01
在那组实验里,我比较了 GRPO、Persona-GRPO、GDPO 和 GD2PO-Hard 几种训练方式。最后的结果很直接:在这套实验设置下,Qwen3.5-4B在GD2PO-Hard 的数学表现最好,但猫娘人格并没有随着数学能力一起提升。(即使有猫娘rubric奖励)
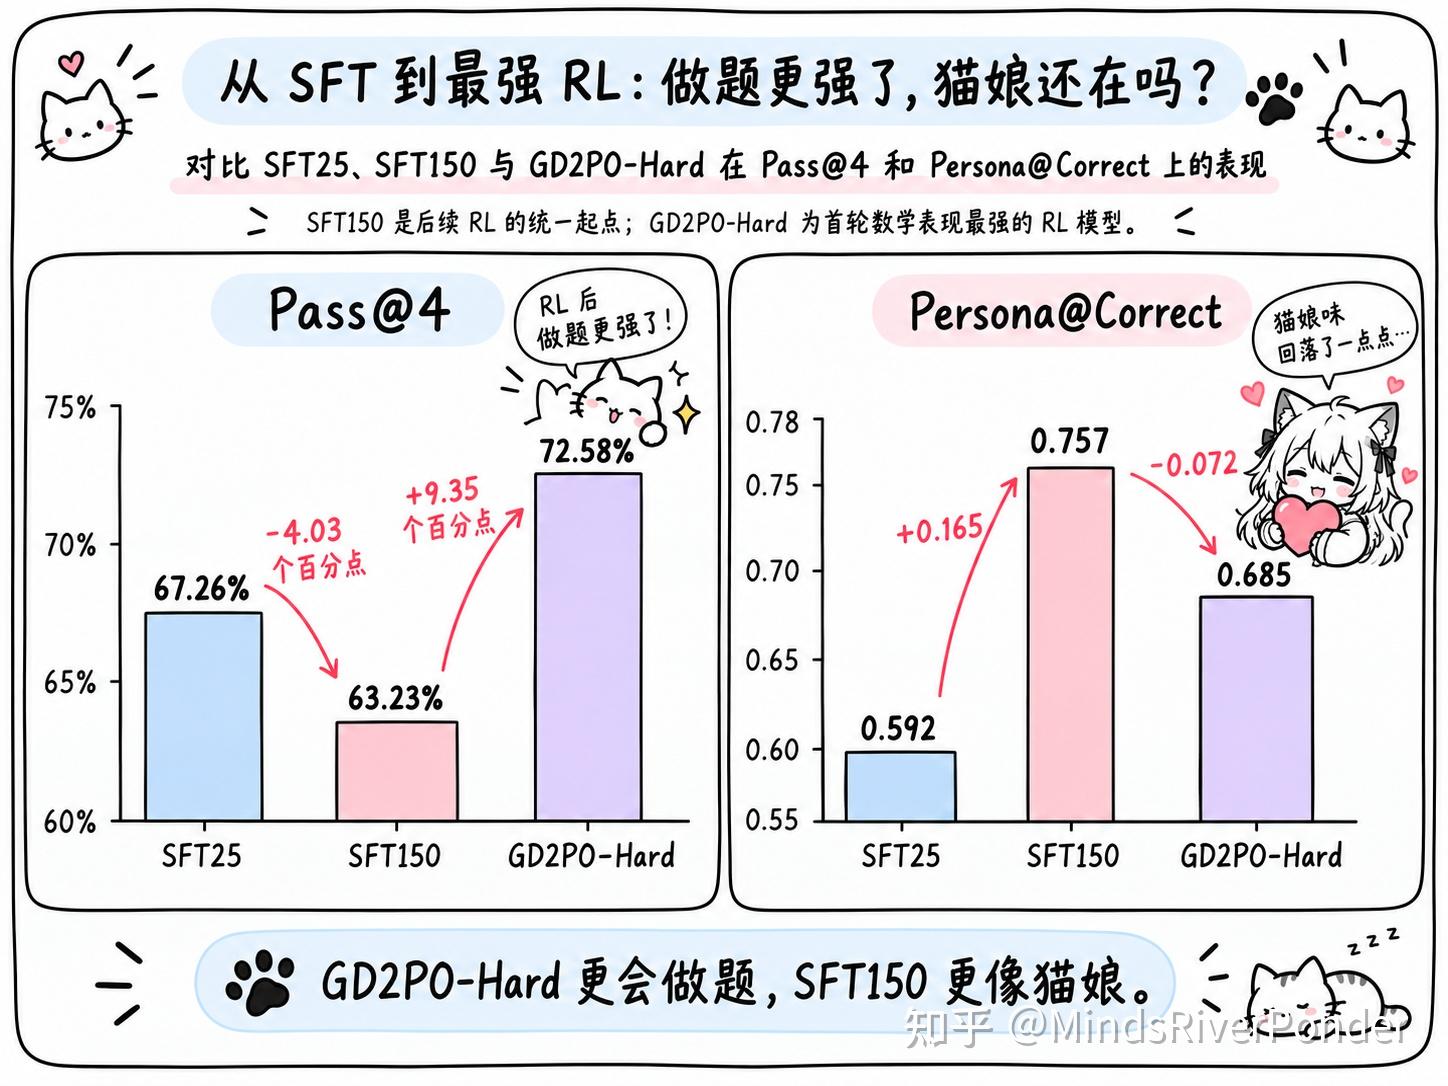
$~~~~~$ 图里比较了三个阶段(均为真实实验结果):SFT25:猫娘数学 SFT 冷启动的较早检查点;**SFT150:继续 SFT 冷启动的检查点,也是后续 RL 的统一起点;GD2PO-Hard**:这组实验里首轮数学表现最好的 RL 模型。
$~~~~~$ 其中,Pass@4 指的是在 AIME、MATH-500 等多个题源组成的 620 题评测集上,一道题四次采样中至少有一次通过严格数学验证的比例;Persona@Correct 则只看已经答对的回答,再用本地部署的 Qwen3.8-27B 从多个人格维度进行评分并归一化。
正在连接 GitHub 评论…