01|前沿 LLM 的训练与推理:总览与阅读路线
同一个 Transformer 怎样从续写走到回答、推理和工具行动?先追踪一条链:数据中的目标 → 网络计算 → 梯度与参数 → 任务尝试 → 独立验证。下面用同一道乘法题区分监督信号,再按问题进入章节。
沿蓝色主线读02—05,把表示、预测和后训练连起来;绿色分支用于按问题选读。
模型训练是一系列数据分布与反馈信号的设计,网络结构只是其中一个环节。 同一个 Transformer 可以成为续写模型、对话助手、数学推理模型或工具代理;关键变化包括它读过什么、模仿过什么、尝试过什么,以及什么行为获得奖励。
资料核对日期为 2026-10-08。本专题以公开论文、官方实现和模型卡为依据。文中的张量例子、手算与机制实验是教学构造;厂商披露与教学选择分别标注。GPT‑6.1 Sol、Claude Opus 5.5 等商业型号没有公布可复现的完整配方,未知的参数量、数据比例和训练预算保留为未知。
新增专题|OPD 与语音 LLM(2026-10-23)
07.1 OPD 与语音 LLM:专题地图已归入第 07 篇下,现含 1 篇导读与 7 篇深读:学生轨迹与梯度、MiniLLM 与 GKD、OPSD/SDFT/SDPO 自蒸馏、稳定性、X-OPD、ASR/多语种/CORD与工程实现。按机制目标、教师稳定性、语音跨模态和工程四组阅读,图文配合原生公式、手算及实验条件;导读逐项注明 23 份实际阅读材料的版本和范围。
本页先给出整个专题的选读入口,再从监督来源、能力归因和证据边界说明读后续章节时应观察什么。页内目录如下:
1. 阅读路线与完整范围
默认读者理解张量、梯度和基本神经网络。本专题不要求先读全部论文,按下列顺序可以建立完整理解链。
行为与任务:04 SFT/偏好 → 05 推理RL → 06 工具代理
扩展与验证:07 多模态/蒸馏 · 08 推理系统 · 09 工程/评测
逐篇问题与具体收获
| 文章 | 核心问题 | 可带走的结果 |
|---|---|---|
| 02|表示与架构 | 文字如何变成 token?一层 Transformer 具体计算什么? | attention、RoPE、GQA、MoE 的张量流与手算 |
| 03|预训练 | 怎样把大规模数据变成稳定的学习信号? | next-token 对齐、交叉熵、数据混合和规模分配 |
| 04|SFT 与偏好 | 从续写模型到助手,参数怎样改变? | loss mask、奖励模型、RLHF 与 DPO |
| 05|推理强化学习 | 没有标准推理过程,怎样用结果训练? | 策略梯度、PPO、GRPO、RLVR 与失败边界 |
| 06|工具代理与对齐 | 多步操作怎样获得奖励,又怎样保持行为边界? | 环境、验证器、信用分配与安全泛化 |
| 07|多模态与蒸馏 | 图像怎样进入模型?教师怎样教学生? | 多模态目标、KL 方向、on-policy 蒸馏 |
| 08|推理系统 | 为什么思考、缓存、采样与搜索会影响表现和成本? | prefill/decode、KV、投机解码与预算 |
| 09|训练工程与评测 | 怎样在集群上训练,并判断得到的是否是真能力? | 显存、并行、数值稳定、评测和成本口径 |
| 10|前沿型号的公开证据 | GPT、Claude、Gemini 究竟披露了什么? | 可核实事实、历史方法、推断与未知的分界 |
| 附录|机制实验与完整源码 | 怎样亲自验证关键计算关系? | 可运行实验、数值结果、排错动作与完整代码 |
想先理解产品差异,可以先读第 10 篇,再沿链接补原理;想实现训练损失,优先读 02—05 与附录;关注 agent,则沿 05—06—08—09 追踪从策略到环境和部署的全过程。
2. 数据与反馈怎样改变模型
2.1 预训练、示范与环境反馈
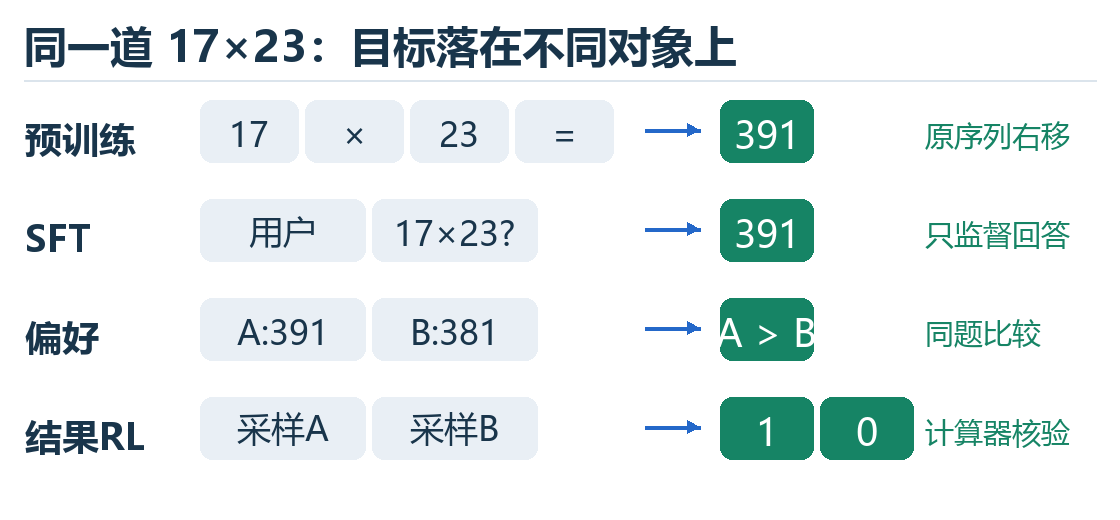
同一道教学乘法题,对照四种监督对象。(教学算例)
四行沿同一道教学题区分目标:预训练从原序列产生下一token,SFT给定回答,偏好比较同题候选,结果RL用核验后的回报给采样路径加权。三类来源——原数据、人或教师、环境——最终通过损失影响权重;阶段可以交替。SFT建立期望行为,蒸馏整合教师技能,安全与质量控制贯穿筛选、奖励、监测和评测。这是公开方法的共同结构,具体来源与方法见下文链接。 InstructGPT 原始论文 OpenAI 的研究说明
2.2 从每个阶段追踪监督对象
| 学习信号 | 改变的对象 |
|---|---|
| 下一token、示范、偏好、环境结果 | 通过损失更新模型权重 |
| 教师轨迹或概率分布 | 更新学生,教师不变成内部专家 |
| 部署中的上下文与工具返回 | 通常改变本次可读内容和状态 |
六阶段的输入、输出与检查对象
| 阶段 | 输入 | 主要学习信号 | 输出 | 读者应该检查的对象 |
|---|---|---|---|---|
| 预训练 | 大规模序列与多模态样本 | 下一个 token 等自监督目标 | 基座权重 | 数据混合、标签对齐、遮罩、损失 |
| SFT | 请求与高质量示范 | 目标回答的对数似然 | 能按任务行动的模型 | 模板、assistant 区域、工具标签 |
| 偏好训练 | 同题不同回答与偏好 | 排序损失、DPO 或奖励模型 | 更符合目标偏好的策略 | 偏好来源、参考模型、长度偏差 |
| 推理与 agent RL | 模型自己生成的轨迹 | 正确性、环境结果、行为约束 | 成功行为概率更高的策略 | rollout、验证器、优势、作弊漏洞 |
| 蒸馏 | 教师输出或概率分布 | 轨迹模仿、token 分布匹配 | 整合技能或更经济的学生 | 教师与学生、访问的状态、KL 方向 |
| 推理部署 | 新请求、上下文与工具反馈 | 通常不更新权重 | 回答或任务结果 | 思考预算、KV、工具、监控、失败恢复 |
3. 能力提升怎样归因
3.1 一次成功,究竟改变了什么
同一份权重增加尝试,可以改变任务结果而不更新参数;这不说明内部采用何种搜索算法。真实系统还可能同时改变测试、工具或重试策略,必须分别控制。
固定同一组仓库任务、工具、验证器与评分规则,再把权重版本和最多尝试次数交叉组合。下面四题A—D的成功集合是自设例,用来练归因,绝非任何产品的实测。
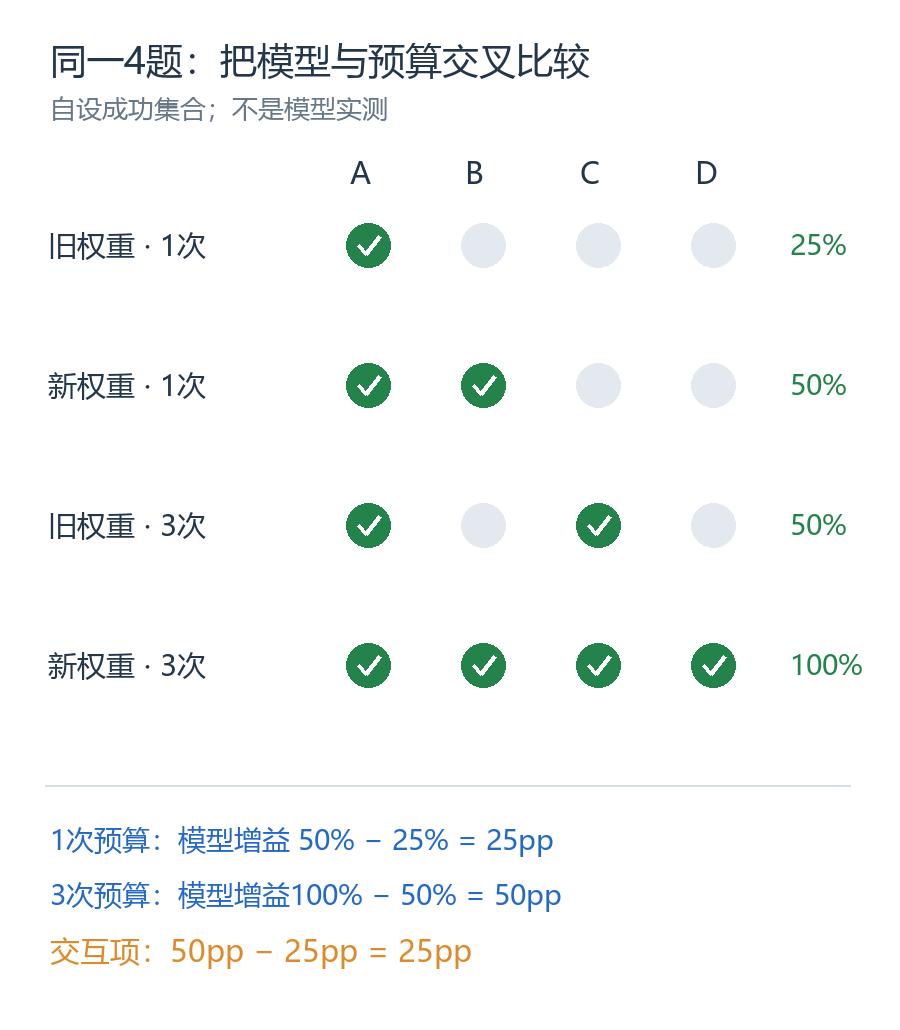
图 3|四题、两种权重、两种预算的控制对照(自设精确算例)
先只看前两行:一次尝试时,旧权重做对A,新权重做对A/B,成功率从升到,权重版本对应的增益是25个百分点。再看第三、四行:预算同为三次时,成功集合变成A/C与A/B/C/D,增益是50个百分点。同一“换模型”操作,在不同尝试预算下并没有相同的收益。
交互项是个百分点:模型与预算的作用不能用一个固定加数概括。若只拿第一行和第四行比较,25%到100%的75个百分点差距同时包含了权重、预算及二者交互,无法归给其中一项。四题也不足以估计稳定总体收益;正式评测还需更多独立任务、配对统计和重复运行。
3.2 六个变量分别落在哪个对象上
这是一份变量清单,不是拟合定律。上图控制的是权重和任务推理计算量;训练数据、任务环境、奖励与部署框架也能改变表现。仓库任务变好,可能来自代码知识、工具策略、训练验证器,也可能是框架加入测试与重试;综合榜单本身不能分开这些原因。
分析框架:符号、职责与边界
| 符号 | 含义 | 典型变化 |
|---|---|---|
| 神经网络权重,无统一物理单位 | 更新权重、调整架构、改变精度 | |
| 训练数据分布 | 加入数学、代码、长文档或高质量示范 | |
| 可交互任务环境 | 仓库、终端、浏览器、模拟业务系统 | |
| 奖励与约束的定义 | 正确性、质量、授权边界、成本惩罚 | |
| 部署框架,包含工具与状态管理 | 检索、重试、上下文压缩、权限控制 | |
| 单个任务的推理计算量 | 多思考、并行尝试、验证、搜索 |
3.3 文档移除后,什么留了下来
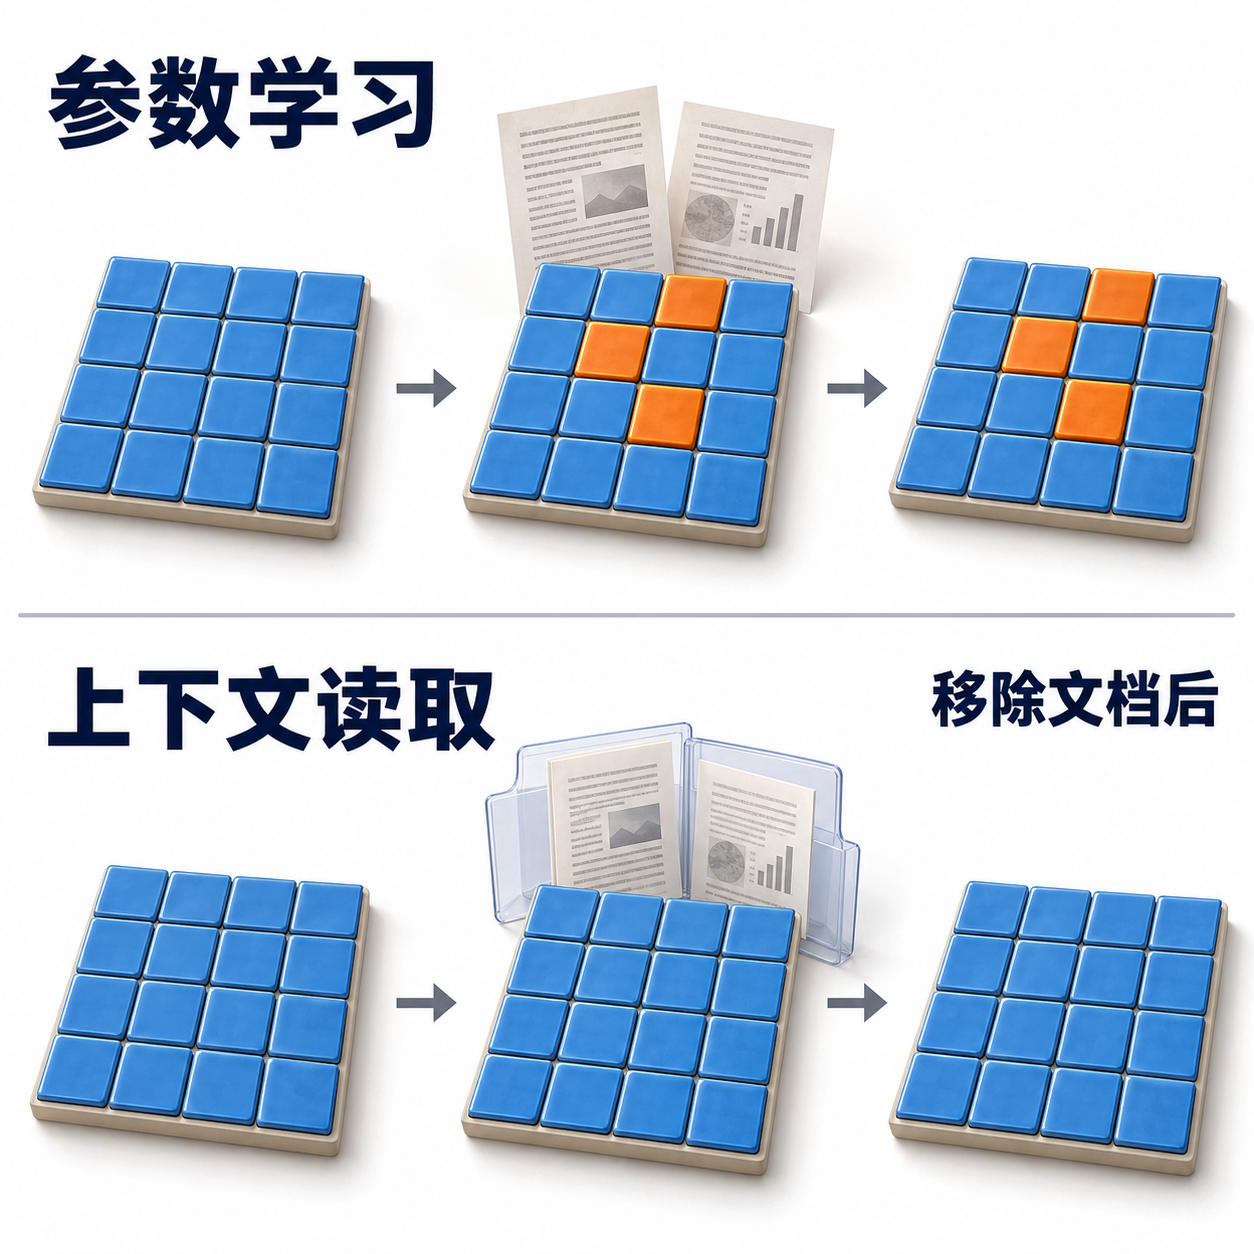
图 4|参数变化会保留,临时上下文可以进出(ImageGen教学示意)
上排三块橙色拼片在文档移走后仍然改变,表示训练后的参数持久更新;下排文档暂存于参数板旁,移走以后参数板始终全蓝。拼片只表示权重状态,并不声称一条知识对应三个真实参数。
训练计算改善权重;推理计算使用权重;工具与检索扩展可访问的信息和行动。 用户上传文档、多聊几轮,通常改变当前上下文。把文档移出可读上下文后,再次提问能否回答,不能单凭结果断言已更新长期权重:答案也可能原先就在训练知识里,或被部署系统再次检索到了。应检查参数更新、上下文和外部状态各自发生了什么。
4. 证据怎样限定结论
4.1 型号披露、研究方法与教学分析
先区分资料能直接支撑的结论范围:型号材料用于核对型号事实,论文用于理解其报告的方法,教学实验用于验证设定内的计算关系;越过边框的联系需要额外证据。
公开事实是可以从某个具体型号的官方材料直接确认的信息。例如 GPT‑6.1 Sol 系统卡明确说其采用与 Astra 同类型的数据与训练。这能支持训练路线的关联,但没有提供相同权重、同一基座、相同结构或蒸馏关系的证明。GPT‑6.1 Sol 系统卡
公开研究方法是可复核的论文或实验。GRPO、DPO、Constitutional AI 的公式可以讲清,但论文作者使用过某方法,不保证每个后续产品原样使用。Claude 当前对齐研究已公开更丰富的 SDF、SFT 和 RL 组合,不能只复述 2022 年的两阶段 CAI。Teaching Claude Why
教学分析与推断用于解释机制和比较取舍。我们会明确假设,例如采用一个单层、单头 attention 来验证因果遮罩。这种实验能验证索引和实现关系,不能推出商业大模型的整体能力。
“模型能做到某件事”不足以反推它使用了某个架构、奖励算法或训练数据。 训练方式应从披露和可复核实现建立证据;能力只能提供需要继续验证的线索。
4.2 与厂商资料对照
| 对象 | 本专题采用的入口 | 如何使用 |
|---|---|---|
| OpenAI | 官方型号文档、Astra 系统卡 | 核对型号与当前直接披露 |
| Anthropic | 透明度中心 | 核对训练概况与产品部署差异 |
| Google DeepMind | Gemini 3 Pro 模型卡 | 对照公开架构、多模态与后训练说明 |
| DeepSeek | V4.1 技术报告、R1 技术报告 | 观察公开训练实例,不替其他厂商填空 |
5. 学习后的检查问题
把问题落回可观察对象,而不是背术语:
| 看哪个对象 | 应能解释的关系 |
|---|---|
| 因果mask的三角区与新增token | 为什么训练并行、自由生成仍逐步依赖 |
| 有效标签与loss mask | 为什么预训练与SFT都用交叉熵,行为仍不同 |
| 轨迹与最后的验证结果 | 为什么答案对不保证中间推理全对 |
| 奖励来源与优势公式 | 为什么RLVR与GRPO回答不同问题 |
| 教师模型与学生内部参数 | 为什么蒸馏教师不是MoE专家 |
| 权重张量与按层增长的KV | 为什么总参数、激活量、权重显存和KV须分别算 |
开始阅读:02|token 表示与 Transformer 张量流。需要厂商资料时,可直接转到前沿型号的公开证据;想验证公式,可打开机制实验与完整源码。
正在连接 GitHub 评论…