07.1.5|语音 OPD:ASR、多语种教师与跨模态推理
返回 OPD 专题导读 · 前置:学生轨迹与梯度 · X-OPD 原理与实验
文中区分原论文结果、原表重绘与教学计算;教学算例不代表模型实测,本文未训练 ASR 模型或复现基准。
语音 OPD 首先要确定输出任务:听到问题后生成答案,与忠实转写听到的内容,虽然都能输出文本,却需要不同教师和反馈。Ark-ASR 把教师带到学生自己产生的转写前缀上;LS-MOPD 加入按语言选择多个教师,并检查声学条件是否相容;CORD 则在跨模态推理轨迹中强调差异较大和较早的位置。共享“学生轨迹”只说明访问位置,还不足以指定任务、词表、KL 方向、教师路由与评测。
阅读路线是:任务与条件 → 三次前向 → 局部候选损失 → 训练阶段与结果 → 多语种教师路由 → 适用边界。
本篇目录
- 1. ASR 与 X-OPD 的条件差别
- 2. Ark-ASR 的三次前向
- 3. union top-K 如何形成局部目标
- 4. 三阶段 recipe 与五项识别评测
- 5. LS-MOPD 的语言路由与声学前缀
- 6. CORD:按轨迹位置加权的跨模态推理
- 7. 迁移到自己的系统前检查什么
1. ASR 与 X-OPD 的条件差别
1.1 共同输出文本,不代表同一种监督
X-OPD 的既有深读涉及“语音问题 → 文本回答”:语音学生读取问题,文本教师读取与语音语义一致的文本问题,再评价同一学生回答前缀。教师不需要直接读取波形,桥梁是输入语义配对与共同文本输出空间。
Ark-ASR 的目标则是“音频 → 转写”。冻结的 Qwen-ASR 教师读取同一段音频,并在学生转写前缀上评分。教师保留声学条件,因此它能围绕学生听成的具体文字给反馈;这里没有先把音频替换成同义文本问题再请纯文本教师回答的路径。来源:Ark-ASR §3.1—3.2。
| 条件 | X-OPD:既有原文范围 | Ark-ASR:本篇原文范围 |
|---|---|---|
| 输出目标 | 回答语音问题 | 转写音频内容 |
| 教师输入 | 配对文本问题与学生回答前缀 | 相同音频与学生转写前缀 |
| 教师反馈 | IM/CM 两路对数概率差与轨迹代理结构 | 统一候选坐标上的局部教师/学生分布 |
| 主要接口条件 | 语义配对、文本事件与位置一致 | 音频条件、转写位置、tokenizer 映射一致 |
| 本文涉及指标 | 问答与推理任务分数,详见原深读 | CER/WER,衡量识别错误 |
这张表用于定位任务,不能横向比较两个方法的分数。转写更准确不自动表示推理更强,问答得分上升也不能直接证明音素感知、音质或交互延迟改善。
1.2 音频表示也是条件的一部分
Ark-ASR 使用音频条件因果语言模型。原文描述 Whisper 风格编码器将语音特征变成声学状态,经归一化、时间合并和 MLP 适配器接入 Qwen2 语言模型隐藏空间;音频 embedding 替换提示中的音频占位位置,再由因果解码器生成转写。理解训练时应同时追踪“读哪段声音”和“已生成哪些文字”,不能只看文本损失。这里概括作者的结构,不把它套到所有 ASR 或语音 LLM。
2. Ark-ASR 的三次前向
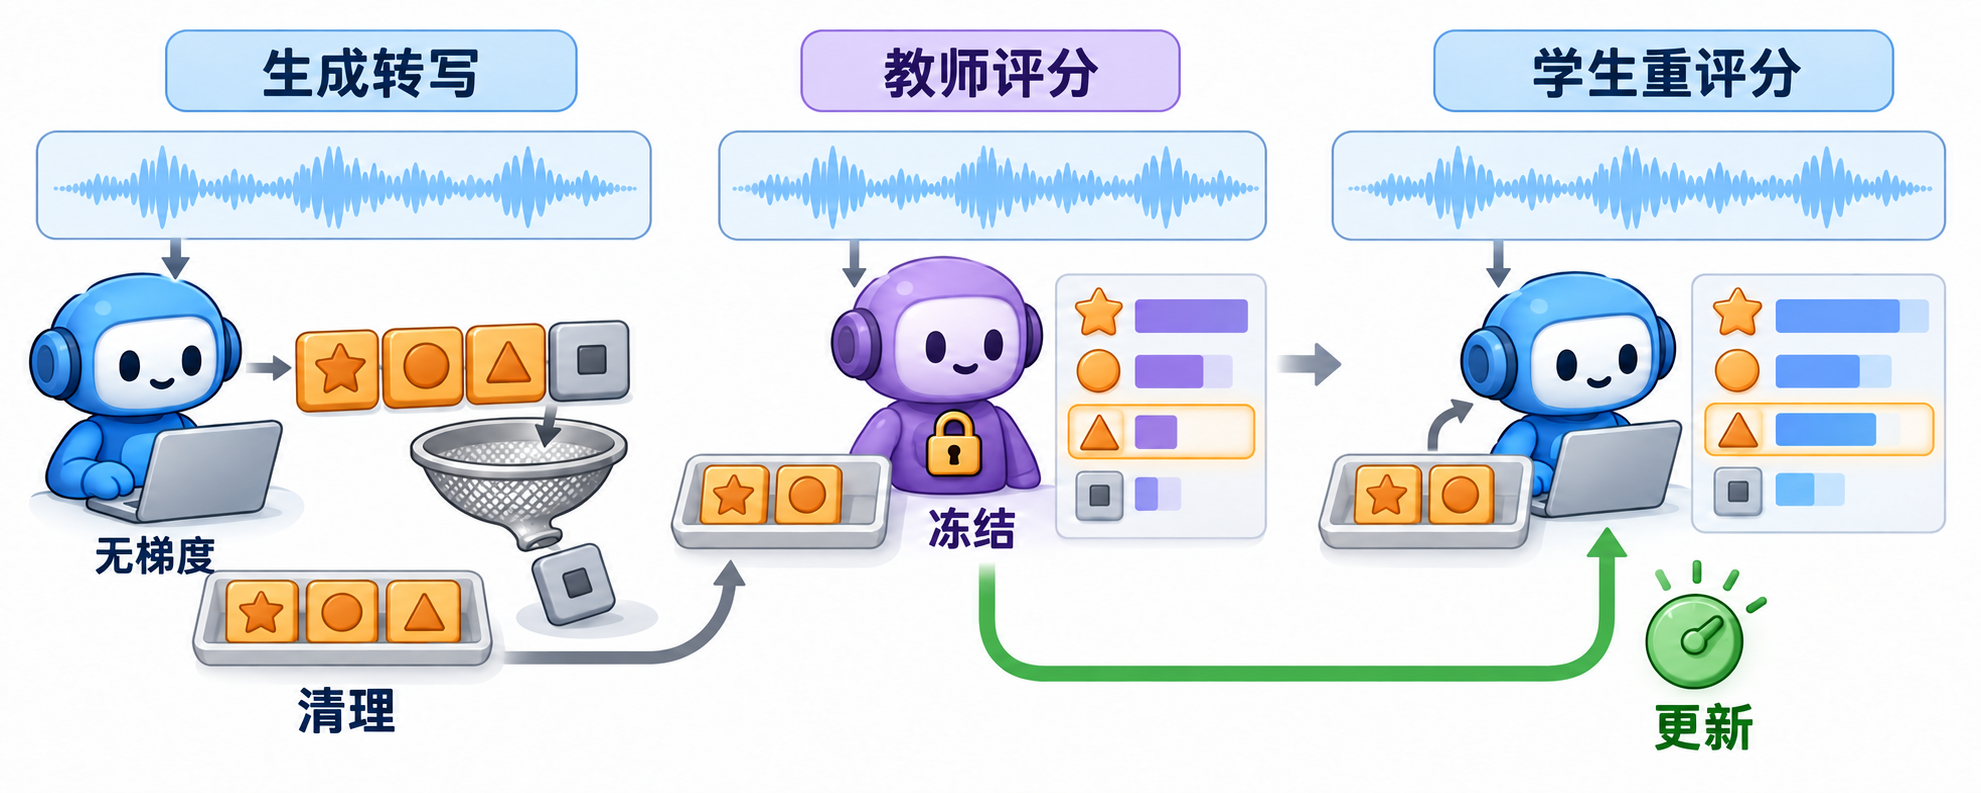
图 1|相同音频与学生前缀上的生成、教师评分和学生重评分(ImageGen 教学示意)
2.1 先产生学生真正访问的转写
沿图左侧蓝学生读:第一遍前向不记录梯度,由学生生成转写 token。随后移除 ASR stop token 与被屏蔽的非 ASR token 范围,再解码为文本。灰色筛网表示清理,橙色格子仍来自学生自身;它们没有被另一条教师标准答案替换。
“无梯度”描述这一遍生成,不表示学生永久冻结。已经抽出的离散 token 确定了本批次访问的历史,下一遍评分会把这些历史作为条件重新读入。
2.2 教师与学生在相同状态上重新评分
中间紫教师接收相同音频和学生转写历史,以 teacher forcing 方式产生对应位置的分数。teacher forcing 在这里是沿给定学生序列、遵守因果位置进行评分,不是让教师重新生成一条不同转写。图中星形、圆形是当前三角形以前的历史,当前目标不提前进入输入。
最后蓝学生在这段生成转写上带梯度重评分,使自己的 logits 与教师反馈对齐。绿色反馈最终更新学生,紫教师保持冻结。原文的核心是“学生访问状态 → 教师评价该状态 → 学生在该状态学习”,不能把三遍计算压缩成“直接拟合一份教师转写”。
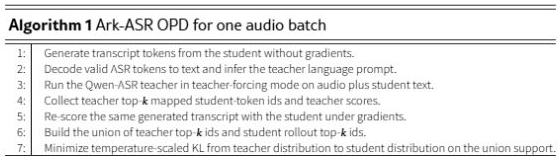
来源:Yu Lin 等,Ark-ASR Algorithm 1(截图裁切,CC BY 4.0)
原算法第 1 行是无梯度生成,第 3 行是冻结教师在音频与学生文本上评分,第 5 行才是学生带梯度重评分;第 4、6、7 行继续处理候选映射、并集与 KL。生成位置、有效文本位置和训练损失位置应顺着这条链逐项对应。
3. union top-K 如何形成局部目标
3.1 先统一候选坐标,再求并集
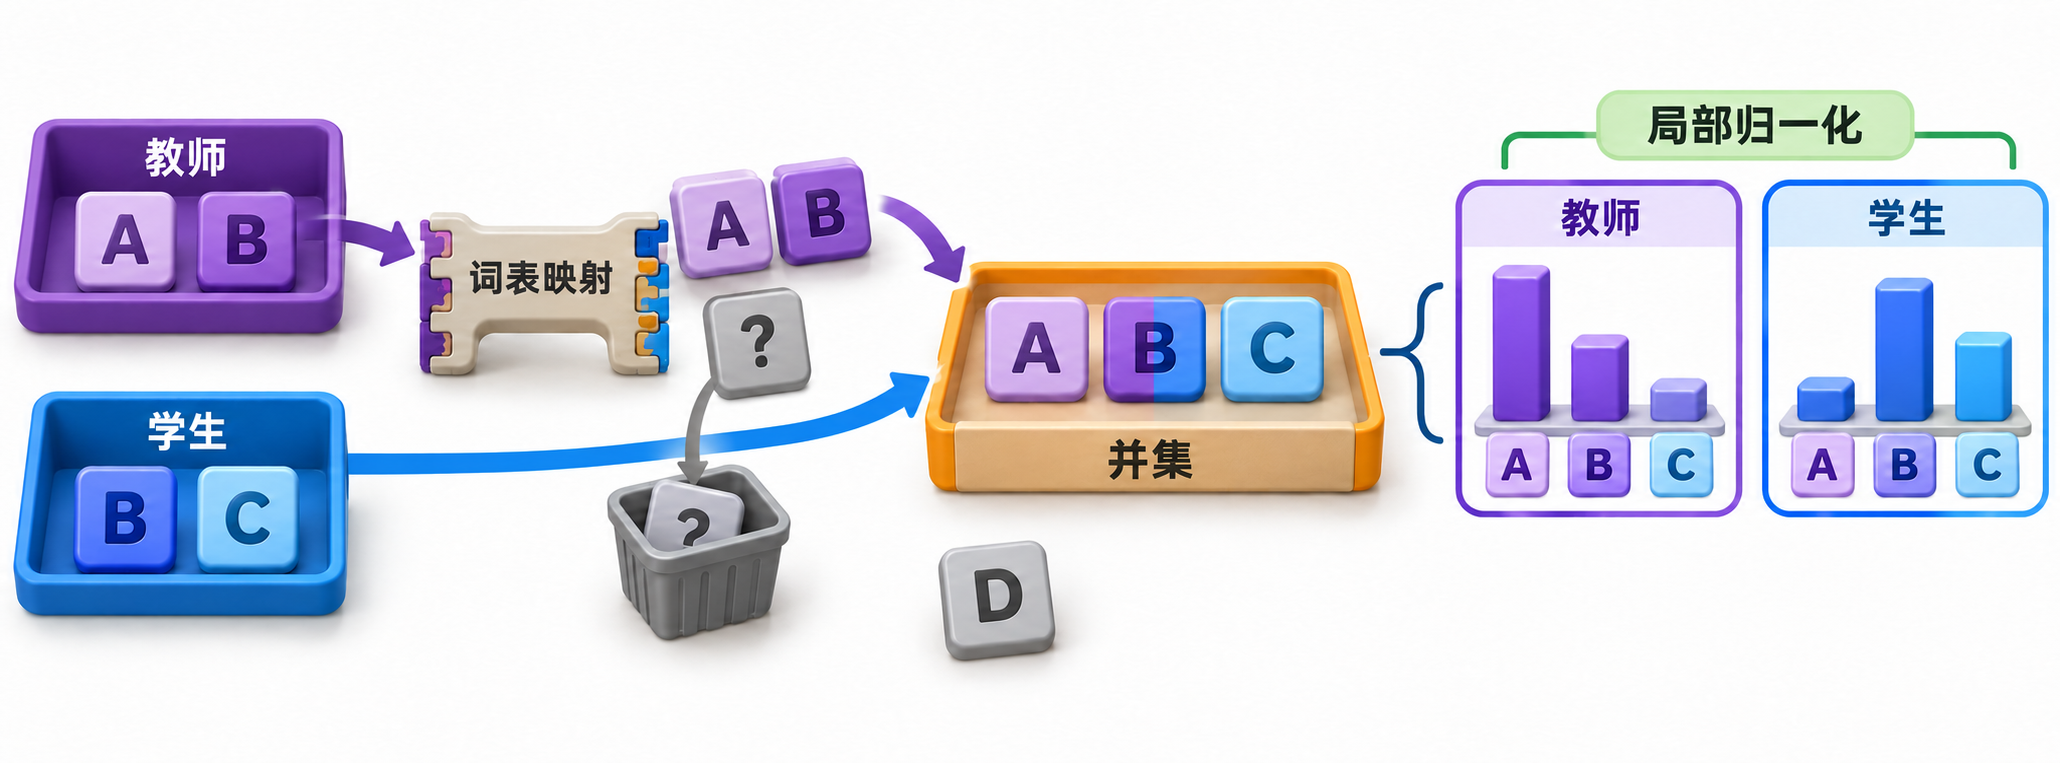
图 2|映射、过滤、去重与局部归一化(ImageGen 教学示意)
看左上紫色候选:教师 tokenizer 的 ID 不直接等于学生 ID,原文通过共享 token 字符串建立映射,无效映射丢弃。左下蓝候选已经在学生坐标中,直接进入并集。中央的 只保留一次, 不在这次支持集内;因此右边两组分布比较的是相同 。
对位置 ,教师贡献映射后的 top-K,学生贡献生成时记录的 rollout top-K;并集记为 。教师支持中的候选使用相应教师分数,学生独有候选的教师分数从 teacher-forced 前向中补齐;学生则在带梯度重评分时收集同一并集上的 logits。它不只是把两份各自 top-K 数组按下标相减。来源:Ark-ASR §3.3—3.4、Algorithm 1。
这里的字符串映射不是任意跨 tokenizer 的完整语义对齐。特殊/控制 token 还要按 ASR 规则屏蔽,音频提示的 padding 与位置偏移需要对齐,作者也记录重分词不匹配等诊断。若学生生成为空,实现允许参考文本评分的回退;论文分析的日志窗口中,报告该回退为零。这个窗口结果不能代替所有数据与运行条件的保证。
3.2 只在有效局部支持上归一化
令 为两个模型在候选 上收集的分数, 表示教师与学生; 是温度。局部分布为:
是分母中的候选索引;两组概率分别归一化,不能先把教师、学生分数混成一组。令 为并集中至少有两个有效候选的转写位置集合, 是位置数,原文目标可写为:
对数为自然对数,概率与损失无物理单位;这是 teacher-to-student 的前向 KL,并带温度平方系数。论文所用 Qwen-ASR teacher-forcing 路径报告的总训练损失就是这一 OPD 项,不能擅自套入其他方法的附加 LM loss。“至少两个有效候选”限制每个位置的支持大小,不是要求每条转写至少两个 token。 只有一个候选时,两侧 softmax 都退化为 1;把它当成完美一致的普通训练位置会误解筛选职责。
3.3 手算局部 KL 与完整词表的区别
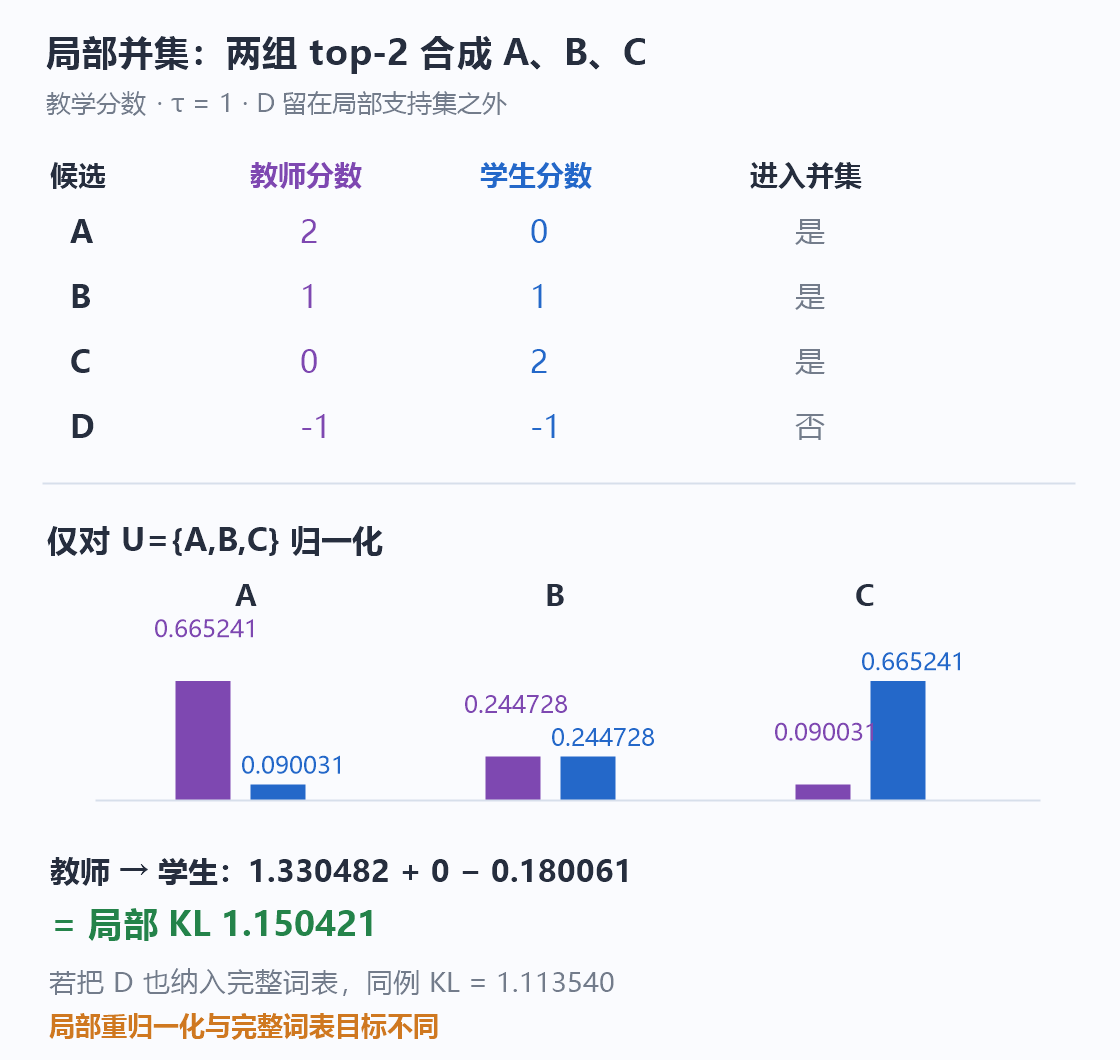
图 3|教学分数:并集归一化改变了计算对象
设词表只有 ,教师分数为 ,学生为 ,取 。为隔离支持集作用,本例令学生 rollout 与重评分的分数相同。教师选 ,学生选 ,所以 ,不是四项完整词表。
教师在并集内的归一化分母为 ,得到 ;学生的 交换第一、三项。逐项贡献为:
相加得局部 KL 为 。若同一例子把 也纳入全词表 softmax,教师在 上仍有约 概率,完整词表 KL 为 。union top-K 是明确的局部目标,不能仅因使用 KL 就称作 full-vocabulary distillation。
这些分数、温度与字母只是教学配置。配套标准库验算已实际运行,以未舍入概率和逐项贡献核对上述结果;没有执行真实 ASR 训练。改变温度还会同时改变概率与 ,不能把该系数理解成让任意温度下损失都严格不变。
4. 三阶段 recipe 与五项识别评测
4.1 区分训练阶段与三次前向
前面的三次前向发生在一个 OPD 批次内,SFT、TD、OPD 则描述跨训练过程的阶段。Ark-ASR 三个学生变体都为 0.6B,报告的训练数据规模是 100k 小时:Ark-Base 是在这些 ASR 数据上得到的 SFT checkpoint;Ark-Base+OPD 从它开始,在相同 100k 小时数据上继续 OPD;Ark-Base+TD+OPD 则先额外使用 2,000 小时教师生成转写数据适配,再做 OPD。来源:Ark-ASR §4.1。
TD 的静态教师数据与后续学生轨迹反馈承担不同职责。比较 TD+OPD 与单独 OPD 时,初始化和额外阶段一起变化,不能把全部收益只归因于同一个 OPD 损失。原文称 OPD 教师为冻结 Qwen-ASR 评分模型;不能仅凭结果表列出 Qwen3-ASR 基线,就自行指定某一行是实际教师 checkpoint。
4.2 CER 与 WER 分面阅读
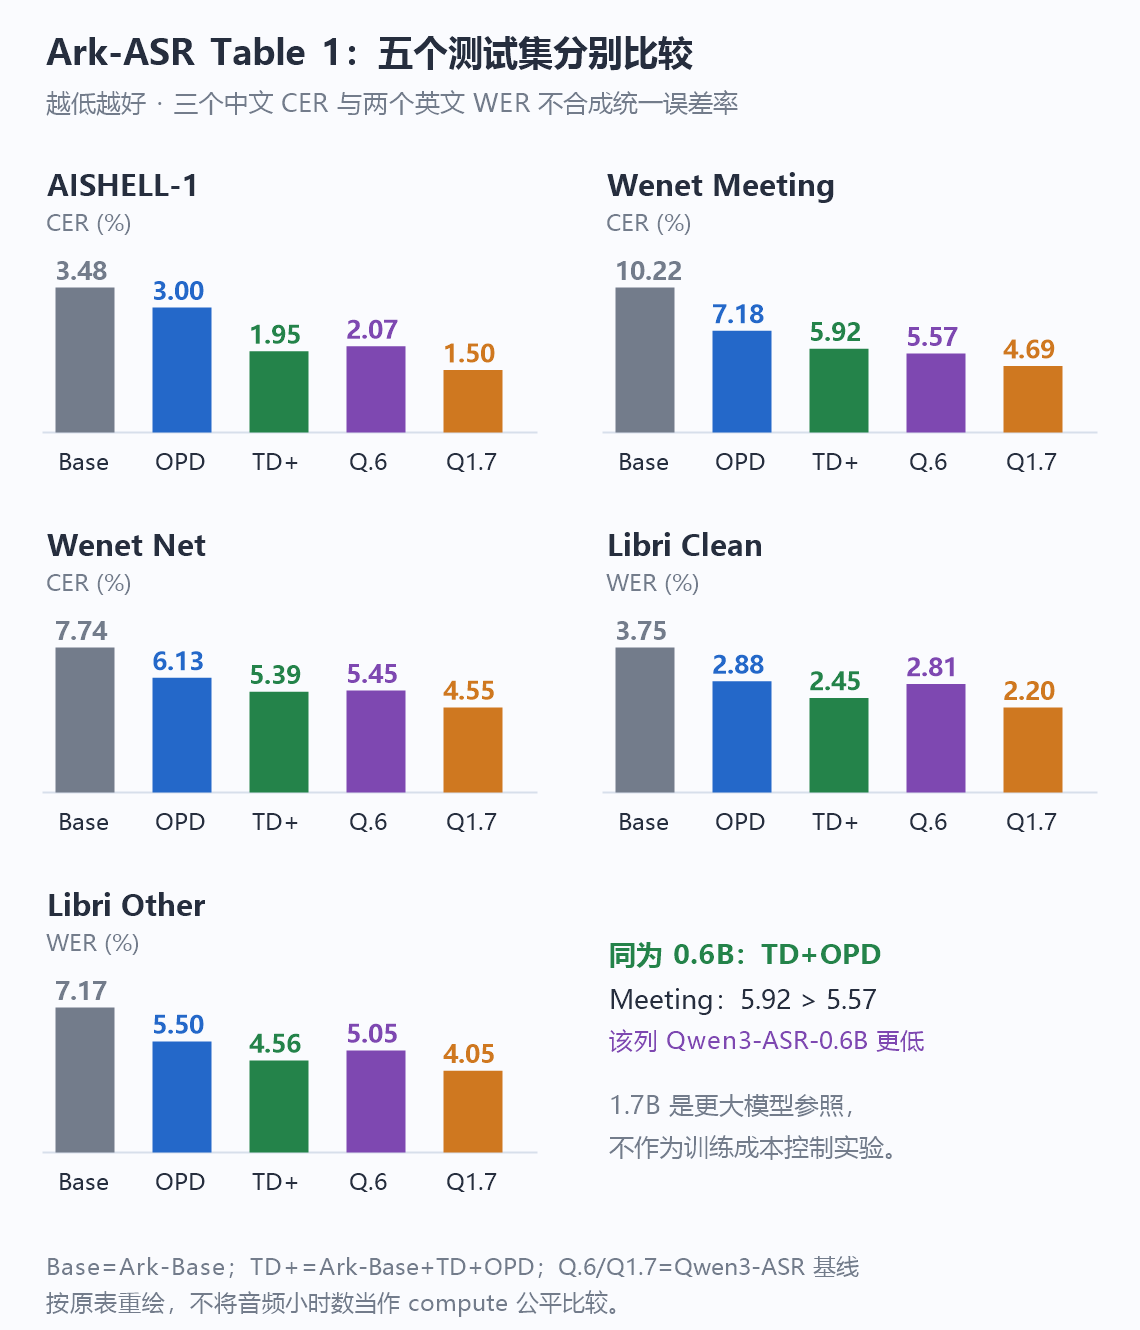
图 4|Ark-ASR Table 1 重绘;各面板独立量表,错误越低越好
中文 AISHELL-1、WenetSpeech Meeting/Net 用字符错误率 CER;LibriSpeech clean/other 用词错误率 WER。两者都以编辑距离中的替换、删除、插入计错,但分母分别是参考字符数与词数。论文评测还做文本归一化和去标点,分数应连同这些条件理解。
由 Base 到 +OPD,五列依次从 降至 ;加入 TD 阶段后为 。图中保留各项原值,不把五个比例直接相加称为统一识别率。
在同为 0.6B 的参照中,TD+OPD 在四项测试上低于 Qwen3-ASR-0.6B,但 Meeting 的 仍高于后者 ;更大的 1.7B 参照在五列都更低。这个表支持所列条件下的改进,也保留未胜出的任务,不能写成“所有模型、所有测试最佳”。
论文另报告 valid union support size(VUSS)均值从 到 。它计算映射、过滤后的有效并集大小;同一 top-K 条件下,更小可与更大支持重叠相一致,但这里是训练诊断,没有通过控制其他变量来干预重叠程度。它不能单独证明“VUSS 下降导致准确率提高”。
5. LS-MOPD 的语言路由与声学前缀
5.1 多个教师如何落到同一学生轨迹
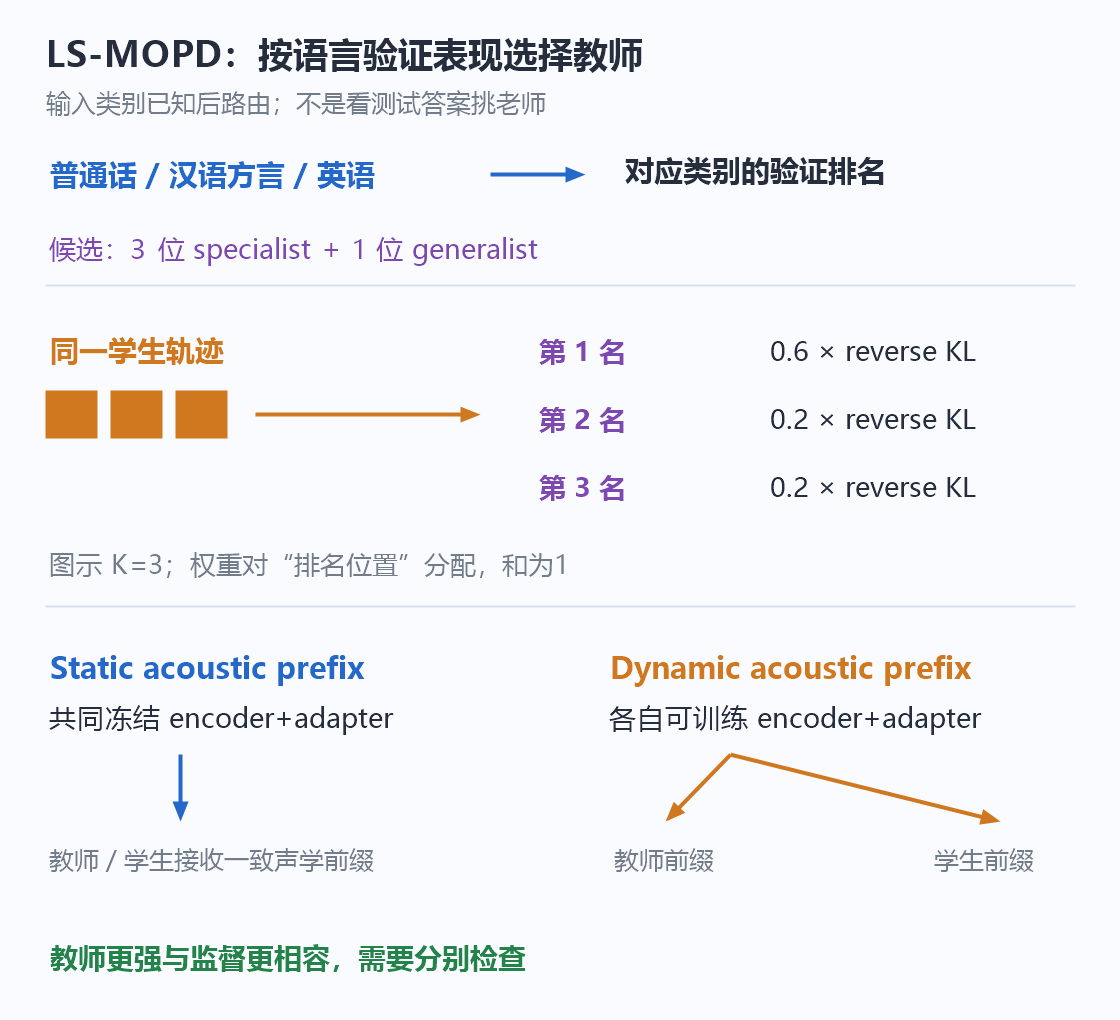
图 5|按 LS-MOPD 方法重绘;示例展示排名前三的加权损失
LS-MOPD 把问题进一步变成“不同语言由谁教”。原文路由类别为 Mandarin、Chinese dialects、English;其中方言组包含 Mandarin subdialects 与 Cantonese。训练池为 50k 条 utterance,四个取样组为 20k/10k/10k/10k,不能把条数当成音频小时。三个 specialist 教师各使用目标类别数据,并混入其他类别的 20%;另有 generalist 教师。来源:LS-MOPD v2,§3—4。
教师先用 DAPO 训练,组大小 ,奖励按识别错误率构造为 ; 是训练定义口径的 CER 或 WER,不应把报告表里的百分数未经确认直接代入计算。随后依据验证集上每个语言类别的表现排序,选择排名较前的教师监督该类输入。图上“第 1 名”是该类别的验证排名,不能把“某任务最强教师”当成不依赖语言的固定身份。
学生生成 on-policy 轨迹后,分别对每位已选教师计算 reverse KL:学生分布在前,教师在后。各位置按轨迹长度平均,再对教师损失加权。若第 名教师的损失为 ,则:
在这里是教师数量,区别于 Ark-ASR 的候选 token 数; 是按排名位置分配的非负损失权重。论文的 分别使用 、、。它是多个 reverse-KL 项的加权,不能自行改写成把教师答案或概率做算术平均。来源:LS-MOPD Eq. (3)/(4)、§4.3。
5.2 教师更强与声学条件更一致是两件事
图 5 下半画出 Static 与 Dynamic 条件。Static 让教师和学生共享冻结的 encoder-adapter,声学前缀保持一致;代价是限制教师端可继续优化的部件。Dynamic 允许各自可训练的声学前缀,教师可能取得更高奖励,但教师与学生条件也可能更不一致。
原文的初步分析将教师训练奖励与 OPD/CE 梯度对齐指标分开观察:动态前缀教师更强,不自动意味着蒸馏梯度更贴近对应监督方向。这不能只用一张教师排行榜解决,也不能从这一组分析推出动态前缀永远较差。本文以文字和独立图解释机制,未转载该论文原图。
5.3 两组结果看见非单调性与解码条件
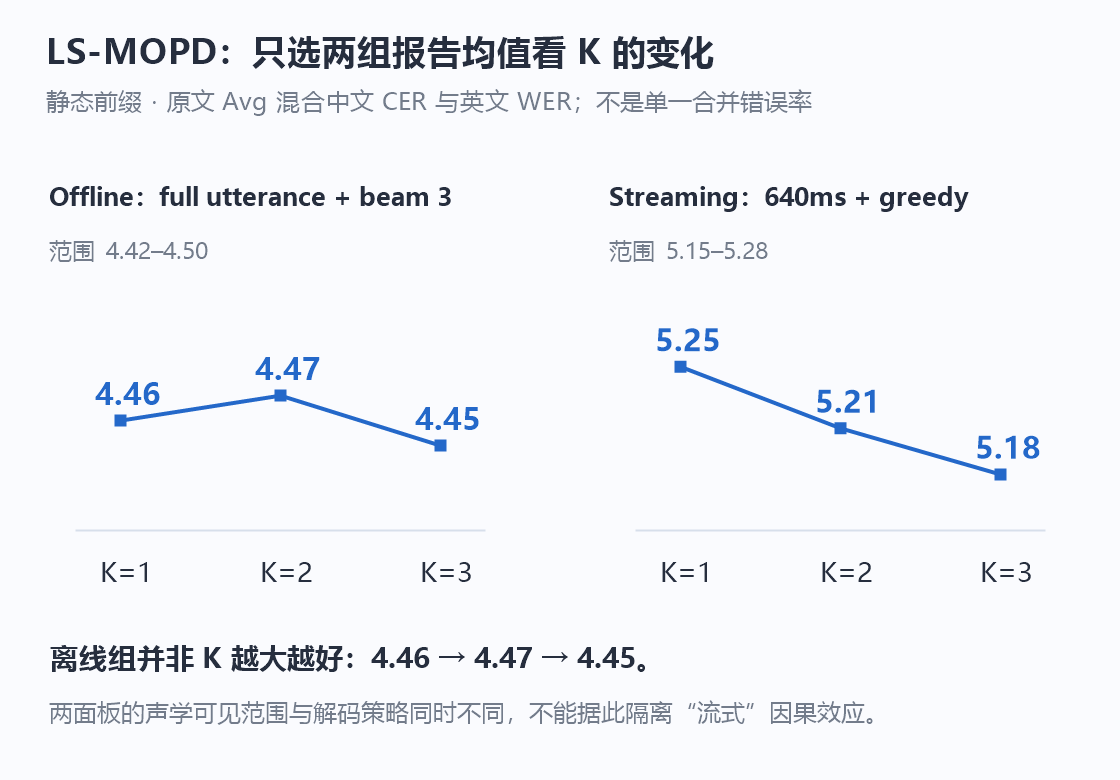
图 6|LS-MOPD Table 1/2 选定两组重绘;保留各自解码条件
只取静态前缀的两组数:离线 的原文 Avg 为 ,并非每增加教师都下降;流式对应为 。动态离线设置也存在两教师优于三教师的报告。“教师更多”与“该条件下损失权重更合适”不能合并成单调规律。
原文 Avg 混合汇总中文 CER 与英文 WER,本文沿用它比较同表配置,不把它称为把所有字符或词合并后的统一错误率,也不与 Ark-ASR 的五列原分数混算。离线使用整句声学输入、beam size 3;流式用 640 ms 块、保留前四块左上下文、greedy 解码。两种模式同时改变可见范围与解码策略,因此两面板差距不能单独归因于分块声学处理。
该工作基于约 2.3B 的单一主干,包含 0.6B FireRed Conformer 与 Qwen3-1.7B 解码器,主干预训练约 560k 小时。它支持这一主干和有限语言条件下的路由分析;动态前缀仍属初步探索,不能把结论直接扩成所有语言与架构的多教师规则。
6. CORD:按轨迹位置加权的跨模态推理
6.1 同模型的文本条件与音频条件
CORD 的任务回到语音问题推理。学生先在音频条件 下生成 ;同一模型的文本条件视角读取语义对应的 ,在相同学生前缀上提供分布参照。位置 的差异为:
这是音频在前、文本在后的 reverse KL。这里的“教师视角”来自同模型的文本条件,与 X-OPD 冻结外部文本教师的设定有别。CORD 的教师分支更新、停止梯度与快照细节尚未核对,因此不能自行将其标为 frozen 或 EMA。来源:CORD §3.1—3.4。
6.2 选高差异时间位置,再强调较早位置
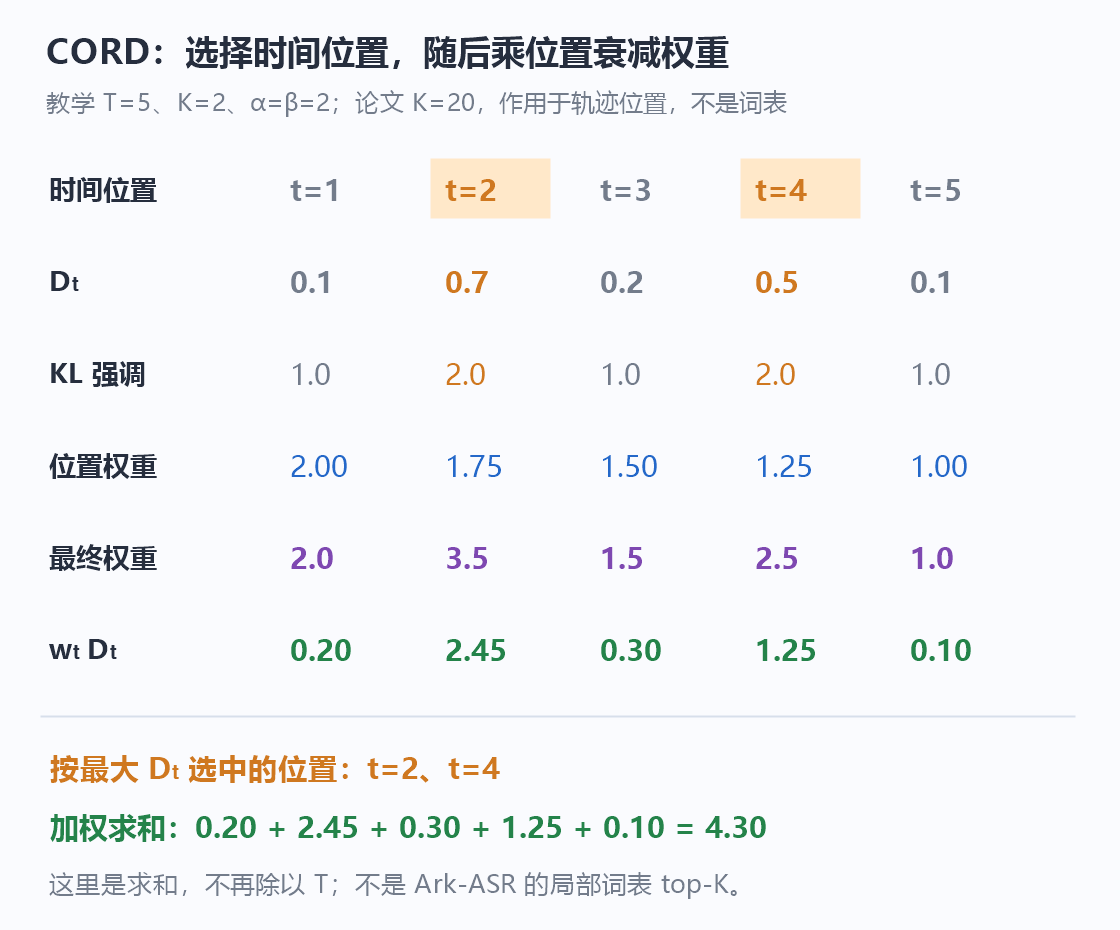
图 7|教学轨迹的双权重;此处 top-K 选时间位置
CORD 在一条轨迹中按 排序,选择最大的 个时间位置:这些位置的 KL 权重为 ,其余为 1。另以位置权重强调前段,最后两者相乘:
为轨迹长度, 控制位置强调;该位置式按 展示,首位为 ,末位为 1,单 token 边界要看实现。 是前述高差异强调系数, 是最终乘积;目标为加权求和,不能自行除以 变成均值。
图 7 缩为教学 ,令差异为 。选中第 2、4 位;第 2 位的位置权重为 ,乘 KL 强调系数后为 ,贡献 。五项贡献之和为 ,脚本已实际核对。例子的 K 与参数便于手算,不冒充论文配置。来源:CORD §3.4、Eq. (4)—(7)。
| 方法中的 K | 选中的对象 |
|---|---|
| Ark-ASR union top-K | 一个位置上的词表候选 |
| CORD 高差异 top-K | 一条轨迹中的时间位置 |
| LS-MOPD top-K teachers | 按语言排名的教师 |
三者改变不同维度,不能把“都用了 top-K”写成相同计算设计。
6.3 序列一致性奖励与实验范围
CORD 还让文本条件另行生成参考回答 ,由 judge 判断音频回答 与它在答案语义上是否一致,给出 0/1 奖励,再使用 GRPO 的序列损失。这条参考是独立生成的完整文本回答,不是 token 分布对齐时的同前缀评分;语义一致也不必然等于答案正确。本文讨论 token 与序列目标的联合训练;精确组合系数尚未完整核对。
原文以 Qwen2-Audio-7B-Instruct、Step-Audio-2-Mini 为基座,从 NuminaMath 取 80k 实例,用 Kokoro 合成配对音频;训练数据为数学题,评测涉及 MMSU、OpenBookQA、GSM8K。原表 HTML 数字排版异常,本文不据此转录具体结果。合成问题上的跨任务评测,也未验证真实口音、噪声或非语音声学信息的普遍泛化。来源:CORD §3.5、§4.1。
7. 迁移到自己的系统前检查什么
沿语音路线分别核对条件。X-OPD 先检查语音/文本问题配对;Ark-ASR 检查同音频、学生转写前缀、token 映射与局部支持;LS-MOPD 检查语言验证排名、教师损失权重与声学前缀;CORD 则区分同模型条件切换、高差异位置与序列语义奖励。它们都围绕学生访问状态,但监督来源和目标并不相同。
对 Ark-ASR,100k 小时与原文引用的 20M 小时只提供报告规模背景。后者来自 Qwen3-Omni 报告中 AuT encoder 的描述,并非本实验独立复现的 Qwen-ASR 训练基线;原文明确没有据此进行完整 wall-clock 或 compute 归一化比较。更少的音频小时不能自动换成某个训练成本优势倍数。
论文还未报告重复随机种子、逐域数据组成与严格成本归一化;长音频鲁棒性、幻觉行为和流式延迟仍待完整测量。LS-MOPD 的块长同样不等于端到端响应时间:采集等待、编码、解码、设备和输出稳定策略都影响部署。模型跑通、局部 KL 下降与 VUSS 变化,分别只能支持相应检查,不能相互替代。
可实施的核对顺序是:固定一条音频和输出历史,检查两模型读到的条件;逐项打印 token 字符串映射与有效支持;独立核对局部 softmax 与损失;然后在相同归一化、任务和解码协议下比较识别错误。涉及多个教师时,额外保存语言类别排名和被选教师版本。只有这条链明确,才知道改动的是听觉条件、文本行为、教师选择,还是训练预算。
原始来源与范围。 Ark-ASR:arXiv:2605.28139v1,2026-05-27,Yu Lin、Yiming Wang、Runyuan Cai、Xiaodong Zeng(AutoArk-AI),本文使用 §3—6 相关方法、实验和局限段及 Table 1/2;算法截图按 CC BY 4.0 裁切署名。LS-MOPD:arXiv:2608.03610v2,2026-08-10,本文采用 §3—4 的方法、解码协议与选定实验结果,未转载原图。X-OPD 的任务与输入条件参照独立深读所用的 v3,2026-06-12,本文仅用于任务与条件比较。
CORD:arXiv:2601.16547v1,2026-01-23,CORD: Bridging Audio-Text Reasoning Gap via Weighted On-policy Cross-modal Distillation,本文采用 §3.1—3.5 的方法与 §4.1 的实验设置;非 CC BY,未转载其原图,也未使用排版异常表格的具体分数。
正在连接 GitHub 评论…