07.1|OPD:从学生轨迹到语音 LLM 的学习路线
On-Policy Distillation 首先改变教师反馈的位置:学生先生成,教师再在这些实际出现的前缀上评分。 本专题从这里出发,把数据访问位置、分布目标、梯度、教师信息和任务评测逐层分开。沿用既有基础机制与 X-OPD 深读,再接序列目标、自蒸馏、ASR、多教师、稳定性和工程实现。
截至 2026-10-23,已实际阅读的内容来源为 23 个:12 篇原论文、10 篇知乎选段、1 篇官方技术博客选段。另有 1 个 GitHub 分类索引,共 24 条书目入口。“已读”指下表列出的章节与材料,包含方法和部分实验核对,不表示 12 篇论文均已逐字通读;没有训练模型或复现论文基准。
本页目录
四组八个内容单元
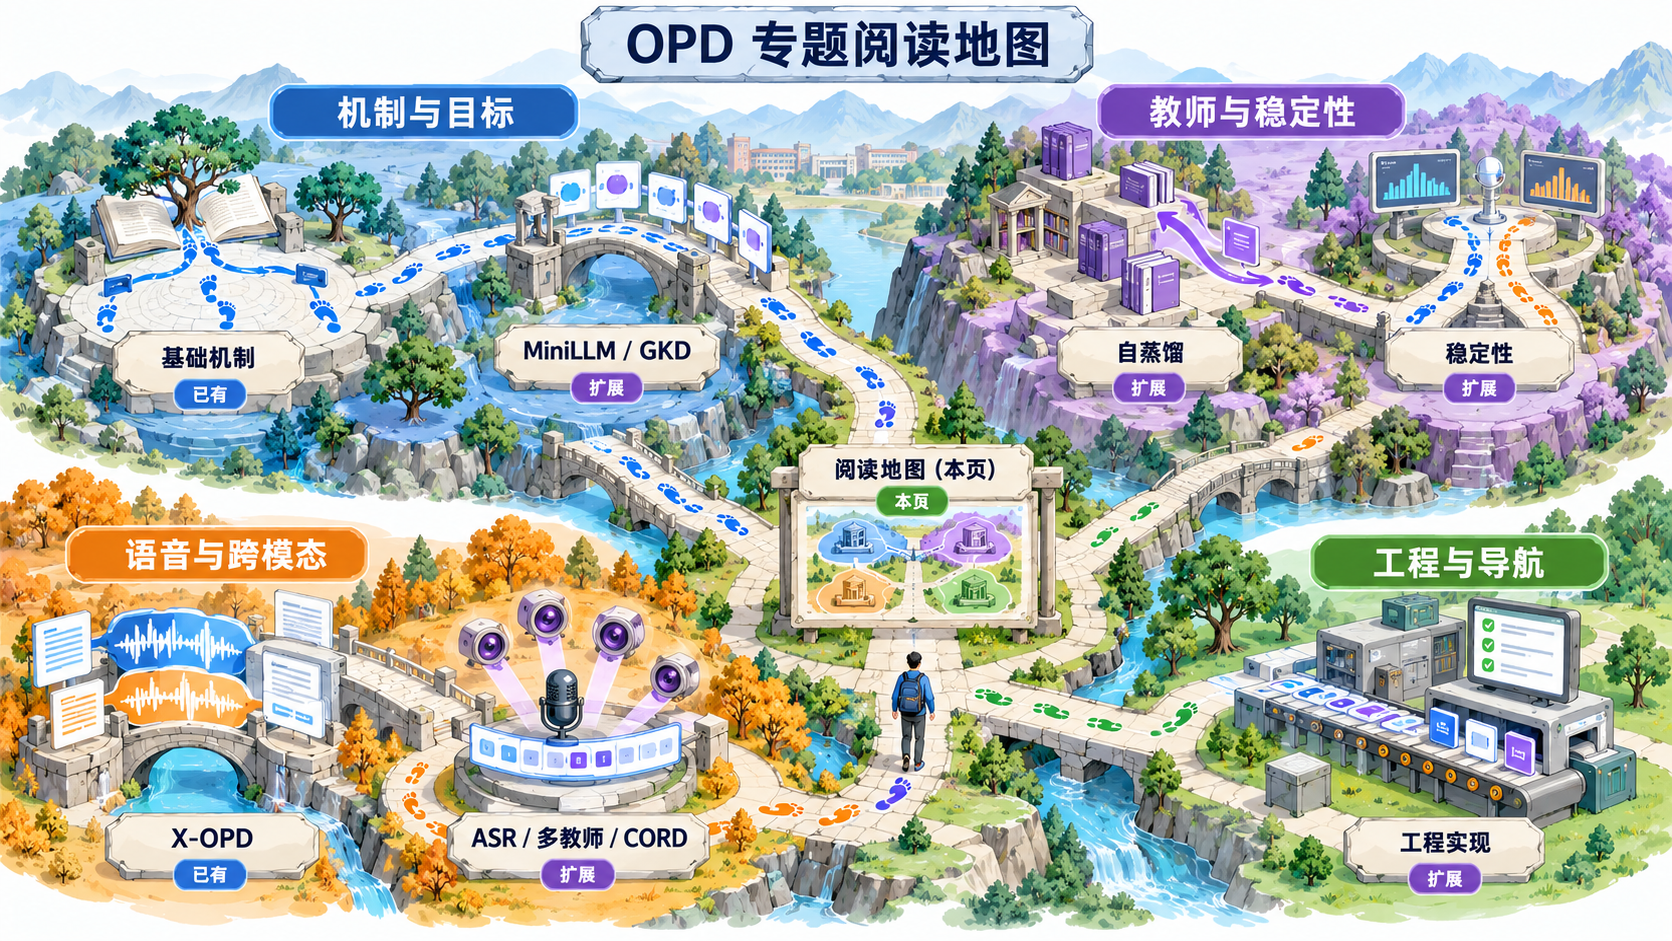
图 1|道路表示建议阅读顺序,八个地标表示内容单元(ImageGen 教学地图)
图中先看左上的蓝色分叉,再沿桥走向其他主题。“已有”是基础机制与 X-OPD 两篇原深读,“扩展”是五篇新增深读;中央阅读地图就是本页,共八个单元。它们按问题分组,图中的连线不是方法间的继承或因果证明。
机制与目标
- 基础机制:学生轨迹、分布与梯度:从 GKD 原算法与可运行手算分清采样来源、共同前缀和停止采样梯度。
- MiniLLM 与 GKD:序列目标如何落实到 token:读序列 reverse KL、未来回报、teacher-mixed sampling 与重要性权重近似。
教师与稳定性
- 自蒸馏:OPSD、SDFT 与 SDPO:教师多读参考解、示范或环境反馈;分清固定初始教师、EMA 与正则教师,以及理论和实际 recipe。
- 稳定性:候选重叠、熵与局部支持:读 Rethinking、EOPD、Revisiting 的诊断与干预,保留失败例、范围与非普遍性。
语音与跨模态
- X-OPD:语音问题与文本教师:同义语音/文本输入,共同文本回答;检查 IM/CM、轨迹平均和论文三任务结果。
- 语音扩展:Ark-ASR、LS-MOPD 与 CORD:分别处理转写、语言教师路由与跨模态推理加权,辨认局部支持、声学前缀与序列奖励。
语音输入后回答问题、忠实转写音频、学习音频输出,并非同一个任务。X-OPD 的回答分数不能证明合成音质,ASR 的 CER/WER 不能直接代表推理能力,流式块长也不等于端到端延迟。先定位输入与输出,才知道需要哪一条深读。
工程与导航
- 工程实现:轨迹、对齐、缓存与评测:从同一批次的身份、版本、logits、mask 和平均单位,走到伪代码与独立评测。
- 阅读地图与来源范围(本页):定位内容,核对版本与证据缺口;技术推导仍保留在相应深读,不挤成摘要。
按问题选择学习路线
- 第一次读 OPD:基础机制 → MiniLLM/GKD → 工程。先能解释“教师评的是学生哪一格”,再讨论序列目标与优化近似。
- 做语音系统:基础 → X-OPD → 语音扩展。问答重点看语义配对与 CORD;识别重点看 Ark-ASR,涉及语言路由再看 LS-MOPD,随后到工程核对接口。
- 研究自蒸馏:基础 → 自蒸馏 → 稳定性。先找新增信息来源,再查教师更新与停止梯度,最后判断弱 ICL、反馈质量和风格残留。
- 已有实验但效果不稳:工程 → 对应任务深读 → 稳定性。先排除位置、mask、采样与评测口径问题,再看支持重叠、熵和冷启动;loss 下降不能替代任务结果。
换一篇论文时,先记下:谁产生 rollout、教师多读什么、比较完整词表还是局部支持、教师怎样更新、按 token 还是轨迹平均、结果用什么单位。同名符号也不能互套:Ark-ASR 的 K 是候选词表项数,LS-MOPD 的 K 是教师数量,CORD 的 top-K 则选择高散度输出位置。这张检查单比先挑一个“最强方法”更能帮助复现。
中文文章阅读路线
这十篇中文材料来自十位作者,适合按解释问题来读。先用入口文找到学生轨迹,再用方法解读检查分布、教师信息与更新;遇到分歧时,回到本专题的原论文图、公式和手算。以下列的是实际读过的选段,完整范围在后面的来源表中。
| 要弄清的问题 | 中文读法 | 带回本专题检查什么 |
|---|---|---|
| 为什么在学生自己的输出上学习? | 欲壑难填的GKD/MiniLLM 入口、xyiz 的后训练 OPD 导读、姜富春的Thinking Machines 中文翻译与注释 | 基础机制两条轨迹中,教师究竟在哪些前缀反馈? |
| 单个 token、完整词表和上下文教师怎样接起来? | kxzxvbk 的核心做法与自蒸馏、今天学习了吗的上下文与经验内化共同模板 | 工程的值与梯度、自蒸馏的教师条件是否分别写明? |
| 同一模型怎样得到更好的监督? | Lei Tian 的SDPO 非对称上下文、龟壳的调研与学习中开卷/闭卷类比 | 教师多看材料后是在原尝试上评分,还是另生成示范?教师下一步怎样更新? |
| 教师更强,为什么仍可能学不好? | 恰似故人归的Rethinking 三层读法、sanmuyang 的EOPD 高熵解释、Your 的学术问题对照 | 稳定性中的任务分数、重叠、熵与支持集分别提供什么证据? |
姜富春的翻译把“采样方式”和“信号密度”放在两条轴上:学生自己生成回答后,可以只收到结尾结果,也可以在每个位置收到教师反馈。它还提醒,模仿教师的风格和置信度不等于取得事实正确性。下面的轨迹图因此先解决反馈落点,能力还要交给独立任务测试;典型 SFT/RL/OPD 的二维表也不能概括所有过程奖励与蒸馏变体。这篇与官方博客属于同一条原始说明链,不能重复当作两份实验。
从 kxzxvbk 的采样信号读到今天学习了吗的共同模板,可以把流程写清:学生不带特权材料生成;教师带额外材料读同一个学生前缀;随后才按选定散度对齐。 这里的关键不是把教师另写的答案按位置硬配给学生。参考解、示范与反馈分别改变教师条件;完整词表、采样 token 与局部支持分别改变反馈信息。OPSD、SDFT、SDPO 的实际散度和教师更新仍按各原论文区分。
Lei Tian 的信息来源表和龟壳的开卷类比,可以帮助理解图中的橙色材料:开卷的是评分教师,原始学生仍在部署条件下作答。类比不保证教师永远正确,也不保证同一模型不会遗忘。中文综述中的成本倍率还要补上分母;生成条数、token、教师评分、FLOPs 与墙钟不互换。
稳定性材料则适合按“现象—机制—干预”阅读。先看相同学生换教师后表现怎样,再看共享候选和熵,最后决定是否试冷启动、提示对齐或额外覆盖。EOPD 的教师高熵解释要接到具体门控与梯度;Your 的问题表可当诊断入口,不能用表中一句概括代替所有论文条件。本文没有把作者推测、统一教师上限或某个实验的重叠范围写成普遍结论。
从地图回到训练过程
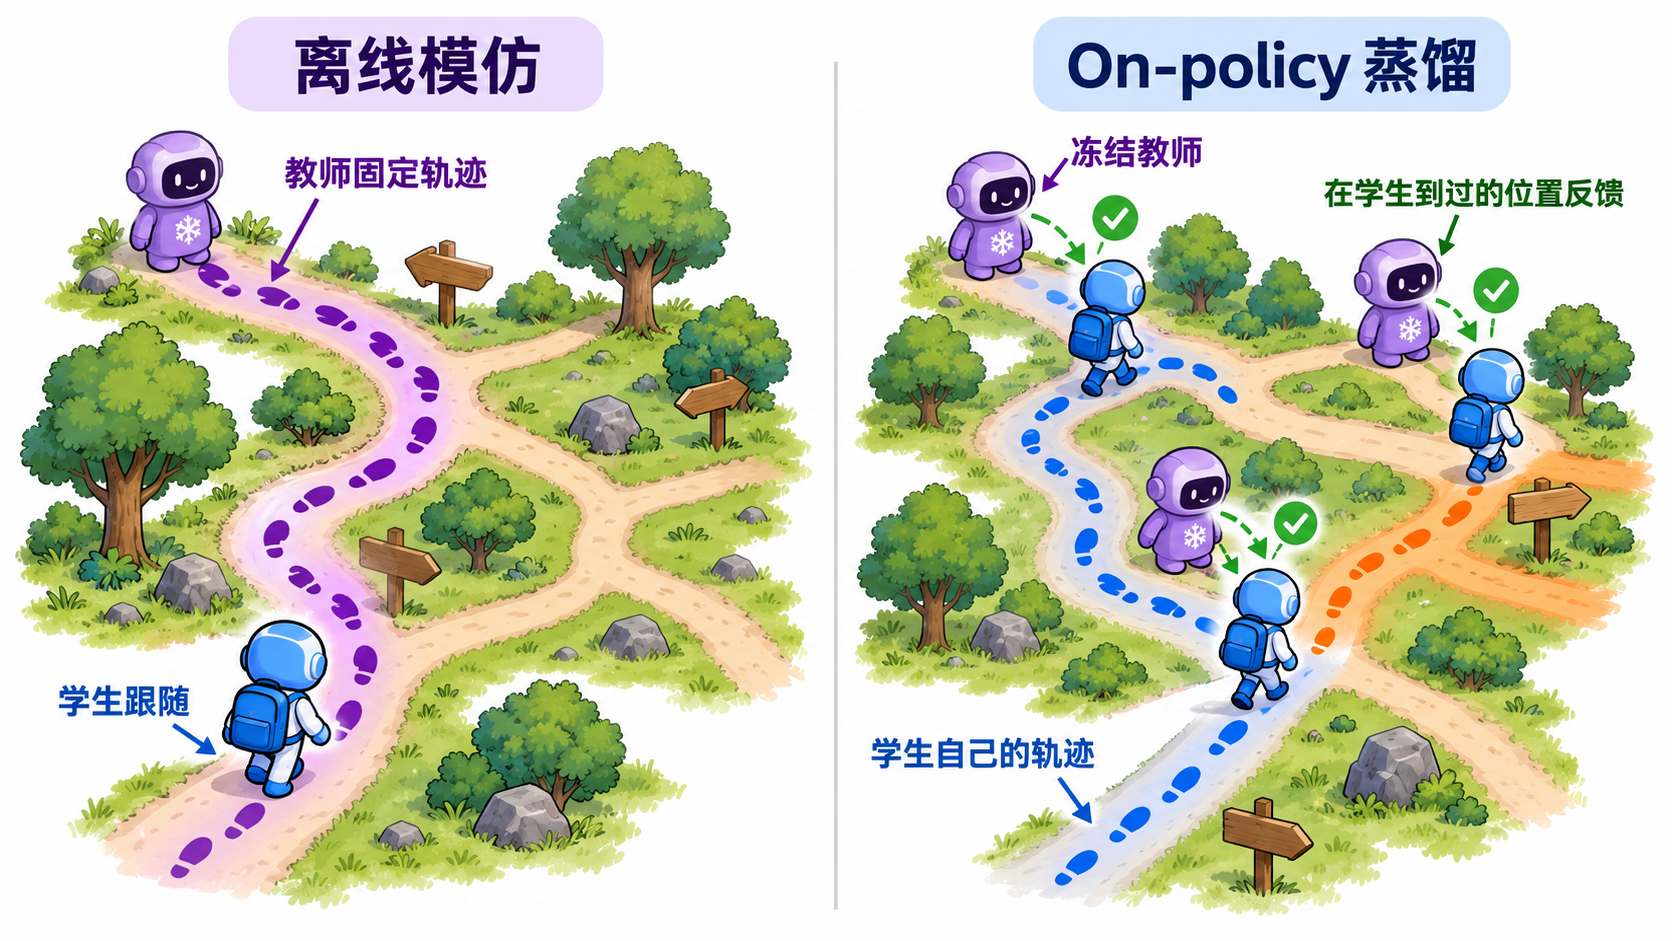
图 2|教师在学生实际访问的位置反馈(已有 ImageGen 教学图)
左侧紫色足迹来自预先生成的教师路线,学生沿它模仿;右侧蓝色足迹由学生自己产生,反馈落在它实际经过的路口。路口对应文本前缀,下一段路对应下一 token。道路只解释训练位置来自谁,不表示所有离线蒸馏都只用一条教师轨迹,也不表示教师能把任何错误前缀挽救成正确答案。
自回归生成会把先前输出带到下一步。若学生早期选错一个 token,它之后读到的历史可能不在固定教师轨迹中。GKD 把教师的逐 token 分布反馈移到学生生成的序列上,并把学生生成数据的比例和分布差异函数设为独立选择。原始依据:GKD §3.1、Algorithm 1。
先问“在哪些前缀学习”,再问“比较什么、怎样反传”。 学生采样不等于必须用 reverse KL,也不等于必须做 PPO/GRPO。GKD 明确停止对学生采样分布的反向传播;X-OPD 则给出基于 token 对数概率差与策略概率比的代理结构。两者都使用学生生成数据,监督与更新仍须分别阅读。
| 需要分开的选择 | 具体观察对象 | 深读位置 |
|---|---|---|
| 数据访问位置 | 固定答案,或学生当前生成的前缀 | 基础机制第 1—2 章 |
| 教师反馈 | 完整词表分布,或当前采样 token 的标量差值 | 基础机制第 2 章、X-OPD 第 2 章 |
| 梯度路径 | 冻结采样权重,或包含采样分布的变化 | 基础机制第 3—4 章、MiniLLM |
| 跨模态接口 | 输入语义、输出 token 和预测位置能否对应 | X-OPD 第 1—2 章、语音扩展 |
读完基础机制,应能解释同一损失换一批前缀为什么改变平均值,以及有限差分时若重新计算本应冻结的采样权重,为什么检查了另一个目标。文内标准库脚本已实际运行;它只检验构造的计算关系,没有训练大模型。完整词表、局部支持与 sampled-token 信号的进一步差别,接续到 MiniLLM、语音与稳定性各篇。
从文本蒸馏到语音条件
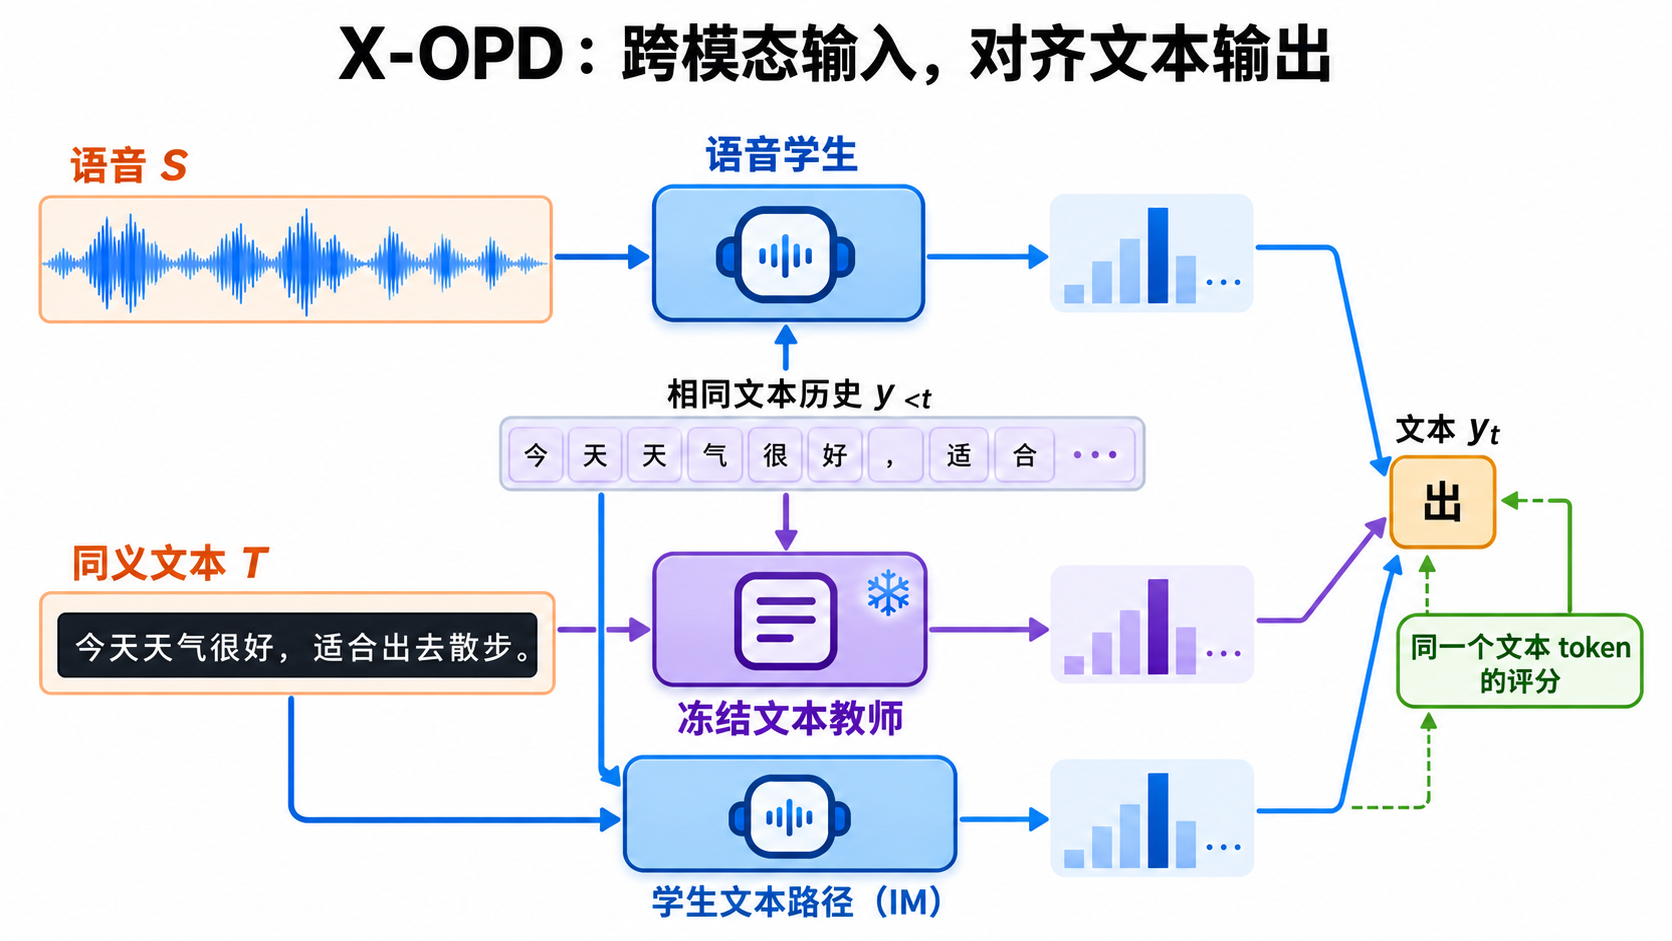
图 3|输入跨模态,评分仍对应同一个文本 token(已有 ImageGen 教学图)
看图中橙色的两种输入:上方是语音问题,下方是同义文本问题。蓝色语音学生读语音,紫色文本教师读文字;中间相同文本历史交给两路模型,右侧比较当前同一个 token。下方另一条蓝线表示学生也在文本条件下评分,为模态内反馈保留参照。
X-OPD 的桥梁因此是语义一致的输入配对与共同文本输出空间。它不是把文本词表第 100 项概率直接当成音频码本第 100 项的监督。论文实验冻结音频塔与适配器,更新语言主干;报告语音输入与文本输入下的回答能力,不能据此推断合成音质或交互延迟。原始依据:X-OPD v3 §3、§4.3、Table 2。
语音深读先检查配对,再检查评分,最后看任务结果。 X-OPD 完整代入两路对数概率差,并用一条两 token、一条一 token 的轨迹说明“先轨迹内平均、再平均轨迹”。结果图保留三任务各自量表;消融则把双目标混合、教师选择和任务条件一起比较。
用于自己的语音系统前,还要沿桥检查:两路是否问同一个问题;教师和学生是否评价同一输出事件;噪声、口音、语气是否在文本化时损失;更新哪些模块;评测是否覆盖真实输入。它们是实施时需要补足的条件,不是论文已证明所有场景有效。语音扩展 再把问题推进到忠实转写、声学前缀、多教师路由与全局回答一致性。
论文版本与实际阅读范围
以下按 arXiv 工作去重;同一论文的旧方法名与当前标题不重复计数。表内范围足以支持对应深读的具体讨论,未覆盖处不据此补造实现或实验结论。
通用机制与序列目标:2 篇
| 原论文 | 版本 | 已读范围 |
|---|---|---|
| GKD,2306.13649 | v3 | 摘要、§3/§3.1、Eq.2/4、Algorithm 1。 |
| MiniLLM,2306.08543 | v6 | §2.1—2.3、§3.1、部分 Table 1;完整算法、附录与 Eq.6 的 EOS 索引约定未完全核对。 |
自蒸馏:3 篇
| 原论文 | 版本 | 已读范围 |
|---|---|---|
| OPSD,2601.18734 | v3 | §3、Figure 2、Eq.6—9、§4.1—4.2、Table 2 与选点协议。 |
| SDFT,2601.19897 | v2 | §3/§3.1、实践选择、§4.1—4.2、Figure 4/Table 1、§5 限制。 |
| SDPO,2601.20802 | v2 | §2/§2.1、§4、Table 2 prompt、附录 A.1—A.3、§7。 |
语音、ASR 与跨模态:4 篇
| 原论文 | 版本 | 已读范围 |
|---|---|---|
| X-OPD,2603.24596 | v3 | §3.1—3.4、§4.1—4.5、Table 2;未由公式推断未读代码的符号或 detach。 |
| Ark-ASR,2605.28139 | v1 | §3.1—3.4、Algorithm 1、实验设置与 Table 1/2、§6 限制。 |
| LS-MOPD,2608.03610 | v2 | §3—4 的目标、语言排名、声学前缀、解码协议与选定结果;非整篇逐字读。 |
| CORD,2601.16547 | v1 | §3.4—3.5 加权与序列奖励、§4.1 设置及可见结果片段;不扩成全实验通读。 |
稳定性与支持集:3 篇
| 原论文 | 版本 | 已读范围 |
|---|---|---|
| Rethinking,2604.13016 | v2 | §4.1/Figure 6、§5.1/Figure 8、§5.2/Figures 9—10。 |
| EOPD,2603.07079 | v3 | §4 Eq.9/Algorithm 1、§5.1—5.2 可见方法与实验段。 |
| Revisiting,2603.25562 | v2 | §3.1—3.2、§4.1—4.2/Table 1;§4.3 仅部分文字,未完整读取 Table 2。 |
中文导读:10 篇、10 位作者
下列十篇均为已注明范围的选段;本次新增八篇,原两篇保留原有范围。它们提供不同读法与检索入口,不能把同一论文的多篇解读当作多份独立实验。
| 中文文章与作者 | 实际阅读范围 | 用途与可信边界 |
|---|---|---|
| ZH01 · 欲壑难填:On-policy Distillation:GKD 和 MiniLLM | 开头、自回归蒸馏与 on-policy KD 段。 | 从固定教师答案进入学生轨迹问题。 作为中文入口;方法和结果仍回原论文。 |
| ZH02 · xyiz:大模型后训练与强化学习(十二):OPD | intro、SeqKD 核心和 OPD 公式,到 SeqKD 对照前。 | 提醒 rollout 来源与 KL 方向可以分开。 不为未读工业案例背书。 |
| ZH03 · 姜富春:OPD(On-Policy Distillation) | 前言、训练阶段、on/off-policy、误差累积、风格置信度与事实区分、逐 token 评分、采样方式×信号密度表。 | Thinking Machines 博客的中文翻译与注释;提供两条比较轴。 与原博客同一说明链,不能当作另一份独立实验;实现标题后未计入。 |
| ZH04 · kxzxvbk:On-Policy Distillation 是什么?如何做? | 核心思想、采样 token reverse KL、全词表引出、tokenizer 难点、自蒸馏 demonstration 条件。 | 连接采样信号、全词表与教师信息来源。 教师另生成答案与在学生原前缀评分要按原论文分开;数值期望不等于直接反传规则。 |
| ZH05 · sanmuyang:LLM RL 2026论文(四)EOPD | KL 背景与方向、mode-seeking、token 目标、教师高熵/top-1 动机、门控 FKL Eq.9。 | 把教师不确定性接到选择性覆盖的动机。 技术形式沿用已核对原论文 v3 的系数与门控;不引未读实验结果。 |
| ZH06 · 恰似故人归:Rethinking On-Policy Distillation of Large Language Models: 现象、机制与配方 | 前言及作者归纳的现象—机制—配方三层。 | 帮助区分任务现象、分布观察和干预。 非全文;归纳来自指定实验,不作普遍必要充分定理或统一重叠阈值。 |
| ZH07 · Lei Tian:【非对称OPD方法】SDPO:把“自我回顾”当 teacher 在 rich feedback 上做 on-policy 自蒸馏 | 非对称上下文、信息优势、feedback 表、GRPO scalar 引出、文末局限与 Biology 推测。 | 按额外信息类型比较方法,并区分待解释现象与假说。 中间精确 SDPO 优势公式未读;Biology 原因是作者推测;同一模型不保证无遗忘。 |
| ZH08 · 龟壳:On-Policy Distillation 调研与学习 | 基础引用、off-policy、OPSD 开卷/闭卷与成本简述、SDPO 相关可见选段。 | 综合检索入口与教师条件的直观类比。 未定位到 X-OPD,不登记语音部分已读;成本简述不能直接当总 FLOPs 或墙钟。 |
| ZH09 · 今天学习了吗:OPD 专栏3:上下文与经验内化 | 前言及共同模板:无特权学生 rollout、带 c 教师在原学生前缀评分、token 散度;c、D 与特权泄漏三项差异。 | 把额外上下文转成权重的流程拆成可检查步骤。 未读其余逐篇方法;共同模板不能抹平各论文实际散度、教师更新与实现。 |
| ZH10 · Your:OPD (2): 学术Paper篇 | Takeaway、tokenizer/重叠/KL/agent 问题对照表、Rethinking Figure 6 的成功与失败解释。 | 把研究问题整理成复现时的诊断入口。 非全文;不采用“OPD 仅能模仿且被教师上限锁死”的绝对说法,也不为表中未读论文背书。 |
官方实现说明与分类索引
| 官方说明 | 实际阅读与边界 |
|---|---|
| Kevin Lu:On-Policy Distillation,2025-10-27 | 读 Implementation:γ=0 只取即时信号、教师一次 forward 可评分 partial rollouts;未运行 Tinker cookbook,也不把它等同所有序列目标。 |
十二篇论文、十篇知乎选段与一篇官方博客选段,构成 23 个实际阅读内容来源。awesome-on-policy-distillation 另作分类检索索引:目录约 800 项,未逐条阅读,不能计作已读论文或实证支持;与内容来源合计 24 条书目入口。
继续阅读时补什么证据
下一步优先补官方实现及确切 revision、未读完整附录与表注、teacher checkpoint 和训练细节,再做目标条件下的复现。MiniLLM 的精确 EOS/长度索引、部分多任务表格、ASR 的严格成本对照、语音长时与延迟测量,各在深读中保留边界。不要用邻近方法的默认配置填空。
教学手算和确定性图验证概率、梯度与平均单位;论文结果仍属于作者报告。读完一条路线,应能指出输入条件、访问前缀、反馈支持集、更新对象和评测单位。 然后再决定该改配对、教师、损失、采样还是预算。
需要 KL 方向、温度与跨 tokenizer 的前置解释时,回到 07 的第 4—5 章,再沿本页进入相应深读。
正在连接 GitHub 评论…