07.1.3|MiniLLM、GKD 与序列蒸馏的三种选择
文中区分原始目标、实际训练修正与教学设定;教学算例不代表模型实测。MiniLLM 的长度归一化索引、完整算法和代码细节尚未全部核实,本文不提供完整模型训练实现。
“用教师生成的数据训练学生”和“让教师评价学生生成的回答”改变了训练历史;选择前向或反向 KL 又改变了差异的计算对象;即使写出同一个数学期望,是否对采样分布求导仍会改变更新。本篇的三种选择是历史来源、反馈对象与更新路径;SeqKD、GKD 和 MiniLLM 在这些坐标上采用不同组合。
先看同坐标机制图,再读 MiniLLM 的序列目标和两步手算,最后区分原始目标、实际 recipe 与任务结果。本文沿用 MiniLLM 的符号: 是冻结教师, 是参数为 的学生;判断 KL 方向应认清模型角色,不能只凭字母名称。
本篇目录
- 1. 三种选择放在同一张图中
- 2. MiniLLM 优化的是序列分布
- 3. 两步手算:未来回报与前缀权重
- 4. 从原始目标到可训练的估计
- 5. Table 1 的结果与条件
- 6. 可以比较的结论与尚缺的证据
1. 三种选择放在同一张图中
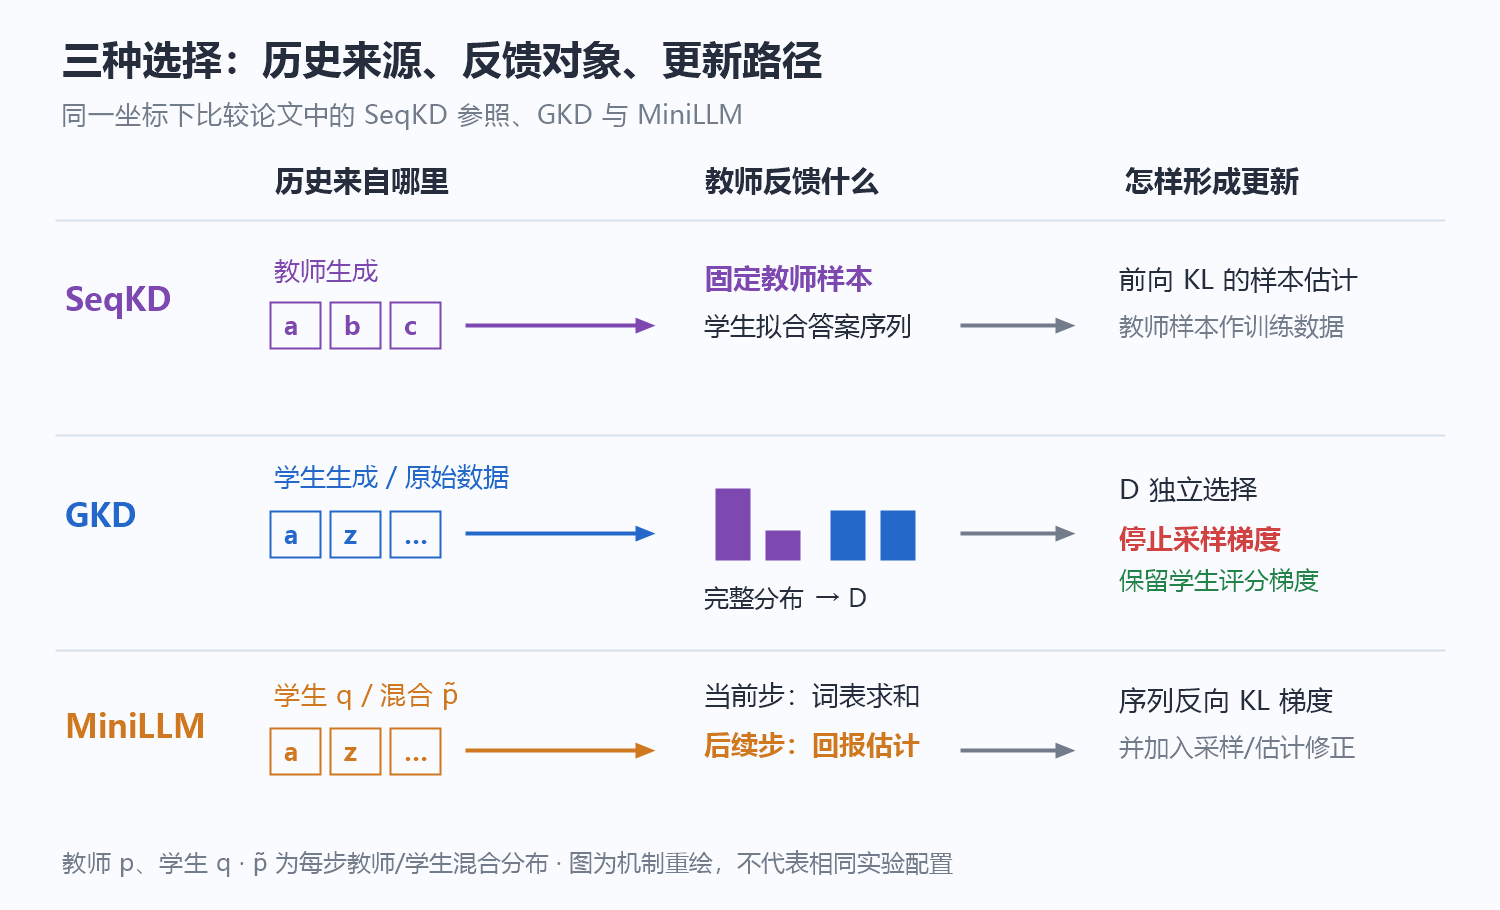
图 1|同坐标机制重绘,非相同实验配置
1.1 固定教师答案与学生实际经过的历史
先沿图中每行的 token 格子读。第一行中教师产生回答,学生用这些序列训练;这里的 SeqKD 特指 MiniLLM 论文所定义的基线。原文 Figure 3 用前向 KL 描述这一路,§3.1 将其定义为在教师生成数据上微调。若理想情况下能对教师的全部序列分布求期望,最小化交叉熵与最小化 相差一个不依赖学生参数的教师熵;实际有限教师样本只是这个期望的估计。来源:MiniLLM §2、Figure 3、§3.1 Baselines。
第二行 GKD 允许选择学生自己产生的序列,也允许使用原始训练数据。教师在同一学生前缀上提供完整下一 token 分布;学生因此不只学习跟随教师答案,也在自己经常访问的历史上接受反馈。GKD Algorithm 1 的 控制学生数据分支的选择概率,;它不是一个已经指定好的 KL 权重或策略梯度系数。来源:GKD §3.1、Algorithm 1。
第三行的 MiniLLM 从学生序列分布出发定义原始目标,实际训练再加入逐步教师混合采样。这里不能把“on-policy”简化为最终每个 token 都只从未经混合的学生分布产生:原始优化分布与实际采样分布需要分别写明。
1.2 完整分布与轨迹回报承担不同角色
观察中列。GKD 的序列差异是各位置分布差异 的长度平均, 可以独立选择;原文明确不对学生采样分布反传,但当前位置的学生评分仍可求导。MiniLLM 则首先选择序列级反向 KL,再推导包含后缀回报的梯度;它的单步分解也会对完整词表直接求和,不能把整种方法画成只有一个采样 token 的标量监督。
| 比较项 | SeqKD:本文所读基线 | GKD:已有原文证据 | MiniLLM:本次原文证据 |
|---|---|---|---|
| 历史来源 | 教师生成的训练序列 | 原始数据或学生序列,按 batch 选择 | 原始目标用学生序列;recipe 用逐 token 教师混合 |
| 反馈对象 | 训练中的教师答案序列 | 同前缀完整词表分布的差异 | 当前步完整词表期望与后缀回报分工 |
| 目标与更新 | 论文以 forward KL 的样本训练为参照 | 差异 独立选择,采样分布停止梯度 | 序列 reverse KL 的梯度,再加入估计与训练修正 |
| 最容易混淆之处 | 教师答案不等于每步都返回软分布 | 学生采样不自动意味着策略梯度 | 原始无偏式不等于最终采用的近似权重与长度处理 |
这些差异解释的是算法设计,尚不构成跨论文的性能排名。两篇论文的归一化、数据与基线条件必须各自保留。
2. MiniLLM 优化的是序列分布
2.1 从整句概率到反向 KL
令输入为 ,输出为 , 是输出长度, 是位置; 表示当前位置可见的输入与历史。学生、教师对整句的概率均由条件概率相乘得到。MiniLLM Eq. (1) 的目标是:
表示按下标分布求平均; 来自任务输入分布,内层遍历学生可能产生的完整序列。概率与损失均无物理单位,本文使用自然对数。教师固定,但学生既在对数比内部出现,也决定哪些序列更经常被抽到。来源:MiniLLM §2.1、Eq. (1)。
原文将 reverse KL 与其对主要模式的关注联系起来,并以示例和实验讨论生成质量。这里不能只靠“mode-seeking”一词就保证任意任务、教师或学生都会得到更好回答;具体能力仍由对应实验支持。
2.2 当前 token 的差值与未来回报
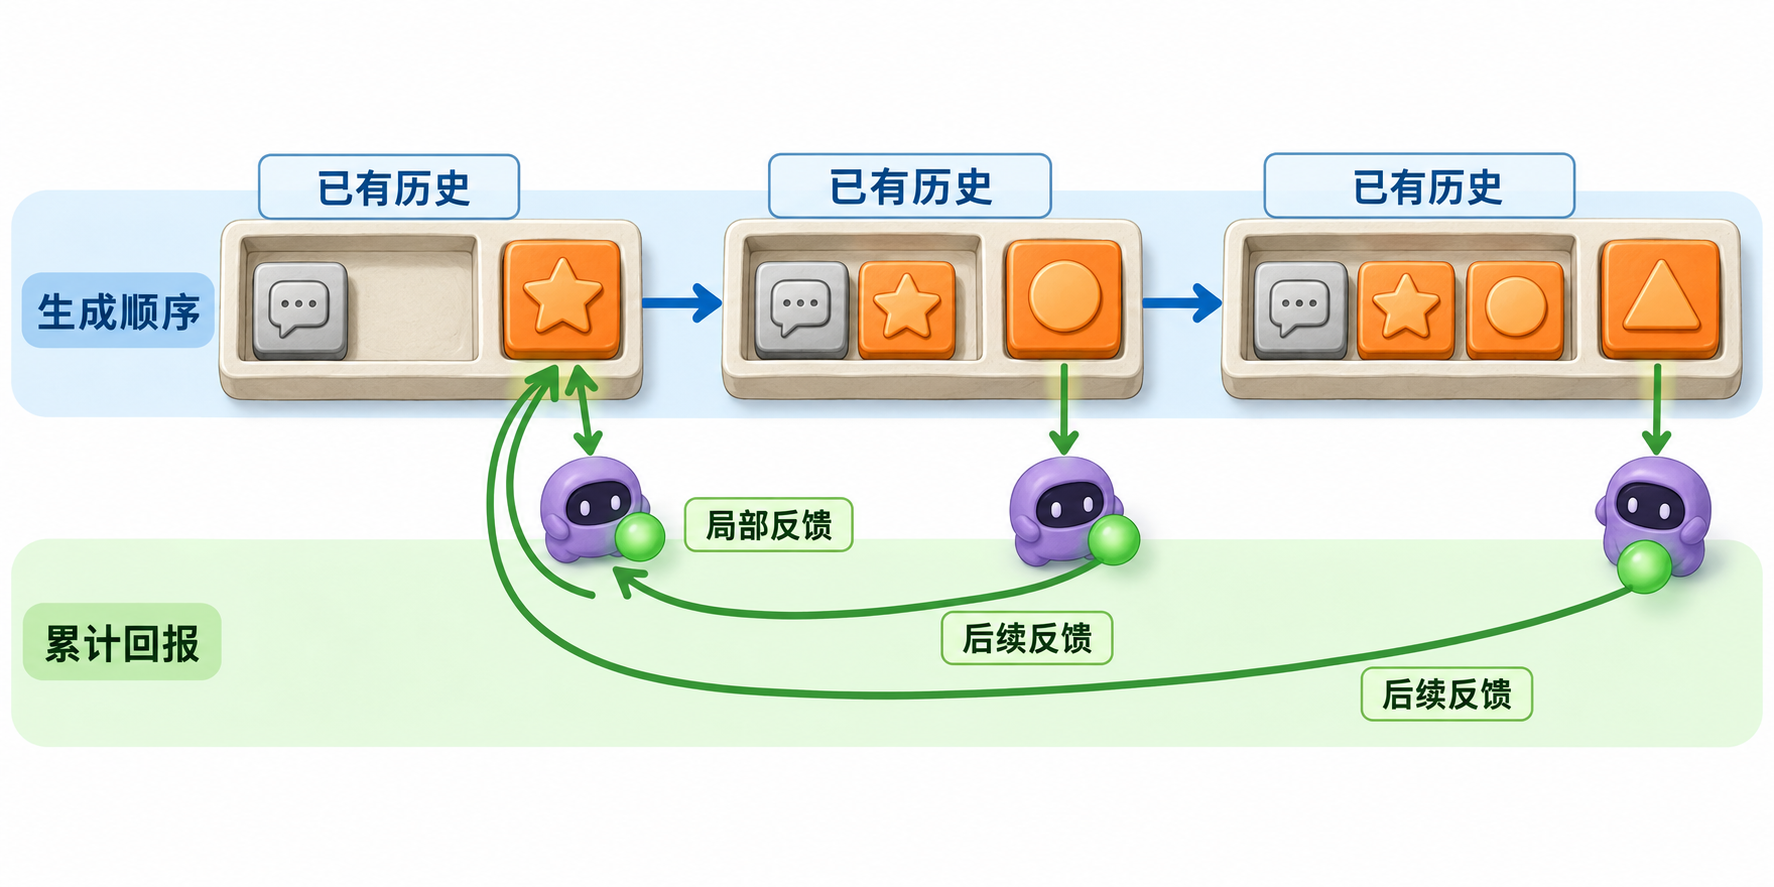
图 2|同一轨迹的前向生成与回顾反馈(ImageGen 教学示意)
先沿上方蓝线从左向右读:第一步选出的橙色星形,留在后面两段“已有历史”中;第二步选出的圆形,到第三步才进入历史。下方绿线分开表示当前局部反馈与从后续位置返回早期选择的反馈。长绿线表示更新早期选择时纳入后续信息,不表示未来 token 提前进入模型输入。 固定前缀局部目标仍可在每个位置计算损失,所冻结的是生成选择的采样路径;累计回报则进一步说明早期选择如何关联后续路径。
MiniLLM 定义当前位置的对数概率差 与从该位置起的后缀回报 :
是后缀求和索引,包含当前步 直至终点 。因此 是当前事件的评分差, 还携带这次选择之后的路径信息。原文 Eq. (2) 给出的原始梯度为:
是参数梯度;外层简写仍表示先取输入、再取学生序列,括号内求各步贡献之和。 衡量参数怎样影响当前选择的概率;式中的 保留原文定义。这个式子所讨论的是原始序列目标,尚未加入后面的混合采样、近似权重与长度归一化。来源:MiniLLM §2.2、Eq. (2)。
与 GKD 的停止采样梯度并读时,关键区别便清楚了:同样沿学生历史读教师,并不意味着两种更新都忽略序列出现频率随参数变化的影响。
3. 两步手算:未来回报与前缀权重
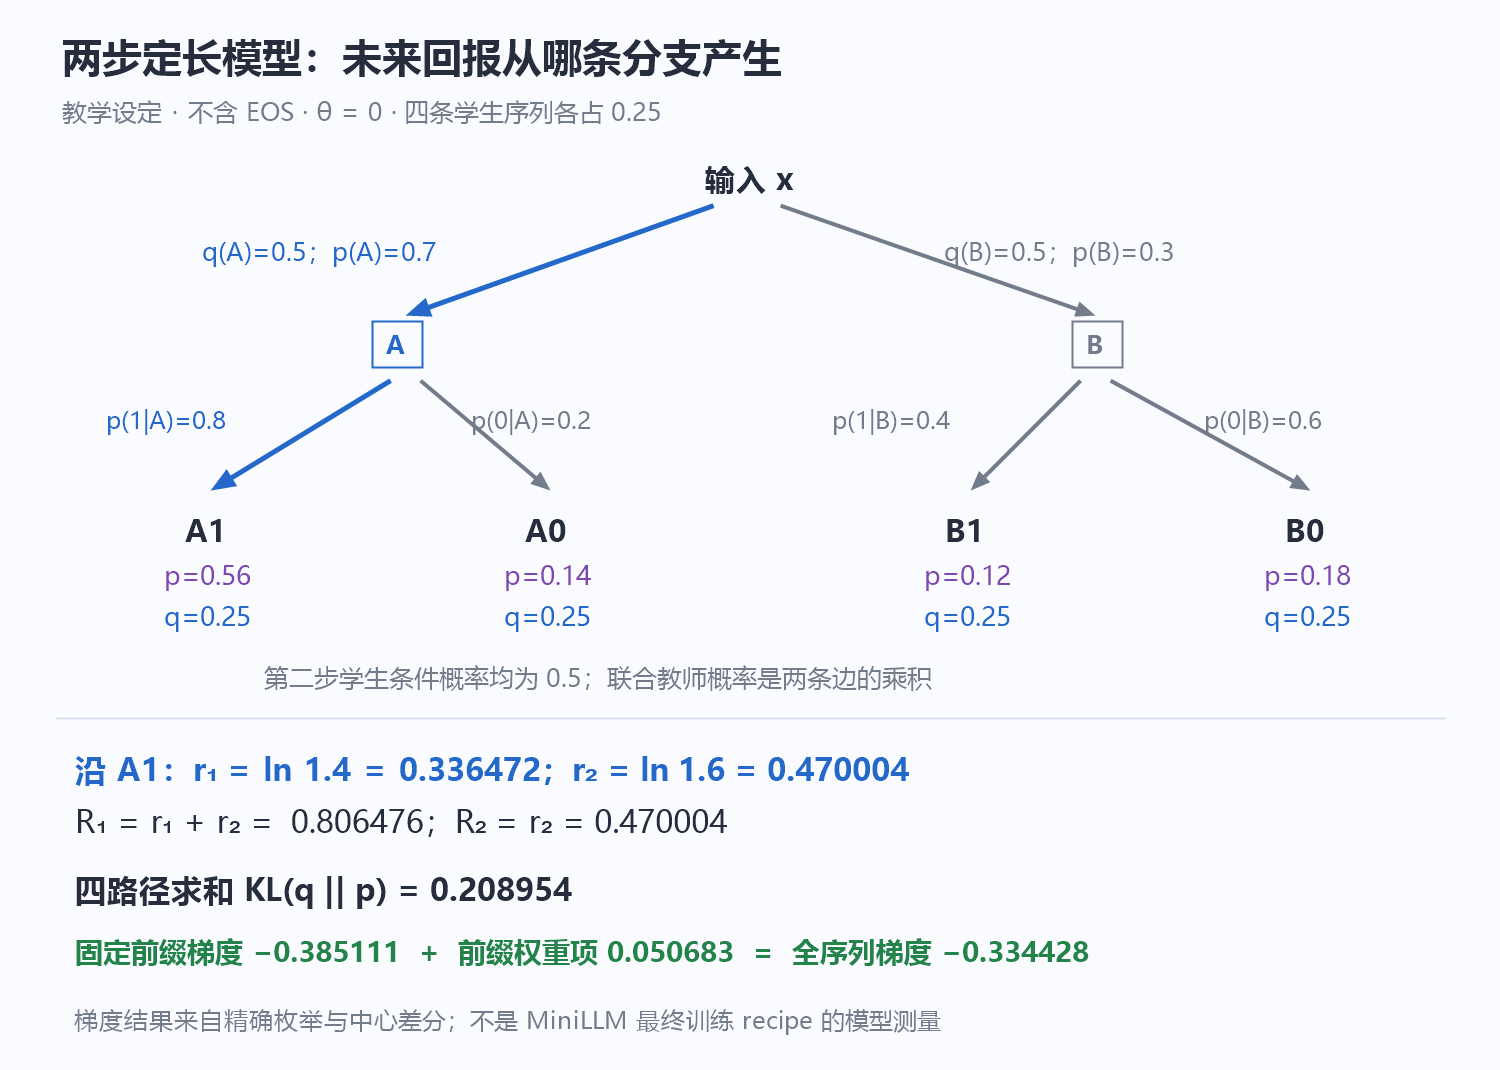
图 3|定长两步教学模型:先算路径概率,再算回报与梯度
3.1 四条路径合成一个序列目标
图 3 是教学设定,不是论文训练数据。固定输入后,第一步输出 或 ,第二步输出 或 ,恰好两步结束,不含 EOS。教师第一步概率为 ;已有 时,教师给 ,已有 时给 ,相应的 概率为补数。
令学生使用一个标量参数:
是自然常数, 是 sigmoid 函数;同一 同时影响第一步和 之后的学生评分。取 ,学生所有边的条件概率均为 ,因此每条完整路径概率为 。
| 路径 | 教师联合概率 | 学生联合概率 | |
|---|---|---|---|
| 0.25 | −0.201619 | ||
| 0.25 | 0.144955 | ||
| 0.25 | 0.183492 | ||
| 0.25 | 0.082126 |
四项之和为 。单条路径的贡献可以为负,完整 KL 仍为非负。沿蓝色 路径,当前差值与后缀回报为:
第一步选择 ,会把学生带到下一组条件分布;因此仅用 无法表达这条路径后续发生了什么。这正是图中一条边的评分与整段后缀回报的区别。
3.2 固定前缀评分与完整序列梯度
为单独观察梯度路径,本例统一使用两步损失之和,不直接比较 GKD 按长度平均后的目标数值。第一步局部 reverse KL 为 ;第二步在 两处的局部值分别为 。序列 KL 可以核对为:
这里 是两组二元分布的 KL,不是两条完整回答的损失。若对第一步与 后评分直接求导,局部导数为:
分别表示两处局部 KL 对同一标量 的导数,。冻结前缀的出现权重时,得到 。完整求导还需计入第一步选择 的概率随 变化:
下标 fixed、outer、full 分别指固定前缀的局部评分项、前缀权重变化项与完整导数。同样访问学生前缀,保留或去掉前缀权重的导数,本例得到不同更新。 这是一组数学对照,不是在同一模型和任务上重跑 GKD 与 MiniLLM。
配套标准库验算精确枚举四条路径,分别计算原始 Eq. (2) 的期望、上述分解与中心差分。Python 3.12.14 实际运行得到完整梯度 ,固定前缀梯度 ;差分步长为 ,两种差分的绝对误差均小于 ,断言容差为 。该验算没有训练语言模型,也没有实现最终 MiniLLM recipe。
4. 从原始目标到可训练的估计
4.1 当前一步直接求和,后续回报继续估计
MiniLLM §2.2 将原始梯度拆成 single-step 与 long-term 两部分。当前步对词表中所有候选的期望可以直接求和,而不用仅依赖一次采样的 ;余下后缀的影响仍通过回报估计。作者以更精确的单步估计减少训练方差为动机。图 3 中,固定一个路口以后可以列出它的两条候选边;走过哪条边以后还会访问什么路径,则是另一个问题。来源:MiniLLM Single-Step Decomposition、Eq. (3)。
这也说明“反向 KL 等于只看采样 token”过于粗略。目标选用了什么分布差异,和实际用完整求和、蒙特卡洛还是二者结合来估计,是不同层次的选择。
4.2 教师混合采样与权重近似
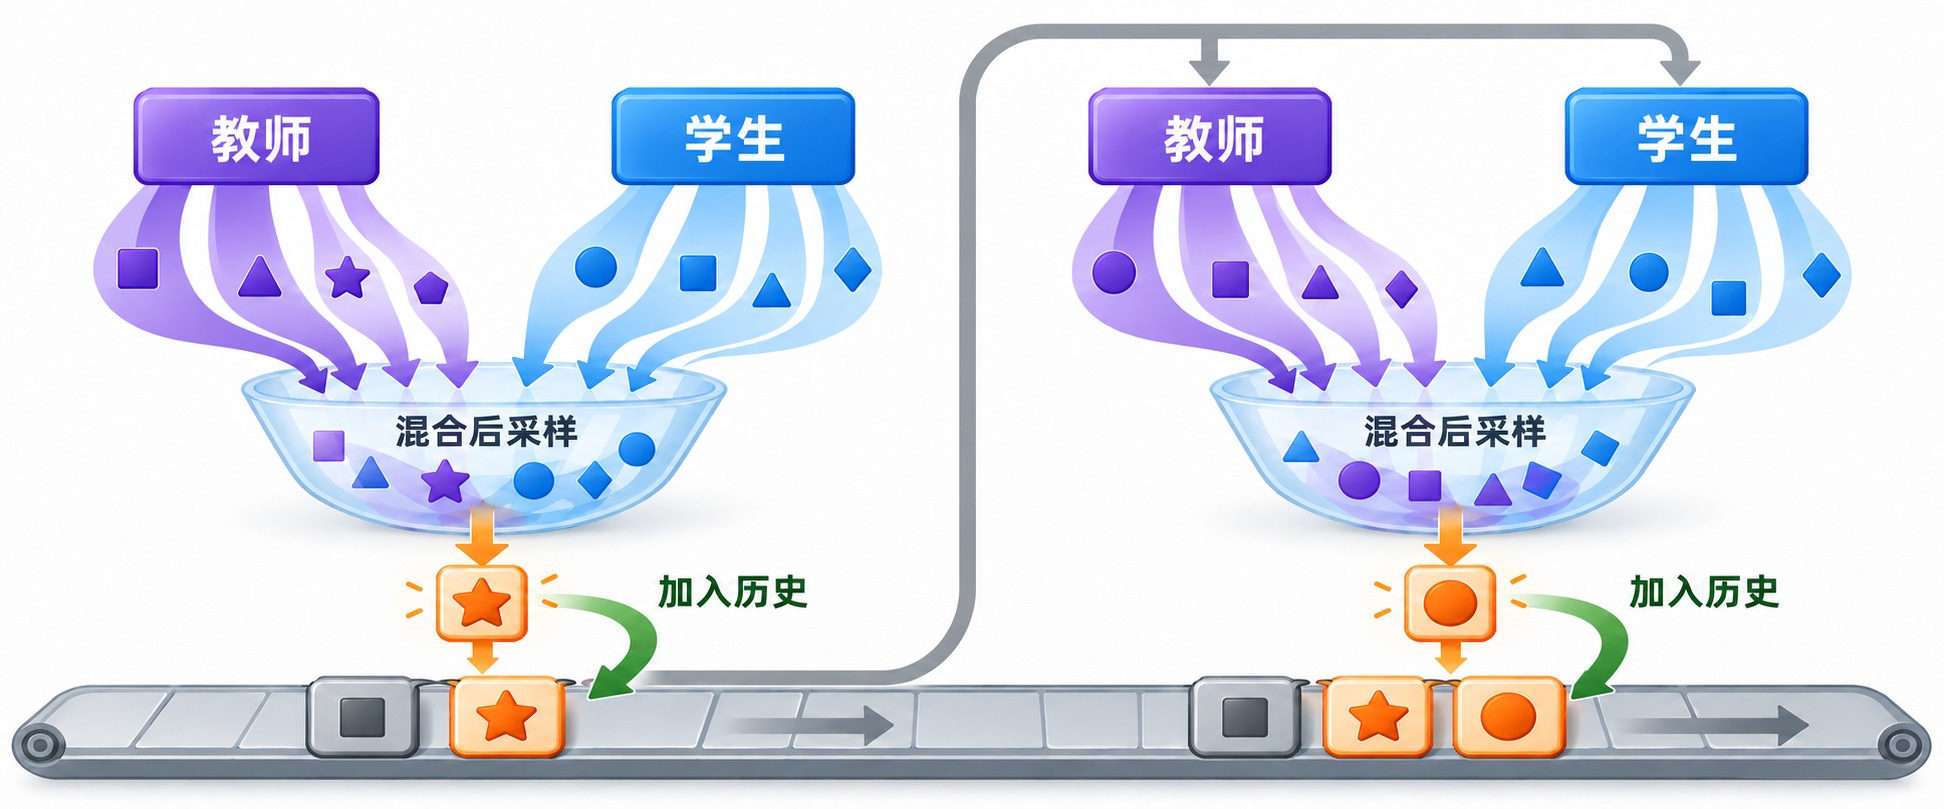
图 4|每个位置先混合概率,再抽一个 token(ImageGen 教学示意)
观察左侧取样槽:紫色教师与蓝色学生提供两组候选概率,合入同一槽后只抽出一个橙色星形,再将它加入底部的历史。灰色路径把这段更新后的相同历史分别送入右侧教师与学生,两路重新计算分布,右槽才抽出下一个圆形。混合发生在每个位置的概率分布上;图中只有一条持续增长的输出序列。
MiniLLM 报告学生采样可能出现重复短语等获得教师高分的退化回答,因此在每一步混合教师和学生分布:
遍历当前词表, 是实际混合采样分布, 控制教师分量;它改变取样槽中的概率配比,损失权重则控制优化项的贡献,作用对象不同。这是逐 token 混合,与 GKD 按 batch 选择学生数据的 含义也不同。改变采样分布后,论文先用重要性采样改写估计:
是当前 token 的概率比, 是到当前位置为止的前缀乘积, 表示逐项相乘。原文随后指出跨步乘积的方差问题,实际近似使用 。当前比值是实际采用的近似,不能直接称作原始乘积的精确无偏替代。 来源:MiniLLM Eq. (4)/(5) 及其后权重近似段。
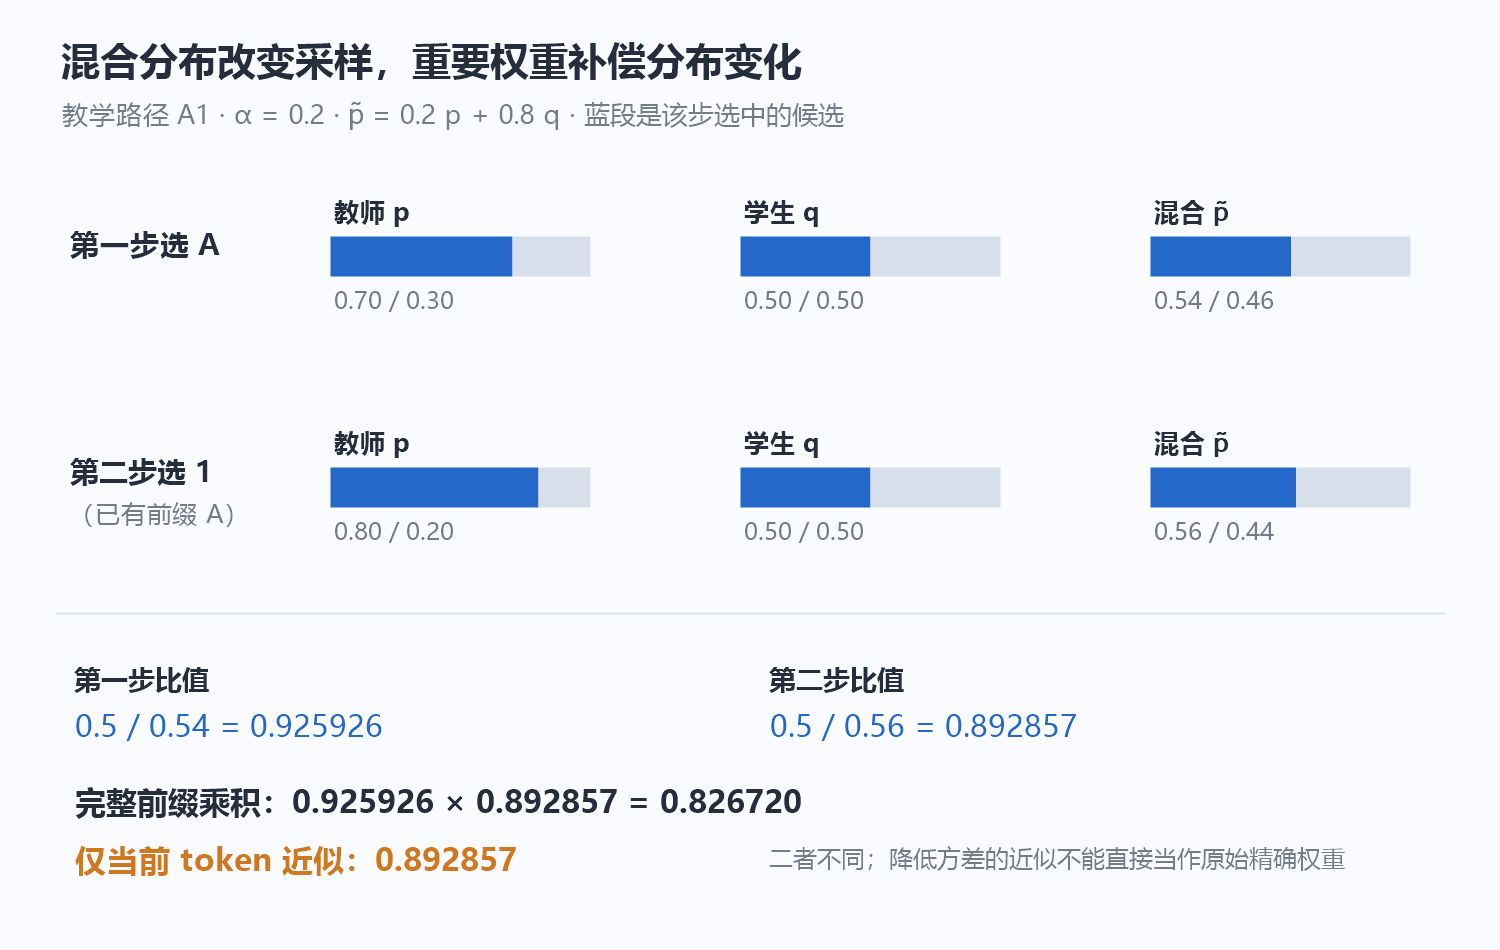
图 5|教学概率:混合采样后的完整权重与近似权重
沿图 5 的教学路径 ,取 ,第一步混合概率为 ;第二步为 。由此:
只保留当前比值就得到 ,与完整乘积不同。例中 与论文报告的设置一致,但这些概率是教学设定,不能从它们推断真实训练的方差或收益大小。
4.3 长度、初始化与通用能力约束
原文的 Length Normalization 针对后续回报与回答长度的关联,引入对 long-term 回报的长度处理。所采用版本的 Eq. (6) 求和范围为 到 ,分母显示为 ;EOS、终止位置或索引约定尚未由完整算法和代码核实。本文保留其机制意图,不改写分母,也不提供可直接用于实现的精确长度公式。
§2.3 还规定先在任务数据上微调,选最低 loss 的 checkpoint 作为后续初值;之后加入预训练语言模型损失以保护通用能力,并使用 clipping 策略改善稳定性。损失如何裁剪、哪些中间量停止梯度、具体系数怎样设置,仍需完整算法或官方实现支持,不能由“类似 RLHF 流程”反推全部细节。来源:MiniLLM §2.2 Length Normalization、§2.3。
因此本文区分三层:Eq. (1)/(2) 的原始数学目标,单步分解与混合采样的估计方式,以及长度、初始化、LM loss、clipping 的训练 recipe。解释第一层不等于已经证明第三层每一步都无偏优化同一个未修改目标。
5. Table 1 的结果与条件
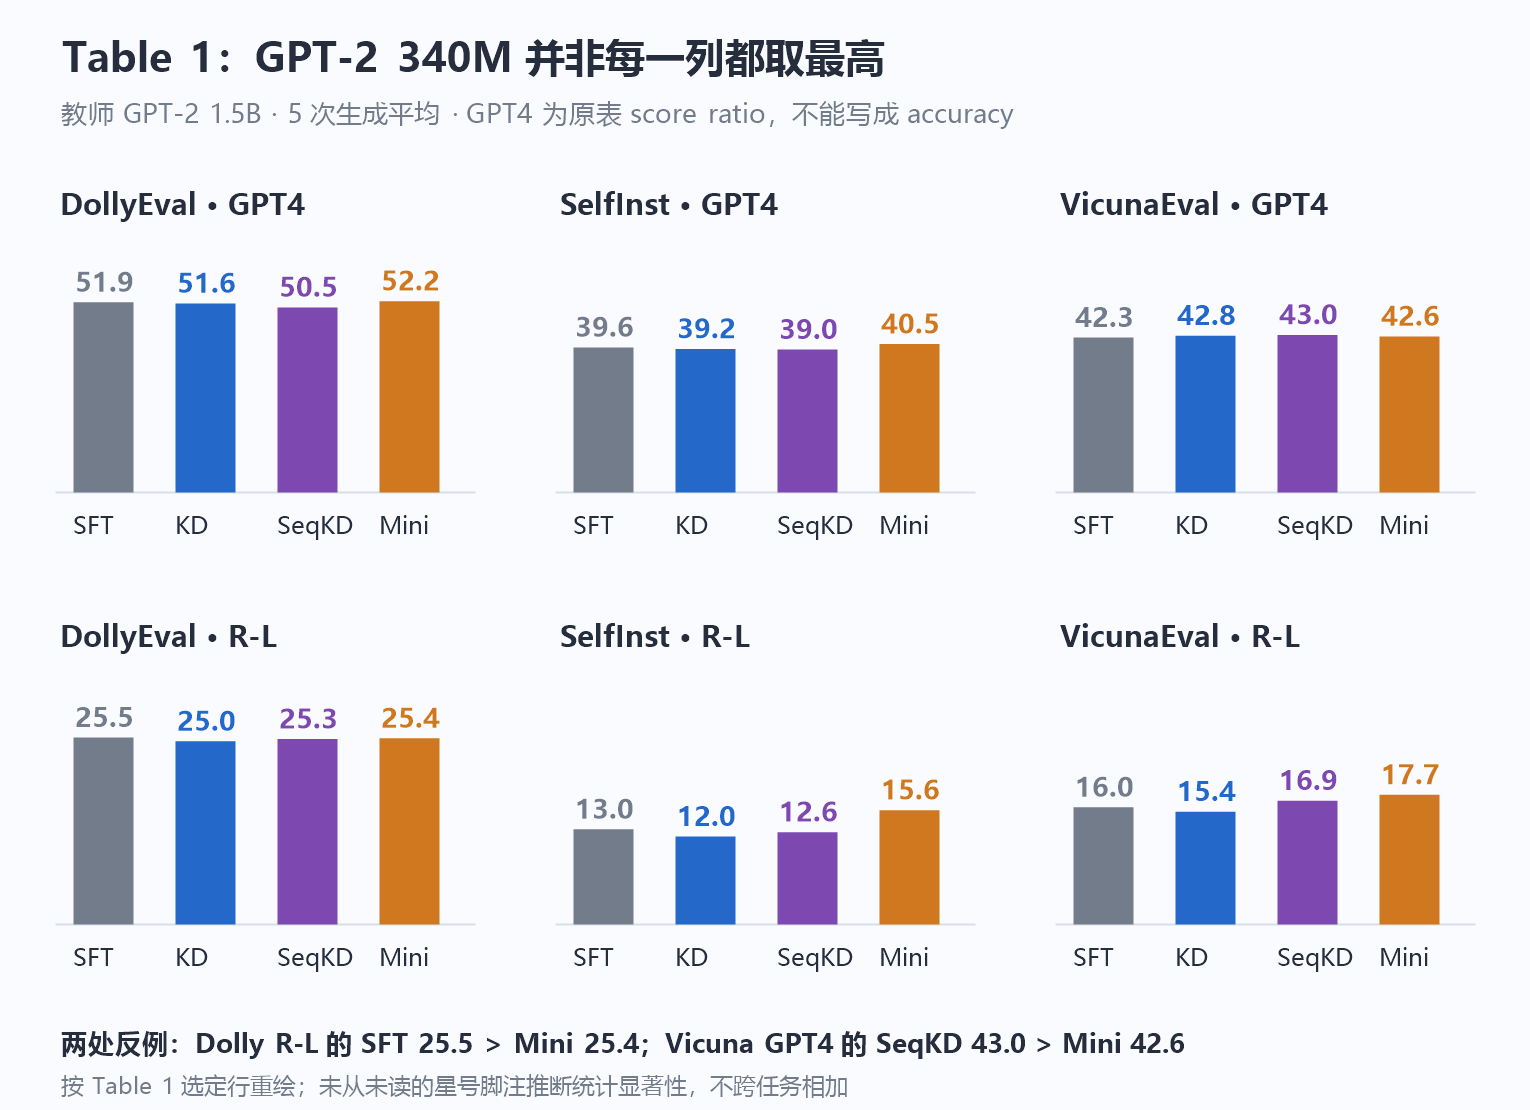
图 6|按 MiniLLM Table 1 的 GPT-2 340M 行重绘
5.1 指标与模型条件先于提升数字
图 6 固定一组教师/学生,只看同表同一组基线。上排是原表 GPT4 score,下排是 R-L(Rouge-L);每个面板有自己的量表,图中统一从零起画。论文将 GPT-4 指标定义为模型回答与参考答案总分之比,不是 accuracy。SelfInst 的人工评测另以 Win/Tie/Loss 比较回答;这里没有把尚未读取的人工结果画成柱状图。
| 条件 | 当前研究证据 |
|---|---|
| 本图模型 | 学生 GPT-2 340M;同组教师 GPT-2 1.5B |
| 原文研究模型范围 | GPT-2 120M/340M/760M、OPT 1.3B/2.7B/6.7B、LLaMA 7B;教师分别为 GPT-2 1.5B、OPT 13B、LLaMA 13B(MiniLLM §3.1) |
| 数据 | Dolly 15k 清洗后约 12.5k 训练、1k 验证、0.5k 测试(MiniLLM §3.1) |
| 教师混合 | 报告设置 (MiniLLM §3.1) |
| 测试 | 温度为 1,每个提示用不同随机种子生成 5 次,报告平均分 |
| 图中范围 | Table 1 的 GPT-2 340M 三数据集六列;不概括全部模型或任务 |
| 尚缺信息 | 原表星号完整脚注、人工评测结果与完整 judge 协议未读;不推断显著性 |
5.2 看见改善,也保留未取最高的列
在 DollyEval 的 GPT4 列,SFT、KD、SeqKD、MiniLLM 分别为 ;MiniLLM 高于这三条基线。但同一数据集 R-L 为 ,MiniLLM 没有超过 SFT 的 。
SelfInst 的 R-L 为 ,MiniLLM 较高;其 GPT4 为 。到 VicunaEval,GPT4 为 ,SeqKD 更高;R-L 则为 ,MiniLLM 更高。同一组模型下,不同评价对象仍会给出不同排序。 来源:MiniLLM Table 1,GPT-2 340M 行。
这些数字支持“在这组任务与指标上出现多处改善,也存在未取最好值的列”,不支持“reverse KL 对所有评价都必然更好”。五次生成的平均也不能直接变成五次独立模型训练,缺少不确定性定义时不能仅凭微小差值判断可靠胜负。
6. 可以比较的结论与尚缺的证据
SeqKD、GKD 和 MiniLLM 不宜画成一条只写“越来越强”的时间线。它们在历史来源、教师反馈和梯度估计上给出不同选择:固定教师数据侧重拟合教师样本;GKD 将反馈移到学生访问的历史,同时明确冻结采样分布的梯度;MiniLLM 则从序列 reverse KL 推导包含后缀的原始梯度,再用估计和训练修正取得实际算法。
后续研究若声称继承其中一条路线,应该逐项问:它沿用了哪种历史,教师返回什么,优化的分布差异是什么,未来回报如何处理,混合或近似改变了什么,成本与能力又由哪个实验支持。仅共享“on-policy”名称不足以省略这些条件。
本文尚未完整核对 MiniLLM Eq. (6) 的 EOS/索引约定、完整 Algorithm 1、官方实现与原表脚注,不据此补写精确实现或统计显著性结论。GKD 的具体算法与原文定位见前置机制文。
版本与来源。 MiniLLM 采用 arXiv:2306.08543v6,2026-01-31,当前标题为 On-Policy Distillation of Large Language Models,作者 Yuxian Gu、Li Dong、Furu Wei、Minlie Huang,会议记录为 ICLR 2024;“MiniLLM”是本文保留的方法名称,与上述条目对应同一项工作。GKD 依据为 arXiv:2306.13649v3,2024-01-17。本站未进行这些模型的训练或基准复现。
正在连接 GitHub 评论…