07.1.2|X-OPD:语音 LLM 的跨模态能力对齐
把同一句问题打字输入和说出来,模型可能给出质量不同的回答。X-OPD 把这个差距转成训练信号:让语音学生沿自己生成的文本轨迹前进,再请冻结的文本教师评价同一条轨迹。它继承了 OPD 的采样位置选择,同时增加一座桥:输入可以跨模态,逐 token 比较必须落在同一个文本输出空间。
本文依次读输入配对、两路评分、轨迹归一化和实验结果。论文依据为 arXiv:2603.24596,v3(2026 年 6 月 12 日);插图为本站教学图,精确结果图按原表重绘。
1. 语音与文本如何配对
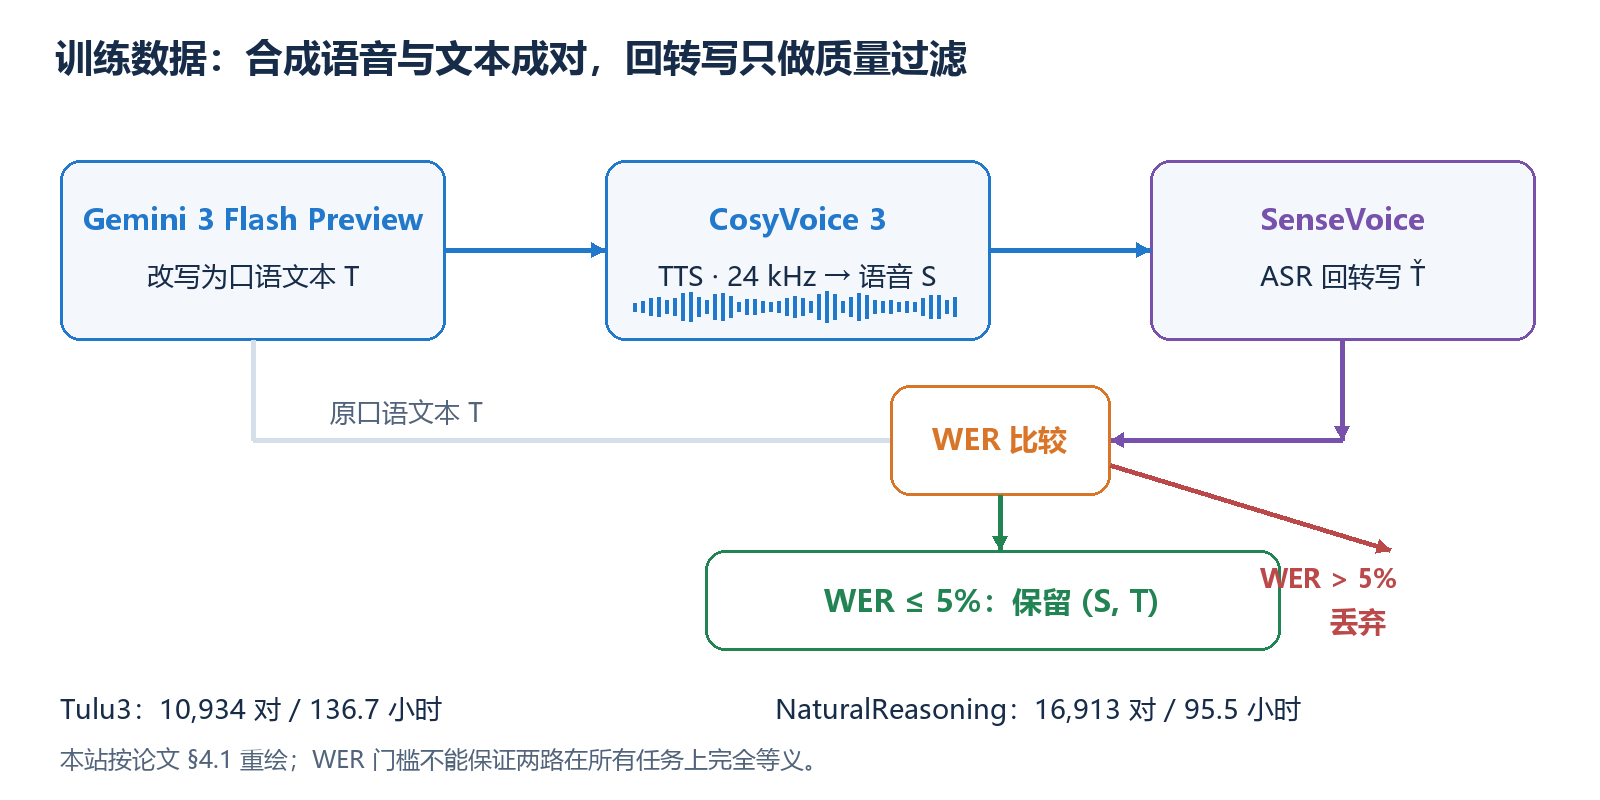
图 1|口语文本、合成语音与回转写过滤(按论文 §4.1 重绘)
图中最重要的对象是最终保留的 : 表示语音输入, 表示与它语义一致的文本输入。论文 §3.1 允许从文本经 TTS 合成语音,也允许从语音经 ASR 获得转写。它们提供两种输入视角,让文本教师能够评价语音学生面对的同一个问题。
这座桥并不要求文本教师直接听懂波形。教师只需要读取与语音问题相对应的文本,再在共同的文本输出空间给分。因此,监督能从文本侧转移过来,关键依靠的是问题语义与输出位置的对应关系,而非把两个模型的音频表示硬接在一起。
论文实验采用图中的合成路径:用 Gemini 3 Flash Preview 将材料改为口语形式,再用 CosyVoice 3 生成 24 kHz 语音;SenseVoice 回转写后,丢弃词错误率 WER 超过 5% 的样本。图中灰线保留原口语文本,紫线带回 ASR 结果,两者一起进入过滤器。保留下来的 Tulu3 数据有 10,934 对、136.7 小时,NaturalReasoning 有 16,913 对、95.5 小时。
这一步解释了配对的作用,也界定了它的局限。WER 检查语音能否较好回转成文本,不能保证语气、重音、歧义以及改写前后的所有信息都完全保留。若两路问题本来就不同,后面的分数差就会混入输入差异,无法单纯解释为学生的能力差距。这里的“同义”是跨模态监督成立的前提,而非过滤阈值自动证明的结论。
2. 同一文本 token 的两路评分
两路输入怎样落到同一个输出位置
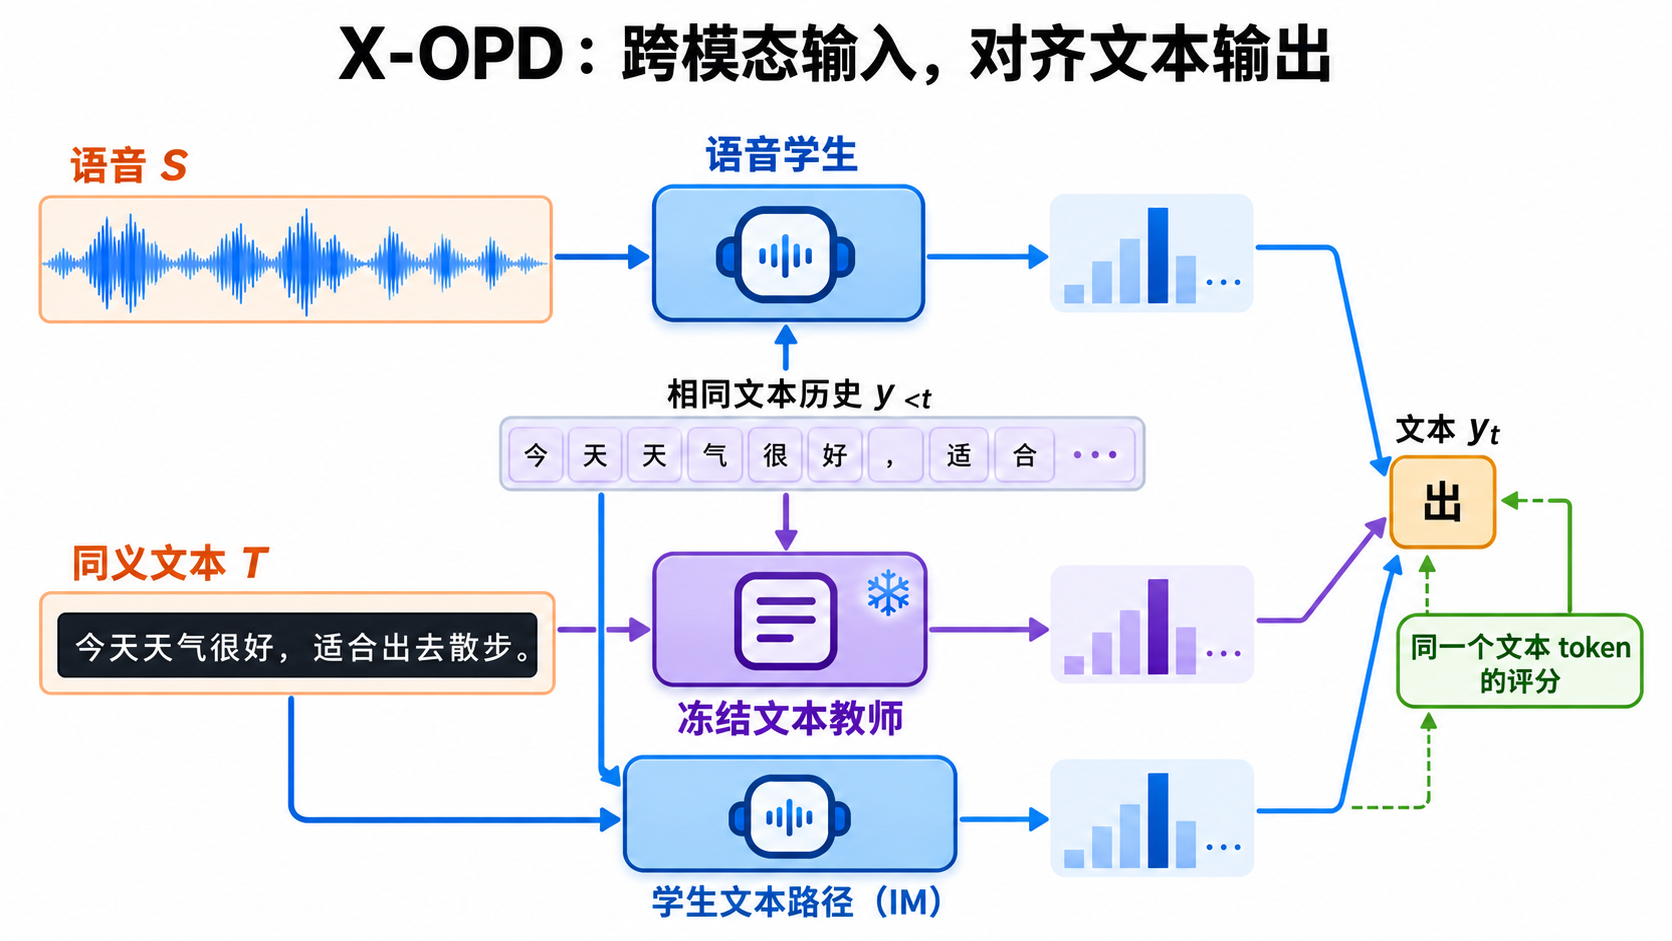
图 2|语音学生、文本教师与学生文本路径,共同评分文本输出(原创教学图)
沿图中上方蓝线读:学生接收 ,生成一条文本回答;紫色教师接收 。中间一排格子是已经生成的文本历史 ,即第 个 token 之前的前缀。教师读取的也是这条学生前缀,而非另起一条自己的回答。右侧橙色格子 是当前待评分的同一个文本 token。
如果教师重新生成一份答案,两份答案可能从第二个词起就走向不同位置,逐位置比较便失去共同对象。图中把历史同时送入各条路径,正是为了固定“已经走到哪里、现在评价哪一个 token”。回答由学生采样这一点仍然保留,因此跨模态扩展没有丢掉 OPD 对学生实际访问位置的关注。
这里的语音 LLM 负责听语音问题、生成文本回答。教师的反馈对齐的是文本词表概率,图中没有音频码本的监督路径;不能据此推断它训练了语音输出质量。
IM 与 CM 分别比较什么
论文 §3.3 的两路信号可写为:
其中 是冻结文本教师的概率分布, 是学生的概率分布; 是自然对数,分数无量纲。下标 指当前文本位置。IM 的两项都接收文本 ,比较教师与学生的文本路径;CM 的教师接收 、学生接收语音 ,比较跨模态的两路评分。图中下方蓝线特意保留了学生文本路径,防止把 IM 误读成另一个教师。
给右侧同一个 代入一次:教师概率为 ,学生文本概率为 ,学生语音概率为 ,则
CM 较大,表示这个位置上,学生的语音条件评分离文本教师更远。它不是整句答案正确率,也不是教师直接给出的人工奖励。若学生概率高于教师,相应对数差可以为负。只有将这些差值与采样、加权、优化方向放在一起,才能说明参数如何改变。
还可以做一个零点检查:若同一 token 上教师与两条学生路径都给出 ,两路差值都是 。这说明信号衡量的是相对评分差异;仅看教师概率很高,不能判断该位置还有多大蒸馏空间。
3. 轨迹内归一化与跨轨迹平均
长回答不会自动得到更多轨迹权重
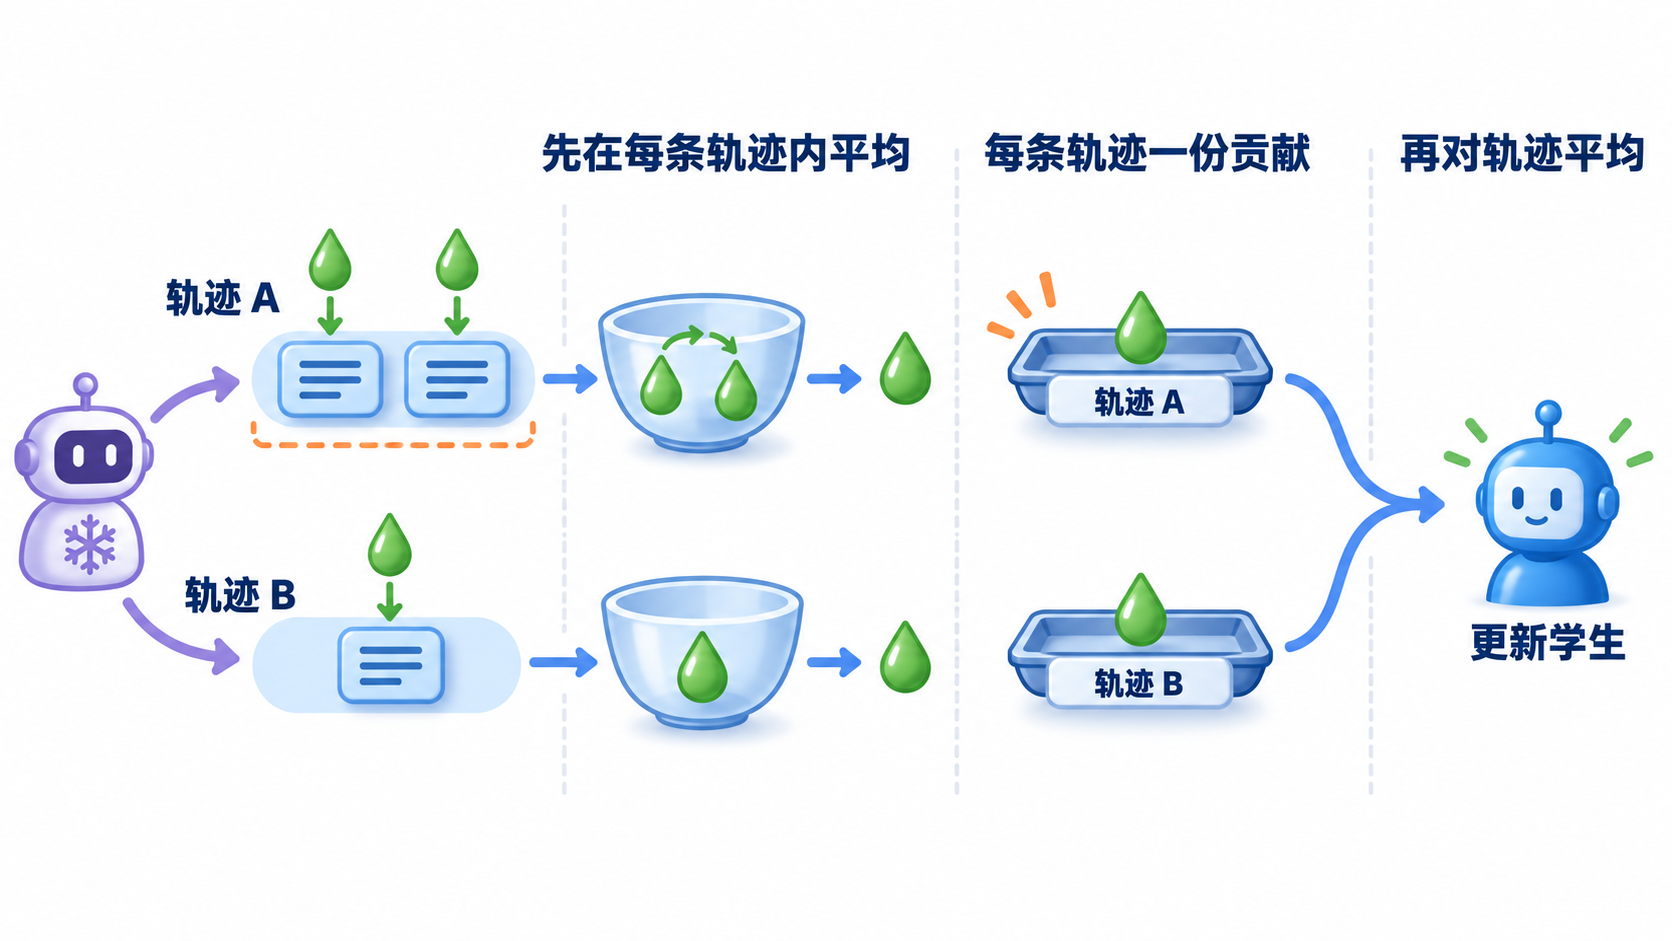
图 3|两格与一格先各自平均,再各贡献一份(原创教学图)
图中轨迹 A 有两个 token,轨迹 B 只有一个。先看两个碗:每条轨迹在内部按长度平均;再看两个同宽托盘:不论回答长短,每条轨迹向外贡献一份。对应论文 §3.4 的正号加权结构,本文用 记代理量:
这里 是轨迹条数; 为轨迹索引; 为第 条轨迹的文本 token 数; 从 遍历到 。 是刚才定义的某一路差值; 表示当前学生参数, 与 分别为当前策略和采样所用旧策略, 是它们在同一位置、同一条件下的概率比。 指该项实际采用的输入条件, 为对应前缀;不能仅凭 IM 的文本评分条件反推 rollout 条件。 是两路混合系数。
原文将正号结构命名为 ,并写 ,但该处未显式交代最大化或最小化约定。“叫 loss”本身不能确定优化方向。 因此本文保留原定义,用 明确指正向代理量;若实现选择最大化 ,交给最小化器时才写成 。这里不推断作者代码的符号、detach 或 clipping。
用两条轨迹手算一次
沿图 3 的两格与一格,取教学参数 、,给定下表概率与比率。它们用于解释运算,不是论文实验样本。
| 位置 | 教师文本概率 | 学生文本概率 | 学生语音概率 | 给定 | ||
|---|---|---|---|---|---|---|
| A 的第 1 格 | 0.60 | 0.30 | 0.20 | 1.1 | 0.693147 | 1.098612 |
| A 的第 2 格 | 0.25 | 0.50 | 0.40 | 0.9 | −0.693147 | −0.470004 |
| B 的第 1 格 | 0.50 | 0.40 | 0.25 | 1.2 | 0.223144 | 0.693147 |
先算 A 的两格:IM 为 ;CM 为 。B 只有一格,IM 为 ,CM 为 。
再把两个托盘平均:,;最终 。中间展示值做了舍入,最终数值按未舍入值计算。
若把三格直接合并、除以 ,会得到约 。这相当于让 A 占两份 token 权重、B 占一份,已经改变了图中两个托盘的关系。先按轨迹长度归一化,再平均轨迹,是实际目标的一部分。
4. 训练时哪些参数更新
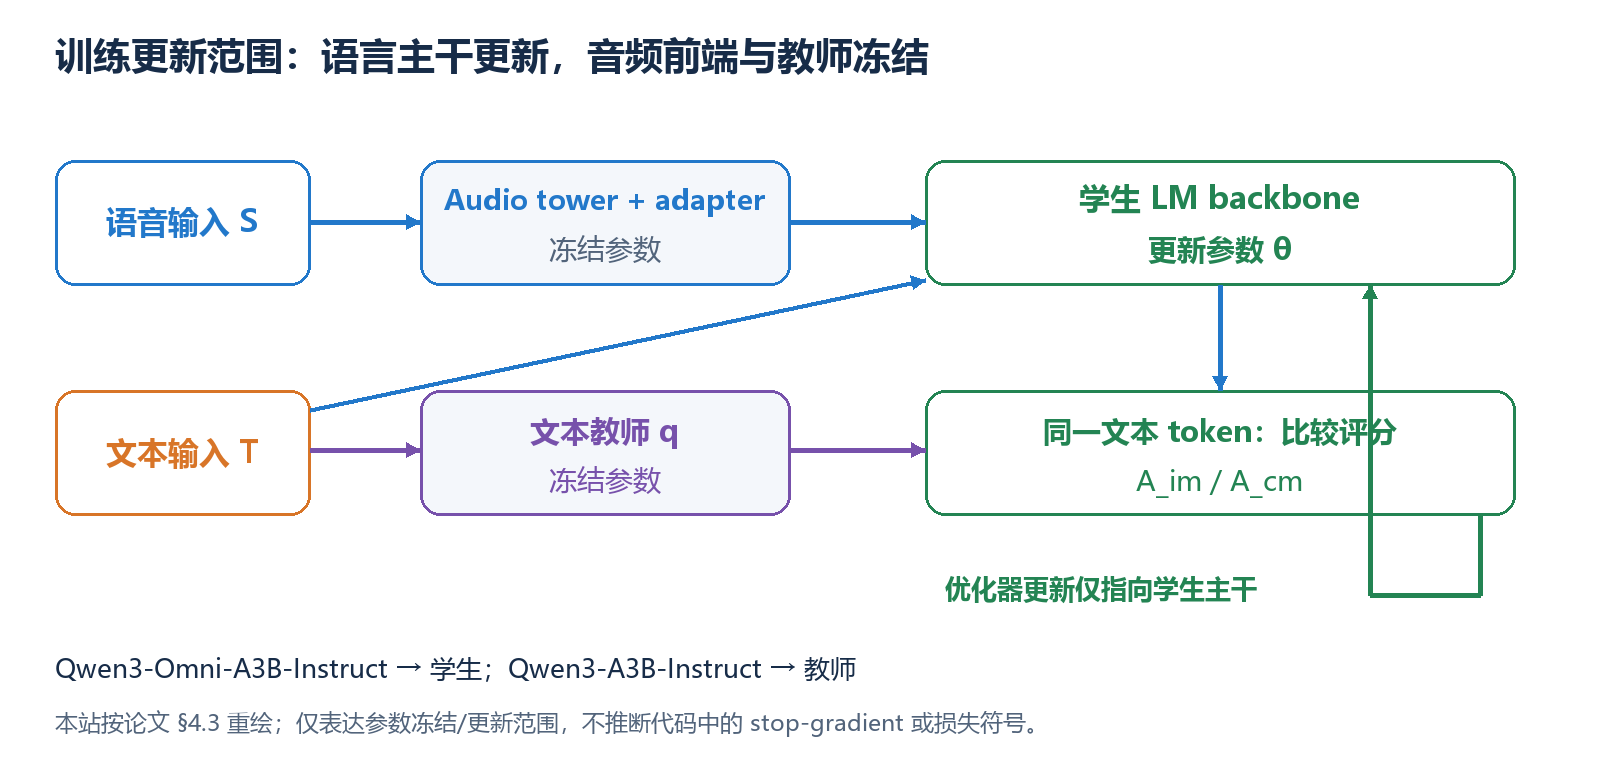
图 4|绿色更新箭头只指向学生语言主干(按论文 §4.3 重绘)
图中上方语音前端仍参与计算,但 audio tower 与 adapter 冻结;绿色 LM backbone 才是被更新的学生参数。教师也冻结。论文默认学生为 Qwen3-Omni-A3B-Instruct,文本教师为 Qwen3-A3B-Instruct,使用 verl 的 RL 式训练流程,Adam 学习率 、batch size 256,每个输入采样 条轨迹。
这套设置把训练调整集中在语言主干如何利用已有语音表示、生成文本回答上。它不意味着音频前端已被新目标重新训练。前面的 是便于看清等轨迹权重的教学例,不能与实验的 混为一谈;图中的参数冻结范围也不能替代对实际自动微分代码的逐行检查。
5. 三项评测与教师消融
先分清三项评测的单位
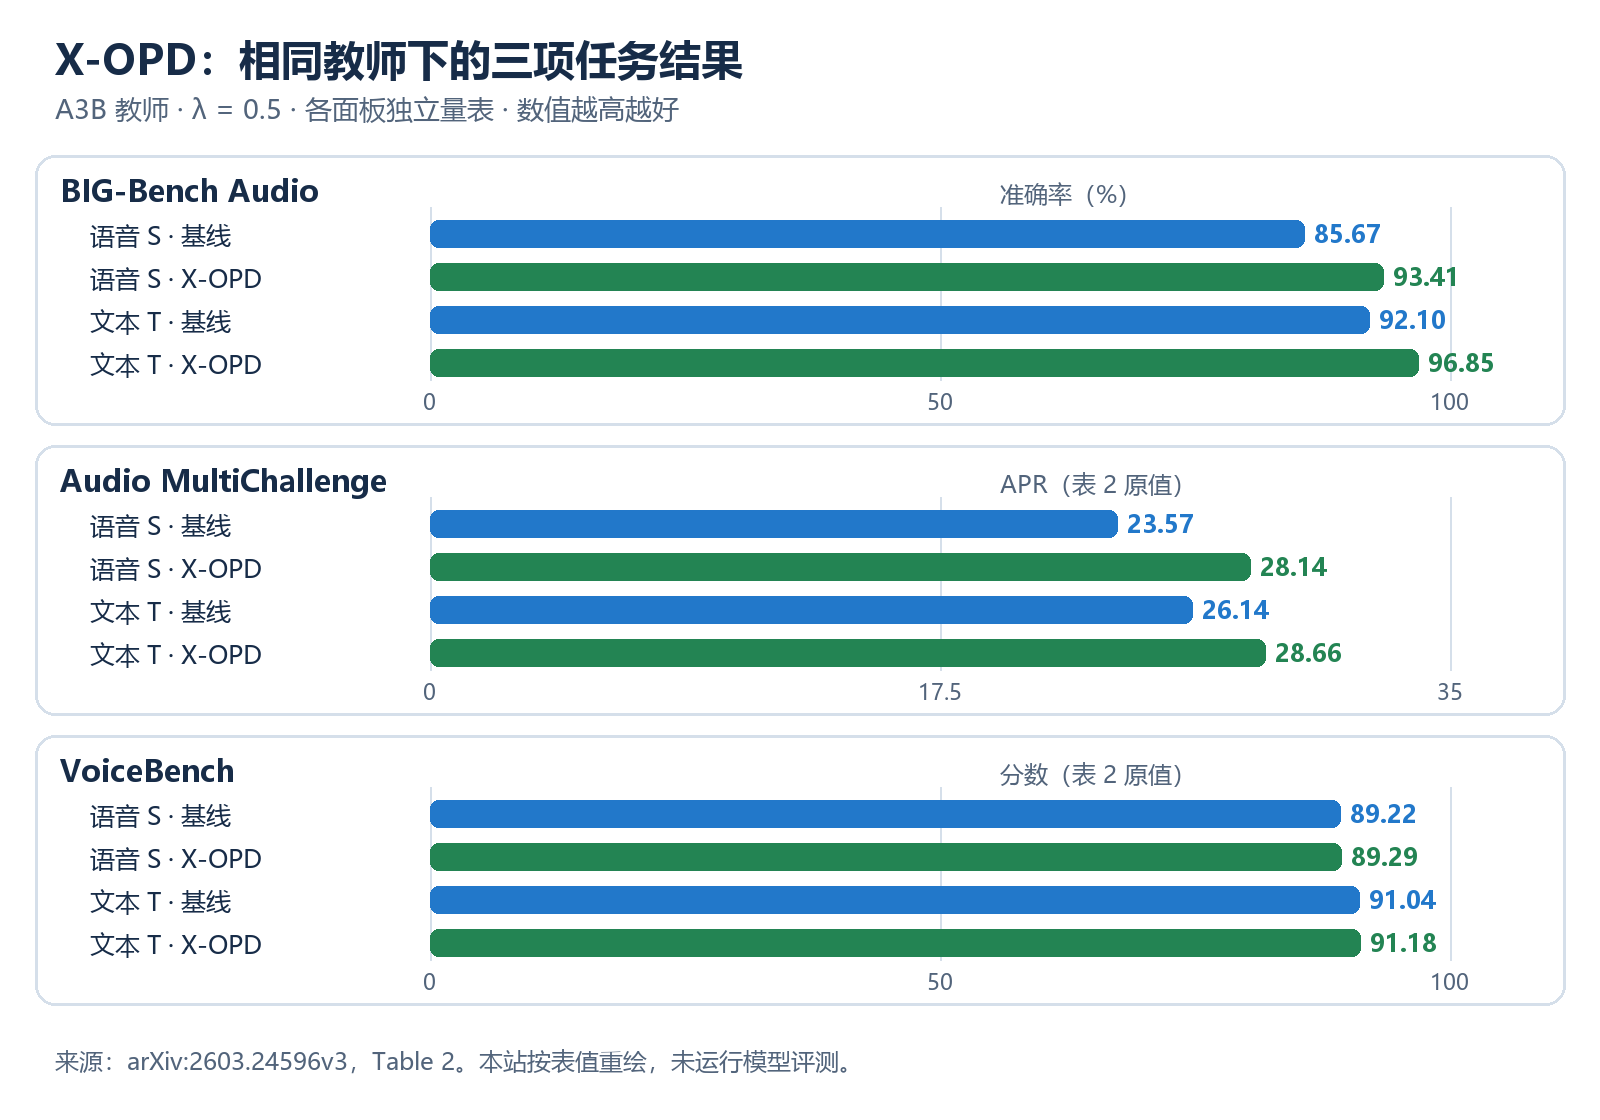
图 5|同一 A3B 教师、$\lambda=0.5$,三项任务分别比较(Table 2 重绘)
图中蓝条为基线,绿条为 X-OPD,每个任务又分别保留语音输入 与文本输入 。BIG-Bench Audio 用 1,000 个合成样本评估准确率;Audio MultiChallenge 使用 452 段对话、1,712 条 rubric,报告 APR;VoiceBench 覆盖七个子集、5,783 个单轮样本。三个面板各用自己的量表,不能把它们相加,称为统一的“准确率提升”。
论文 §4.2 的重复生成与判分采用三次生成、每次三次 judge,取九次均值;judge 为 Qwen3-235B-A22B-Instruct-2507。这是具体评测协议的一部分,不能等同于九次独立训练,也不能仅凭均值判断统计显著性。
最明显的变化在第一面板:BIG-Bench Audio 的语音准确率由 85.67 到 93.41,增加 7.74 个百分点;文本准确率由 92.10 到 96.85,增加 4.75 个百分点。第二面板 APR 的语音原值从 23.57 到 28.14,文本从 26.14 到 28.66;第三面板 VoiceBench 仅从 89.22 到 89.29、91.04 到 91.18。改善幅度依任务而变,不能只挑最大的一项代表全部能力。
两路反馈与更大教师的对照
论文表中另报告平均性能下降指标 与 ,分别对应语音与文本输入;这里沿用表值,数值越低表示下降越小。本文未展开这两列的归一化定义,只在相同报告口径下比较,不与前三项原始分数混算:
| 配置 | ||
|---|---|---|
| A3B 教师下的基线 | 11.29 | 5.51 |
| A3B 教师,X-OPD, | 3.43 | 0.97 |
| A3B 教师,仅文本项, | 6.91 | 2.43 |
| A3B 教师,仅语音项, | 5.08 | 2.52 |
| A22B 教师,X-OPD, | 5.55 | 5.23 |
在这个表的条件下,混合两项优于仅用其中一项;更大的 A22B 教师也没有自动优于 A3B 教师。它对应的三任务语音/文本原值依次为 91.91/95.29、26.62/27.86、89.60/91.67:VoiceBench 略高,另两项低于 A3B 教师配置。这个对照足以提醒我们检查教师与学生、任务及训练方案的匹配程度,还不足以宣称“大教师一定更差”。
这篇论文给出的证据集中在语音输入下的文本回答与推理表现。没有音质、端到端延迟或实时率测量,就不能把表中的增长翻译成更自然的声音、更快的语音交互。本站未进行模型训练与基准复现;图 5 来自论文报告,前面的手算只验证数学代入与归一化过程。
数据路径还带来一个阅读实验的边界:合成语音上的结果,不能单独证明任意真实录音环境中的收益。要判断具体应用,仍需把目标输入条件、配对质量与对应评测放在一起。这里需要补充的是新条件下的证据,而不是把已有表格换算成一个更大的通用能力结论。
继续追问时,可以沿图 1 检查配对质量,沿图 2 分别看 IM 与 CM 的反馈,沿图 3 对照长度归一化,最后回到图 5 问清具体任务与输入条件。这样才能把“语音学生进步了”落实为一条可以检查的计算和证据链。
正在连接 GitHub 评论…