07.1.1|学生轨迹上的蒸馏:分布、目标与梯度
返回 OPD 专题导读 · 前置:07 中的 KL 方向、词表对齐与基础代码
学生自己生成回答,决定教师去哪些上下文上提供反馈;损失函数再决定怎样比较两个模型。轨迹来源、分布差异与梯度路径,是三个分别需要说明的选择。 本篇用 GKD 的原文定义拆开它们,再以一个可运行的标量例子检查“停止采样梯度”究竟停止了什么。
阅读顺序是:选择训练位置 → 固定位置比较分布 → 明确反传路径 → 数值检查。已熟悉 KL 的读者可以直接进入第二章。
本篇目录
1. 学生轨迹与损失函数的独立选择
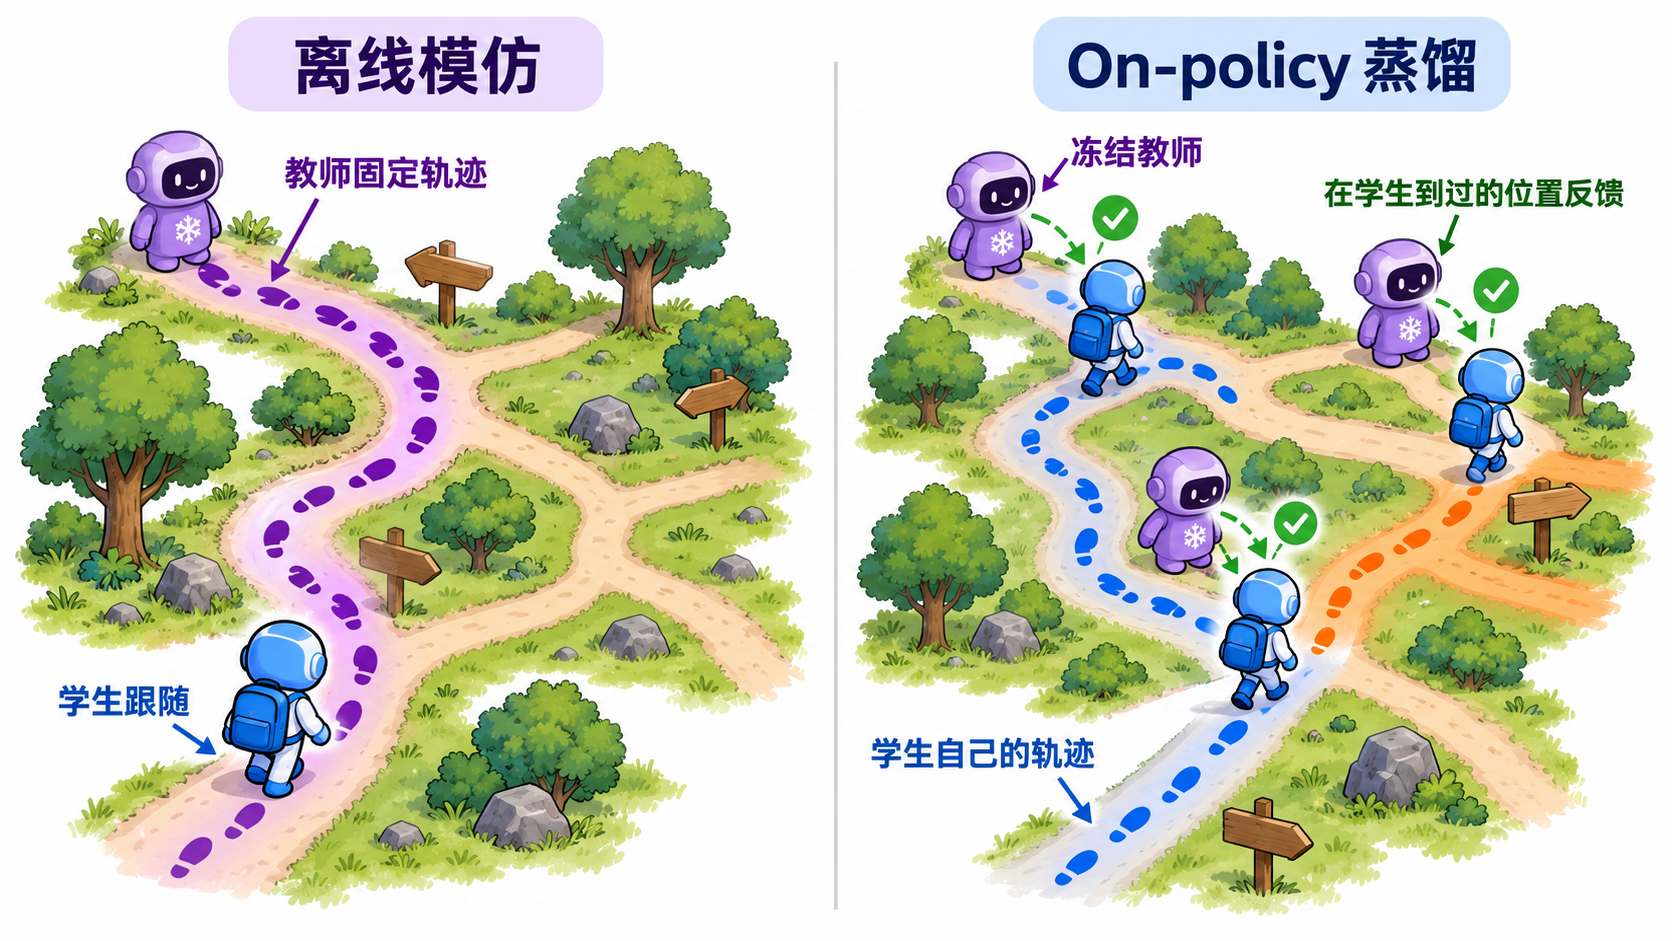
图 1|轨迹来源的教学示意
观察右侧蓝色脚印:学生走到哪个分岔,教师就在那个位置反馈。教师可以对学生已经生成的前缀重新计算下一 token 分布,不必只提供一条预先写好的完整答案。左侧画的是一种离线教师轨迹设定;GKD 的原始数据分支更一般,不能把图中场景当作全部离线蒸馏的定义。
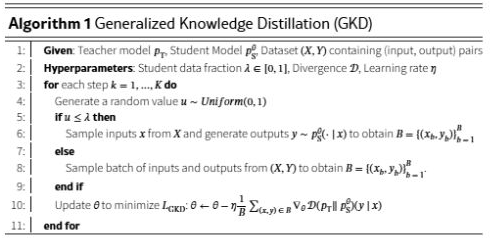
来源:Agarwal 等,GKD Algorithm 1(截图裁切,CC BY 4.0)
从原图第 4 行读起:先抽取 ,即在 到 间均匀采样一个随机数;第 5 行检查 。满足条件就抽输入、让学生生成输出,形成训练 batch;否则第 8 行从原始 数据取输入输出。两路在第 10 行汇合,计算批次的平均差异梯度,以学习率 更新学生参数 ; 控制更新步幅。
GKD 将学生生成数据与原始训练数据混合,并允许独立选择分布差异函数。因此,GKD 的 是学生数据占比的控制量;差异函数 是另一项选择。 这里的 分别表示数据集中的输入及对应输出,;有限次随机选择得到的实际比例不必恰好等于 。图中的两条数据分支使用同一个更新步骤,不能从选中了学生数据分支就推出某个特定的 。来源:GKD §3.1 与 Algorithm 1。
“在学生数据上训练”本身既没有指定 KL 方向,也没有指定策略梯度。前者关心在哪些位置学习,后两者分别关心怎样衡量差异、怎样取得参数更新。把三者合成一个标签,会让人无法解释同一批学生轨迹为何可以配不同损失。
2. 固定前缀与外层期望
2.1 教师与学生读取同一个历史
令输入为 ,输出序列为 ,长度为 ; 是输出位置, 表示该位置以前的输出。固定前缀 后,定义:
分别标记教师、学生; 是学生参数; 遍历共同词表中的候选 token, 都是完整词表上的概率向量。共同词表与概率坐标对齐是本教学写法的前提,跨 tokenizer 不能直接按数组下标相减。
GKD Eq. (2) 将一条给定序列上的差异按位置平均:
表示选定的分布差异, 是这条序列的平均差异,二者均无物理单位。每项先比较相同 下的两个完整分布,再对 个位置平均。生成时抽到的那个 token 决定后续前缀;它不等于教师在当前位置只监督一个候选 token。 GKD §3.1 的学生数据训练使用教师完整分布,不能在解释时悄悄换成只算采样 token 的对数概率差。来源:GKD Eq. (2)、Eq. (4)。
2.2 学生生成改变期望中的权重
固定序列上算出 ,还没有回答训练经常遇到哪些序列。用 表示负责采样的学生参数副本,学生数据分支可写成:
是期望损失; 表示按其下标所指定分布求平均,输入 来自训练输入分布; 产生离散序列。分号用于强调:当前学习的是 ,本次样本来自固定的 。 只是为区分计算角色而引入的采样时参数快照,可随下一批重采样更新,并非另一个永久冻结的学生。学生重新采样后,前缀出现频率会改变;同一前缀处的 仍可保持原定义。
3. 停止采样梯度的计算含义
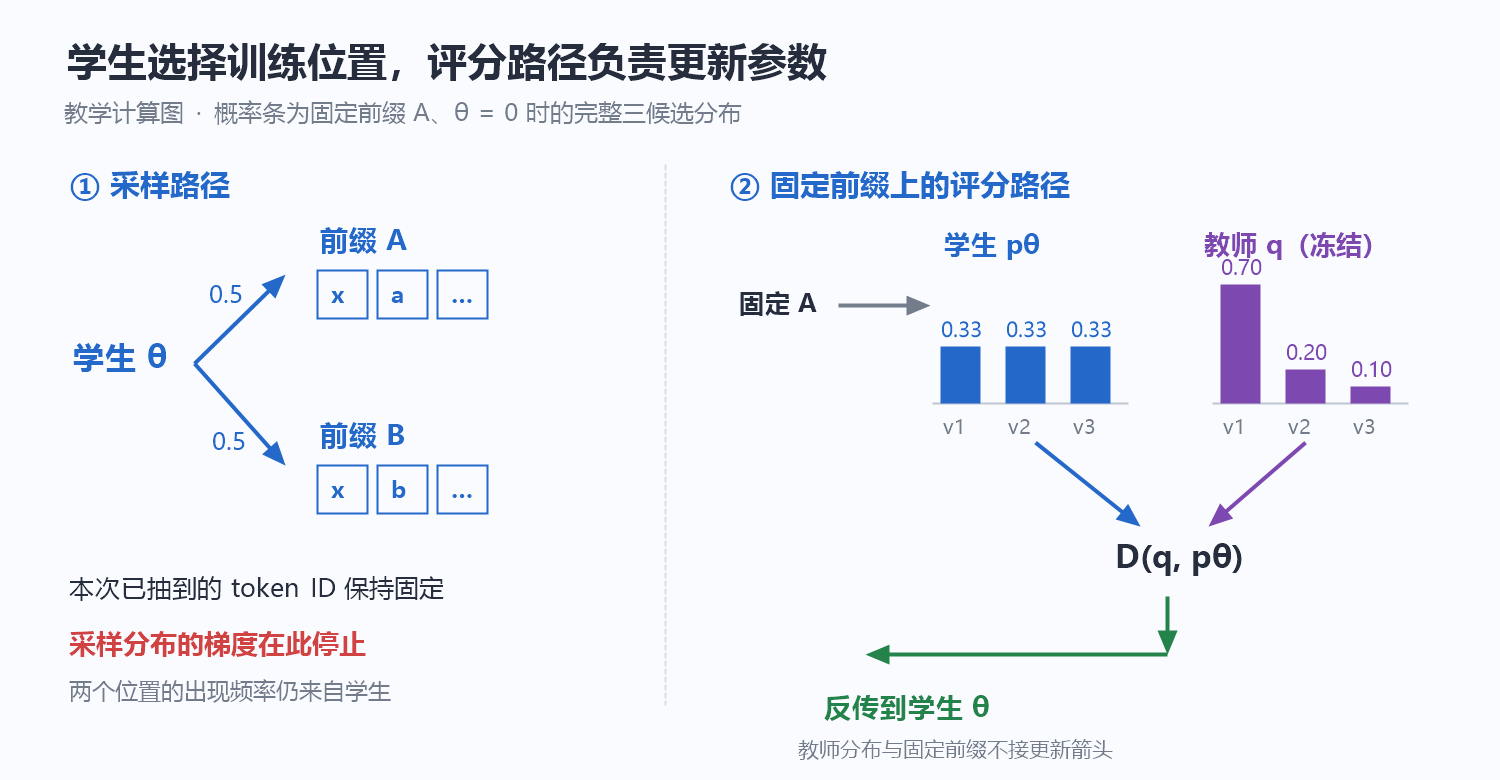
图 2|教学计算图:固定已抽到的前缀,更新学生评分
沿图中的两条路径分别阅读:上方采样路径决定本批读到哪个前缀;下方评分路径在这个前缀上重新计算学生概率。教师保持冻结,学生评分仍然参与反传。GKD §3.1 明确说明,不对学生采样分布反传;其采样温度使用 以进行探索。这里 是温度参数,不应据此推断所有 OPD 都采用相同温度。来源:GKD §3.1。
为了看清差异,暂时只考虑两个可能的前缀 ,用 表示前缀 的概率,用 表示该前缀处的局部损失。若完整求导一个参数相关的期望,乘积法则给出:
表示对参数求导; 遍历两个前缀; 是固定采样权重、只求局部评分梯度的部分, 是前缀权重变化带来的部分。GKD 所描述的停止采样梯度对应前一种更新路径;不能因为采样数值来自当前学生,就默认还包含后一项。
停止采样梯度不表示冻结整个学生,也不表示损失不再依赖学生参数。 它排除的是经由“这个样本出现的概率”回传的路径。在全程可导、概率为正的这个教学例子中,后一项可改写为带 的形式;这解释了为什么讨论策略梯度时必须交代是否计入采样分布,不能只根据“用了 rollout”判断算法。
4. 两种前缀的数值与代码检查
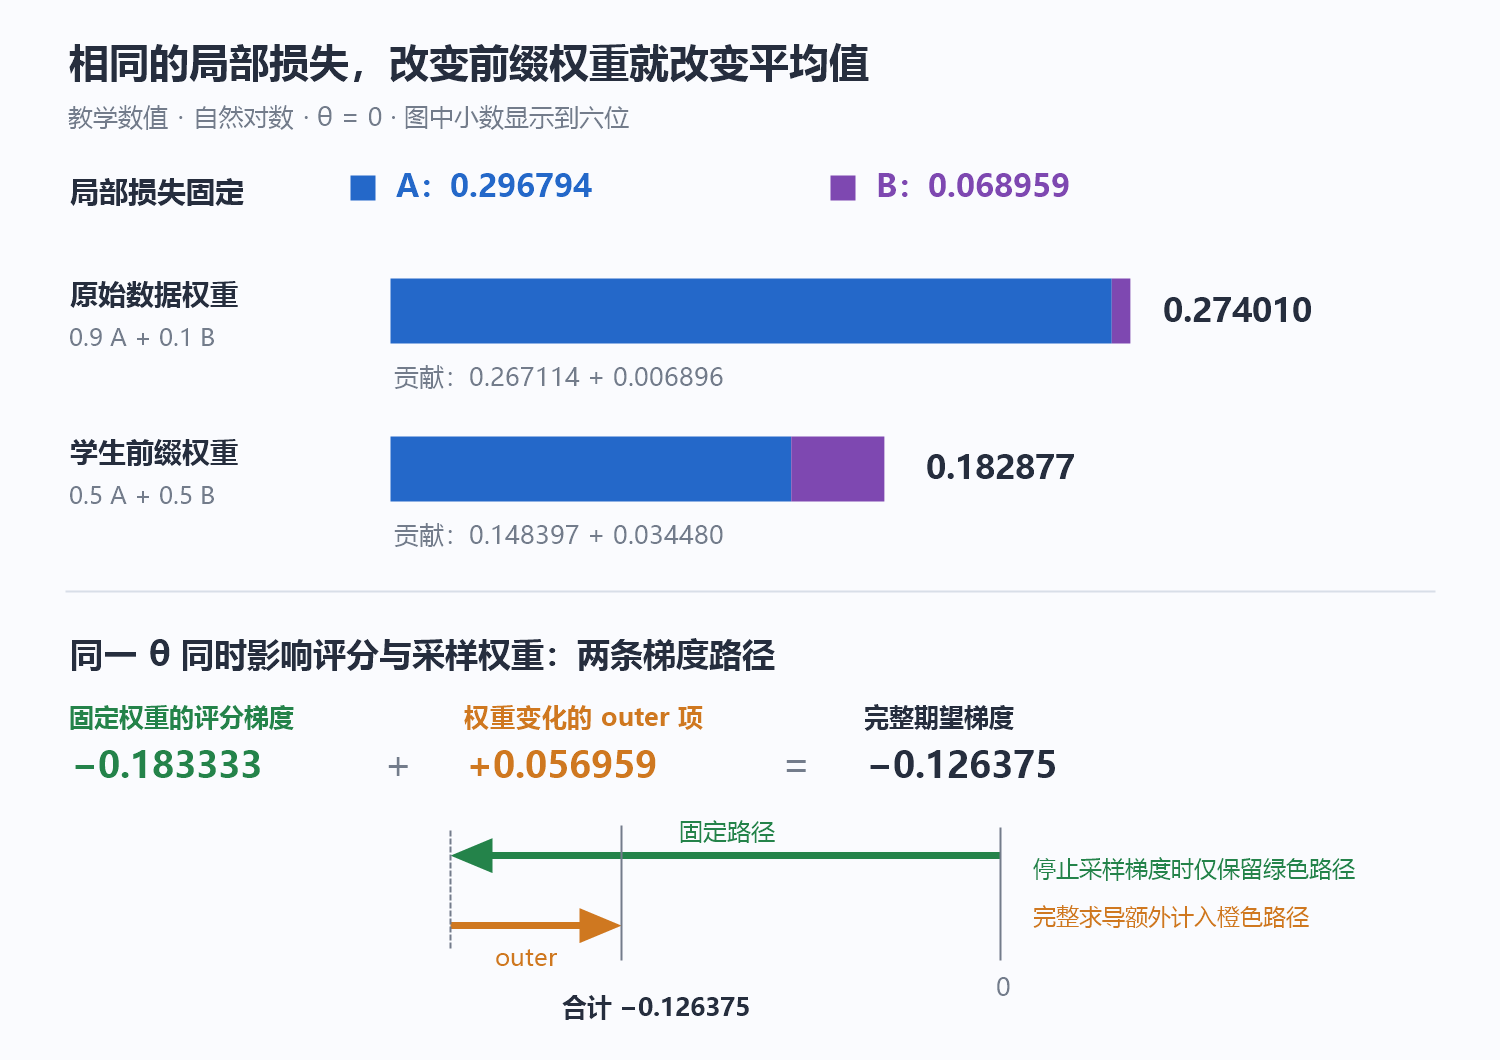
图 3|教学数值:上半比较加权平均,下半分离两条梯度路径
图 3 上半的蓝色、紫色分别表示前缀 对平均值的贡献:局部损失不变,权重变化就会改变总条长。下半的绿色箭头是固定采样权重的评分梯度;橙色箭头是完整求导时额外计入的权重变化项。下面逐项计算这两种变化。
4.1 先固定词表分布,再改变前缀权重
沿用图 2 的两个前缀,以下均为教学设定,使用自然对数。教师固定为 、;学生在 的 logits 为 ,在 的概率恒为 。logits 是 softmax 前的无单位实数;本例只让第一个分量随标量 改变。取前向 KL:
这里 是三个候选 token 的索引。当 ,学生两处分布均匀。代入 :
同理:
若原始数据的前缀权重为 ,其期望为 ;若学生权重为 ,期望变为 。KL 方向没有改变,仅训练位置的频率已经改变了平均值。 这组数值只展示权重作用,不能用来证明模型能力提高。
4.2 冻结权重与完整求导得到不同结果
进一步设 ,; 是自然常数。这使同一个 同时影响前缀权重与 处学生评分,便于分离两条梯度路径。
在 ,有 ,;前向 KL 对 的首个 logit 的导数为 , 的学生分布固定,因此局部导数为零。于是:
下面的脚本用有限差分检查两种结果。f 输出两个前缀的局部 KL;w 输出采样权重;value 在权重与局部损失汇合后求和。fixed 对应本批已经确定的采样权重,传入它后只改变评分参数。保存为 check_prefix_gradient.py,使用 Python 3 标准库运行即可。
import math

def f(theta):
    a = math.exp(theta)
    p_a = [a / (a + 2), 1 / (a + 2), 1 / (a + 2)]
    def kl(q, p):
        return sum(x * math.log(x / y) for x, y in zip(q, p))
    return [kl([.7, .2, .1], p_a),
            kl([.5, .3, .2], [1 / 3] * 3)]

def w(theta):
    a = 1 / (1 + math.exp(-theta))
    return [a, 1 - a]

def value(theta, fixed=None):
    weights = w(theta) if fixed is None else fixed
    return sum(a * b for a, b in zip(weights, f(theta)))

eps, fixed = 1e-6, w(0.0)
frozen = (value(eps, fixed) - value(-eps, fixed)) / (2 * eps)
full = (value(eps) - value(-eps)) / (2 * eps)
print(f"frozen={frozen:.9f}; full={full:.9f}")
assert abs(frozen - (-0.1833333333333333)) < 1e-8
assert abs(full - (-0.1263747179530243)) < 1e-8
本地标准库验算使用 Python 3.12.14、中心差分步长 ,固定权重与重算权重的结果分别为 和 ,对解析结果的绝对误差均小于 ;断言容差为 。这是精确枚举两个前缀的数值检查,未训练语言模型,也不构成 GKD 的模型复现或性能证据。扩展版验算脚本还保存每项分布与中间结果,便于定位错误。
5. 阅读与实现检查
拿到另一篇 OPD 文章或代码时,按同一条计算链检查:
- 前缀来源:原始数据、教师生成还是学生生成?是否每批重新生成,混合比例控制什么?
- 监督对象:同一历史上的完整词表分布,还是采样 token 的标量分数?词表、位置与 mask 是否对齐?
- 差异与归一化: 的方向、温度、每条序列平均与 batch 平均怎样定义?换成总 token 平均是否改变权重?
- 梯度路径:教师、采样轨迹和评分分支分别在哪里停止梯度?有限差分时是否意外重算了本应冻结的权重?本例改变输入参数、保持
fixed不变才对应固定路径;让所有函数自动重算,检查的会是另一个目标。 - 结论边界:数值与梯度正确只能支持这一计算路径,效果仍需任务、基线和独立评测。
本文依据 GKD,arXiv:2306.13649v3,2024-01-17 的 §3、§3.1、Eq. (2)/(4) 与 Algorithm 1。中文阅读入口为欲壑难填的 《On-policy Distillation:GKD 和 MiniLLM》;这里使用其中 GKD/on-policy KD 的解释,不据此转述尚未精读的 MiniLLM 原论文结论。
正在连接 GitHub 评论…