04|SFT、奖励模型与 DPO 的目标变化
本篇主要跟踪同一道题“计算 ”:A 简短回答 391,B 用较长文字回答 381。事实检查、人的选择、模型预测和训练目标会在同一对答案上分别出现。§1.2 另保留一个假设切成七个 token 的“1+1”小例,只用来放大位置右移;这不是把中文片段当作真实 tokenizer 的固定切分。
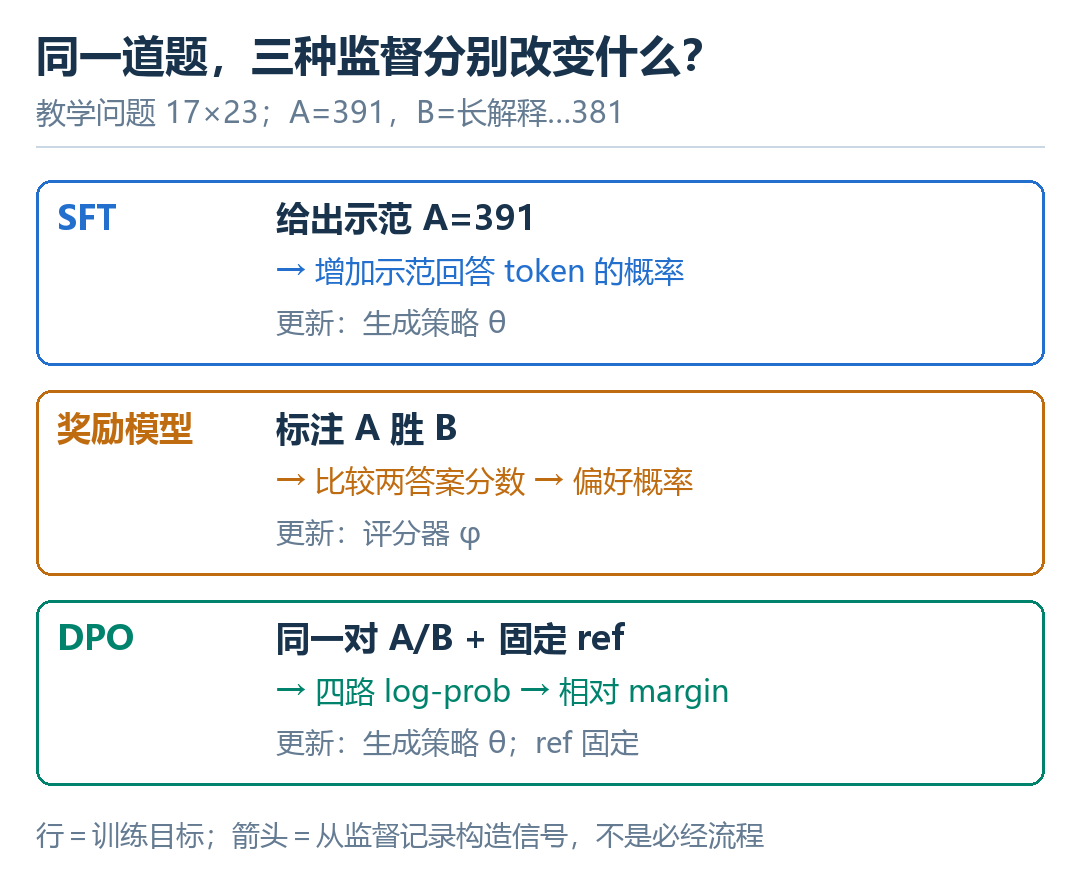
每行是一种训练目标;先区分输入的监督,再追踪谁的参数会更新。
预训练学续写,后训练用示范、比较与奖励改变回答行为。先看角色怎样变成可训练的序列,再用同一道乘法题追踪偏好如何变成梯度。这些公开方法是机制教材,不是 GPT-6.1 或当前 Claude 的完整配方;RLHF、RLAIF、DPO 也不是固定必经流水线。
阅读路线。 先沿角色与 token 对齐读 SFT,再看同题分差怎样变成奖励;随后把 KL 约束逐步变形成 DPO,最后检查标签分歧与评测边界。已有 SFT 基础可从第 2 章开始;DPO 读者至少连读 3.2 与第 4 章。4.5 用三候选分布区分“真正的一步梯度”与“损失降低的反例”。
本篇目录
1. SFT:角色、目标与右移
SFT 仍使用下一 token 预测,但训练记录通常以指令或对话组织。模型看到完整上下文,只在需要学习的输出位置计算损失。例如用户问“用一句话解释梯度”,示范回答是一句准确解释;目标不再是任意网页的后续文本,而是在这个指令后生成对应答案。InstructGPT 公开了一条示范微调、偏好收集、奖励学习、RL 优化的路线,并展示较小后训练模型在其评估分布上也可以获得更高偏好。该结果不意味着后训练能够替代全部预训练。来源:InstructGPT。
1.1 模板把角色变成网络可读的序列
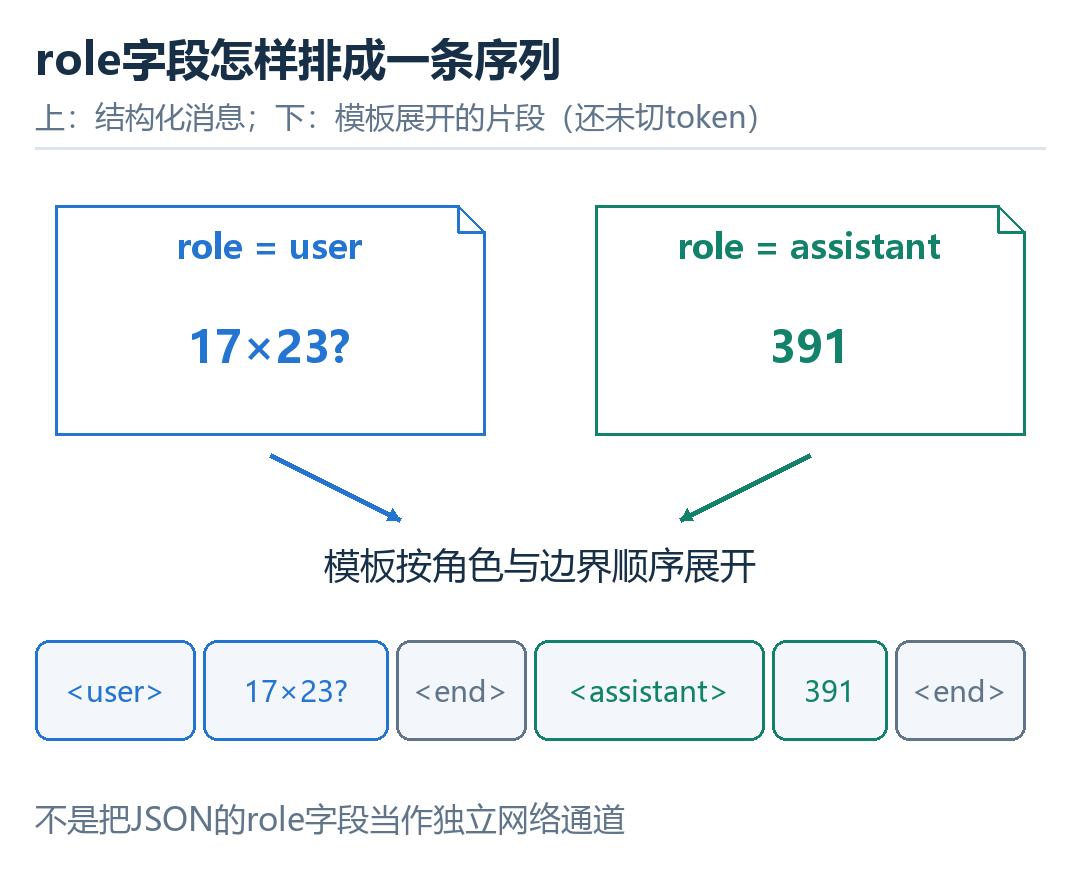
上方是两条消息记录,下方是模型实际读取的序列;位置沿横轴增加。
先看图上方,role=user 和 role=assistant 属于消息记录的字段。模板把角色、正文和结束边界排成一条 token 序列,网络再读取下方这条序列。颜色用来追踪哪一段来自用户、哪一段来自助手;它不是 Transformer 里另有一个名叫 role 的输入通道。
对话首先要序列化。这里自设一个教学模板:<user> 问题 <end> <assistant> 回答 <end>,不是任何商业模型的实际协议。角色标记、消息边界、工具名称及参数都是网络需要识别的内容。JSON 中的 role 字段不会天然进入 Transformer,必须由模板转成模型学过的序列。不同模型模板不同;重复添加 BOS/EOS、误用另一种模板或缺少 assistant 起始标记,都可能改变分布。官方参考:Chat templates。
1.2 预测右移、有效目标与代码
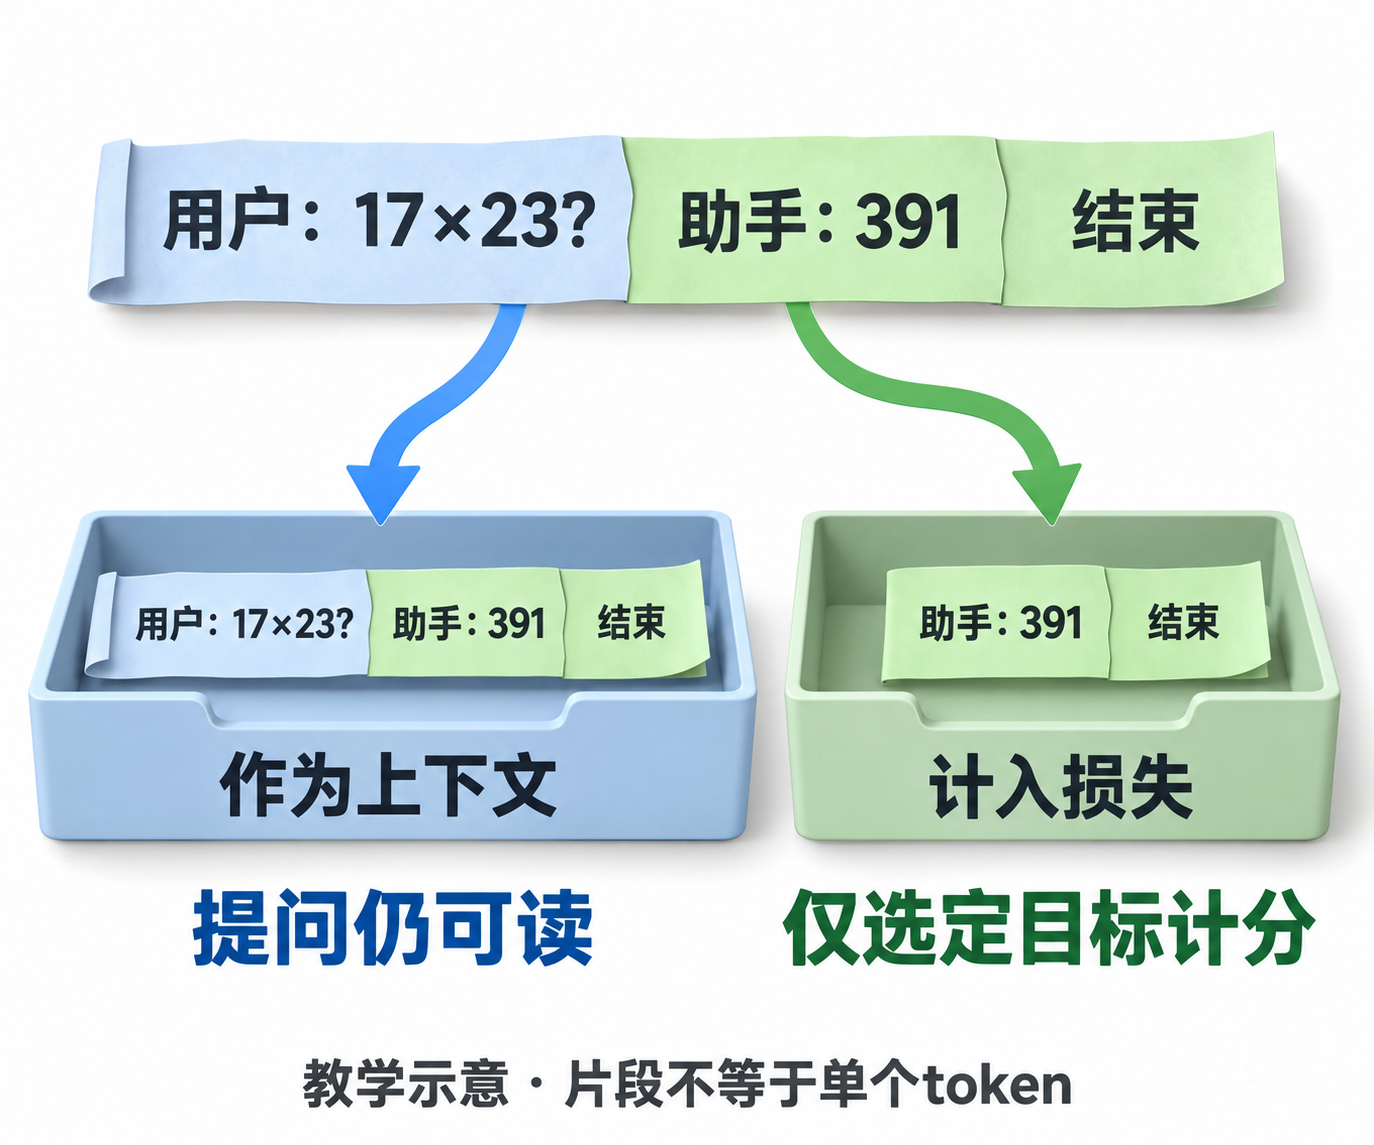
左托盘保留训练记录,右托盘只选监督片段;精确预测位置见下一图(ImageGen 教学示意)。
上方蓝灰色提问和绿色回答属于同一份记录。左下仍保留提问,说明“不对用户文本算损失”不等于“不让模型读问题”;右下只选择绿色助手回答与结束片段,说明监督选择的对象。这里分的是记录用途,不表示某个预测位置可以偷看未来答案:真正预测下一项时仍只能读取此前合法前缀,下面用索引把这件事展开。
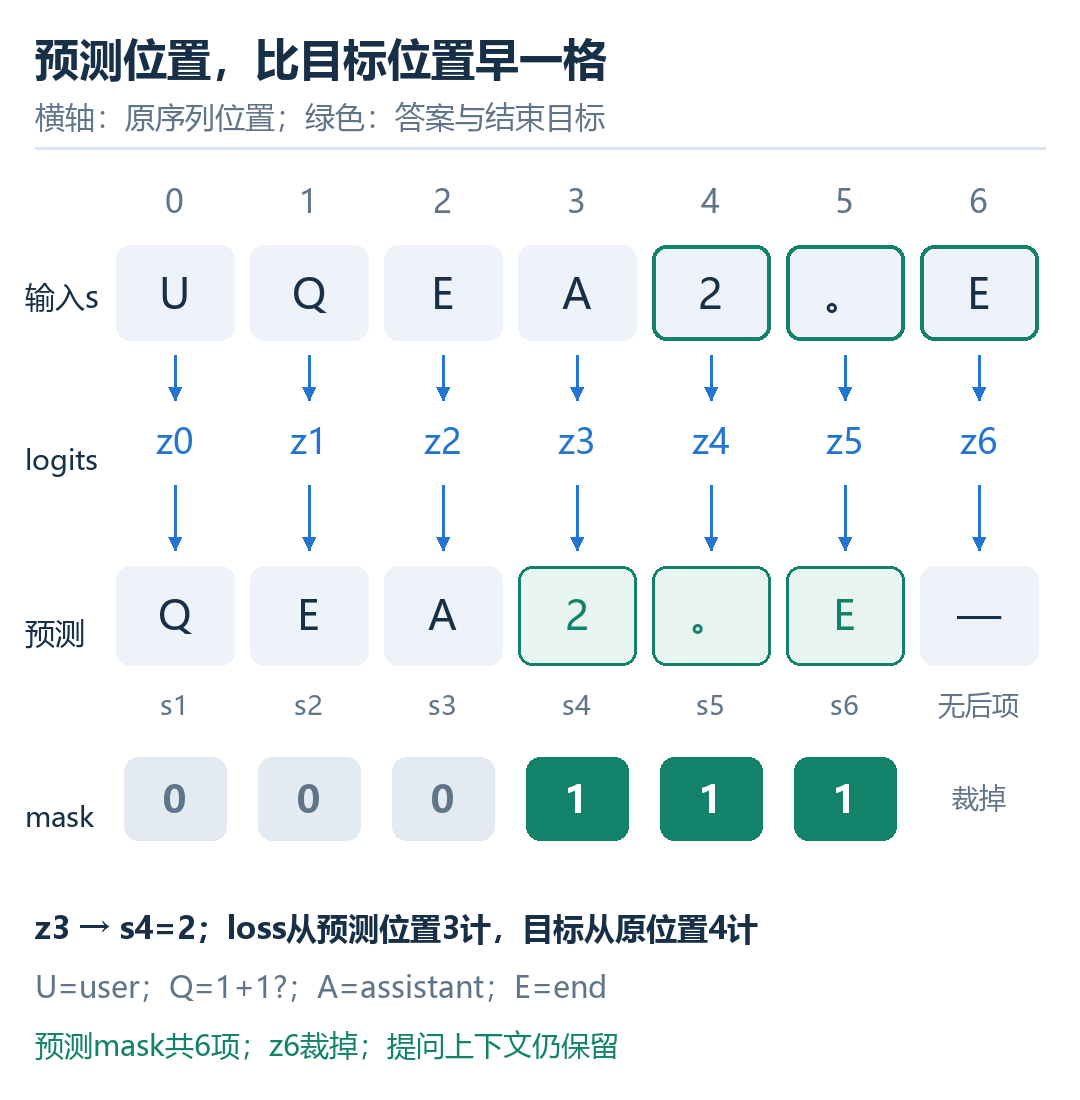
横轴是原位置0–6;上排是已知序列,下排是该位置预测的下一项;绿色框按目标定义。
图中 U/Q/E/A 只是为避免挤字使用的教学别名:U=<user>,Q=1+1?,E=<end>,A=<assistant>。这里的 A 是角色标记,不是后文候选答案 A。上排 是助手起始标记;在这个位置算出的 logits ,负责预测右边的 。所以绿色监督框从预测位置 3开始,而目标本身从原序列位置 4开始。同一绿色目标在两排错开一格,是因果预测的对齐,不是漏掉了回答第一项。预测 mask 只保留 项;最右端 不存在要对齐的下一项,代码会将它裁掉,图中不把它伪装成第七个有效 mask。
假设 tokenize 后序列恰好为以下 7 项,每一项在本例是一个 token:
| 原序列位置 | token | 是否作为目标受监督 |
|---|---|---|
| 0 | <user> | 0 |
| 1 | 1+1? | 0 |
| 2 | <end> | 0 |
| 3 | <assistant> | 0 |
| 4 | 2 | 1 |
| 5 | 。 | 1 |
| 6 | <end> | 1 |
原位置 3 的 logits 用来预测原位置 4 的 2,因此对应预测位置的 loss mask 为 1。原位置 6 的 <end> 也受监督,模型才能学到合适的终止。是否同时训练角色头或其他标签是实现选择;这里固定为 assistant 内容与终止标签。Assistant mask 遮的是损失,不是助手能读取的上下文。 用户提问虽然不作为目标,仍会经过网络并影响回答梯度。
| 符号 | 含义、形状与单位 |
|---|---|
| batch 索引和预测位置索引; 的 logits 预测 项 | |
| 序列化对话的 token ID,整数张量 | |
| 参数为 的条件 token 分布,输出 | |
| assistant 监督位置 mask,形状 ,值为 0 或 1 | |
| 有效目标 token 数,单位 token,假设大于零 | |
| 截至当前位置的全部合法历史,不只 assistant 文本 | |
| 自然对数平均 NLL,单位 nat/assistant token |
若模型对 2、。、<end> 的目标概率分别为 0.5、0.8、0.9,损失为 。
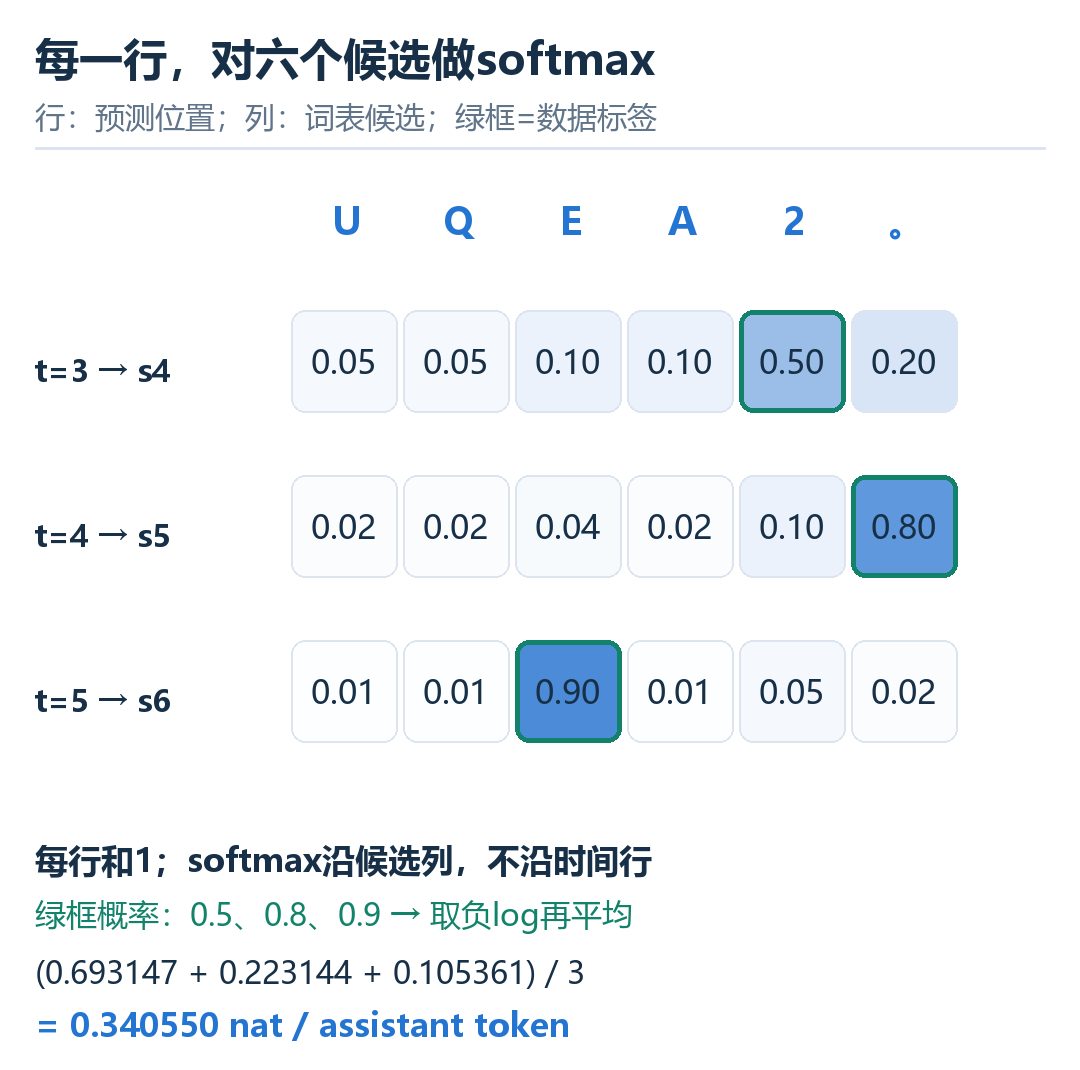
行是预测位置,列是候选token;每行做softmax、和为1;标签只选择其中一格。
这幅图把“模型预测”与“标签目标”分开。三行分别是 的预测,六列按教学词表 排列;蓝色深浅表示模型分给各候选的概率,绿色边框表示数据记录要求预测的真实下一项。softmax 的归一化轴是候选列,不是三个时间行。每行的概率和为 1,但标签只选出本行目标列的 。这些预测概率是示意输入,不是从正确标签本身推出来的。
取每格示意 logits 为对应概率的自然对数,逐行 softmax 可还原图中分布。例如第 1 行是 ,所以指数还原后的和为 1,目标 2 所在列恰得 0.50。取目标列的负对数后,再按有效目标数量平均:
这里除以 3,是因为有 3 个受监督目标,不是因为词表有 3 项、也不是因为序列有 7 项。用户问题预测得好不好不进入这个平均,但正确理解问题仍能帮助降低回答损失。若在多个 turn 中监督所有 assistant 消息,模型会同时学习前面的回答和最终回答;若只监督最后一轮,训练目标不同,应在数据记录里明确。
以下片段接收原序列位置上的 is_assistant_target,明确做右移。
调用前先核对接口:logits 是浮点张量 [B,T,V],ids 是整型 token ID [B,T],is_assistant_target 必须是布尔张量 [B,T]。valid 右移后是 [B,T-1];代码中的 ~valid 只有对布尔 mask 才表示逻辑非。它不是要求把用户上下文从输入中删去。它与预训练损失接口相似,但 mask 来源是角色。代码未在本篇实测;完整实验与实际输出见专题源码附录。TRL 的 assistant-only loss 同样要求模板能提供正确跨度,不能只打开配置就认为任意模板已支持。官方参考:SFT Trainer。
import torch.nn.functional as F

def sft_loss(logits, ids, is_assistant_target):
    scores = logits[:, :-1].contiguous()        # [B,T-1,V]
    labels = ids[:, 1:].clone()                 # 被预测的token
    valid = is_assistant_target[:, 1:]
    if not valid.any():
        raise ValueError("no assistant targets")
    labels[~valid] = -100
    return F.cross_entropy(scores.reshape(-1, scores.shape[-1]),
                           labels.reshape(-1), ignore_index=-100)
检查输入模板时应把解码文本、ID 和 label mask 并排打印,确认回答首 token 与终止 token 都落入监督。仅看 loss 数值不能发现用户文字被错误训练或回答第一项被漏掉。
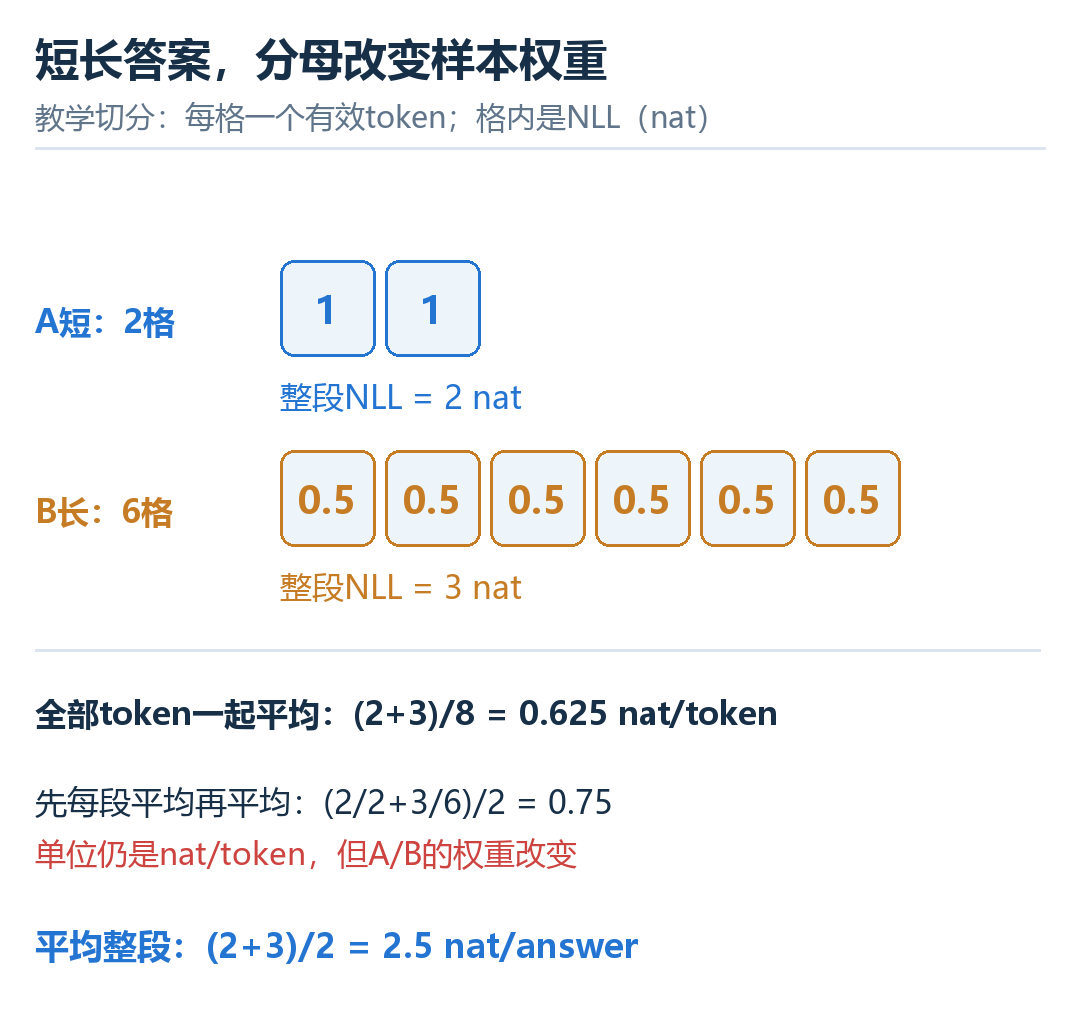
上方每格代表一个有效目标;三个平均的分母不同,不能只比较数值大小。
再用后文的短 A 与长 B 检查单位。假设在这组教学切分中,A 有 2 个受计 token,序列 NLL 为 2 nat;B 有 6 个,序列 NLL 为 3 nat。把所有有效 token 一起平均,是 nat/token;先把各答案除长度、再给两答案相同权重,是 nat/token。虽然单位都写 nat/token,短答案和长答案的权重已经不同。若直接平均序列 NLL,则 nat/answer。不能把 2.5 当成模型比 0.625 差四倍,因为分母是不同对象。SFT 还可能过度模仿长度、口吻、排版甚至错误思考过程,因此要按任务结果评估,而不是把“回答更像范文”当成能力更强。
1.3 工具动作与环境观测
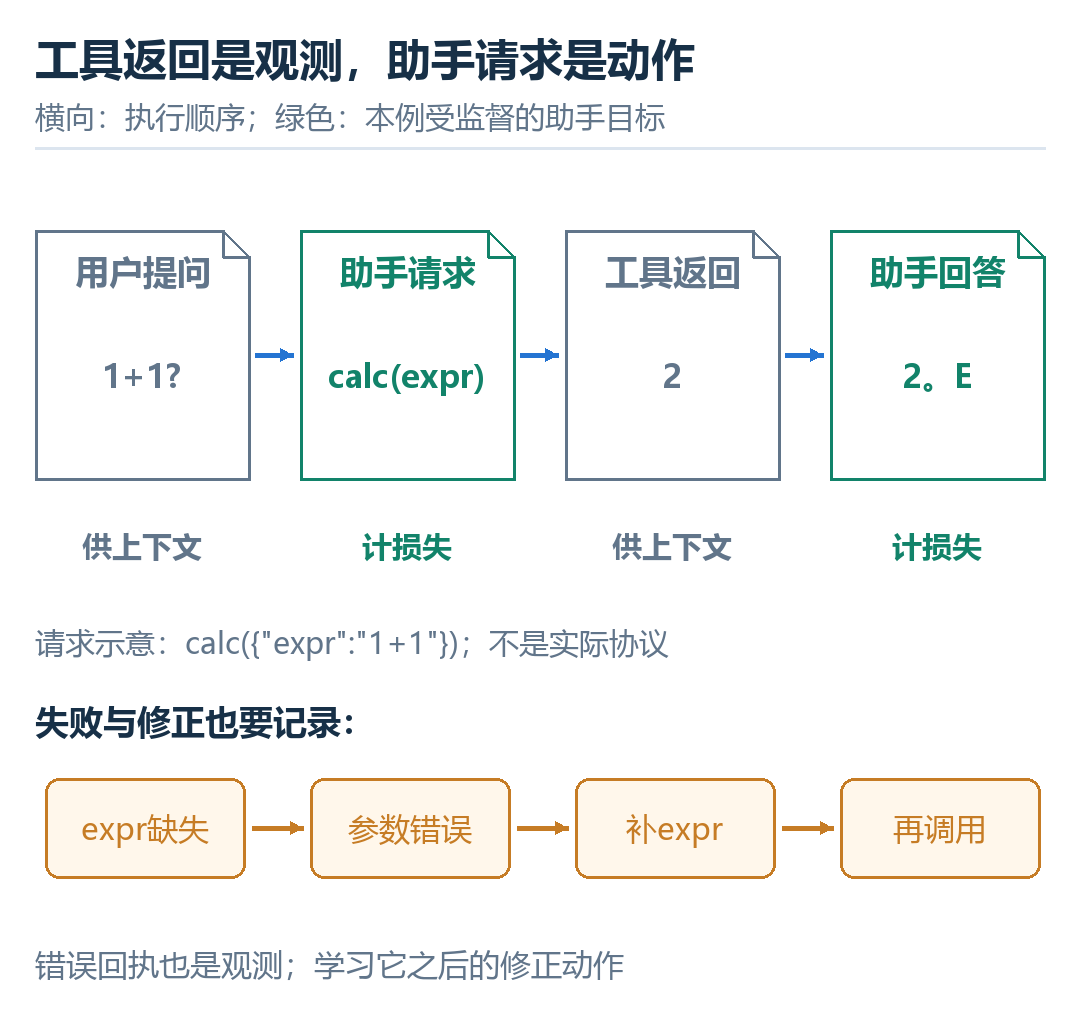
图 1c|工具调用是动作,工具返回是观测(教学示意)
横向四个片段按执行顺序排列:用户提问、助手工具请求、工具返回、助手最终回答。绿色监督标记只放在两个助手动作片段,灰色提问与工具观测提供后续上下文。本图的 calc({"expr":"1+1"}) 和返回 2 都是教学对象,不是从某次商业模型的真实日志截取。
例如请求参数有误,工具回报错误后,助手应能修正参数再试。错误回报仍是环境观测;要学习的是“在这份观测之后选哪一个修正动作”,而不是让模型假装自己已经生成了真实工具结果。
工具轨迹需要同样的精确约定。模型可以输出 calc({"expr":"1+1"}),工具返回 2,模型再生成答案。工具返回值通常是观测,assistant 的工具调用则是动作;如果把观测也作为模型生成目标,训练含义就改变了。优秀轨迹还要包含工具失败、参数修正与终止选择,不能只积累每一步都成功的演示。真实工具标签必须遵循所训练 tokenizer 的协议,不能把本例字符串加入任意模型就期待它自动执行。
2. 偏好标签与奖励模型
2.1 同一输入下的成对比较
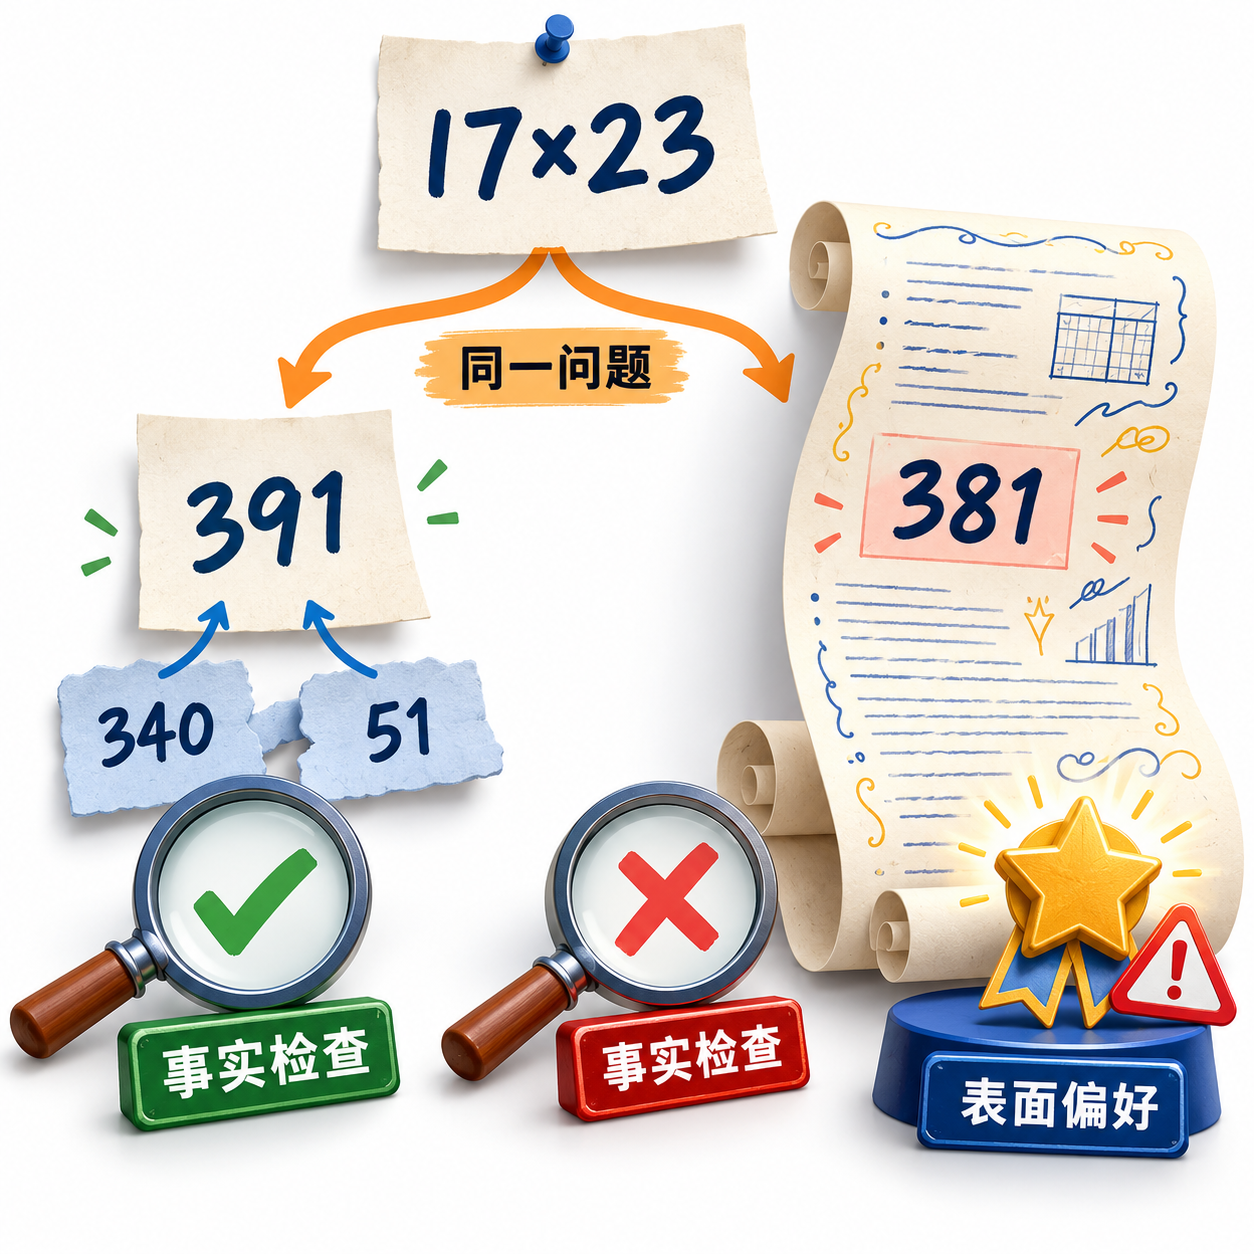
图 2-1|同一道题,先分清事实标签与偏好标签(ImageGen 教学例)
人可能很难写出最优答案,却较容易比较两份已有答案。给同一问题 ,记录选中的 与被拒绝的 。本篇固定问题为“计算 ”:A 简洁回答 391;B 用华丽长解释回答 381。事实核对只需拆成 ,不能被排版或长度替代。
图中的风格徽章刻意展示一种错误的评价规则:它奖励外观,却没有核对算术。若 rubric 明确要求“先正确,再简洁”,应选 A;若标注者仍选 B,标签记录的是这次比较选择,不能把它重新解释成 B 算对了。偏好关系需要连同问题、约束和评价标准一起读。
实际候选未必一真一假:两份都正确时,可以比较简洁、约束遵循或完整证明;两份都错时,胜者仍不是所有答案中的最优。记录平局、不确定和分歧,比把每一票都写成绝对事实更有用。下面的 RM 只学习这些比较所表达的统计关系。
2.2 分差、胜率与梯度
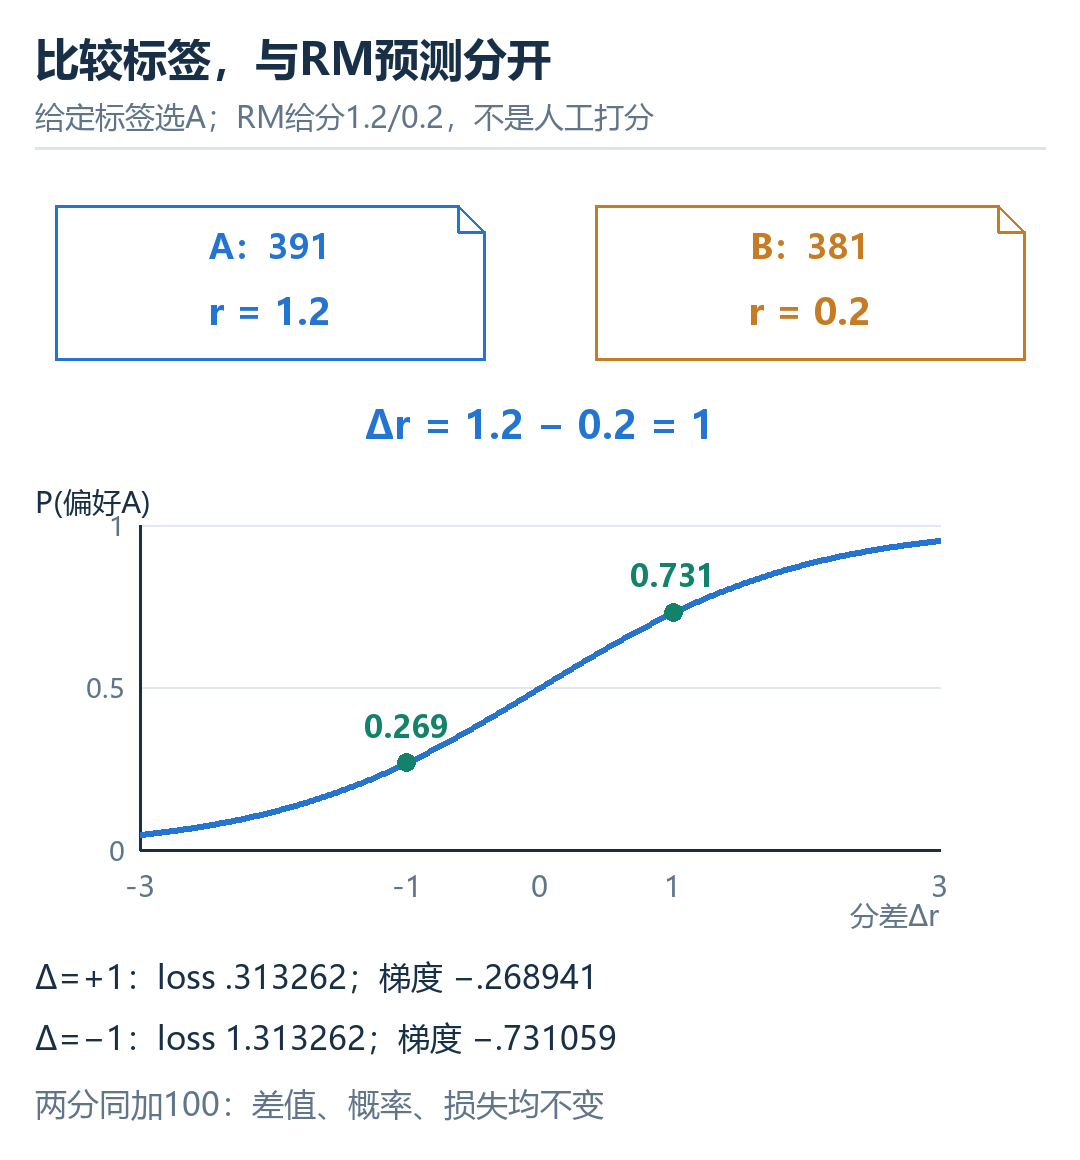
横轴是RM分差,纵轴是预测偏好概率;标注选择与RM预测分开。
在乘法例中,先由给定 rubric 标记 A 为 、B 为 ;这是数据标签。奖励模型再对两份答案输出 ;这是模型预测。图上的 sigmoid 读它们的差,不会再做一次乘法事实核查。这里不对 token 词表做 softmax,而是把一个比较分差变成“本标签被预测为偏好”的概率。
一种典型奖励模型把问题和答案编码后输出一个标量,使用 Bradley–Terry 偏好假设:两个答案的胜率由分数差决定。公开实现可以核对 TRL Reward Modeling;更早的语言模型偏好训练可见 Fine-Tuning Language Models from Human Preferences。
| 符号 | 含义、形状与单位 |
|---|---|
| prompt、选中答案和被拒绝答案,均为可变长 token 序列 | |
| 奖励模型参数和标量分数;batch 输出形状 | |
| 同一 prompt 的分差 ,标量、约定无量纲 | |
| ,输出无量纲概率 | |
| 偏好关系,不是事实真假的等价符号 | |
| 单对比较的负对数似然,单位 nat/pair |
若 ,分差为 1,预测胜率 0.731,损失约 0.313;分差的梯度为 -0.269,梯度下降会继续扩大分差。
把三个量按运算次序连接:,故 ;再取 nat/pair;最后 。反向排序时 ,预测概率只有 0.268941,损失为 1.313262,梯度为 ,因此对这个错误排序给出更大的局部修正信号。图中曲线横轴是分差,不能把沿曲线向右读成训练已经前进了一步。
这一损失更新奖励模型参数 。奖励模型学好后用于给策略行为打分,策略优化才更新生成参数 ;SFT、RM 与策略不能因为都在“训练”就混成同一目标。如果模型把败者分数设得更高,分差 -1,损失约 1.313,修正幅度就更大。将同一问题下全部分数加 100,胜率完全不变,因为只能辨认差值。因此奖励 7 分本身并不表示“70% 正确”,跨不同模型的原始分值也没有统一尺度。
偏好评分器学的是比较分布,不是自动获得真理判定能力。 长度偏好、位置偏好、华丽表达或评审知识缺口都可能变成捷径。可通过交换候选位置、控制长度、保留专家问题和独立事实检查诊断。若用 AI 提供比较,来源改为 AI feedback,但标签仍需要校准;Constitutional AI 是公开的原则与 AI 反馈路线之一,不可据此认定所有 Claude 版本都沿用同一算法和配比。来源:Constitutional AI。
3. 在线 RLHF 与 KL 约束
3.1 在线循环中的职责
奖励模型训练好以后,策略模型生成新答案,奖励模型为其打分,RL 再改变策略,使高奖励行为更常发生。这形成了在线循环。与 SFT 的逐 token 标准答案相比,RL 可以给整段行为一个反馈;反馈到底如何分配给中间步骤,是信用分配问题,后续推理强化学习篇会展开。
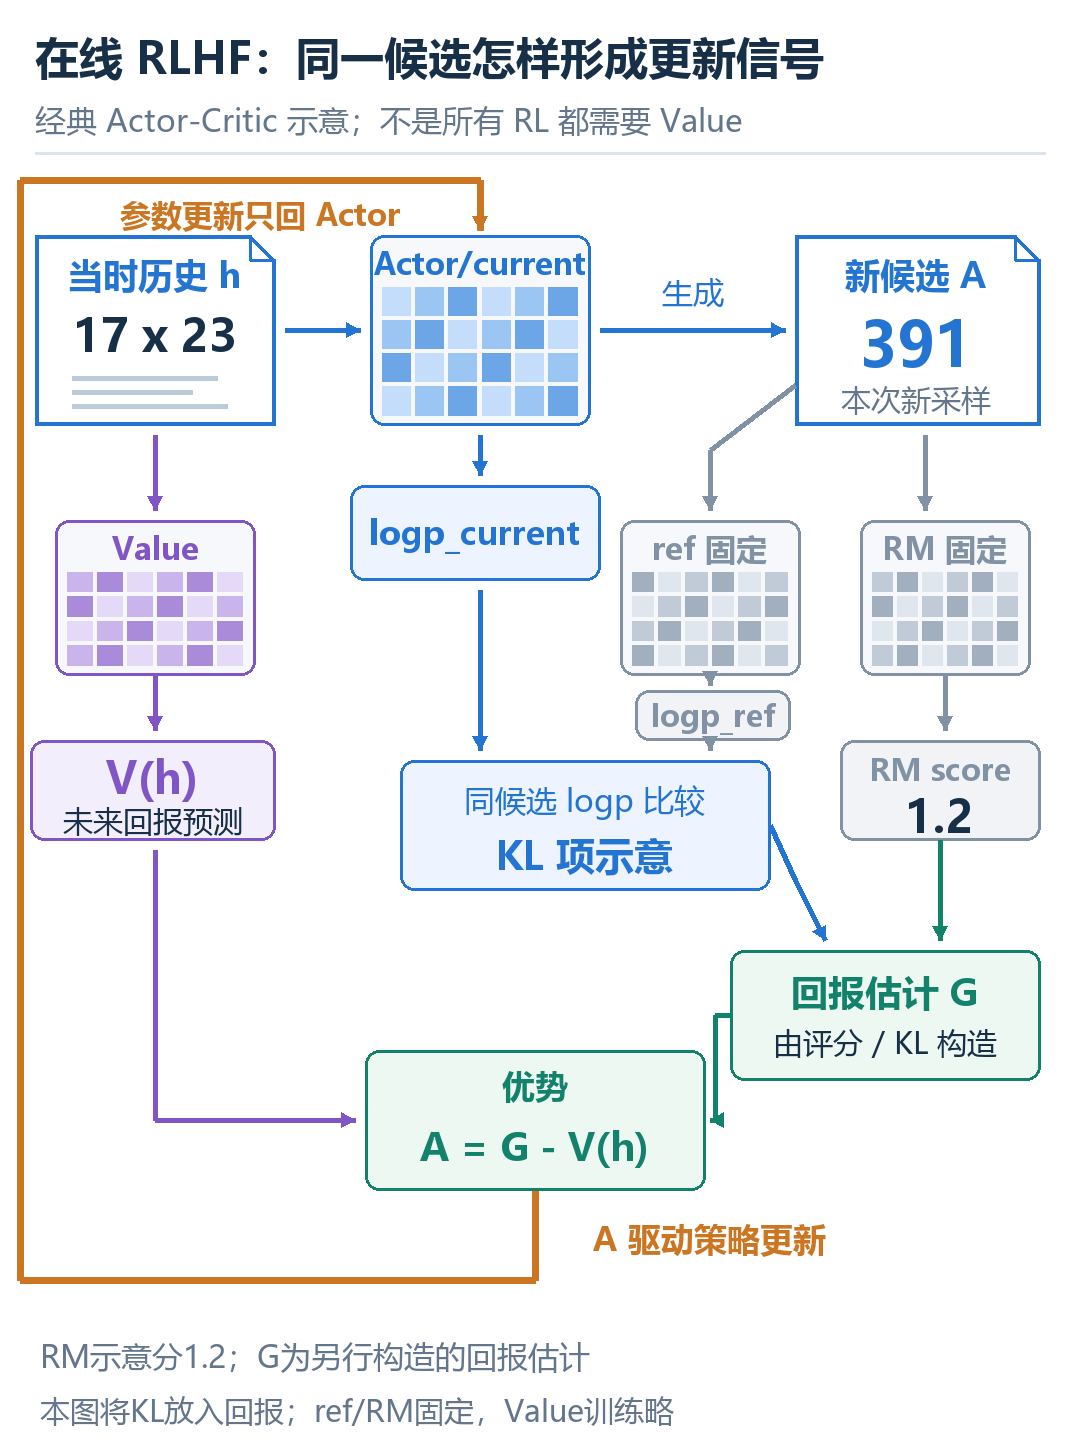
图 2|经典Actor–Critic的职责分离;图中RM分数1.2是示意,不是下一节手定奖励。
从上方候选纸沿三条路径读:RM评价这份答案,reference评估同一答案的概率以比较漂移,Value则读取当时历史来预测未来回报。策略更新需要把反馈和回报估计转成训练信号;图中相减节点展示Value作为基线的职责,不声称每种RL都使用Value。固定的RM与reference在这一阶段不因橙色策略更新箭头而训练。本图选择把KL项纳入回报估计 ;如果实现还在loss中显式加入同一惩罚,应核对是否已计算过,避免无意重复扣分。
Actor 是正在训练的语言模型;Reference 通常是固定的起始策略,用于限制漂移;Reward Model 是已学到的评分器;Value 是回报估计器,帮助降低方差。
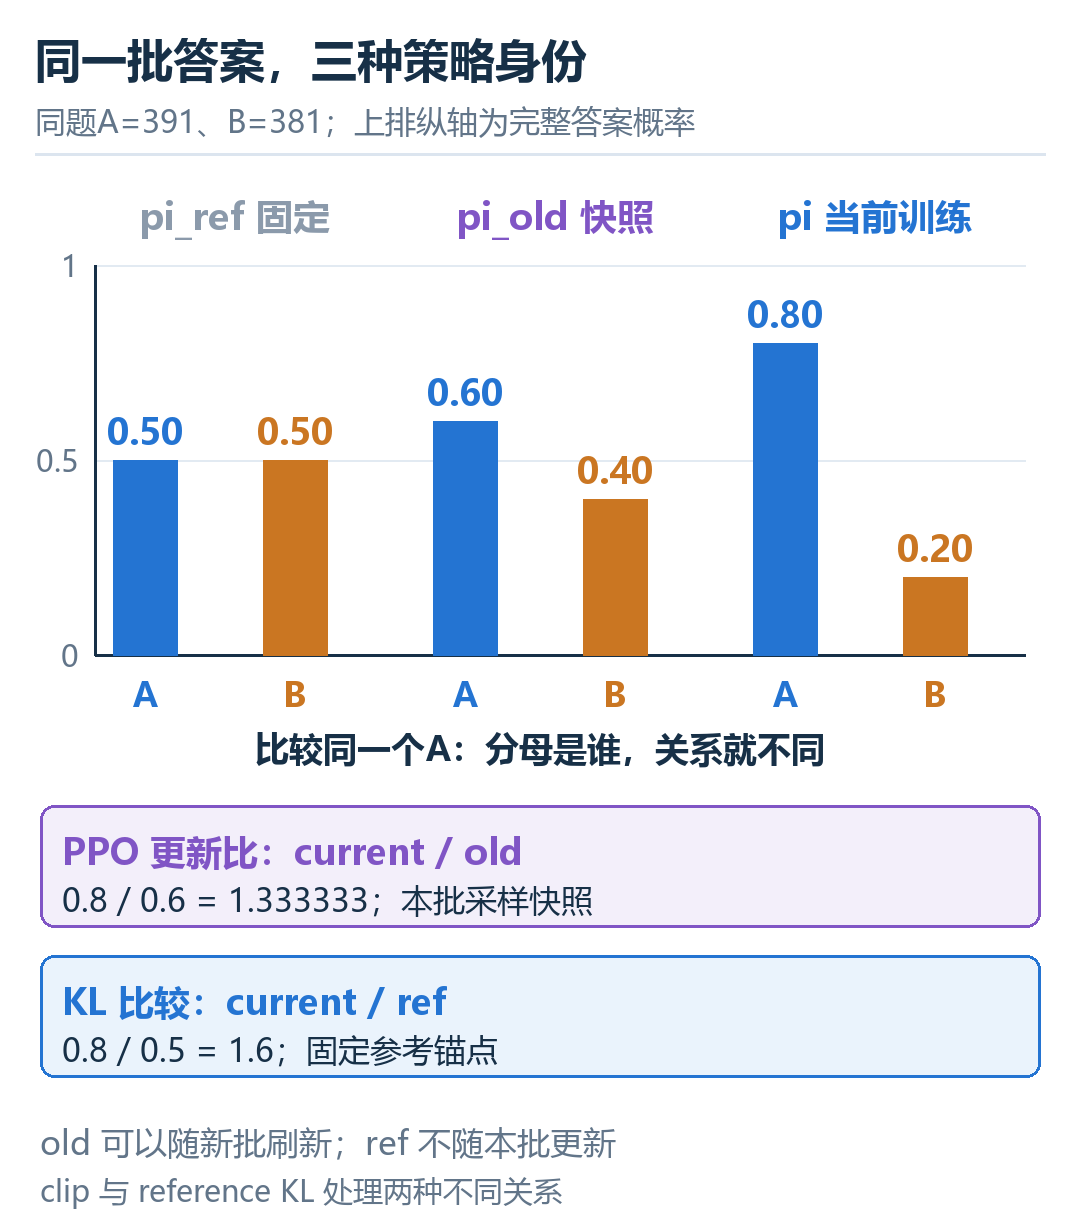
三组是三种策略身份,横轴都是完整答案A/B;PPO更新比与reference KL使用不同分母。
这几个名字里,有两条不同的“比较旧值”关系。沿同一 A/B 答案空间,把固定参考取为 ,本批采样快照取为 ,正在优化的当前策略取为 。图中横向三组分别对应 ref、old、current;每组的横轴都是完整答案 A/B,纵轴是概率,每组两根柱的概率和为 1。
PPO 的 A 答案概率比是 ,分母来自产生本批样本的 old 快照;相对于固定参考的比却是 ,它出现在 KL 漂移关系中。本批旧策略不等于固定参考策略。 old 随采样批次更新,reference 在所讨论训练阶段保持固定,current 则在优化。RM 对完整答案给分,Value 对当时历史预测未来回报;它们也不是这三个策略分布的别名。基础离线 DPO 的四路 log-prob 后面只用 current 与 reference,不需要把这个 PPO old 快照硬塞进去。这些逻辑角色可能共享部分工程资源,但职责不能混同。PPO 使用采样旧策略与新策略的概率比限制更新幅度;它的 clip 约束和对 Reference 的 KL 惩罚处理不同关系。PPO 的一般方法来自 PPO 原论文,其机器人/游戏实验不是语言模型训练配方。
3.2 奖励与参考漂移如何共同计价
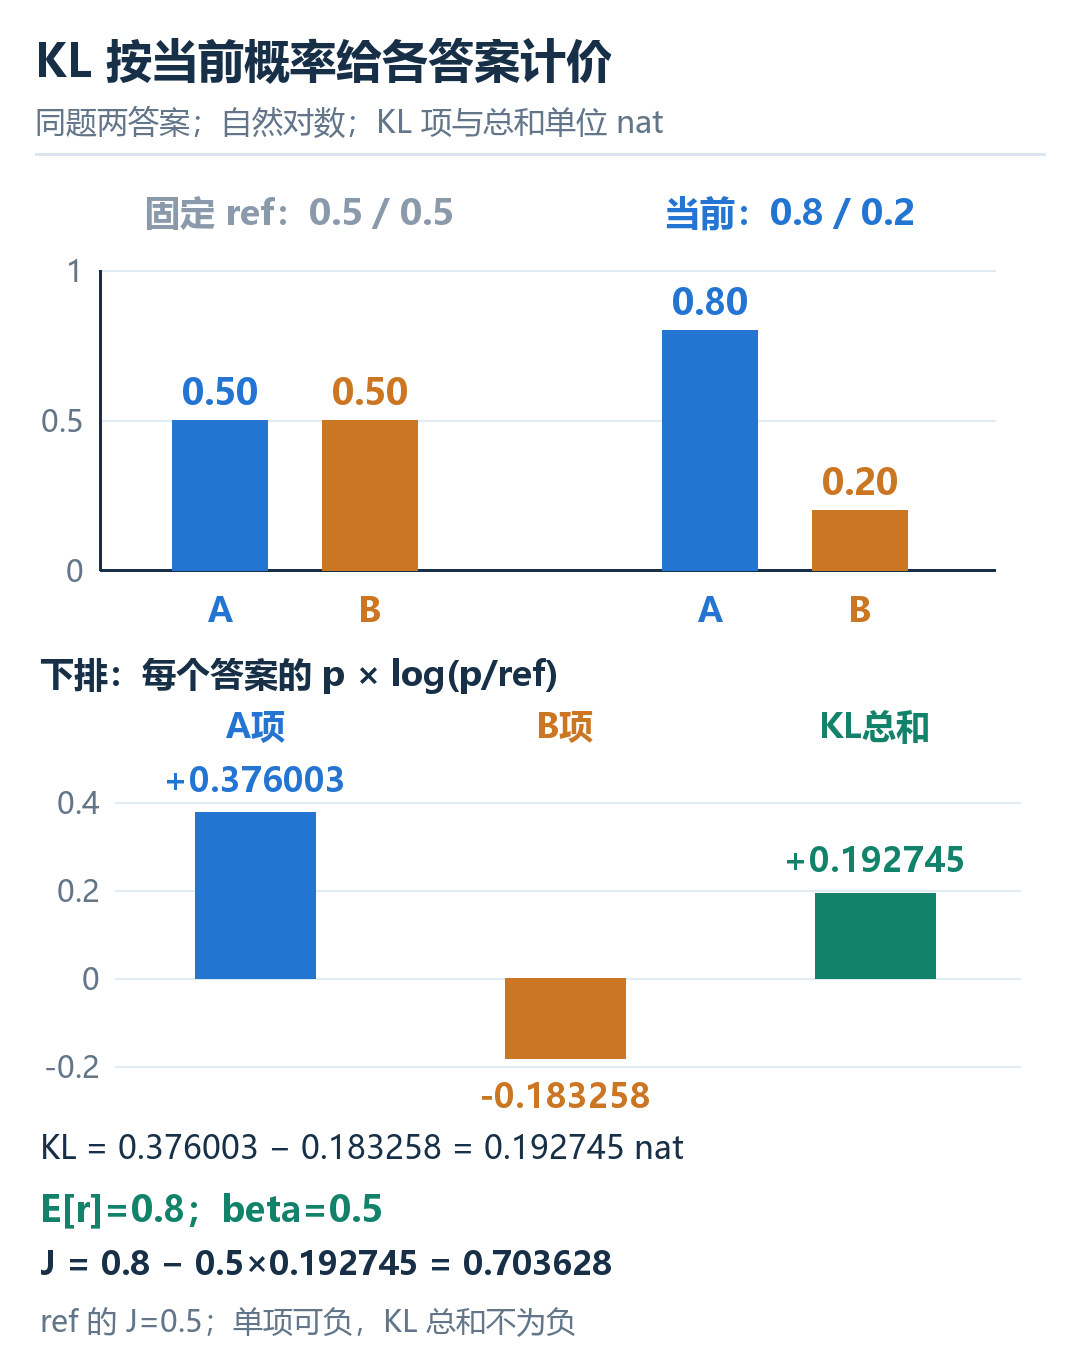
图 3a|A/B 分布变化与带 KL 目标的手算
先看概率图:两根柱的横轴 A/B 表示完整答案类别,纵轴表示生成这些答案的概率,不是单个 token 的概率。参考为 ,当前为 ;当前给 A 更多质量,也必须从 B 移走相同质量。图下方把奖励收益与漂移代价分别画出,再相减得到目标,不能只看 A 的柱变高就宣布目标一定更好。
我们对固定问题写一个带 KL 的理想目标,忽略实现中的截断、长度处理及其他损失:
| 符号 | 含义、形状与单位 |
|---|---|
| 固定 prompt 与包含终止的完整答案; 遍历所有候选答案 | |
| 当前策略与固定参考策略的完整答案概率,均为标量分布 | |
| 固定奖励函数,约定无量纲;可由奖励模型或其他机制提供 | |
| 正 KL 系数;将 nat 单位转换到约定奖励尺度 | |
| 最大化的期望目标;第二项是 forward KL,权重来自当前策略 | |
| 支持集假设 | 当前策略有概率的答案,参考策略应有正概率;并假设归一化和期望存在 |
把答案暂缩成 A/B 两种,参考概率为 ,当前为 ,则 KL 为 nat。若奖励分别为 1 和 0,当前期望奖励为 0.8; 时目标约为 。
每个候选对 KL 的贡献也要保留符号:A 项为 ,B 项为 。单个候选项可以为负,完整 KL 的和才非负。 两项加总为 nat,乘 得 个约定奖励单位;所以 。参考策略自己与自己比较的 KL 是 0,期望奖励为 ,因此参考 。
这里的求和/平均对象是一条完整答案分布,KL 单位是 nat;它与 §1.2 的 nat/assistant token 不能直接作大小比较。 负责把 KL 的单位换到本例奖励尺度。参考策略的目标为 0.5,因此这次偏移仍值得;但继续偏移是否值得由奖励增益与 KL 增长共同决定。
在线训练能探索原偏好数据没有出现的新答案,也会把策略带到评分器不熟悉的区域。若高分来自奉承、冗长或评分器漏洞,优化越成功,真实质量可能越差。KL、独立评测、红队与奖励更新可以缓解这种问题,却不能由训练奖励单调上升证明用户收益。
4. 从约束最优策略走到 DPO
DPO 绕过显式奖励模型训练和在线 RL 循环,使用固定偏好对直接训练策略。原论文给出了它与带 KL 奖励优化之间的联系。以下是以两候选演算为核心的教学重建,目的在于把每个变换检查清楚;并不复述论文全部定理和实验。来源:DPO。
4.1 归一化约束与指数重加权
为便于手算指数,本节把上一节的 改成 ,参考仍为 、奖励仍为 。这是另一套明确给定系数的理想最优分布例,不是把上一节当前策略接着做一次 SGD。
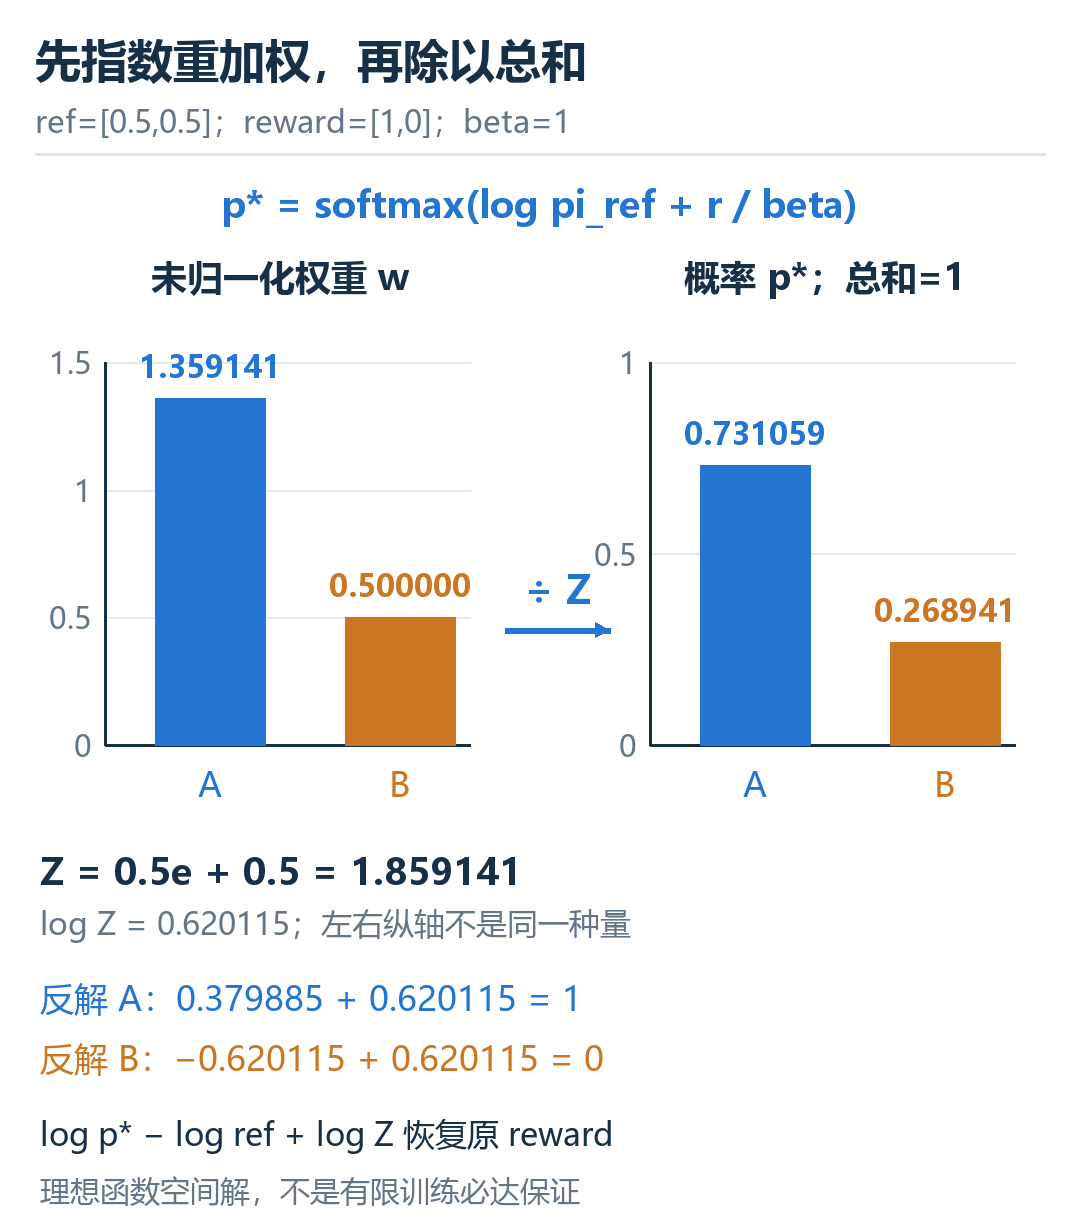
图 4a|未归一化奖励权重除以 Z,得到理想最优分布
先对上面的 增加归一化约束 。以拉格朗日乘子 求每个答案概率的偏导,驻点满足 。
把这条驻点条件拆开,先固定某个答案 。奖励项对 的导数是 ; 的导数是 ;归一化约束给出同一个 。因此:
把共享常数设为 ,才能使所有答案概率相加为 1。图中的“除以 ”是一次对候选答案轴的归一化,不能把它读成给每个 token 单独打分。等价地,可以把 当作答案分数再做 softmax。移项、取指数再归一化,得到:
| 符号 | 含义、形状与单位 |
|---|---|
| 理想函数空间中最大化 的分布;不是有限训练必然得到的结果 | |
| ,标量归一化常数 | |
| 归一化约束乘子,与 使用同一约定尺度 | |
| 固定 后 的简写,均为标量 |
用原创例核对:参考 A/B 概率均为 0.5,奖励为 ,,未归一化权重为 ,总和约 1.859,最优分布约 。
沿左侧未归一化权重走:A 的 ,B 的 ,所以 。这些权重还不是概率,因为和不是 1。两项都除以同一个 ,得到 ;右图纵轴此时才是概率。左图的 1.359 和右图的 0.731 不能当作同单位的两次概率测量。代入反解式,A 的第一项是 ,,相加为 1;B 的第一项约 -0.620,加上 0.620 为 0。
4.2 同题常数相消,得到偏好 margin
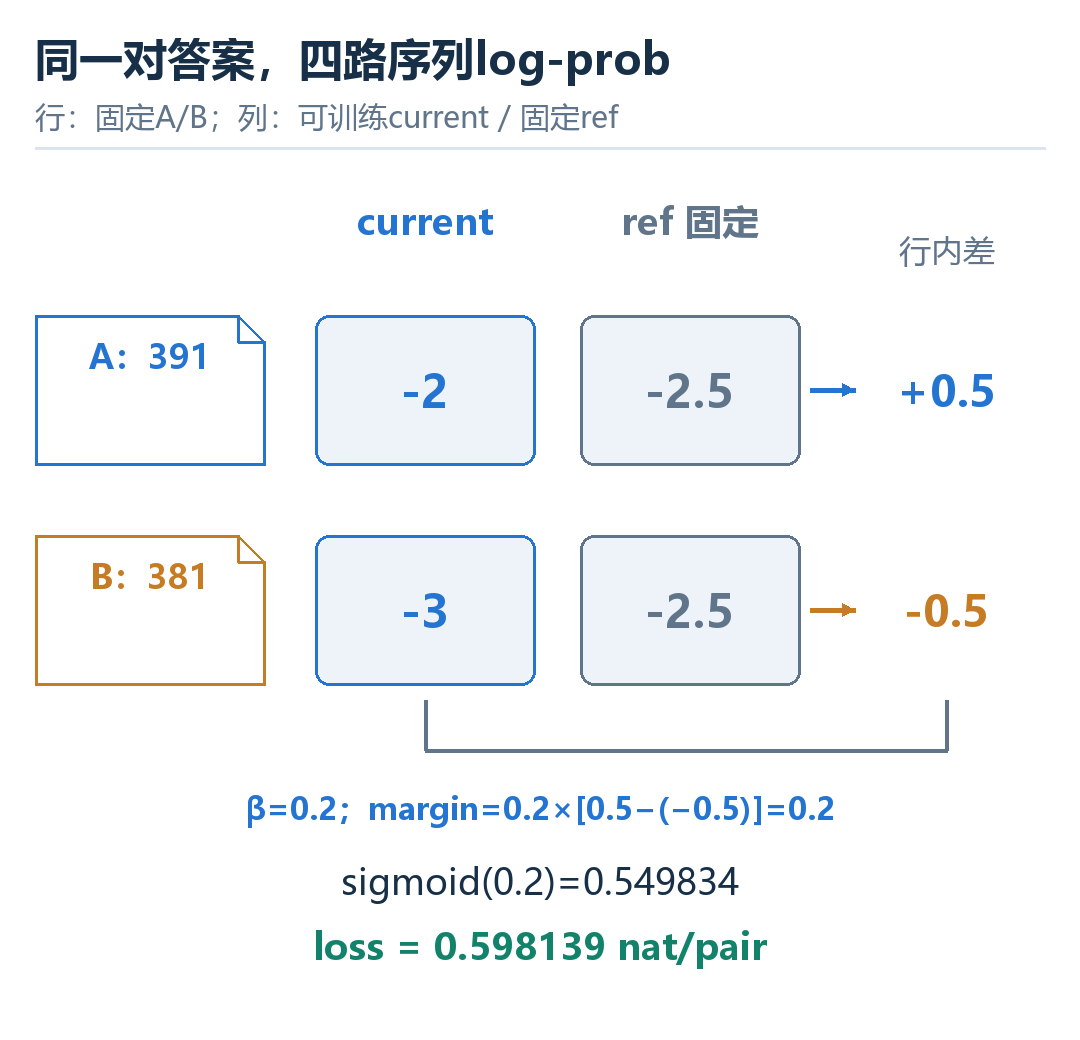
行是同一问题的胜者/败者,列是current/ref;四个值都是整段答案log-prob之和。
在图左侧,A、B 都已经写在偏好记录中;模型此时评估现成答案的概率,不是每做一次 loss 就重新生成答案。两行共享相同 prompt、模板与答案监督跨度。蓝色 current 列可训练,灰色 reference 列固定;先沿每一行相减,再把两行之差相减,最后乘 。这里没有 一列,因为本基础离线损失没有 PPO 的采样概率比。
前一节的理想奖励反解包含 。它在比较中消失的条件是同一个 :胜者减败者时,两份同题常数相同,才有 。若连 prompt、上下文或工具条件也换了,就不能这样直接相消。
下一步只比较同一问题的两个答案, 相消。令语言模型直接参数化这个隐式奖励差,得到一个二元 logistic 分类损失:
| 符号 | 含义、形状与单位 |
|---|---|
| 可训练策略参数; 固定,不参与梯度更新 | |
| 已标注偏好对;两者条件 prompt 必须一致 | |
| 答案 token 条件 log-prob 的和,包括选定的终止目标,单位 nat | |
| 相对参考的偏好 margin,标量;batch 形状 | |
| 此处沿用带 KL 目标的系数约定;不同实现参数化需查公式 | |
| 单对偏好损失,单位 nat/pair;不是单 token CE |
假设策略对胜者/败者的序列 log-prob 分别为 -2/-3,参考值为 -2.5/-2.5。胜者相对增加 0.5,败者相对减少 0.5,取 ,margin 为 0.2,胜率 ,损失约 0.5981。
四路相减完整写成 、,差是 ;乘 得 。再算 , nat/pair。这里 0.549834 是隐式比较模型的概率,不是模型生成 A 的绝对概率; 才是本教学四路值中 current 对这条 A 序列给出的概率。A/B 在这一例不是整个答案空间的全部结果,所以不要求 。与普通 SFT 不同,DPO 使用的是两答案相对参考的差,不能只拿胜者答案 CE 来代替。
4.3 梯度方向与绝对概率边界
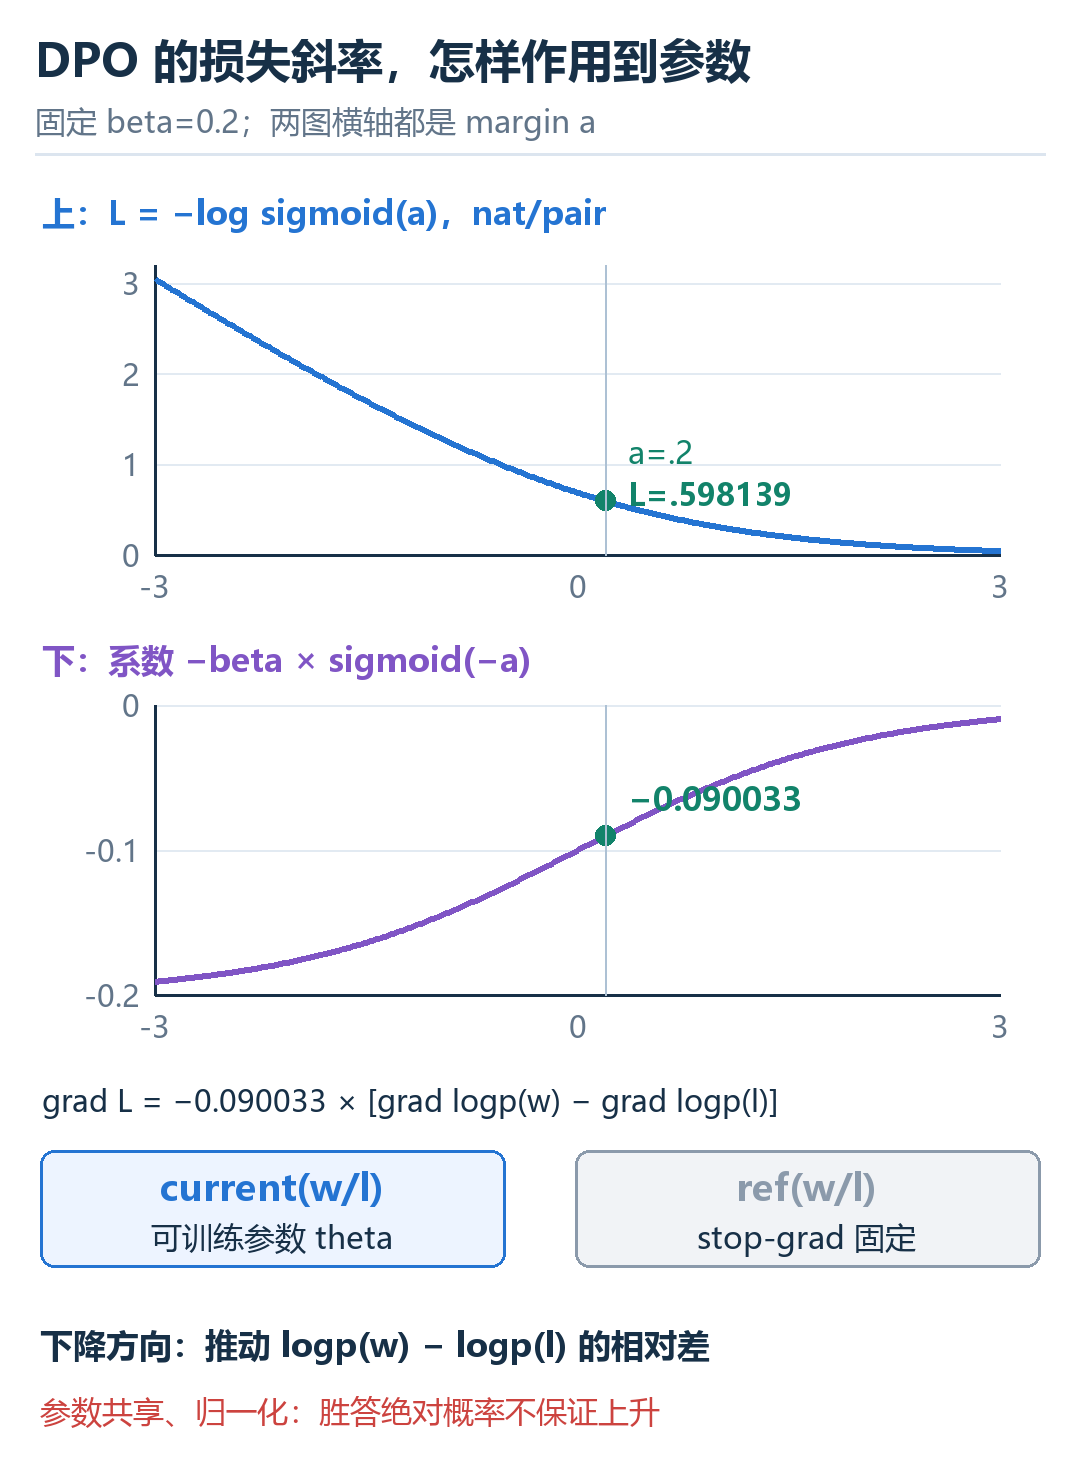
横轴是margin,不是训练步;曲线是函数值与局部梯度,reference停止梯度。
先看图中的 标记:当前比较概率略高于 0.5,损失仍要求扩大胜者相对败者的 log-prob 差。上方蓝线给出单对损失,单位 nat/pair;下方紫线给出参数梯度前的标量系数,在 时为 。曲线较左边的排序错误点,局部系数幅度更大;右边 margin 很大时,系数接近 0。这是某个固定偏好对上的导数关系,不是一次模型训练的质量曲线。
其单对参数梯度可以直接由链式法则得到:
| 符号 | 含义、形状与单位 |
|---|---|
| 对全部可训练参数求梯度;形状与 相同 | |
| 当前排序错误或不确定时较大,正确且 margin 大时较小 | |
| 教学例 时约 -0.0900 |
这给出增加胜者相对 log-prob、减少败者相对 log-prob 的更新方向。但参数共享与归一化使所有答案耦合,不能保证每次更新后胜者绝对概率一定上升;模型可能把两者都降下来,只让败者下降更多。DPO 学习相对偏好 margin,不能用它的下降直接证明绝对质量提升。
4.4 四路 log-prob 的实现约定
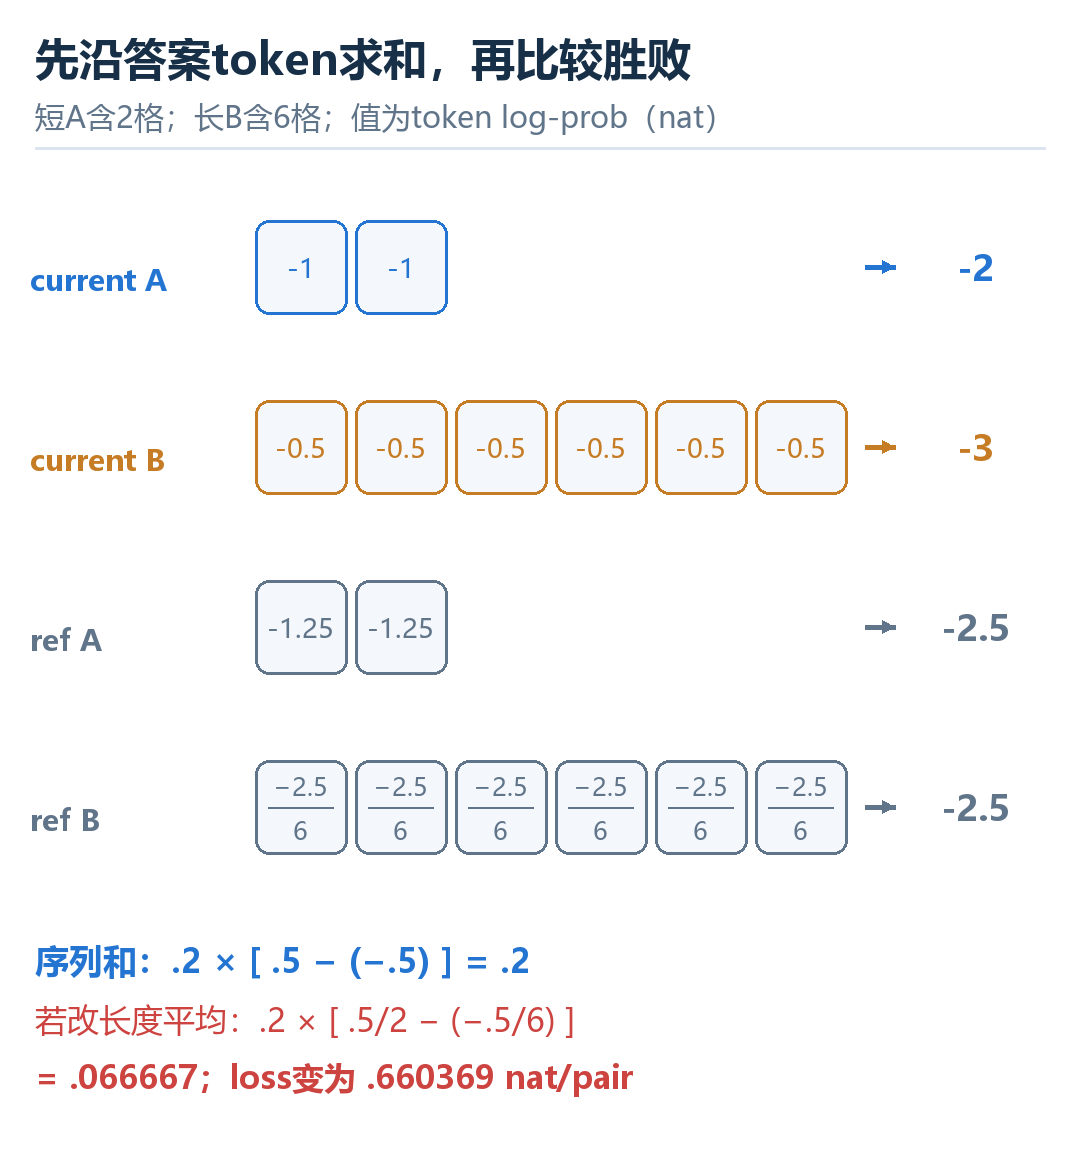
每行是一条已知答案,格子是受计目标;先沿答案token轴求和,再比较两条答案。
延续四路值,并明确一次不对称的教学切分:A 有 2 个受计 token,current 每格 log-prob 为 ,合计 ;B 有 6 个,每格 ,合计 。reference 对 A 两格各给 ,对 B 六格各给 ,两段和均为 。这些格子不声称对应真实 tokenizer,作用是让“先求和还是先除长度”可以实际检查。
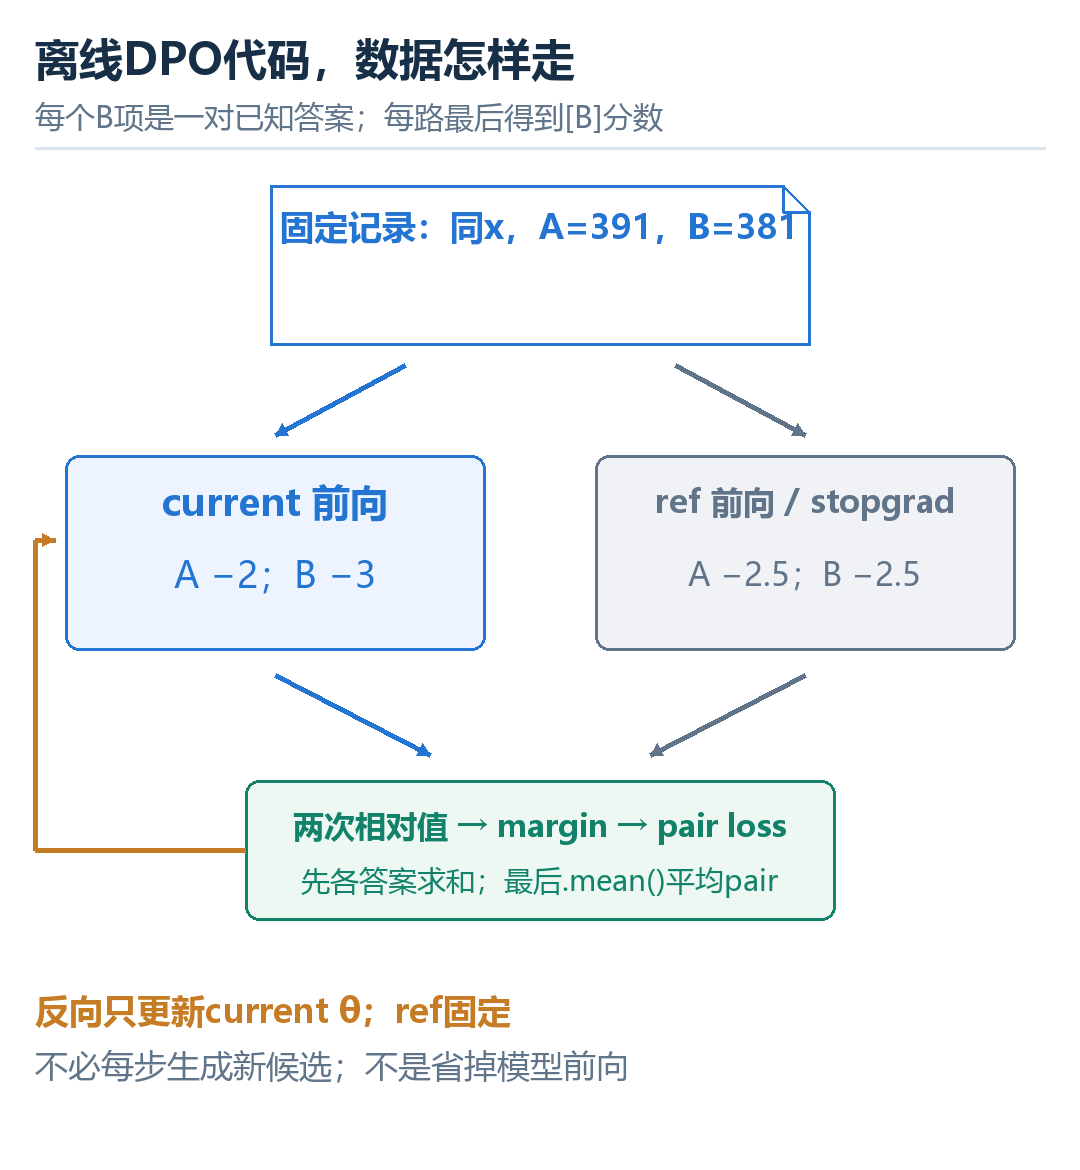
图 3|基础离线 DPO 在训练循环中评估现成答案,无需每步生成新答案
图的两条模型通路读取同一份固定记录,返回四个形状为 [B] 的序列分数;reference 路径标记停止梯度。中间完成两次行内相减与一次胜败相减,最后得到每对一个 loss。这里形状 [B] 中的 B 是 batch 内偏好对数量,不是候选 B 的名字。代码末尾的 .mean() 平均的是 batch 中的偏好对,不是答案里的 token。因此这里输出 nat/pair,不能把它当作 §1.2 的 nat/assistant token。
关键实现只需要四个 [B] 序列 log-prob,但它们必须使用同一 tokenizer、模板和监督跨度。下面为未实测教学片段,预期前述输入给出约 0.5981;框架的实际选项可核对 TRL DPO Trainer。
import torch.nn.functional as F

def dpo_loss(policy_chosen, policy_rejected,
             reference_chosen, reference_rejected, beta=0.2):
    chosen_ratio = policy_chosen - reference_chosen.detach()
    rejected_ratio = policy_rejected - reference_rejected.detach()
    margin = beta * (chosen_ratio - rejected_ratio)
    return -F.logsigmoid(margin).mean()
基础公式使用序列 log-prob 的和,不能随意改成长度平均:平均会改变目标,尽管它可以是有意设计的变体。
用刚才两条不同长度答案算出改变的幅度。求和时两行相对值是 与 ,所以 margin 为 0.2。若先分别除以 2 和 6,则相对均值变为 与 ,margin 变成 ,loss 约为 0.660369。不是小数显示精度改变,而是目标本身改了。
如果两行的相对增加都为正,长度归一化甚至可以改变排序方向。另取一个明确不同的例子:current 仍为 ,reference 改为 ,相对增量是 。按序列和计算 ;按长度平均却得 。这个补充反例使用了新的 reference,不能冒充原来 那组数的更新结果。prompt 参与合法上下文,但不进入回答 log-prob 的求和;padding 不计入求和,也不应作为可读内容进入注意力。beta 对理论最优策略控制偏移;在固定一批 margin 的局部梯度里也影响斜率,不能脱离参考模型、训练量和实现方式断言“越大更新一定越小”。
4.5 三候选实算:损失下降,胜者就更常出现吗?
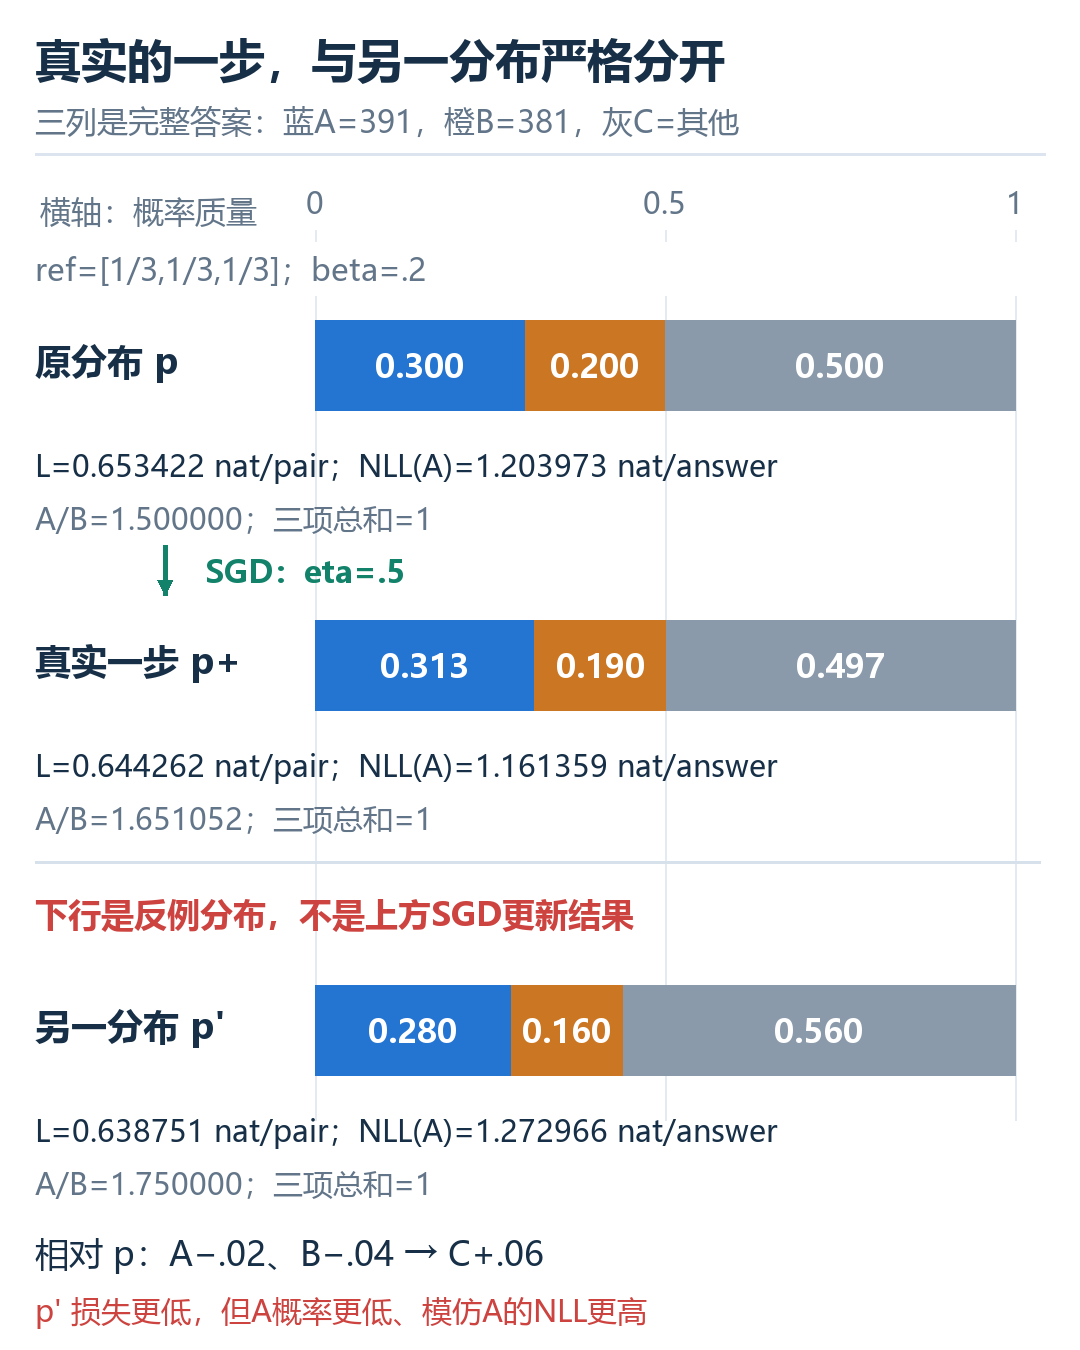
独立logits的真实一步,与另一个低损失分布分别展示。(教学算例)
横轴是完整答案的概率质量,范围0–1;蓝A=391,橙B=381,灰C=其余答案集合。每行三段和为1。纵向三行是初态、真实SGD一步、另一合法分布,只有前两行之间有更新箭头;分隔线下的反例没有被画成同一次更新结果。
图中真实的一步使A上升;第三行是另一个合法分布,A、B都下降但A/B提高。两种损失都能降低,不能把第三行冒充第二行的SGD更新。
把同一道乘法题的完整答案暂时压缩成三个离散结果:A=391,B=381,C=其他答案。C 是剩余概率的集合,不预设它全对或全错。这一缩小空间用于检查目标性质,不是实际 tokenizer 的三个 token。 参考分布固定为 ,当前分布为 ,偏好对只有 A 胜 B,。
先把同一组数字放回三种监督:若 SFT 示范是 A,完整答案的 NLL 为 nat/answer;它与 1.2 中按 assistant token 平均的损失口径不同。若 RM 给 A/B 打分 1.2/0.2,比较概率为 ;C 的得分不参与这一对。DPO 则读取相对参考的概率比:
先算真正的一步。 仅在本例中,让三个 logits 独立可训练,,并取 。
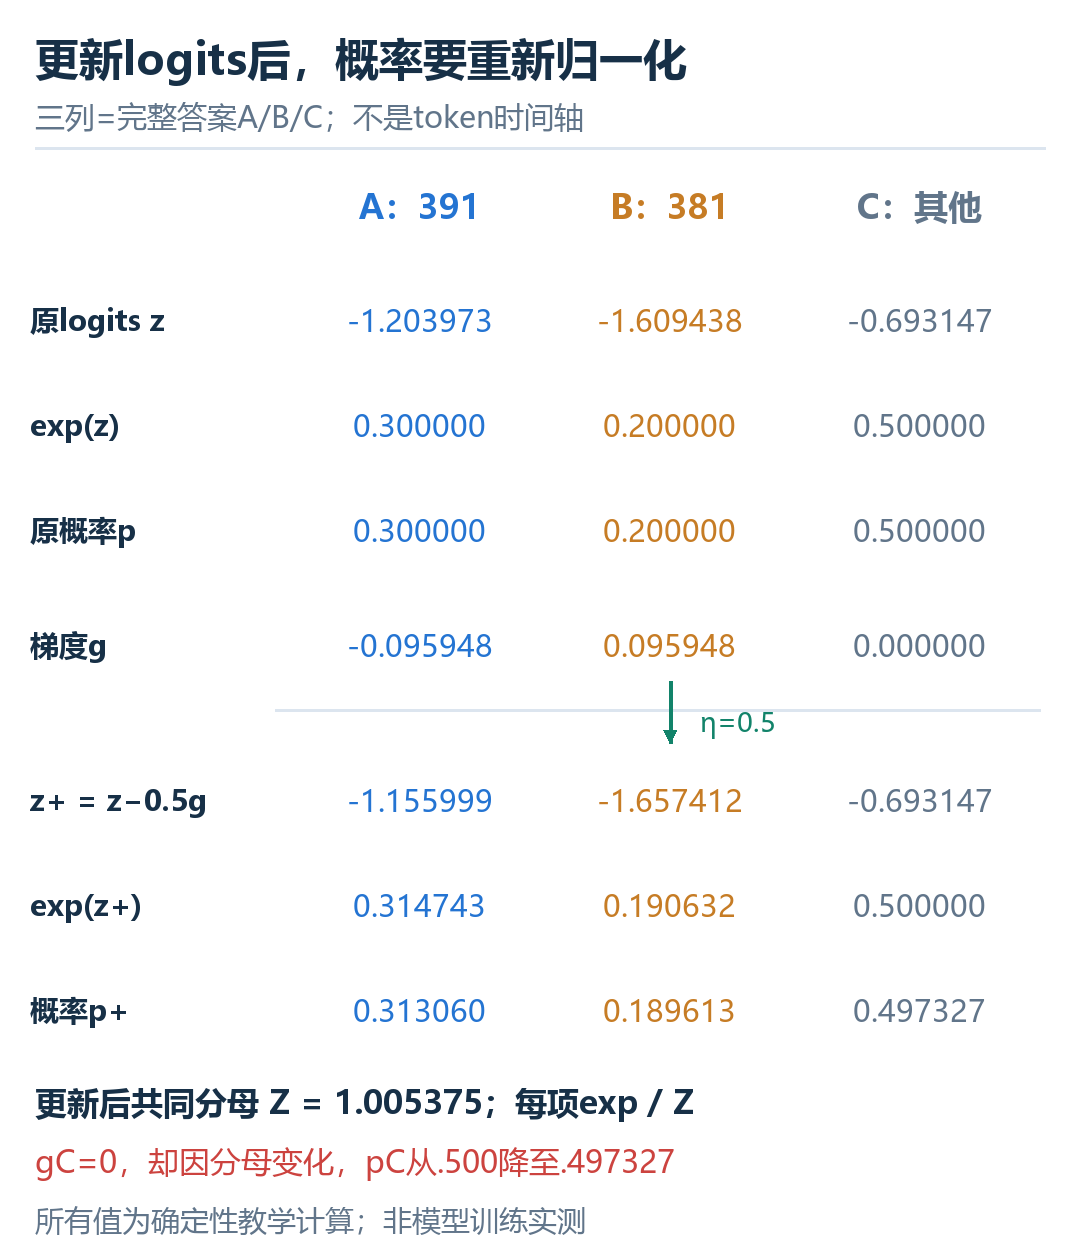
三列是完整答案A/B/C;行是logits、指数权重、归一化概率,不是三个token时间步。
先走图中“更新前”的一侧:,约为 。取指数得到 ,总和恰为 1,所以 softmax 还原原分布。真实语言模型每个位置的 softmax 是在 token 词表轴上;这里则刻意缩成三个完整答案类别,用于检查 DPO 目标性质,不能混用这两种列含义。两项 log-softmax 的公共归一化项相消,所以 ,第三坐标梯度恰为零。
展开公共项相消的原因:,,相减只留下 。因此此特殊参数化下, 的直接梯度为零;但更新后分母重新计算, 仍可以改变。零 logit 梯度不代表该类别概率保持不变。梯度与学习率 的一次下降是:
这一步确实提高 A 的概率,不能为了讲反例,把真实梯度步骤画成 A 下降。图中展示的是另一个合法分布 :它说明仅凭目标值降低,无法反推出绝对概率增加。
A、B 让出的 0.02 与 0.04 都进入 C,总概率仍为 1;A/B 改善,而单独模仿 A 的 NLL 变差。真实语言网络共享参数,还同时处理许多偏好对,情况比三个独立 logits 更耦合。反例限定的是“从 DPO loss 下降推断胜答绝对概率或任务质量”的推理,不是否认这个独立 logits 例中梯度的上升方向。
本次用 NumPy float64 独立核算了归一化、两种分布的损失和一步更新;中心差分对三个 logit 梯度的最大误差约 。这是确定性目标函数验算,没有运行模型训练。精确结果保留在本次工作记录,原有教学代码和历史验证边界保持原含义。
5. 反馈含义、分歧与独立评测
5.1 三种反馈不构成必经流水线
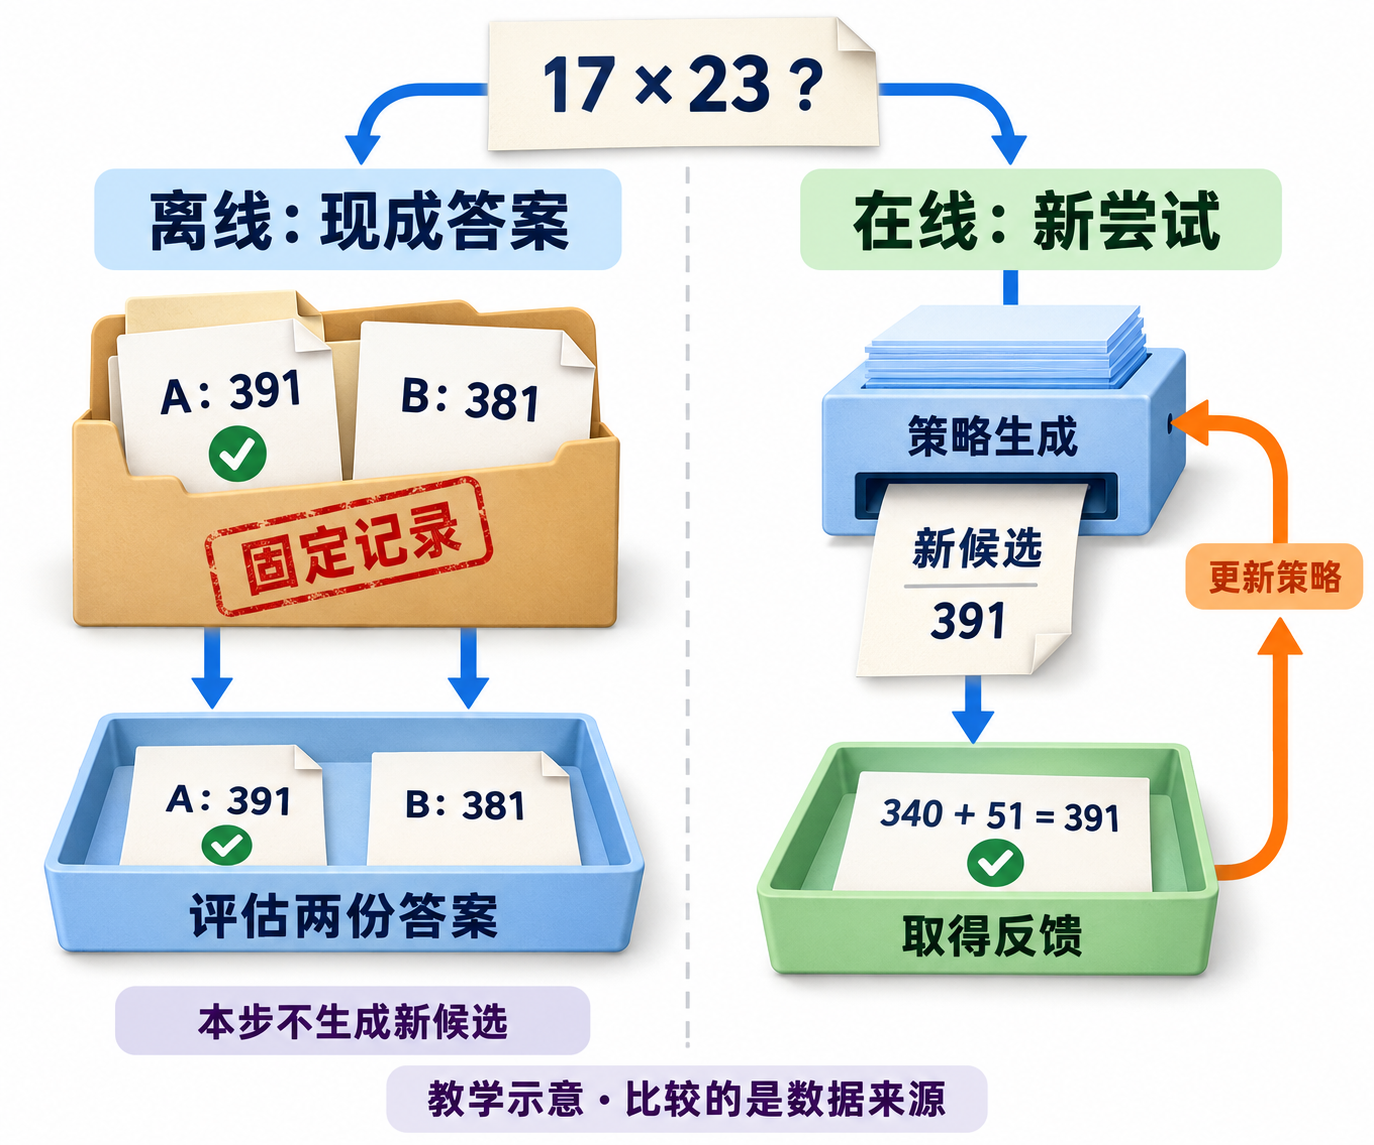
图 5a|示范、固定偏好与在线尝试提供不同监督(ImageGen 教学图)
图左从固定文件夹取出 A=391、B=381,两张已有纸页进入评估托盘;图右才从策略生成口产生一张新候选,再到算术检查托盘取反馈,橙色回线代表策略更新。左右对照的是本步候选的来源,不是断言离线方法不更新参数。左侧 DPO 仍对现成答案做前向、计算损失和反向传播,只是不必在每个训练步重新采样答案。SFT 的单份示范来源已在第1章展开;下表把三种反馈职责放回同一问题。
| 方法 | 给模型的反馈 | 学习的直接对象 | 主要检查 |
|---|---|---|---|
| SFT | 一份示范轨迹 | 示范输出的条件概率 | 标签跨度、示范正确性、任务泛化 |
| RM + RLHF | 比较训练评分器,在线轨迹获得奖励 | 高奖励行为的采样概率 | reward hacking、KL、独立结果评估 |
| 基础离线 DPO | 固定胜者/败者对 | 相对参考的偏好 margin | 标签噪声、长度效应、离线覆盖与漂移 |
偏好对只覆盖已有候选;若数据中从未出现正确解法,基础离线目标没有在线环境帮它发现。理论联系依赖偏好模型和理想函数空间,有限样本、矛盾标注、模型容量与优化误差都可能打破预期。SFT 也不必永远在偏好训练之前,训练系统可以混合或迭代这些信号;这里的顺序用于理解职责。
5.2 保留分歧,保留监督的统计含义
这一节先控制事实正确性,换成同题的两份正确候选:A 只回答“391”,B 给出“”的证明。图中 B 不再是前面错误的 381。这样才能把标注差异与长短、解释需求联系起来,而不让算术错误被风格解释掩盖。
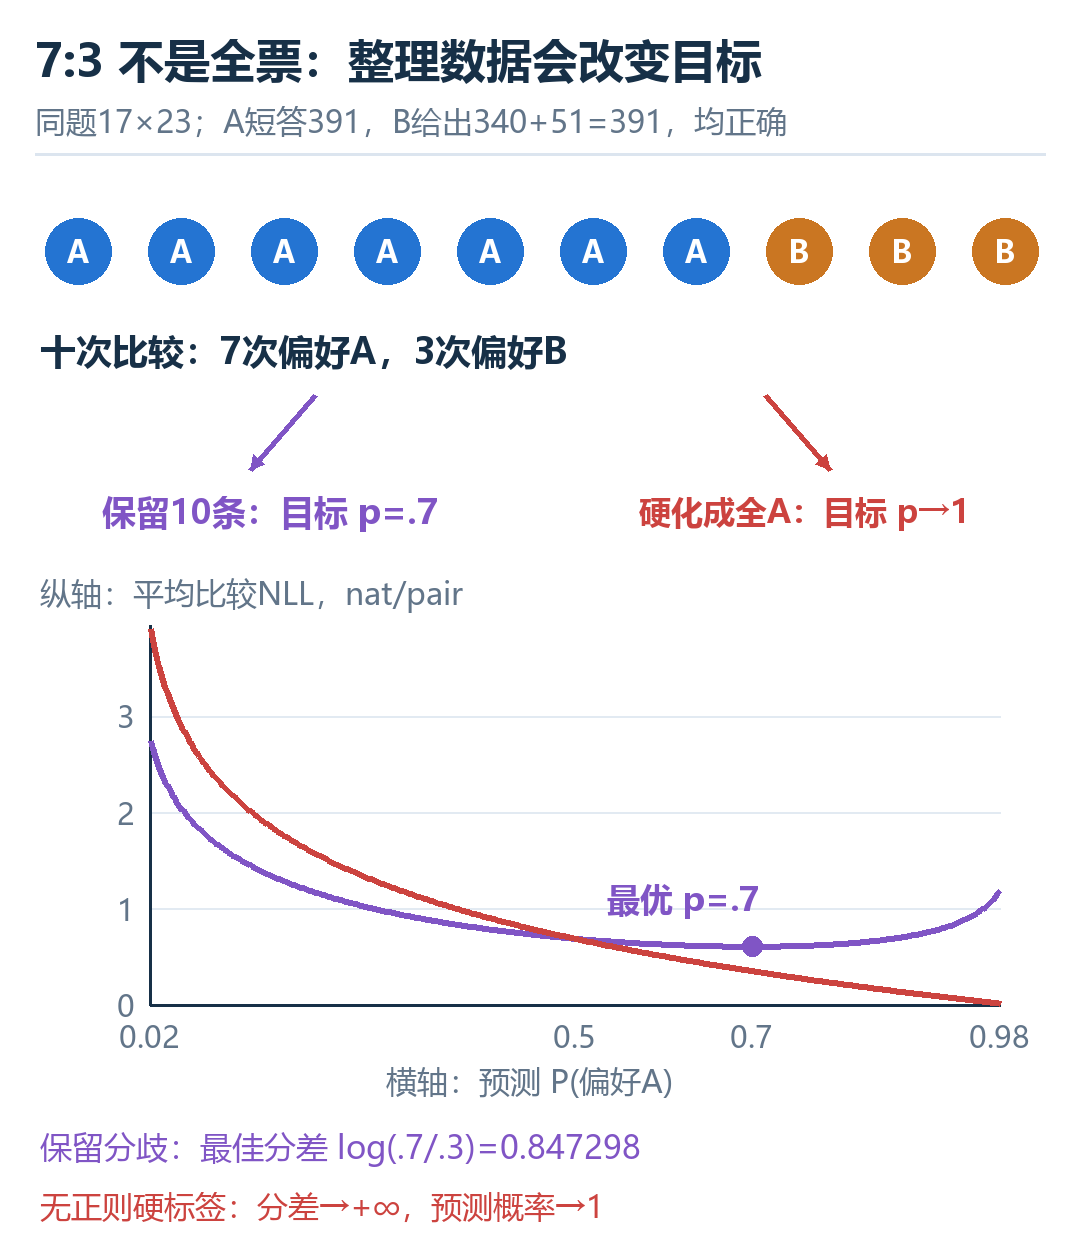
图 5b|保留 7∶3 标签与把多数改为绝对硬标签,优化目标不同
同一偏好对可以有分歧。假设对固定问题与固定两答案重复标注,十次中七次偏好 A、三次偏好 B;
这里的 7∶3 是对固定问题、固定两答案的比较标签计数。如果继续使用前文 391/381 那一对,它意味着有人偏好了错误的 381,并不表示 381 有 30% 的概率算对。图中的十个票据是十条标注,不是十次模型生成,也不是“正确概率”分块。把十条都保留下来,logistic 目标的最优预测概率是 0.7,最优分差为 。
这个结果来自保留频率后的平均比较损失。令 是模型预测偏好 A 的概率,范围为 :
曲线在 达到最低点,是对这份标注频率的拟合;把全部标签改成 A 后,目标变成 ,在没有正则的理想情况下持续偏好 接近 1。两条曲线的横轴是预测概率,不是标注人数或训练步。若只保留多数标签并把它当作绝对正确,信息就变成“所有标注都偏好 A”,理想的无正则 logistic 目标会持续推动分差增大。这两种数据整理方式训练的对象不同,不能把硬标签替换当成无影响的压缩。
分歧也未必只是噪声。有人重视简洁,有人需要完整证明;
本节图中正是用两个都正确的答案做控制:同题 A 只回答“391”,B 回答“”。这与前文华丽但答成 381 的 B 是不同候选对;不先控制事实正确性,就不能把 7∶3 全部归因于长度偏好。如果问题没有写清约束,两个答案可能各有合理用途。把需求写入 prompt、分项标注事实与风格、保留平局或不确定标签,可以让监督含义更清楚。胜答与败答必须对应同一个输入条件:问题、可用工具或上下文不同,序列概率之差就失去原来的偏好解释。
5.3 训练指标与独立任务结果
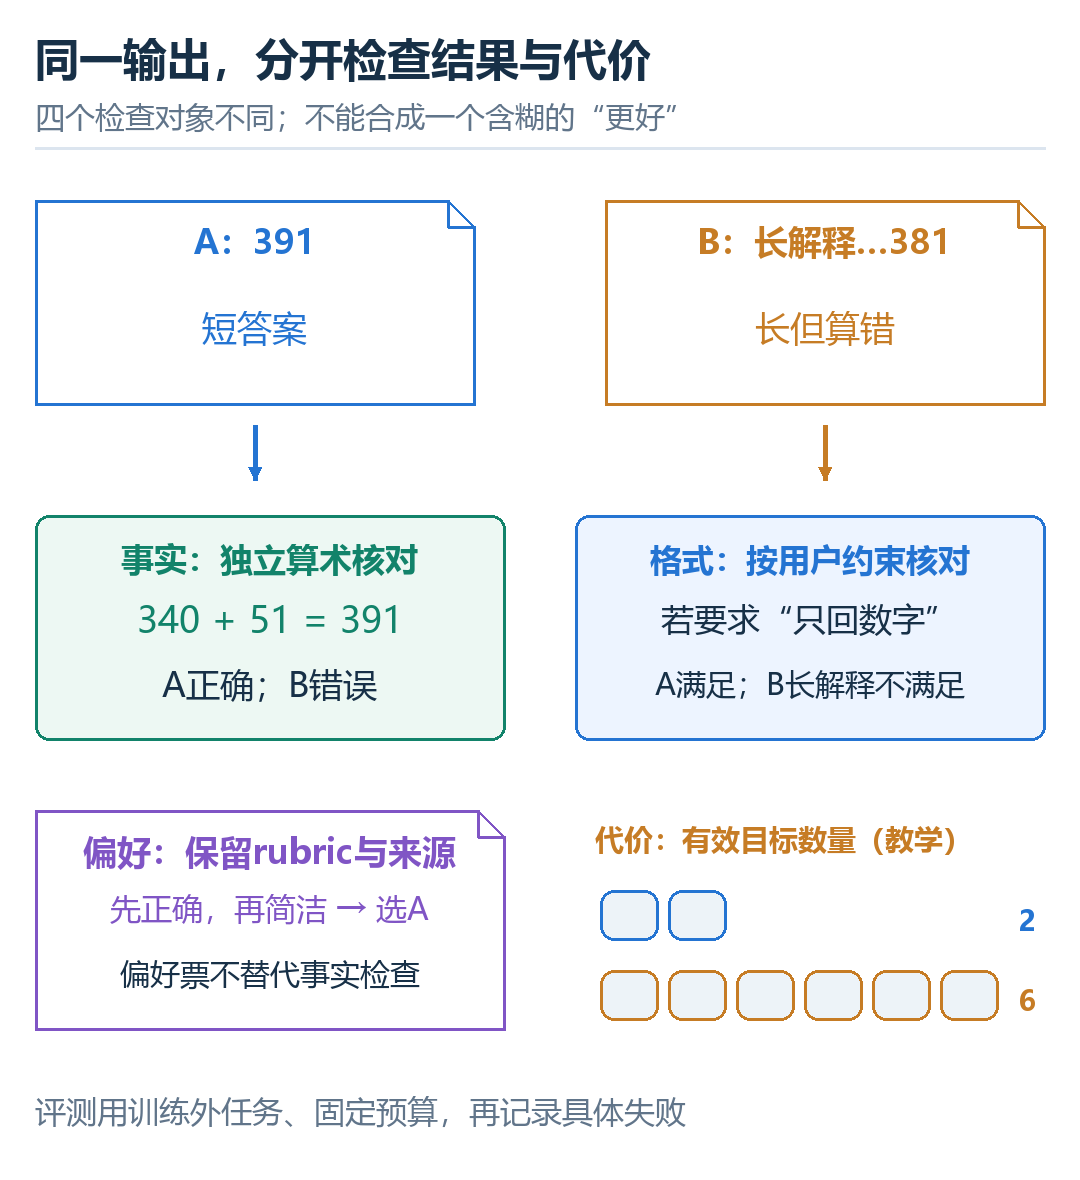
四个检查对象分开;答案长度仍用2/6格教学切分,不是实测tokenizer计数。
从上方 A=391 与长解释 B=381 分别往下看。事实槽用 核对算术;格式槽另按用户“只回数字”的约束核对,所以内容正确和格式符合是两项结果。偏好槽保留rubric与标注来源,不让一张风格票覆盖事实;代价槽数有效目标或其他事先定义的成本。若任务还包含工具执行,就另外检查真实返回与环境状态,不能从语言回答看起来完整推出工具已经成功。
训练结束后,最好分开检查独立事实题、格式与工具执行、开放偏好和代价变化。某个偏好集胜率提高,可能主要来自更长回答或更熟悉裁判风格;某个 DPO loss 降低,也可能集中在已有候选的排序。保留训练外任务、固定推理预算,并观察回答长度、拒绝率和具体失败样本,才能判断提升是否来自期望的行为。这里仍没有从偏好标签推出真假标签的数学保证。
到这一阶段,助手学会了对话协议、输出习惯和偏好方向。要让模型自行尝试复杂数学、执行代码测试、使用工具反复验证,还需能评价结果的环境与强化学习信号。下一篇沿这个缺口解释可验证奖励、策略梯度和推理能力的增长。
正在连接 GitHub 评论…