07.1.6|OPD 的稳定性:候选重叠、教师熵与局部支持集
返回 OPD 专题导读 · 前置:MiniLLM 与 GKD · 实现:轨迹与对齐
教师答题更强,学生却未必从它身上学得更好。反馈是否落在学生能利用的候选上、教师是否仍保留多种续写、一次更新究竟比较一个 token 还是一组分布,都会改变训练。候选重叠、熵与支持集,是观察 OPD 稳定性的三种不同坐标。
本文先读失败与成功的训练动力学,再看三类干预:改变初始策略与提示分布、按教师熵调整目标、在局部候选集合上比较分布。引用的是指定论文版本的方法与实验;教学概率和诊断图属于本站分析,未运行模型训练。
1. 训练动力学中的候选重叠
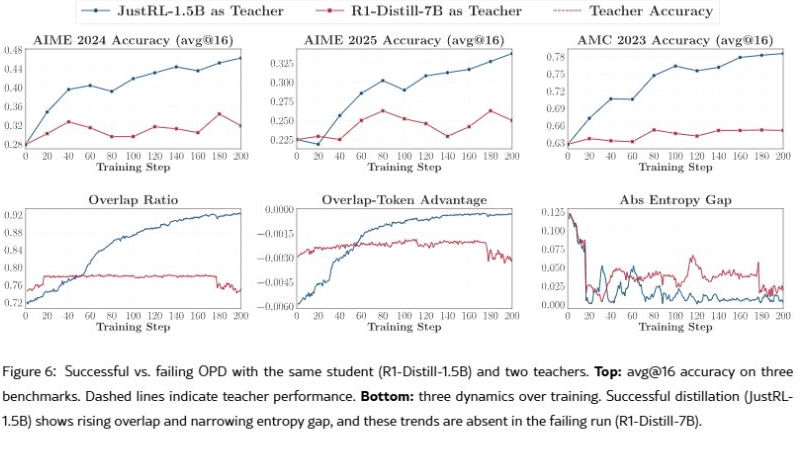
来源:Yaxuan Li 等,Rethinking Figure 6(截图裁切,CC BY 4.0)
上图上排是三个数学评测,下排依次是候选重叠、重叠 token 的优势和绝对熵差。蓝线对应 JustRL-1.5B 教师,红线对应 R1-Distill-7B 教师;学生固定为 R1-Distill-1.5B,训练数据同为 DAPO-Math-17K。两名教师数学表现接近,后者还略强,但学生从前者获得了清楚的收益。
观察左下角:成功训练中的教师与学生高概率 top- 候选重叠逐步增加,失败训练没有同样增长;熵差的变化也不同。这使“教师有多强”变成一个更具体的问题:学生实际访问的前缀上,教师的高概率续写能否逐步成为学生也愿意考虑的续写? Rethinking §4.1 用同学生、不同教师的设置考察这一过程。
恰似故人归的 Rethinking 解读把阅读分成现象、机制和配方三层。对应这张原图,上排回答相同学生换教师后表现怎样,下排给出重叠、优势与熵差的机制线索,下一章的冷启动和提示对齐才进入干预。三层相接,仍不能倒过来用某个配方有效就认定唯一原因已证明。
Your 的学术问题表把 tokenizer、候选重叠、KL 与 agent 错误累积并列,适合用来提出诊断问题。其 Figure 6 解释也强调成功训练中的重叠增长与失败停滞。这里应同时看教师原始任务分数、学生前缀上的可利用反馈及训练后的学生表现,不能把教师 benchmark 直接当成可学习性,更不应由一份问题表推断所有 OPD 都受同一个教师上限约束。
这里不能从曲线读出一个放之四海皆准的重叠阈值,也不能凭共变就证明低重叠是所有失败的唯一原因。原图同时保留表现与分布动力学,正是为了避免只盯着训练 loss。本文仅采用原文支持的定性关系,不从图片反推精确坐标或统计显著性。
2. 冷启动与提示对齐
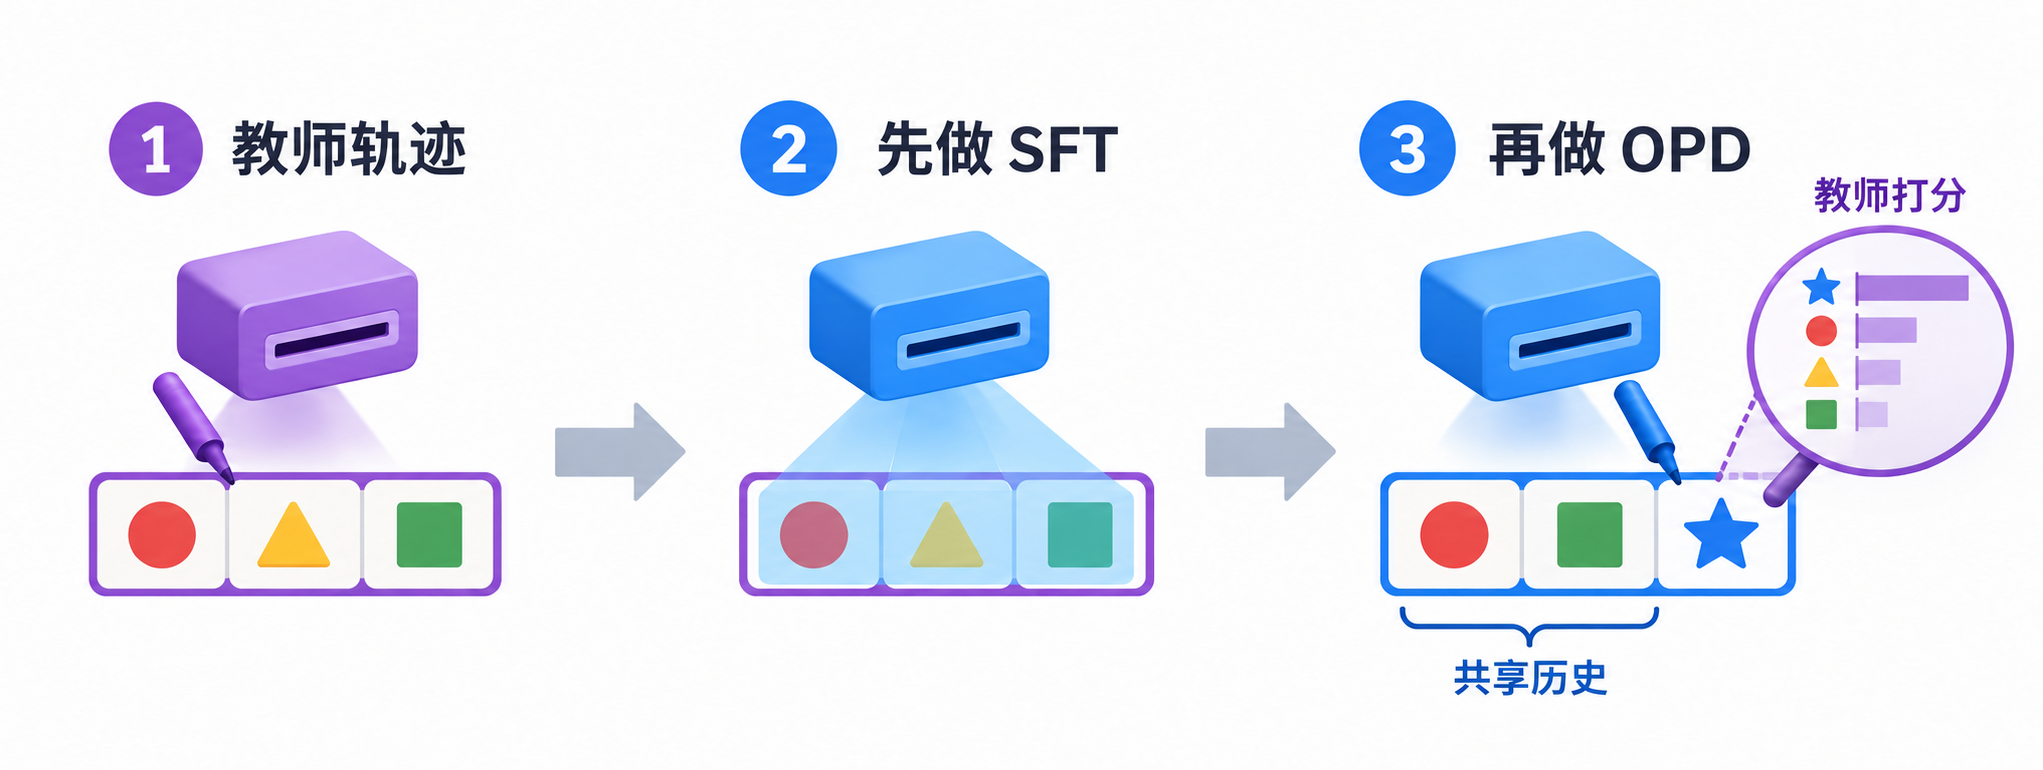
图 1|离线教师轨迹用于冷启动,后续 OPD 仍由学生生成
图 1 左侧教师先给示范,中间学生在已有轨迹上做 SFT,右侧才进入学生自行生成、教师在同一历史上评分的 OPD。两条示意回答故意不同:冷启动不是要求训练后学生永远照抄教师,而是改变 OPD 开始时学生的策略,使教师反馈更容易被利用。
Rethinking §5.1 采用这个两阶段方案。Figure 8 的设置与前一章不同:教师固定为 Qwen3-4B(non-thinking),比较 Qwen3-1.7B-Base 直接 OPD 与经过教师轨迹 SFT 后再 OPD。论文报告,冷启动提高起始重叠,并在所示评测中取得更好的后续表现。这支持一种具体的修复路径,不证明任何学生都必须先 SFT,或任意 SFT 都能修好失败。 来源:Rethinking §5.1、Figure 8。
同一节的另一类干预不改模型结构,而是改提示。§5.2 分开考察 prompt template 与 prompt content:前者对齐教师后训练所用模板,后者使用更接近教师训练分布的问题。模板对齐的 Figure 9 显示更好的表现和重叠增长;内容对齐的 Figure 10 又显示,概率质量可能更集中到共享候选,学生熵显著降低。
这两种变化需要一起读。提示对齐能让监督更贴近教师熟悉的行为,同时也可能使学生过早收窄续写。论文因此提出混入分布外提示来防止熵坍塌。这里不补造配比,也不把“熵越高越好”当成目标:需要保留的是对任务有用的多样性,而不是任意随机输出。
从条件概率看,模板也是前缀的一部分。相同题目换了回答格式要求,教师下一步更愿意写什么就可能改变;内容对齐还改变了训练时访问哪些问题。因而,模板对照宜固定问题集合,内容对照则明确数据来源。这是理解干预的计算解释,不能把模板差异、题目难度和教师能力都归并成同一个“分布差距”数值。
3. EOPD:在高熵位置补充覆盖
3.1 教师的不确定性决定额外项何时开启
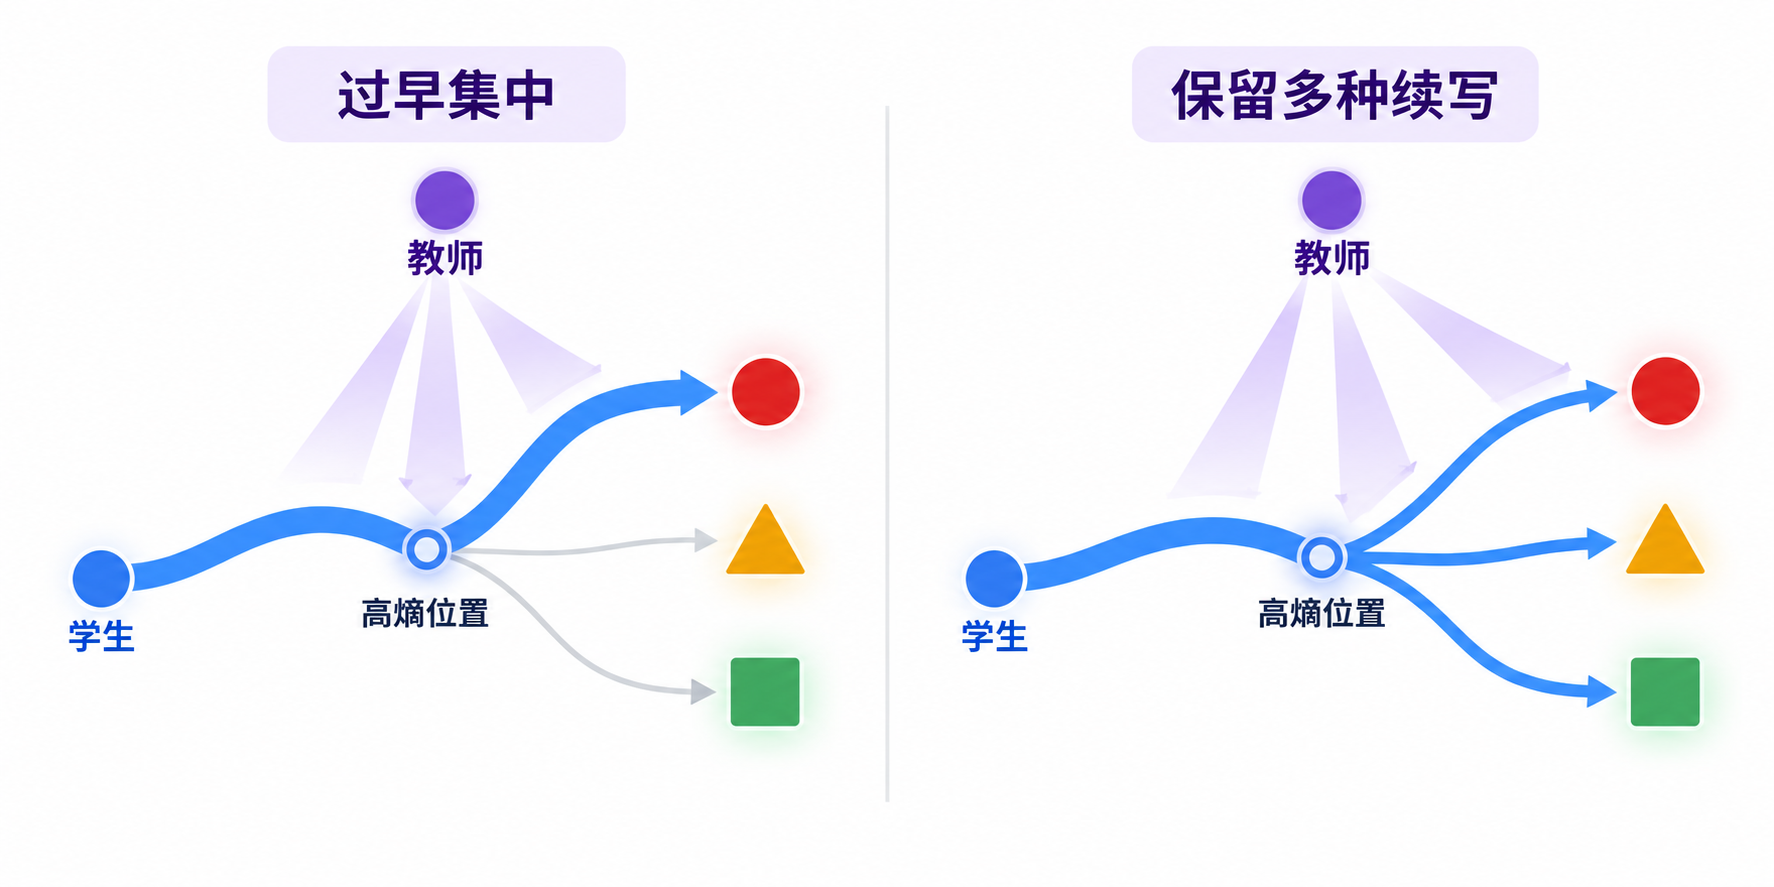
图 2|分支表示候选续写,不能直接解释成等价正确答案
图 2 中紫色教师对多个续写仍保留概率,左侧学生却把大部分质量压到一条路。EOPD 的设计是在这类教师高熵位置额外加入前向 KL,鼓励学生覆盖教师的分布结构;教师很确定的位置,则保留基础 OPD 更新。
令 为学生在第 个输出位置的 prompt 与历史, 为教师分布、 为学生分布, 遍历词表 。教师熵与门控目标写成:
衡量教师在该位置的概率分散程度; 为自然对数,熵以 nat 计。 条件成立为 1,否则为 0; 为阈值, 控制额外前向 KL 的强度。第一项保留论文定义的 clipped reverse-KL OPD 基础项,本篇不将其替换成未裁剪 KL 后声称完整复现。论文实验取 。这是相加的目标, 不是与另一系数相加必须等于 1 的混合比例。 来源:EOPD §4、Eq. (9)。
3.2 两个三 token 分布的手算
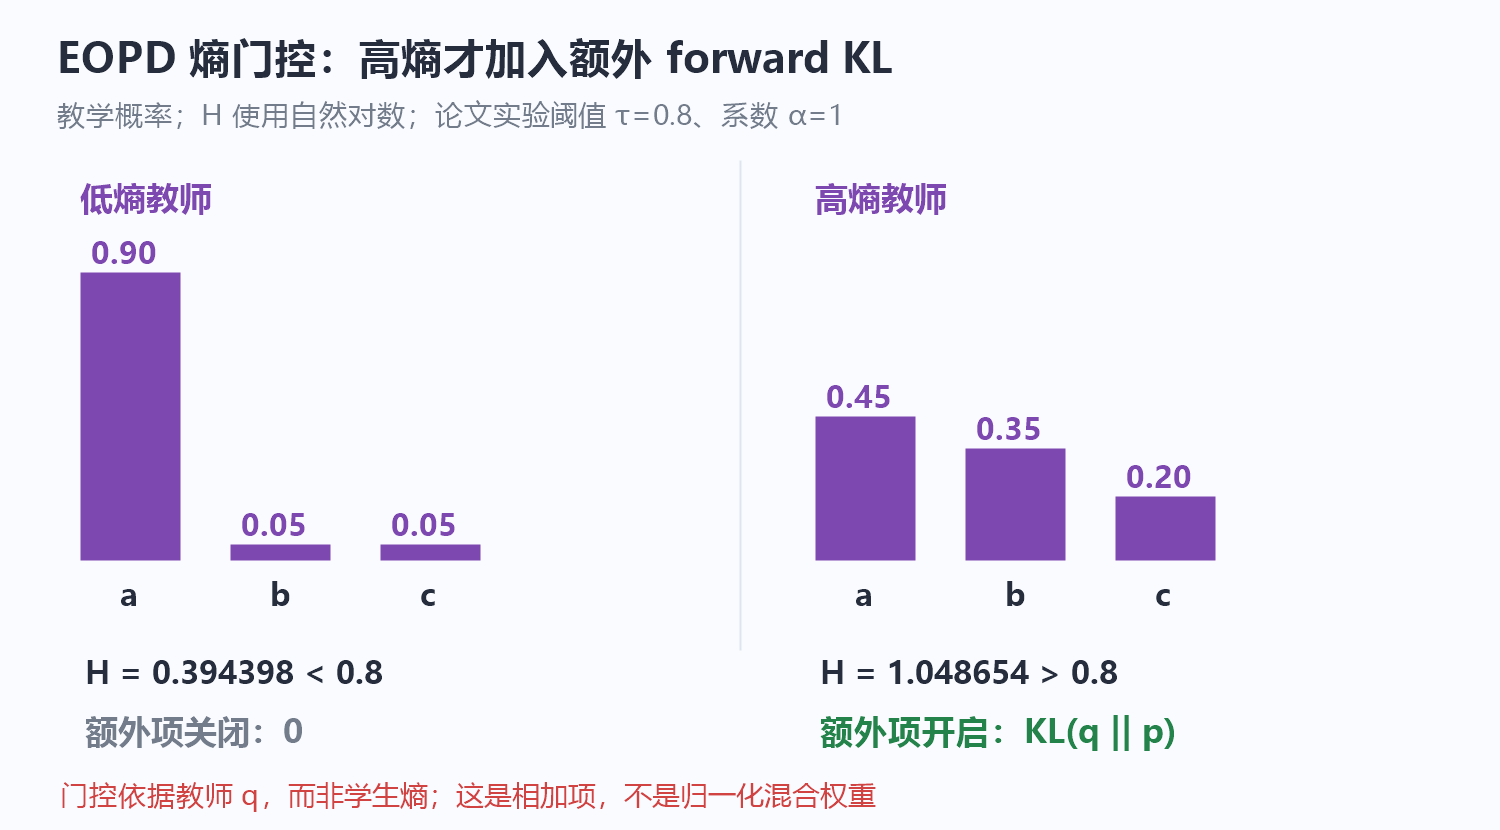
图 3|用教师熵开关额外项,阈值与对数底须一致
图 3 左侧教师为 ,右侧为 。这是教学概率,不是论文测得的某个 token。代入熵定义:
现在让学生为 。高熵教师下,额外前向 KL 为:
低熵教师的门控关闭,额外项为 0;基础 OPD 项仍在。对高熵情形,前向 KL 对学生 logits 的梯度为 。最小化时,第一项对应的 logit 下调,后两项上调,具体说明了“补充覆盖”如何作用于学生过度集中的分布。这个算例只验证额外项,不代表完整 clipped 目标的一步模型更新。
门控也不同于给所有学生输出添加熵奖励。教师很确定、学生很分散时,本式不会仅因学生熵高就开启额外项;教师很分散、学生很确定时,仍会开启。前向 KL 追随的是教师赋予各候选的不同概率,而不是把词表推向均匀分布。一个位置的熵保留下来,也不能单独保证整条回答具有有用的推理多样性,仍须检查生成结果与任务指标。
sanmuyang 的 EOPD 解读用教师高熵时 top-1 容易摆动,说明“当前排第一的是谁”不足以代表整组分布。对照图 3 右侧,教师对三个候选都保留概率,学生却集中在第一格。额外前向 KL 的梯度 不仅压低第一格,还按教师结构提高另外两格;它补的是有区别的概率,并非把词表推向均匀。
中文材料里的 mode-covering 应接到这种选择性覆盖上:门控读取教师熵,基础 clipped 目标仍在,教师很确定的位置不因这项规则普遍增加随机性。本篇沿用原论文 v3 Eq. (9) 的 系数;中文截图未单列它,不能由此推成所有实现固定同一权重。高熵候选也未必都正确,最终仍看任务表现和有用的回答多样性。
3.3 结果要保留采样口径
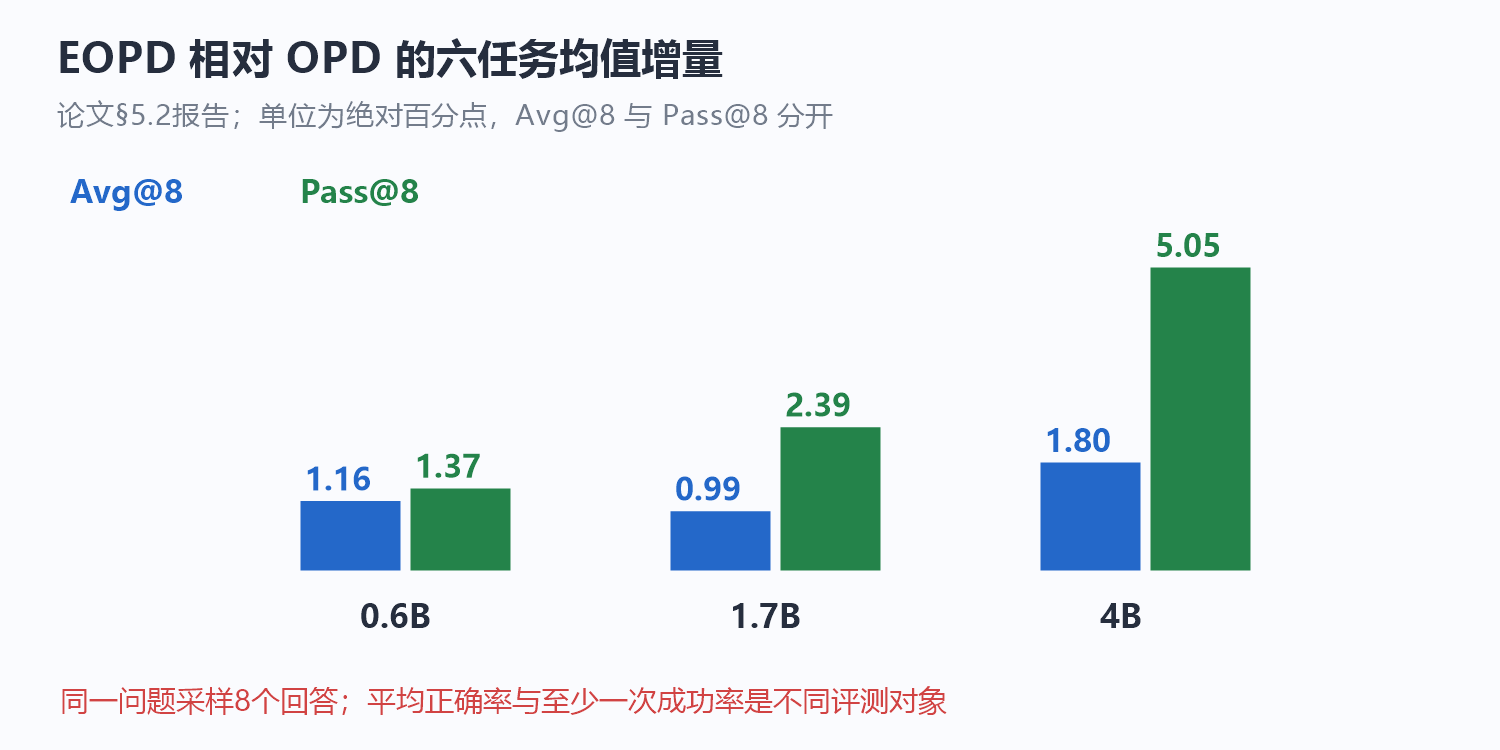
图 4|论文 §5.2 的同基线增量,六个任务内取均值
EOPD 使用 Qwen3-0.6B/1.7B/4B-Base 学生与关闭 thinking 的 Qwen3-8B 教师;前两个学生用 MATH 训练,4B 用 DAPO。评测包含 MATH500、AIME24/25、AMC23、Minerva 和 OlympiadBench,温度 1、top-p 0.8、最大回答长度 8192,每题采样 8 个回答。
图 4 的蓝条是 Avg@8 平均正确率增量,绿条是 Pass@8 成功率增量,均相对该文 OPD 基线、以绝对百分点表示。4B 的两项分别为 1.80 与 5.05;不能统一说成“准确率提高 5.05%”,也不能把与其他论文不同的采样预算和训练数据混成规模定律。来源:EOPD §5.1—5.2。
4. Revisiting:共同支持内的分布匹配
4.1 top-K 并不是一种统一目标
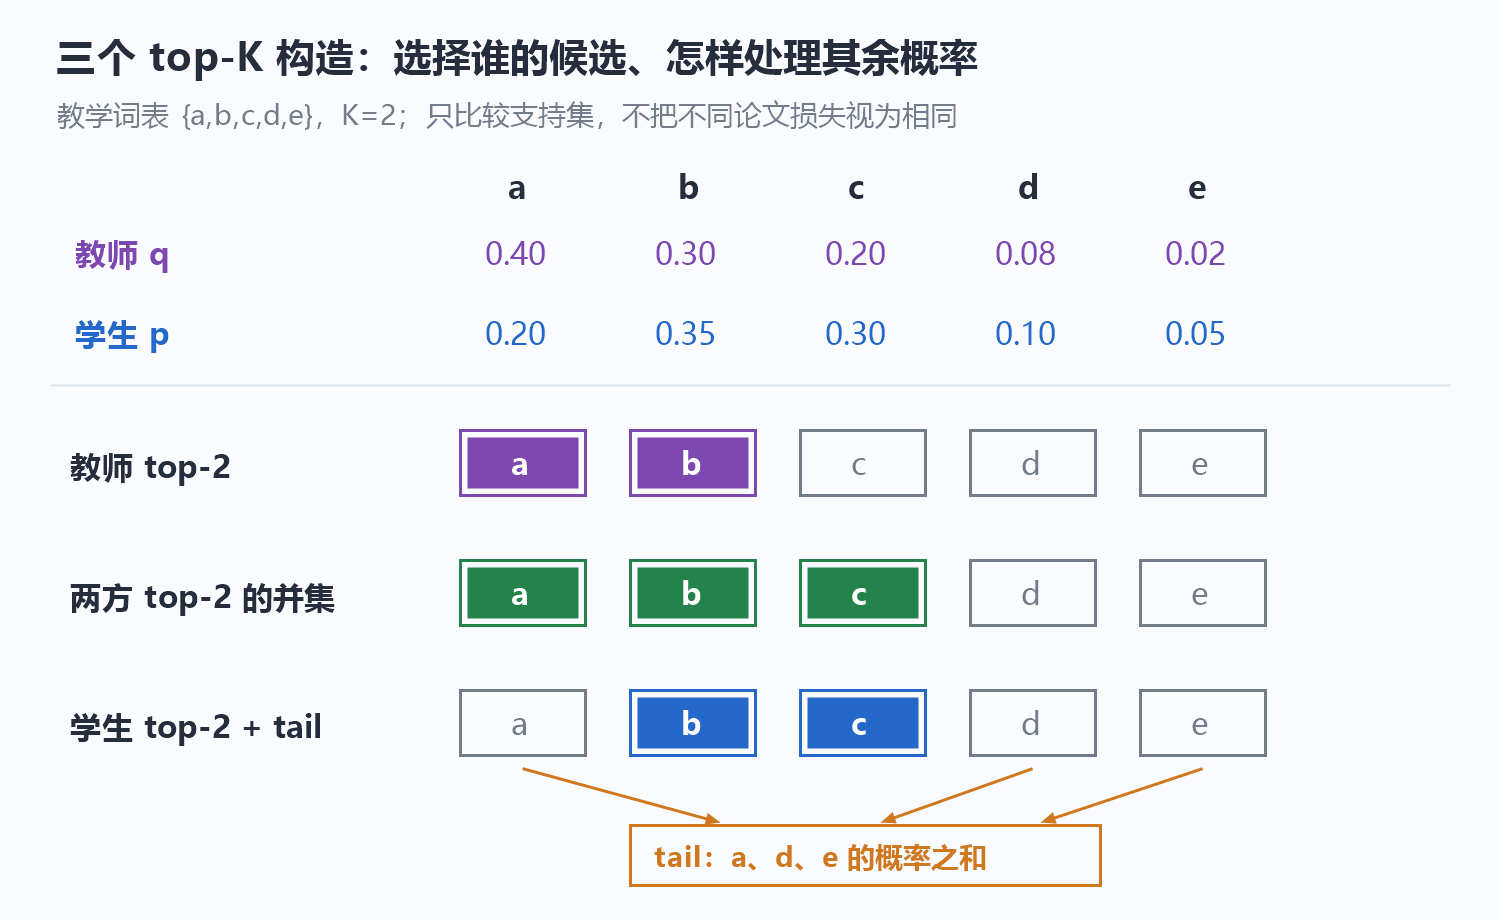
图 5|同一组教学概率,三种构造保留不同的信息
图 5 的词表是 ,。教师最高概率候选为 ,学生为 。第一行的 Revisiting 只选择教师 top-;第二行以 Ark-ASR 为例取双方 top- 的并集;第三行以 SDPO 的近似为例,单列学生 top-,其余概率聚合成 tail。第三行中的 不再分别保留,但它们的总质量没有直接丢掉。
这三行只比较支持集构造,不能看见“top-K”就把 KL 方向和归一化也视为相同。Ark-ASR 的原式使用共同并集上的教师到学生 KL;SDPO 的 top- 加 tail 服务于其反向 KL 近似。Ark-ASR §3.3,SDPO Appendix A.3。
Revisiting 在每个学生前缀上令 ,再分别用各自位于同一个 内的总质量归一化:
局部损失是 ,并对 rollout 中的 token 位置平均。 是共同比较的候选集合, 是集合内 token 索引。图 5 第一行中,教师总质量为 ,学生为 ,归一化后分别是 与 ,局部反向 KL 为 。它比较的是两方对集合内部候选的相对偏好。来源:Revisiting §3.1、Eq. (6)—(8)。
Eq. (8) 的归约还保留一个选择:对同一 prompt 采样的一组回答,先把各回答的局部 KL 按 token 求和,再除以这组回答的总 token 数。较长回答因此贡献更多位置;不能默默改成每条回答内部平均后再等权平均。支持集相同、散度方向相同,也仍可能因为这个归约单位而得到不同更新。
4.2 被归一化掉的信息必须另行观察
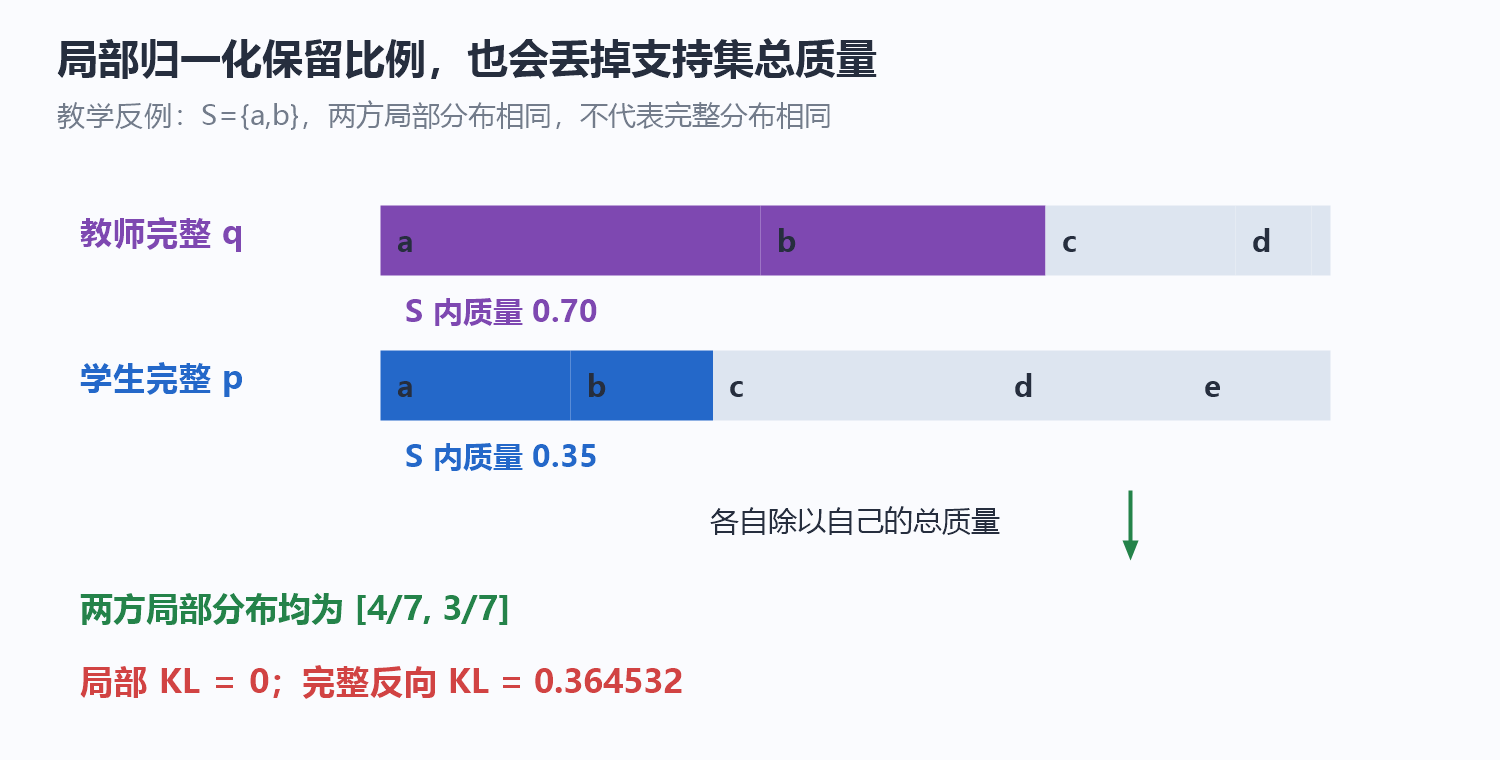
图 6|局部 KL 为零,不说明完整词表分布已经一致
图 6 换一个学生 ,教师仍为 。教师集合 内质量为 ,学生只有 ;各自归一化后,两者都是 。局部 KL 因而为零,完整词表的反向 KL 却为 。
这不是数值 bug,而是截断并重新归一化的边界。Revisiting §3.2 说明,在支持内单独 softmax,梯度不直接传播到集合之外的 token。目标用较少的候选提供分布监督,同时放弃了一部分完整分布信息。 因而,可将支持集总质量、候选重叠和外部概率变化作为额外观察量;这里的诊断建议不能写成论文已证明局部目标与完整 KL 等价。
4.3 支持集目标与工程修复分别贡献多少
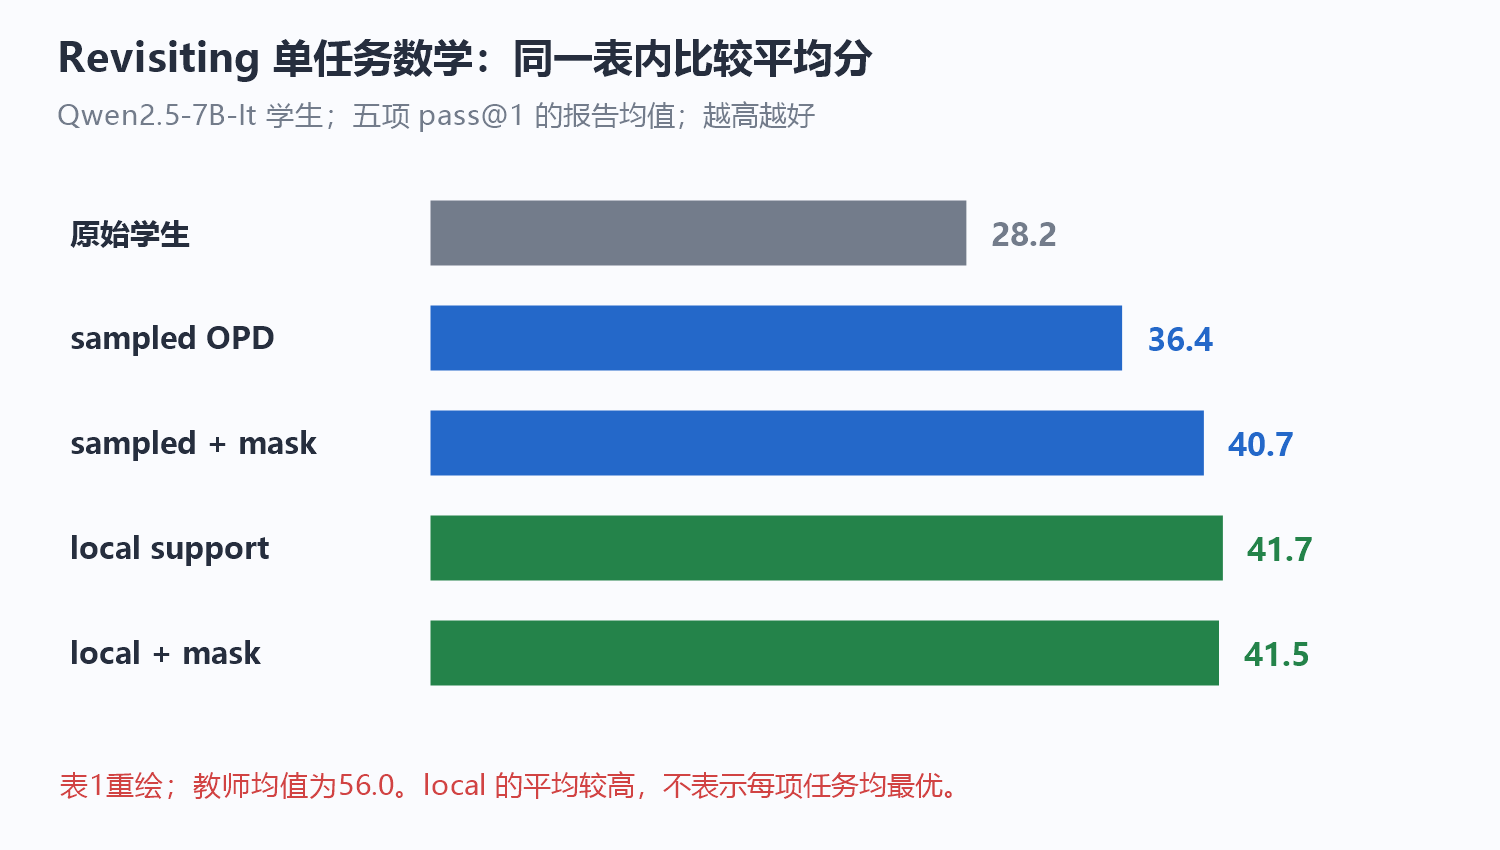
图 7|Table 1 重绘;均值优势与逐任务优势分别判断
单任务设置采用 Qwen2.5-Instruct 学生、OpenThinker3-7B 数学教师,使用 DAPO-Math-17K 英文部分,最大上下文 16K。图 7 对应 Qwen2.5-7B-It,报告 Math500、AIME24、AIME25、Minerva、OlympiadBench 的 pass@1 均值。sampled OPD 从学生的 28.2 提高到 36.4,加 special-token mask 后为 40.7;local support 两个版本为 41.7 与 41.5。
mask 对 sampled 版本帮助明显,而 local support 的两种数值接近,并未因加 mask 自动更高。平均分最高的版本也没有在每项任务上最高,例如 AIME24 中 sampled + mask 的 26.7 高于 local 两个版本的 23.3。这个表支持分布级监督与 special-token 修复并非同一件事,不能证明所有差距都来自单一机制。来源:Revisiting §3.2、§4.1—4.2、Table 1。
该文另有数学与 ALFWorld 交替训练的多任务设置,两个任务使用不同教师。那里报告的数学均值 对应约 19.8% 的相对增益;它不是本图 的提升,更不是 19.8 个百分点。单任务与多任务要分别判断,不能把一个设置的更大增益挪来解释另一个设置的柱图。
5. 从观察量到可检验的修复
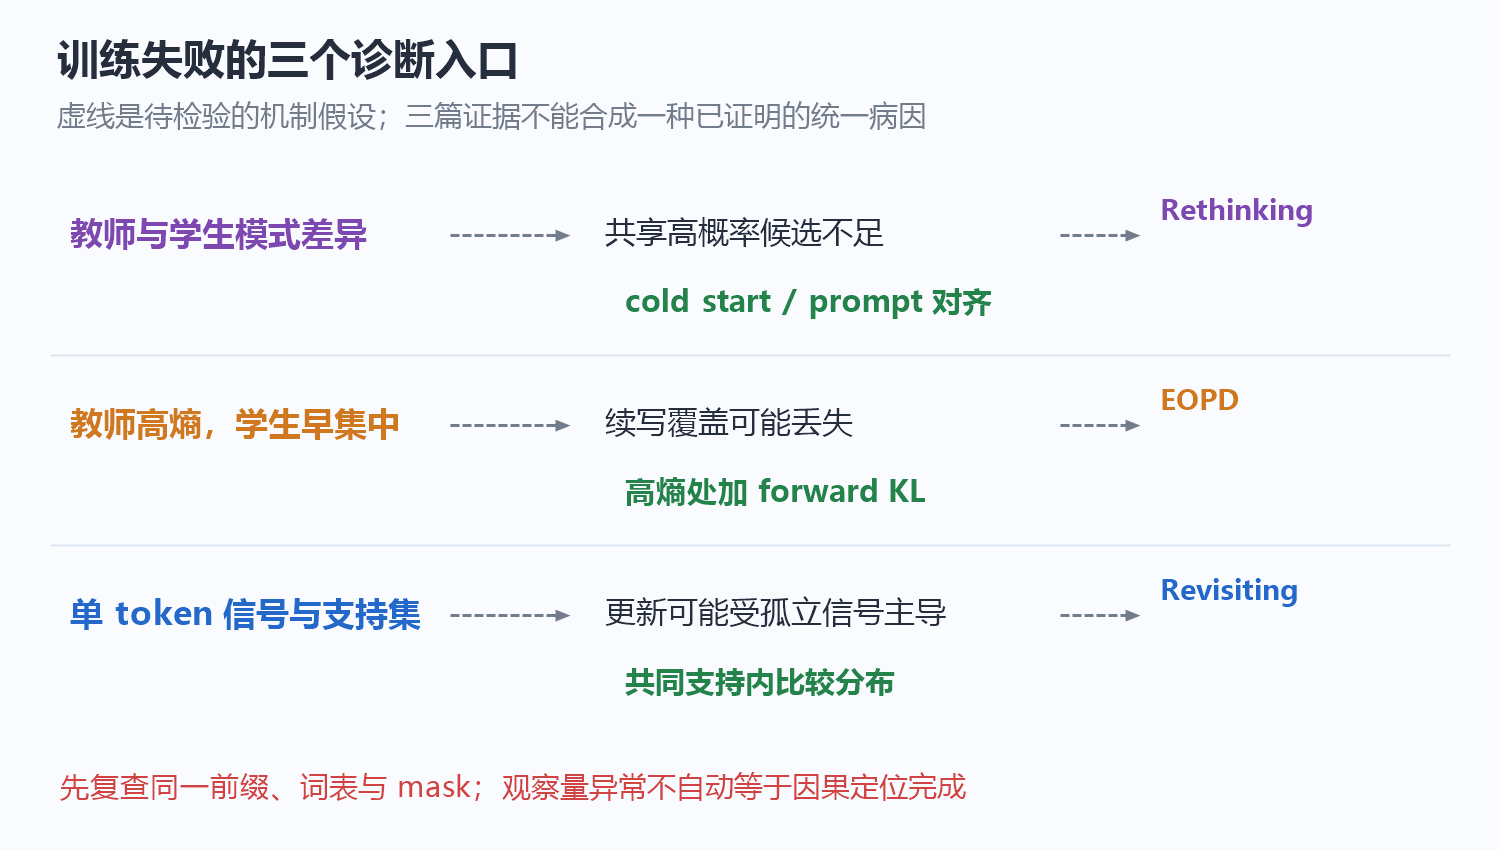
图 8|虚线表示待检验的假设链,不是统一因果证明
图 8 的三行给出不同入口。若共享候选长期不增长,可以先对照教师轨迹冷启动或 prompt 对齐;若教师保留多种续写而学生迅速集中,可以按教师熵分桶观察,再检查 EOPD 式额外覆盖;若更新对某个采样 token 或特殊标记格外敏感,可以比较共同局部支持与 mask 的独立作用。
| 读中文材料时看到的概括 | 需要实际测量的对象 | 不能直接推出什么 |
|---|---|---|
| 教师更强 | 同条件教师成绩、学生前缀上的重叠与优势 | 学生一定学得更多 |
| 高熵需要覆盖 | 教师熵分桶、目标门控和候选梯度 | 学生熵越高越好,或所有候选都正确 |
| 某种修复有效 | 固定其余条件的消融与独立任务结果 | 所有失败都来自同一原因 |
每次干预保持其余条件一致,并同时看任务表现与相应观察量。重叠变高、熵下降、局部 KL 变小,都不单独等于能力提升;一项修复有效,也不证明其他问题不存在。开始比较方法之前,仍要检查 工程篇 的同一前缀、词表坐标、回答 mask 与策略版本。数据错位时,给错误信号加熵门控或扩大候选集,并不能解决对应关系。
本文主体依据 Rethinking v2(2026-04-15) 的 §4—5、EOPD v3(2026-06-12) 的 §4—5.2,以及 Revisiting v2(2026-04-27) 的 §3—4。原图仅使用许可已核对的 Rethinking Figure 6,其余机制与结果分别为原创教学图、按报告值重绘;手算以 Python 标准库有限枚举验证。
正在连接 GitHub 评论…