07|多模态联合训练、合成数据与知识蒸馏
一张图先变成 patch 和视觉特征,教师监督则先要明确前缀、词表与概率坐标。本篇沿这两条路径追踪张量与梯度,再用两位教师的完整小例区分“教师彼此分歧”与“学生尚未学会”。公开案例与自定配置分开:不把某个开源模型的视觉编码器、KL 方向或多教师配方套给 GPT-6.1 或当前 Claude。
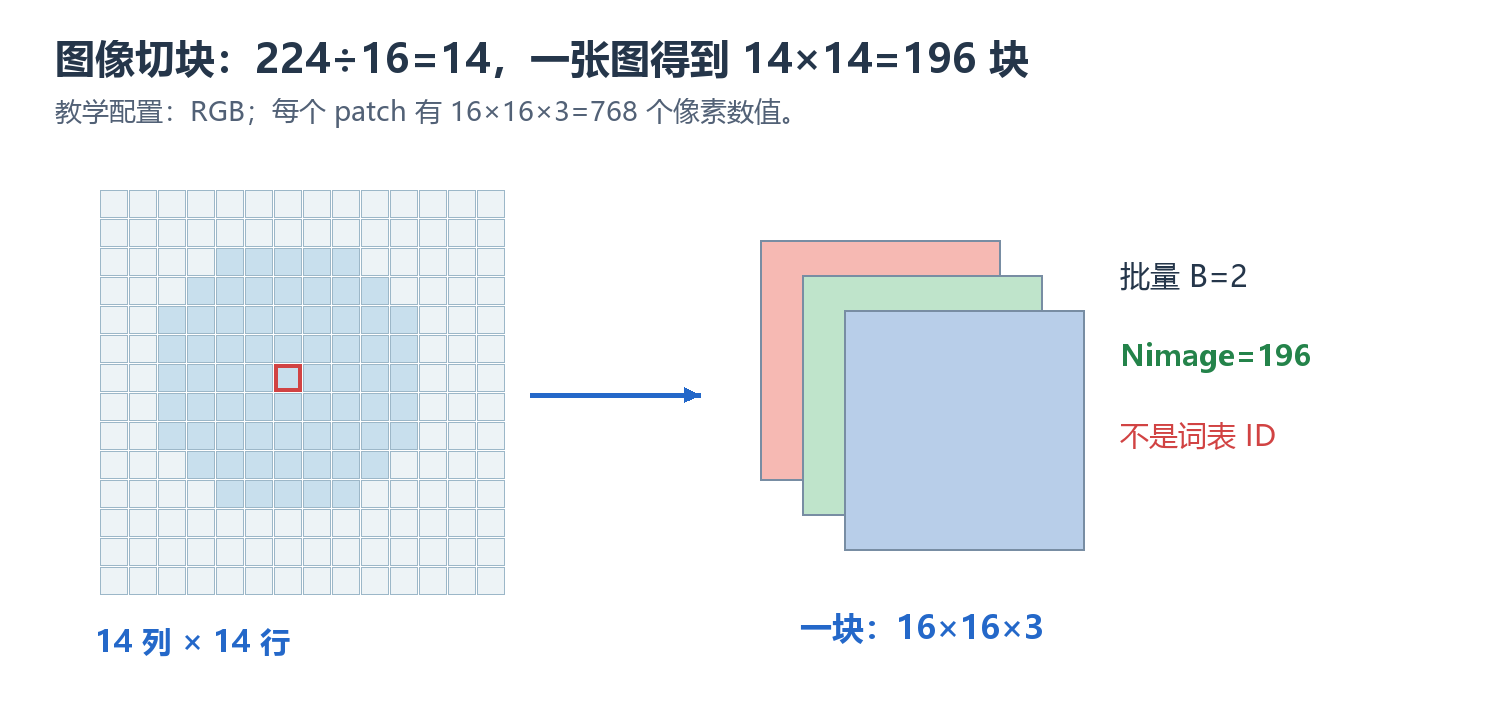
图 1a|14×14 个 patch;放大一块观察 RGB 数值体积
阅读路线。 先沿图像切块与张量接口进入多模态主干,再比较对比学习、自回归与训练阶段;合成数据说明监督怎样生产,蒸馏部分则依次回答监督内容、KL 方向、前缀来源与多教师层级。只读蒸馏可从第 4 章起。
OPD 专题深读(2026-10-23):从学生轨迹到语音 LLM 的学习路线,下设分布、目标与梯度与X-OPD 语音能力对齐。基础承接本篇第 4—5 章,继续阅读原始算法、停止采样梯度的运行算例、双优势与实验条件。
本篇目录
1. 图像与文本如何形成可汇合的表示
文本 tokenizer 把字符串切成整数 ID,随后 embedding 表把 ID 映射为向量。图像通常先经历缩放、切块和视觉编码。两路最终都可以表现为“序列长度乘隐藏宽度”的张量,但生成这些张量的过程不同;视觉 token 也未必是可查词表的离散符号。
1.1 切块、像素数与视觉特征
以教学配置为例:一批两张 RGB 图片,每张 像素,patch 边长为 。按无重叠网格切分,得到 个 patch。每块有 个像素数值;线性映射和视觉 Transformer 将其变成有上下文的视觉特征。ViT 的原始工作确立了将图像 patch 序列交给 Transformer 的路线。来源:ViT。
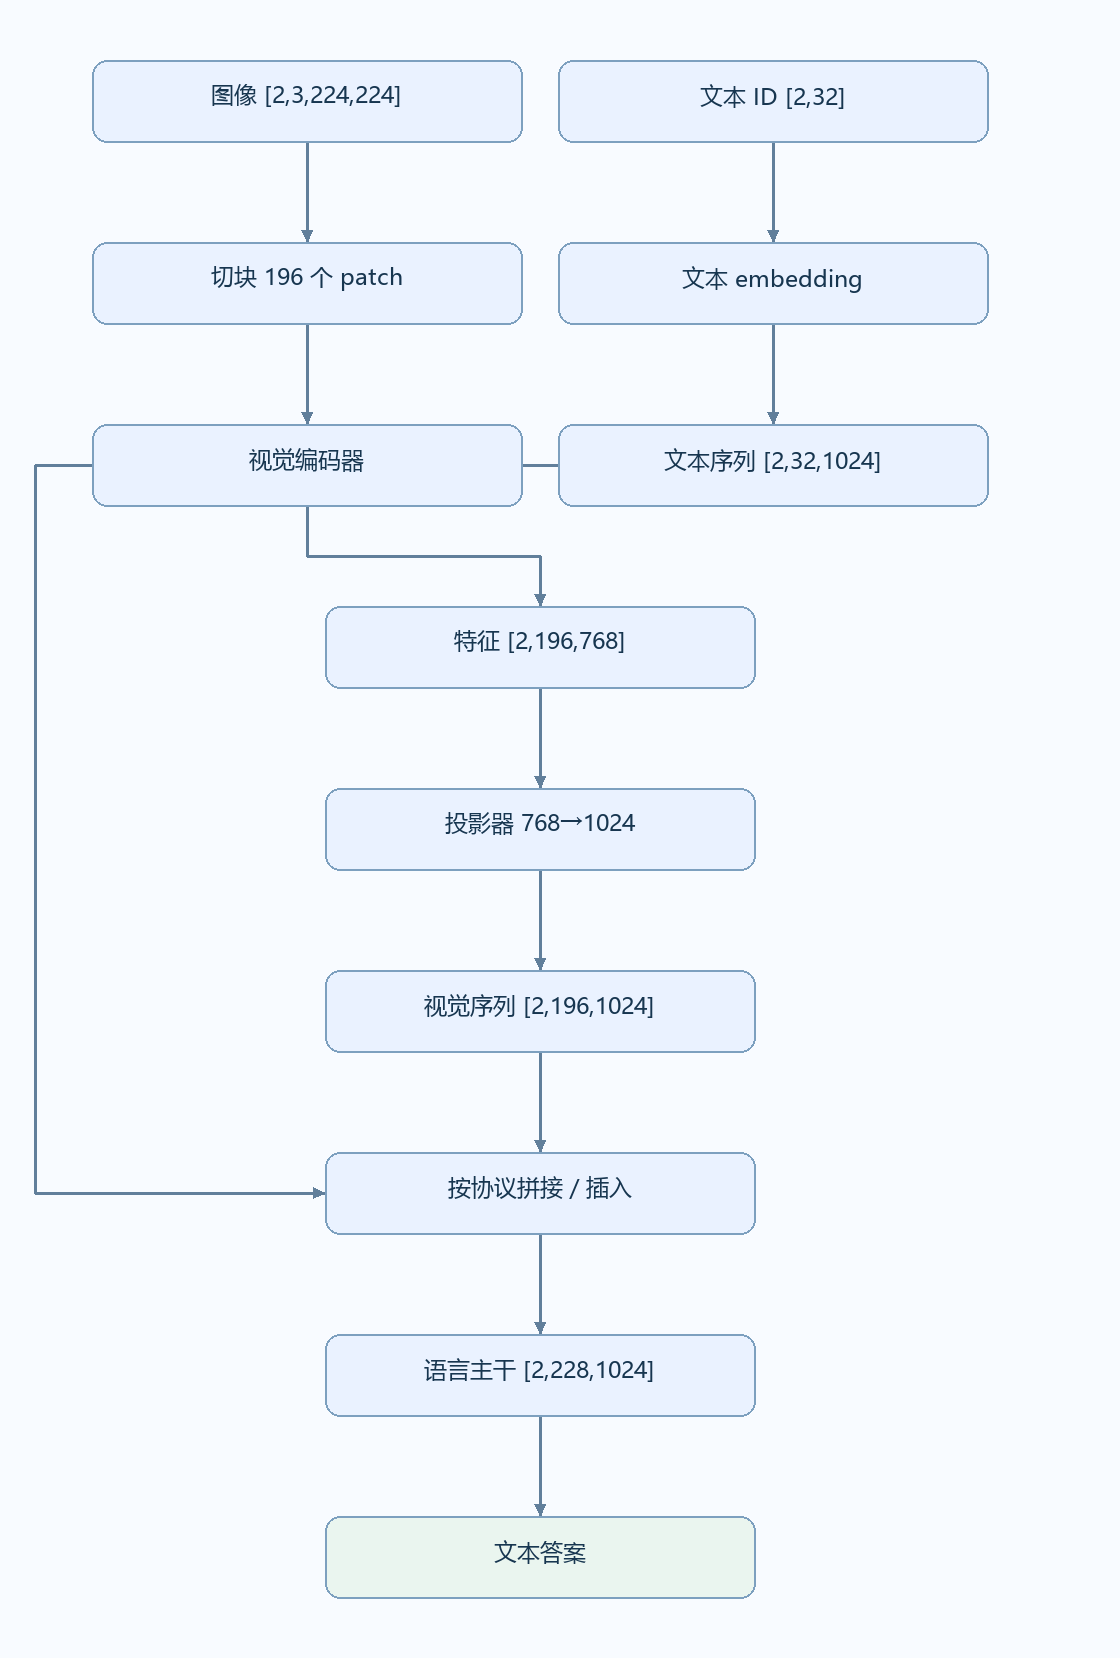
图 1|教学配置中的视觉与文本张量汇合
图从左向右读。视觉编码器负责提取形状、文字和关系;projector(投影器)负责把视觉特征映射到语言主干能够接收的宽度。 宽度相同只解决接口问题,训练还必须让主干学会利用这些特征。
这里忽略 CLS、图像起止标记和高分辨率分块,因此 。真实系统还可能用 resampler 压缩视觉序列,或让文本通过 cross-attention 读取独立的视觉状态,不能都画成同一条简单拼接路径。LLaVA 给出了连接视觉编码器与语言模型的公开实例;其官方 projector 实现包含线性层和多层 MLP 等选项。来源:LLaVA,官方 projector 代码。
1.2 宽度对齐、序列汇合与监督范围
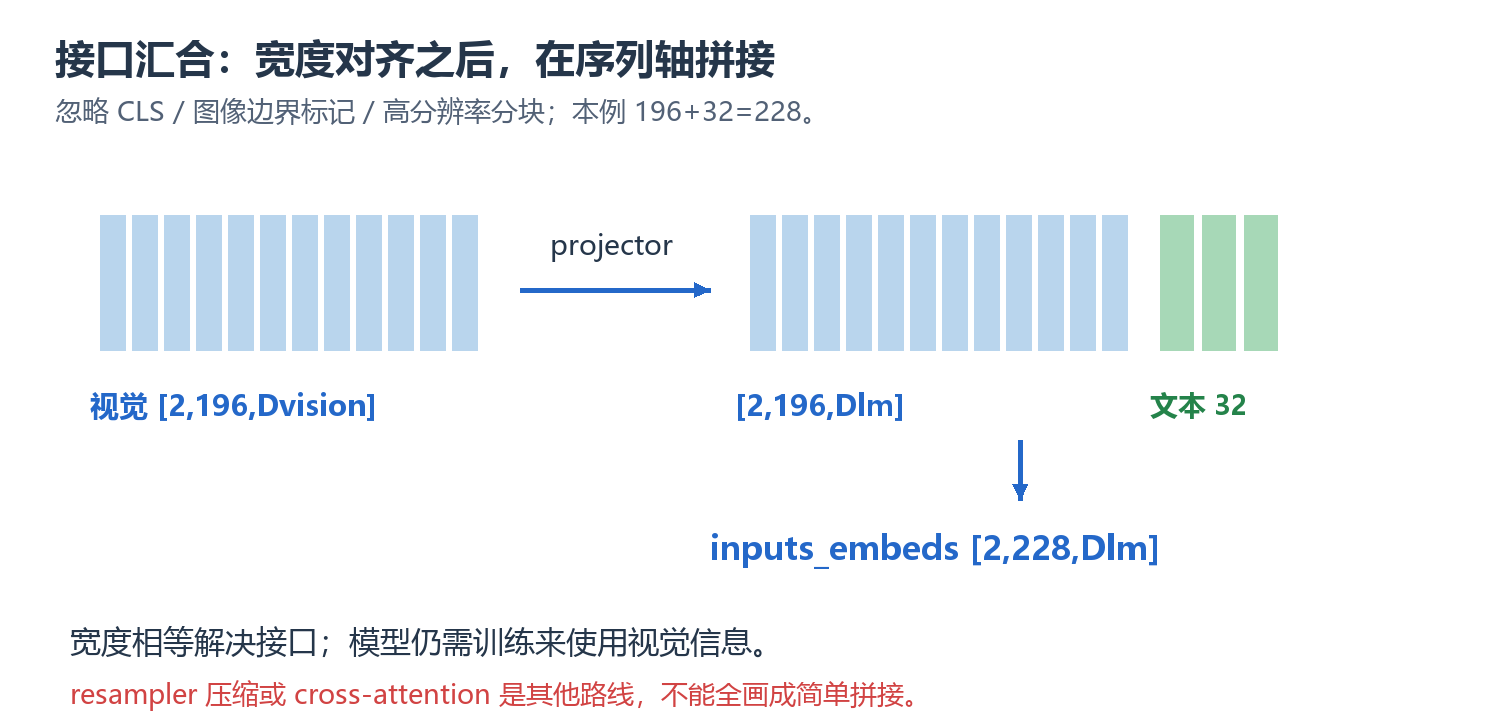
图 1b|projector 对齐宽度,拼接后序列长度由 196+32 得到
代码阅读地图是 image → vision_encoder → projector → inputs_embeds;文本走 input_ids → embedding → inputs_embeds。两路在序列轴上汇合,损失一般只覆盖指定的输出位置。下面只展示接口,属于教学片段,本篇未实测,不包含可用视觉模型、位置编码与真实图文协议。
# vision_features: [B, N_image, D_vision]
# text_ids:        [B, N_text]
visual = projector(vision_features)   # [B, N_image, D_lm]
text = token_embedding(text_ids)      # [B, N_text, D_lm]
inputs = torch.cat([visual, text], dim=1)
logits = language_model(inputs_embeds=inputs).logits
# logits: [B, N_image + N_text, vocabulary_size]
当回答“图中有几只猫”时,生成目标仍是答案文本;输入图片位置不需要对应一个待预测的普通单词。训练标签与 attention mask 应分别设计:前者决定哪里计算损失,后者决定哪里可以读取信息。把所有视觉位置标成答案目标,或把答案泄漏进可见输入,都会改变任务。
2. 多模态目标与训练阶段
2.1 对比目标与自回归目标
在图文候选之间匹配
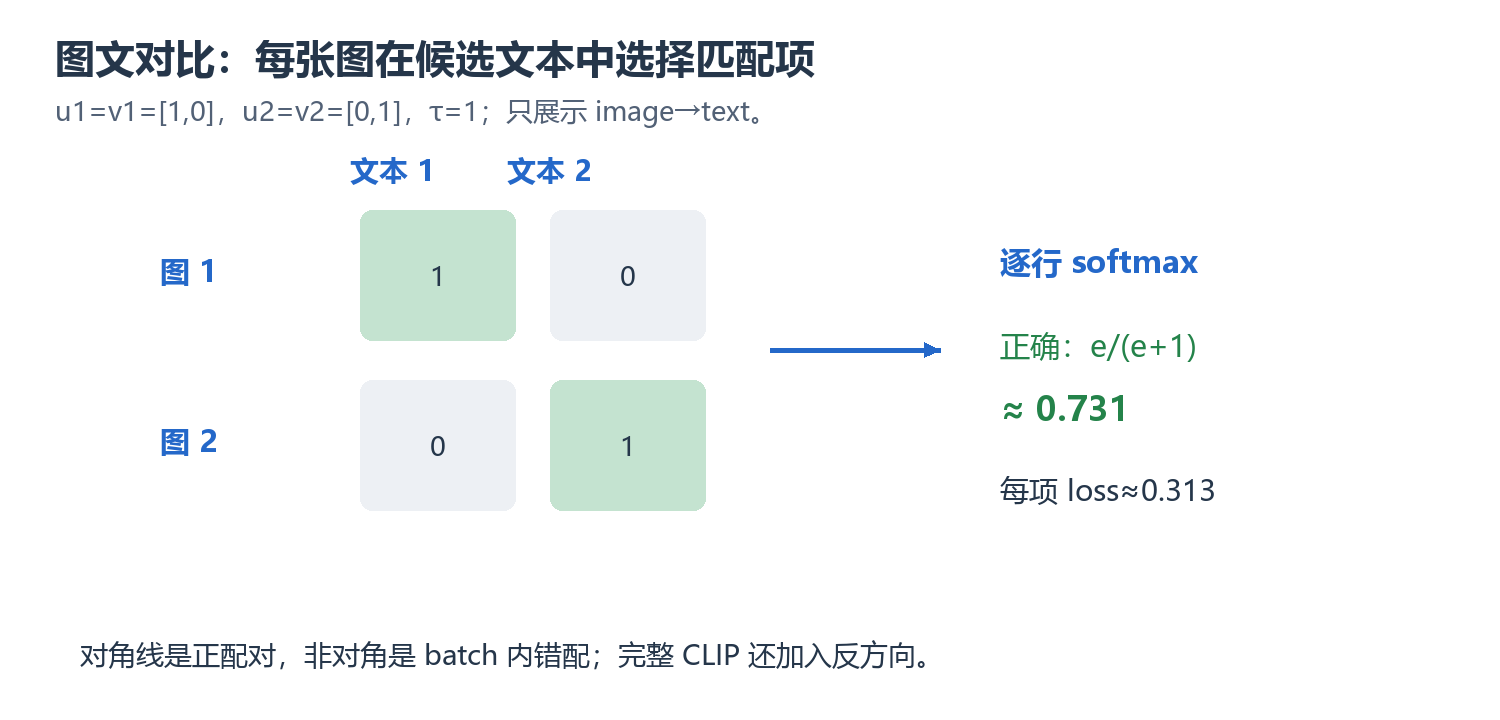
图 2a|配对在对角线;按行 softmax 选择正确文本
图文对比学习学习“哪些图和文字相匹配”。给一个 batch 中的图像与描述,分别编码为向量,匹配对的相似度应高于错配对。CLIP 使用图像编码器和文本编码器训练这种关系;它不是逐词生成答案的训练目标。来源:CLIP。
以下只写图像到文本方向,完整的对称目标还可加入文本到图像方向:
图文对比目标:符号、形状与假设
| 符号 | 含义与教学取值 |
|---|---|
| batch 中图文配对数,本例为 。 | |
| 图像和文本在 batch 内的整数索引,范围 。 | |
| 归一化后的图像、文本向量,均为 ;本例 。 | |
| 转置; 是无量纲点积。 | |
| 相似度温度,正标量,本例为 。 | |
| 第 张图与第 条描述的分数;整体矩阵形状为 。 | |
| 自然指数与自然对数,损失单位为 nat。 | |
| 在同图像的所有候选文本上归一化; 对所有图像求平均。 | |
| 图像选择匹配文本的平均负对数概率。 |
手算取 、。分数矩阵对角线为 、其他位置为 。每张图选对描述的概率为 ,每项损失为 ,平均仍为 。降低温度会放大分数差,但温度、负样本和数据质量共同影响学习,不能只追求更尖锐的分布。
SigLIP 使用逐图文对的 sigmoid 目标,避免 softmax 在全体候选上的归一化依赖。这说明“图文对齐”描述的是学习关系,具体损失可以不同。 来源:SigLIP。
在答案位置预测下一个 token
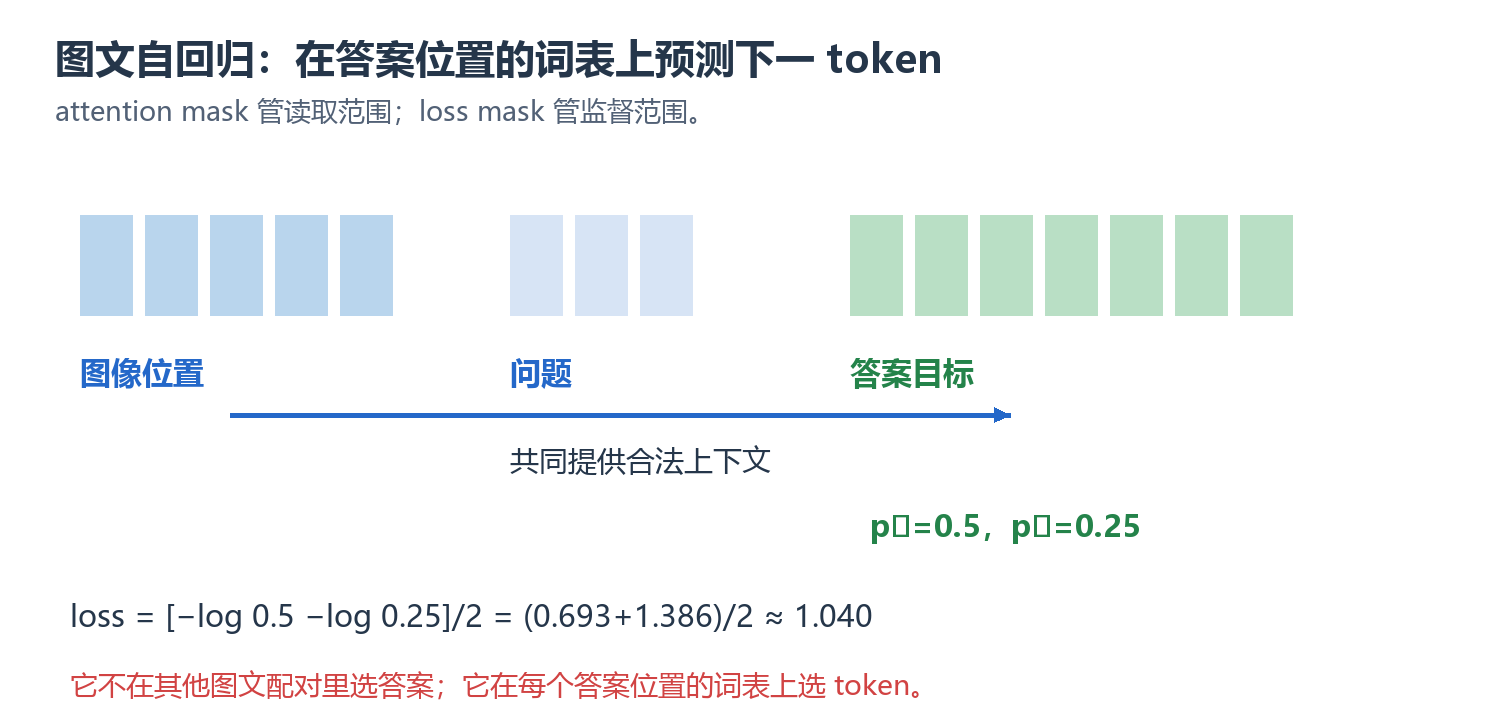
图 2b|图像与问题提供上下文,损失只统计指定答案目标
图文自回归任务则学习“看着图片和已有文本,下一段答案应该是什么”:
图文自回归目标:符号与损失位置
| 符号 | 含义 |
|---|---|
| 图片与用户问题;图片可以经视觉模块转换为特征。 | |
| 答案第 个目标 token 与它之前的答案 token。 | |
| 答案序列长度及位置索引;。 | |
| 本阶段允许更新的参数集合。 | |
| 在给定图片、问题和答案前缀后,目标 token 的条件概率。 | |
| 损失 mask,取 或 ;padding 等位置取 。 | |
| 有效目标 token 数,要求大于 。 | |
| 有效目标上的平均负对数概率,单位为 nat。 |
若两个目标 token 的概率分别为 、,且 mask 均为 ,损失是 。它没有在 batch 的其他图片描述之间选择配对,而是在每个答案位置的词表上选择下一 token。
2.2 数据进入哪个阶段,梯度更新哪些模块
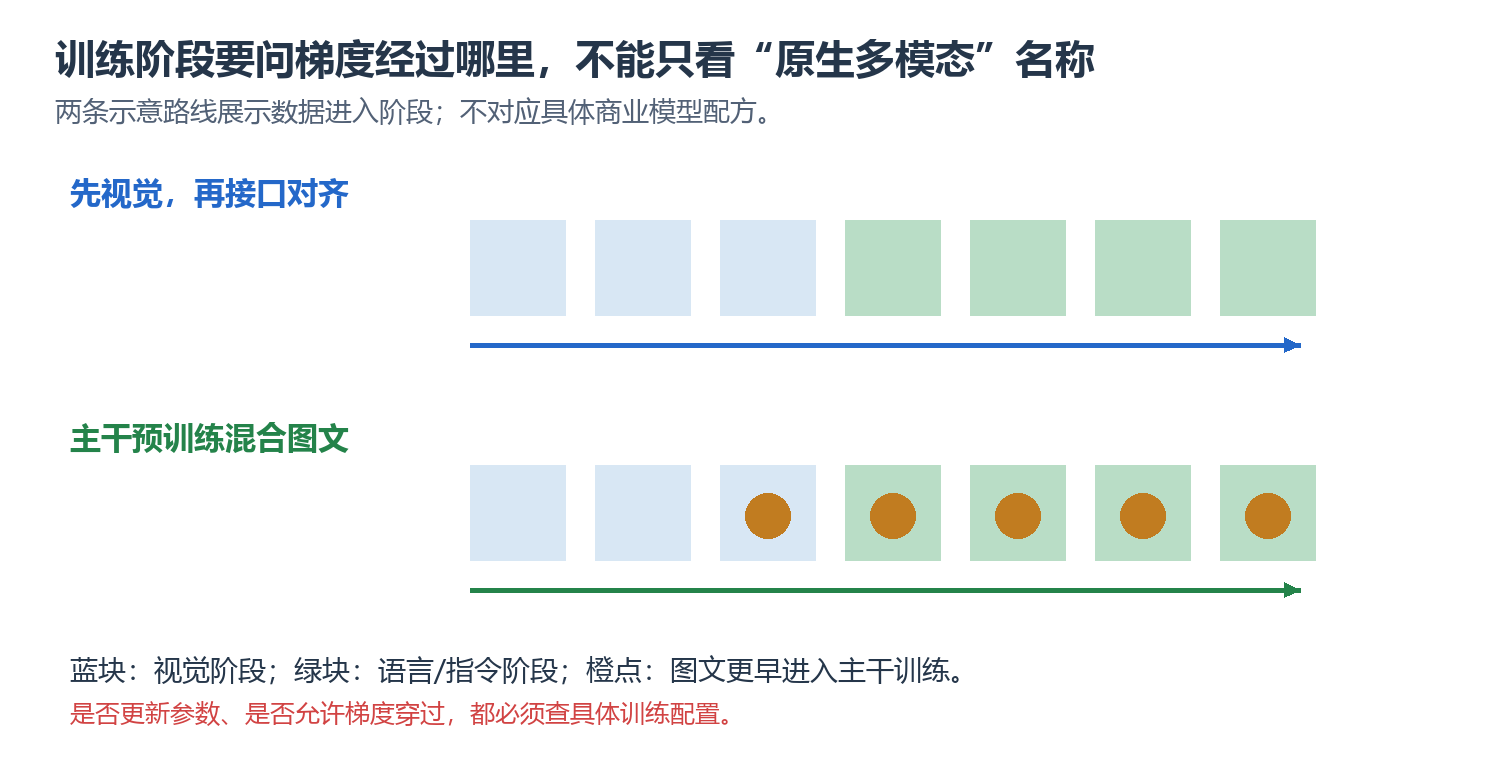
图 2c|比较数据进入阶段时,同时核对各模块的冻结与更新
一种常见路线先训练视觉编码器,再用图文任务对齐 projector,最后对语言主干或更多模块做指令训练。另一条路线在语言主干的大规模预训练中就混入图文序列,使跨模态关系从较早阶段参与学习。“原生多模态”不自动意味着所有子模块从随机权重一起训练,也不意味着没有视觉编码器或 projector。 应具体问哪些数据从哪个阶段进入,哪些权重被冻结,梯度经过哪里。
公开的 DeepSeek-V4.1-Flash 是后一条路线的例子:报告披露视觉编码器和 MLP projector,语言主干预训练使用图文与文本混合数据;视觉编码器此前还经历独立训练。报告的参数口径为 B backbone,另有 B Engram 条件记忆参数;它接收图像和文本,输出文本。V4 系列的全部细节不能自动套给后续版本,也不能套给 GPT 或 Claude。来源:DeepSeek-V4.1 技术报告。
具体定位是报告正文 §2.1、§2.1.1 与 §4.2.2 的 Vision Encoder Training:§2.1 给出参数与输入输出口径,§2.1.1 解释视觉编码器与 MLP projector 接口,§4.2.2 说明视觉模块先独立进行对比学习与自回归训练。报告图 3 展示其 40 层、20 层 causal encoder 加 20 层 decoder 的实际结构;本篇前面的 切块与简单拼接是自设演算,不能当作该型号的完整配置。
| 数据与任务 | 可能的表示 | 常见监督对象 | 必须另行核实的边界 |
|---|---|---|---|
| 图片描述与视觉问答 | 图片特征加文本序列 | 文本答案的下一 token | 是否保留空间位置、高分辨率细节。 |
| 语音识别 | 连续声学特征 | 文字或其他对齐目标 | 是否使用 CTC、encoder-decoder 等结构。 |
| 语音生成 | 离散 codec token 或连续声学表示 | codec 概率、回归或生成目标 | 音频生成不必是普通文本词表分类。 |
| 图片生成 | 连续潜变量或离散图像 token | 去噪、流匹配或 token 预测 | 读图的语言模型未必能直接生成像素。 |
这张表是表示设计的分类地图,不是任何闭源模型的配方表。目标可以组合;损失权重、序列打包和模态比例决定不同任务贡献多少梯度。一个 batch 中“视觉 token 占比”与“图片数量占比”也不同:高分辨率图片可能贡献更多位置,直接按样本数比较会失真。
3. 合成数据的验证与课程组织
合成数据把模型变成候选样本生产者。例如让教师围绕一张图提出问题与答案,或围绕代码仓库构造任务、环境和验证器。但生成者自信不等于样本正确。一个看似完整的推理答案可能读错坐标、漏掉条件,或者只是在解释错误结论。
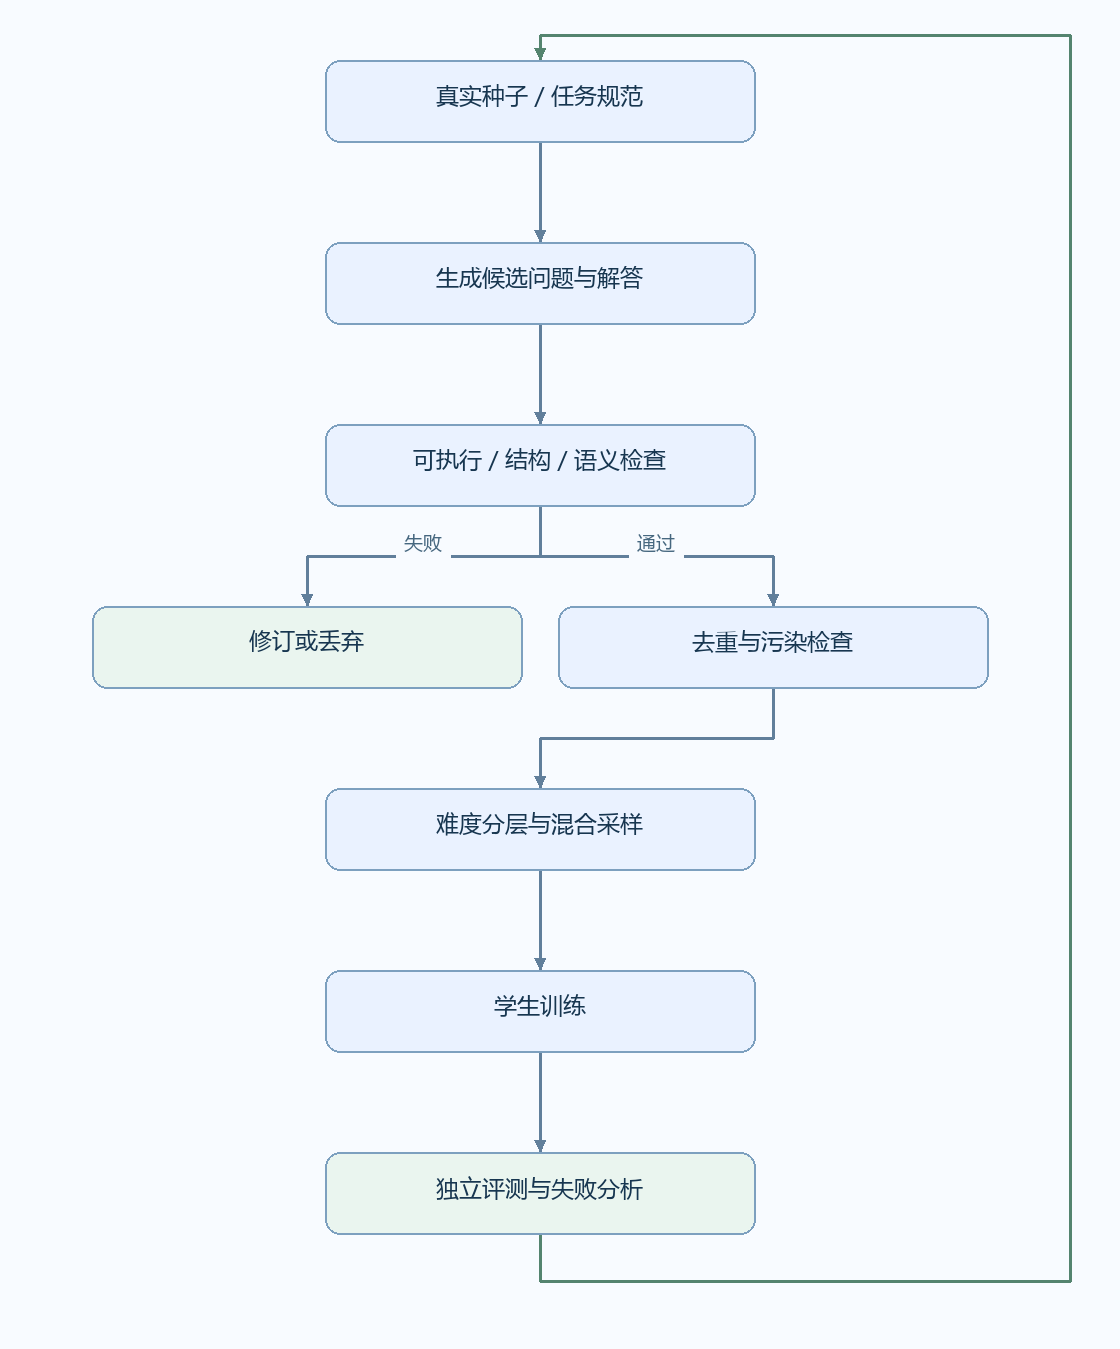
图 2|合成数据需要验证闭环
这是一条教学数据流水线。结构检查只回答 JSON 或标签是否合规;程序测试回答程序在给定测试下是否通过;语义裁判判断相关性或可读性。它们覆盖的错误不同,适合串联。对数学题,可检验终值;对图像计数题,应校验图中对象;对开放写作,则难以得到单一的完美验证器。
3.1 验证之后仍需保留难度与真实条件
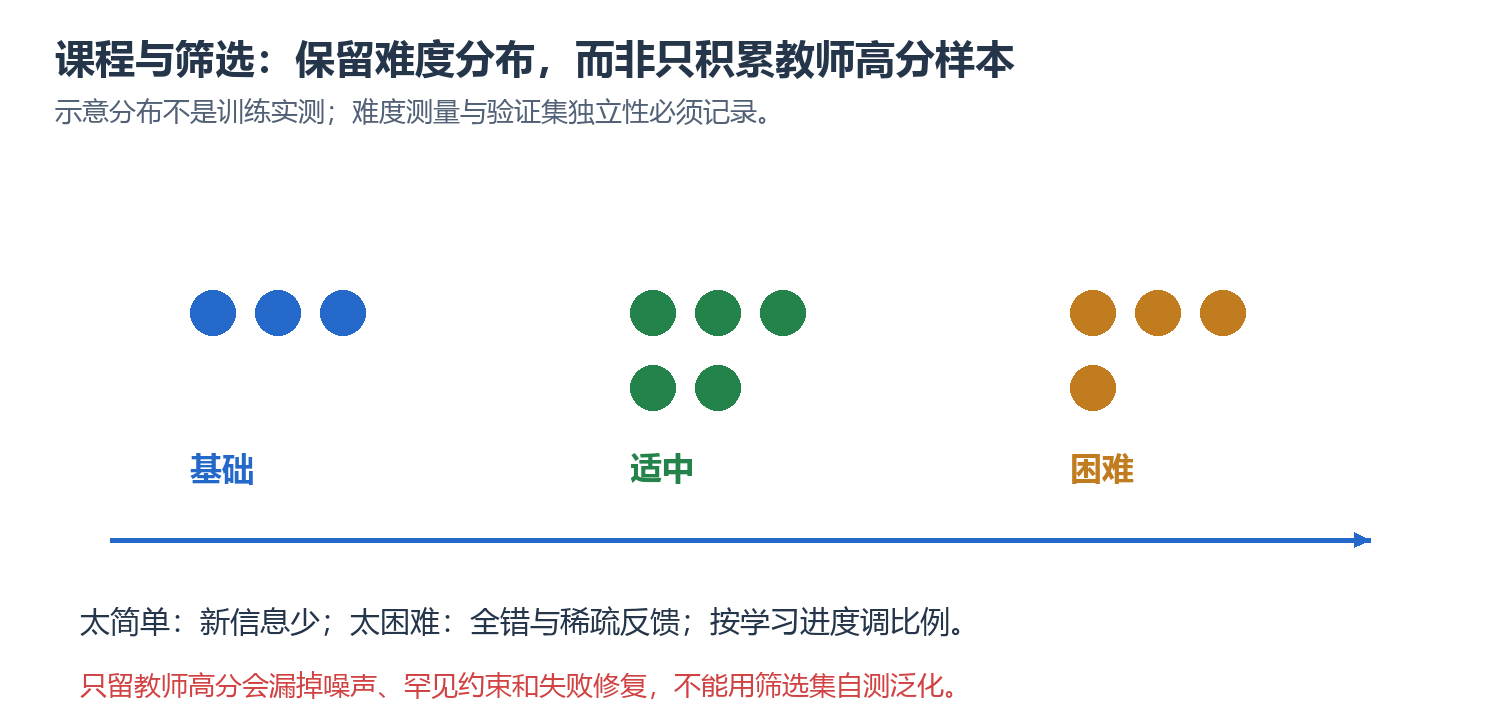
图 3a|课程保持基础、适中、困难与失败修复覆盖(示意)
课程组织也不是简单把所有容易样本先训完。可以同时保留基础、适中和困难任务,通过学习进度调整比例:太简单的样本缺少新信息,太困难的样本可能全错,产生稀疏反馈。重要的是记录难度如何测量以及验证集是否独立。只保留教师高分答案会缩窄分布,丢掉真实用户的噪声、罕见约束和失败修复场景。
LLaVA 使用生成的视觉指令数据,说明语言模型可以参与图文训练样本构造;DeepSeek-R1 则通过多次生成、筛选正确推理轨迹构建后续 SFT 数据。两种做法都包含候选到训练样本的转换,具体筛选规则并不相同。来源:LLaVA,来源:DeepSeek-R1。
4. 从教师轨迹到软目标蒸馏
4.1 离线轨迹、软分布与温度
“蒸馏”是能力迁移的总称,不能只看数据来自大模型就推断损失形式。至少分清两件事:谁生成训练前缀,以及教师提供文本还是整个概率分布。
| 路线 | 学生看到的监督 | 前缀通常来自哪里 | 信息与成本 |
|---|---|---|---|
| 离线轨迹 SFT | 教师生成并筛选的 token 序列 | 固定的教师轨迹 | 不需要全词表概率,易保存;只展示采样到的路径。 |
| token 级分布蒸馏 | 教师在每个位置的软概率 | 固定数据或教师轨迹 | 保留替代 token 的相对概率;存储与计算更昂贵。 |
| on-policy 蒸馏 | 教师在学生走到的位置给反馈 | 当前学生 rollout | 接触学生自己的偏差;需要持续生成和教师评估。 |
R1 的小模型公开案例使用筛选后的约 K 样本微调 Qwen 与 Llama,这是离线轨迹 SFT。学生没有复制教师参数,也不能由这个案例推出它训练时拿到了教师的全词表 logits。来源:DeepSeek-R1。
先对齐含义,再比较概率
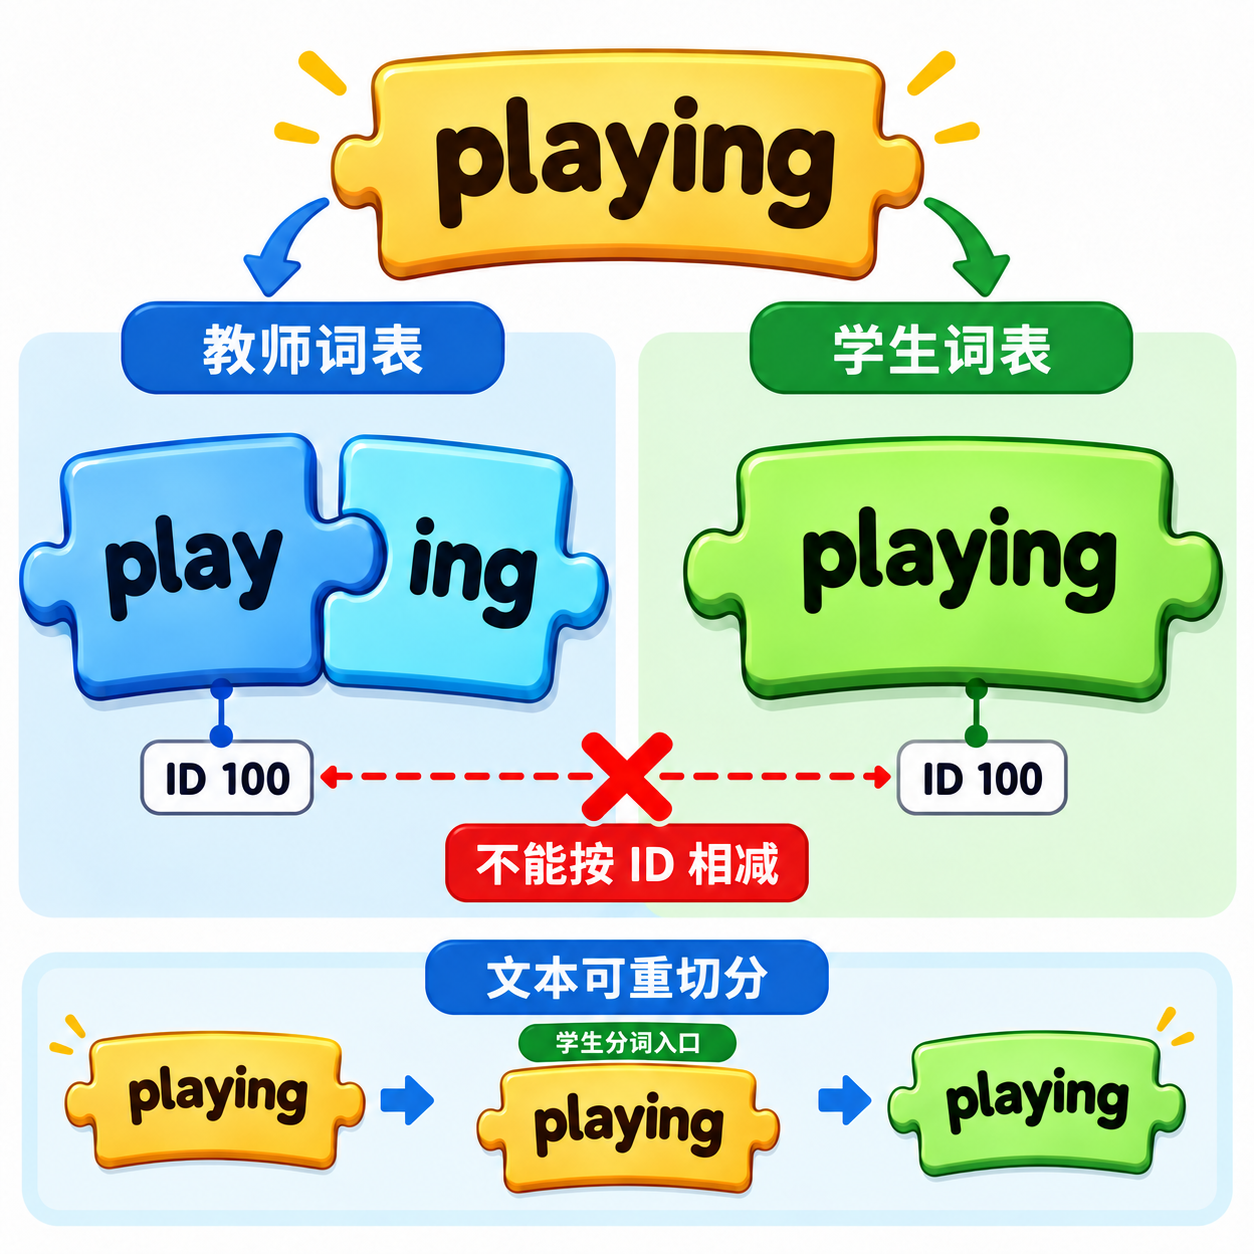
图 4-1|数字坐标相同,不等于预测的是同一个事件(ImageGen 教学词表)
先暂时把 tokenizer 缩成拼图片。教师把 playing 切成 play、ing,学生却把它保留为一项;两边恰好都有 ID 100,但左边 ID 100 是 play,右边是 playing。这些切分与编号是自造反例,不披露任何真实模型的 tokenizer。
此时两个“第 100 项概率”描述不同事件,直接相减或逐项 KL 没有前文期待的语义。形状都为 ,也不能弥补坐标含义不同;如果两边切分的长度不同,预测位置本身还可能无法一一对应。
下方文本纸带保留另一种可行监督:先取完整教师文字,再交给学生自己的 tokenizer。学生得到的是自己词表中的 playing,并没有把教师 play 的概率当成它的概率。文本轨迹能重新切分,全词表软分布则必须另有明确的语义对齐方案。 以下演算都假设同一前缀、预测同一位置,且词表项含义与顺序完全一致。
温度改变软目标的相对质量
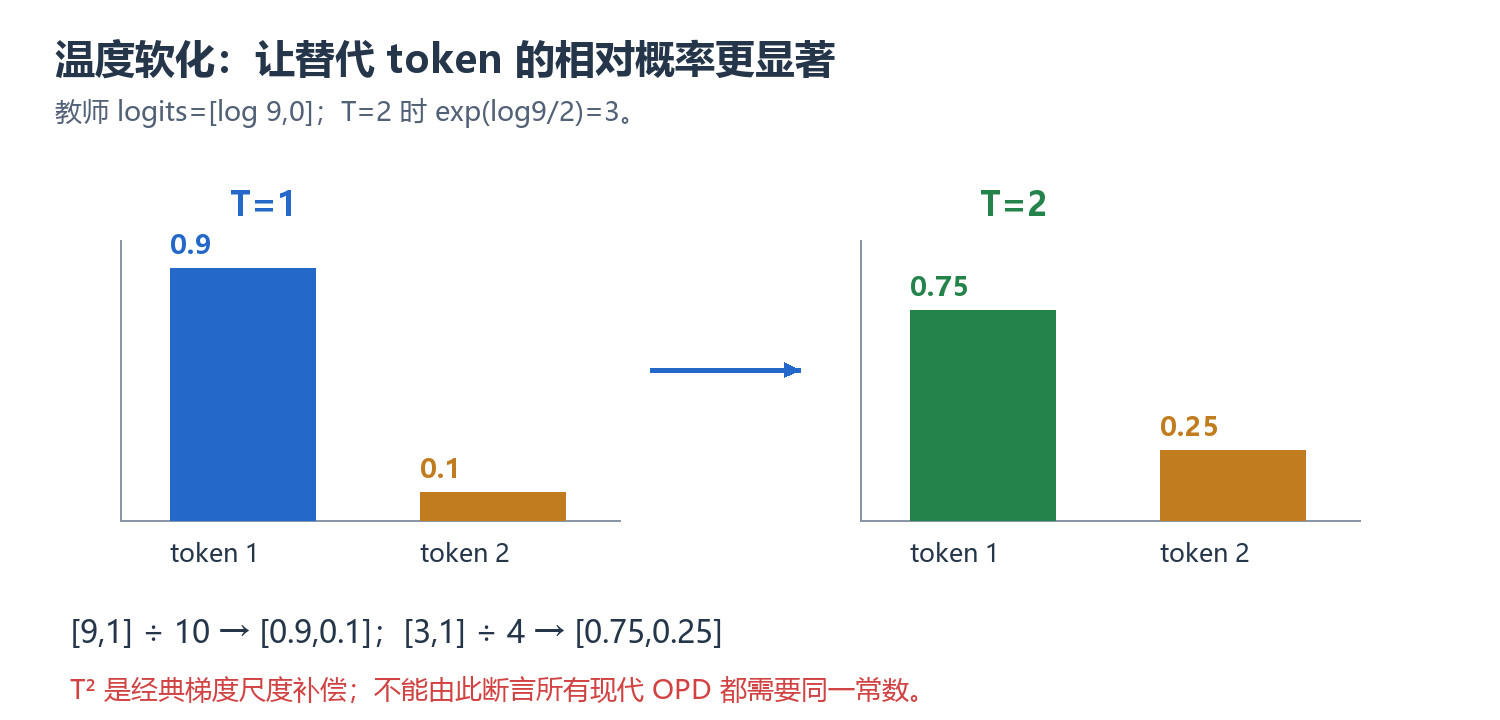
图 4a|从 9∶1 到 3∶1:温度软化概率,不增加正确性保证
对分布蒸馏,令教师和学生在同一个前缀上分别产生 logits。温度将其变成较软或较尖的分布,以下使用教师到学生的 KL:
单位置软目标蒸馏:符号与温度
| 符号 | 含义 |
|---|---|
| 词表大小与词表索引,索引范围为 。 | |
| 教师、学生对 token 的无量纲 logit;上标 表示 teacher, 表示 student。 | |
| 正的温度标量;这里恰好与 teacher 上标同字母,含义由位置区分。 | |
| 温度为 时教师、学生的概率;各自在词表上求和为 。 | |
| softmax 的归一化; 对所有候选 token 的 KL 项求和。 | |
| 单一有效位置的蒸馏损失;多位置实现还需 mask 和平均。 | |
| 经典软目标蒸馏的梯度尺度补偿,不是提高信息量的乘数。 |
手算教师两项 logits 为 。 得 ; 时指数为 ,得到 。替代 token 的概率变得更显著。温度升高也会放大教师不可靠的尾部信息,需要验证而不是越高越好。
经典蒸馏在较高温度近似下,软目标梯度规模随 缩小,所以常乘 ,保持它与硬标签交叉熵的相对贡献。这不是所有温度、所有损失都严格具有同一梯度,也不是现代每种 OPD 都必须使用的常数。来源:Distilling the Knowledge in a Neural Network。
4.2 两种 KL 的完整演算与边界
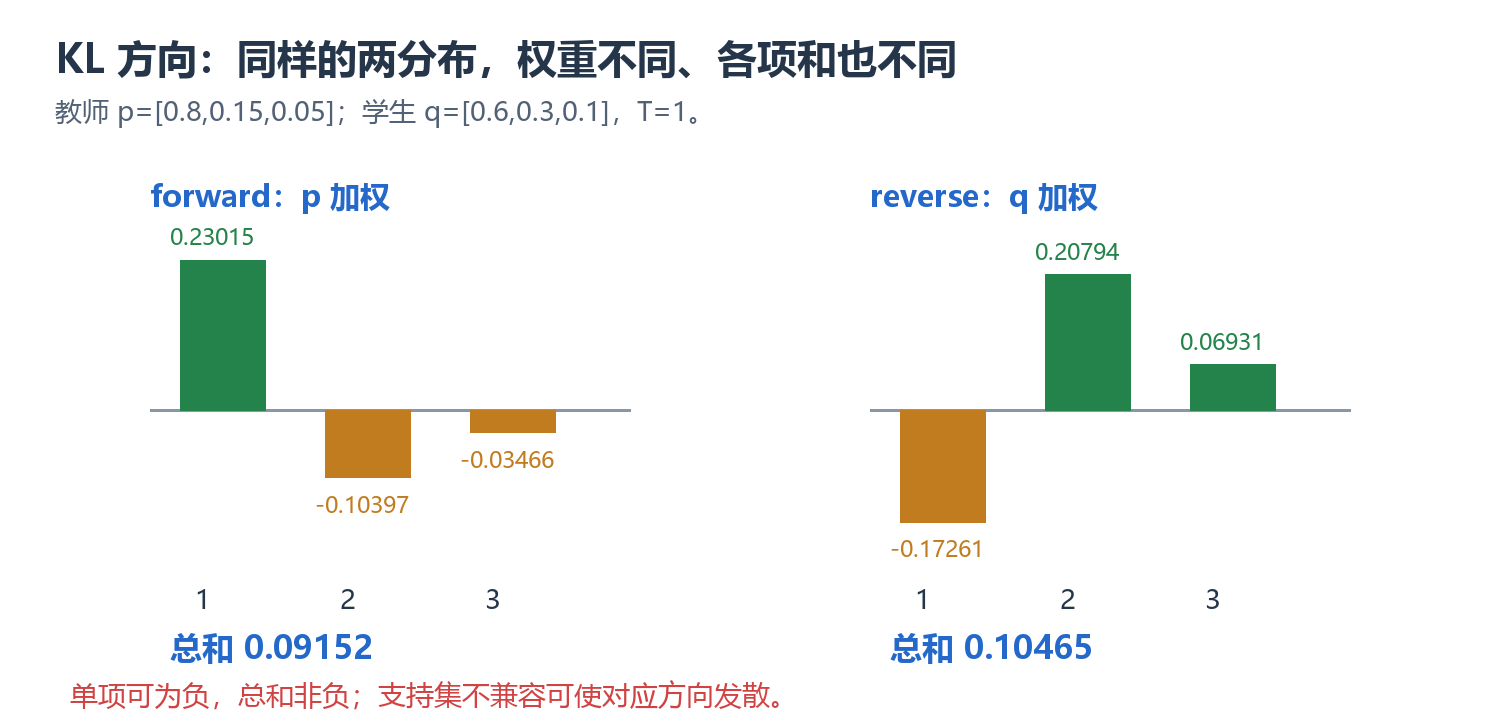
图 4b|两种 KL 按不同分布加权,单项与总和需分开读
约定教师为 、学生为 ,称 为 forward KL, 为 reverse KL。其他文章若交换分布身份,名称也可能交换,因此必须读方向。
KL 方向:符号、边界与完整演算
遍历三个候选 token; 是正概率,和均为 ; 为自然对数,KL 单位为 nat。例子取 、,温度为 。
| token | forward 项 | reverse 项 |
|---|---|---|
| 1 | ||
| 2 | ||
| 3 | ||
| 总和 |
单项可以为负,总和非负。若前一分布对某 token 有正概率,而后一分布为零,对应方向的 KL 发散;实现需处理数值下溢与支持集问题。
forward 由教师概率加权,教师重视的候选会持续推动学生覆盖;reverse 由学生概率加权,更直接惩罚学生把质量放到教师低概率的候选上。常见的“覆盖模式”和“选择模式”描述来自受限模型族中的优化直觉,并不保证 forward 一定更有创造力,或 reverse 一定更准确。 对完整可表达分布,两者最优解都可以是 ;真实差异取决于学生容量、前缀分布和评测方式。
5. 学生前缀上的反馈与多教师
5.1 学生决定访问哪些前缀
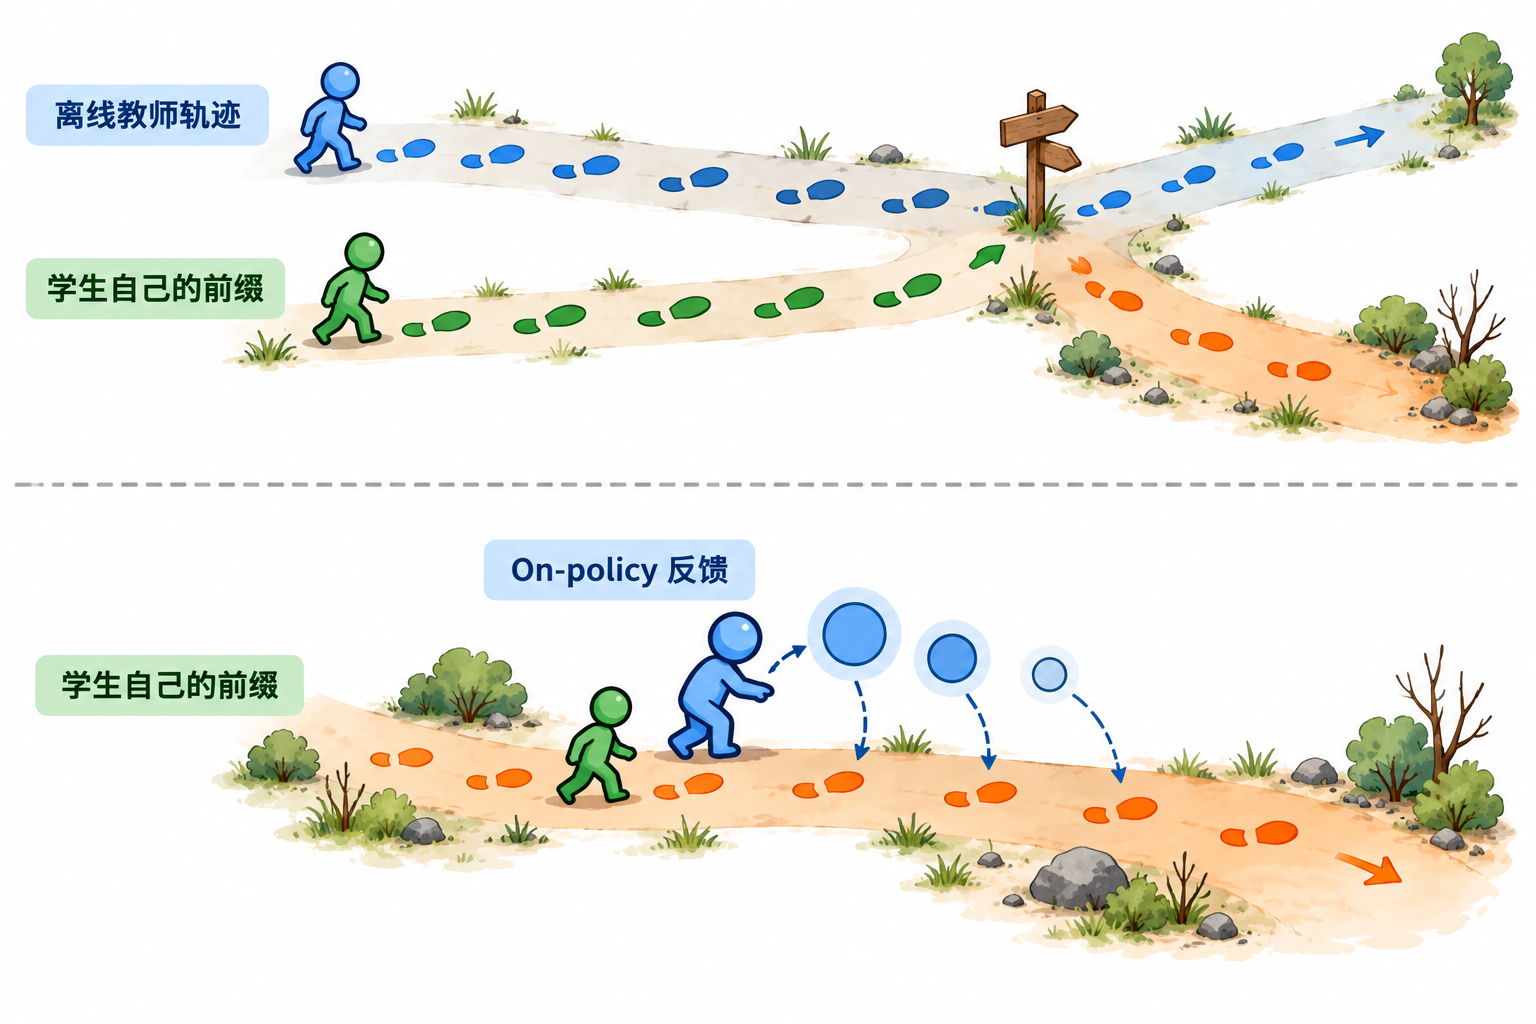
图 5a|离线足迹可能漏掉学生岔路;on-policy 在实际前缀提供反馈(ImageGen)
上半图的橙色分支缺少教师轨迹覆盖;下半图蓝色反馈来到学生已经访问的位置。道路只是前缀分布的类比,不表示教师能保证任何错误前缀都有正确结局。
固定教师轨迹会有分布差异:训练时学生总看见教师已经走对的前缀,推理时却会看见自己的误选。一旦前缀偏离,后面的监督可能没有覆盖。On-policy 蒸馏先让当前学生生成,再让教师对这些学生前缀给出下一 token 分布。教师不必把整条学生轨迹判为正确;它是在学生实际会遇到的位置提供局部指导。
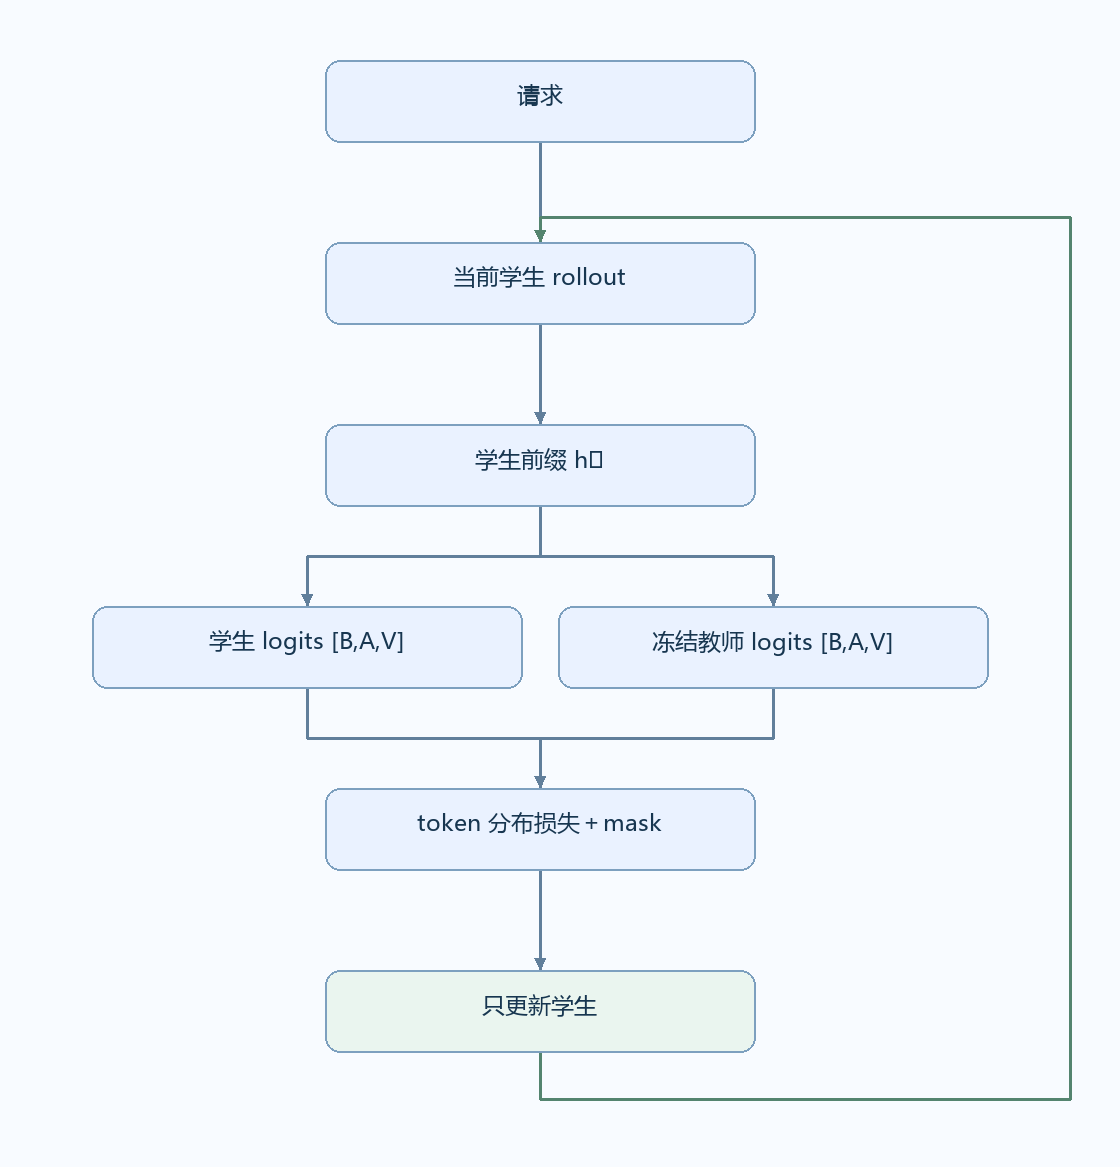
图 3|学生决定访问的前缀,教师提供软反馈
GKD 原始工作系统研究了这类学生生成序列上的监督,也比较不同散度;它不规定任何领域都必须选同一 KL。来源:On-Policy Distillation of Language Models。
代码地图为 student rollout → 同前缀重算 → teacher/student logits → mask → backward。下列教学片段未实测,只计算单 batch 的 forward KL。若 mask 没有任何有效目标,本例直接抛出 ValueError,避免对空张量求平均产生 NaN。教师输出已停止梯度;rollout 的离散 token 被当作本轮采样数据,不在这段代码里对采样过程求导。
# Both logits describe the SAME prefixes and vocabulary order.
# Shape: [B, A, V]; mask: [B, A], true for valid target positions.
if not mask.any().item():
    raise ValueError("OPD batch has no valid target positions")
log_q = torch.log_softmax(student_logits / temperature, dim=-1)
with torch.no_grad():
    log_p = torch.log_softmax(teacher_logits / temperature, dim=-1)
    p = log_p.exp()
per_token = (p * (log_p - log_q)).sum(dim=-1)  # [B, A]
loss = temperature**2 * per_token[mask].mean()
loss.backward()  # teacher stays frozen
5.2 词表、预测位置与停止梯度
补充:原词表坐标关系图
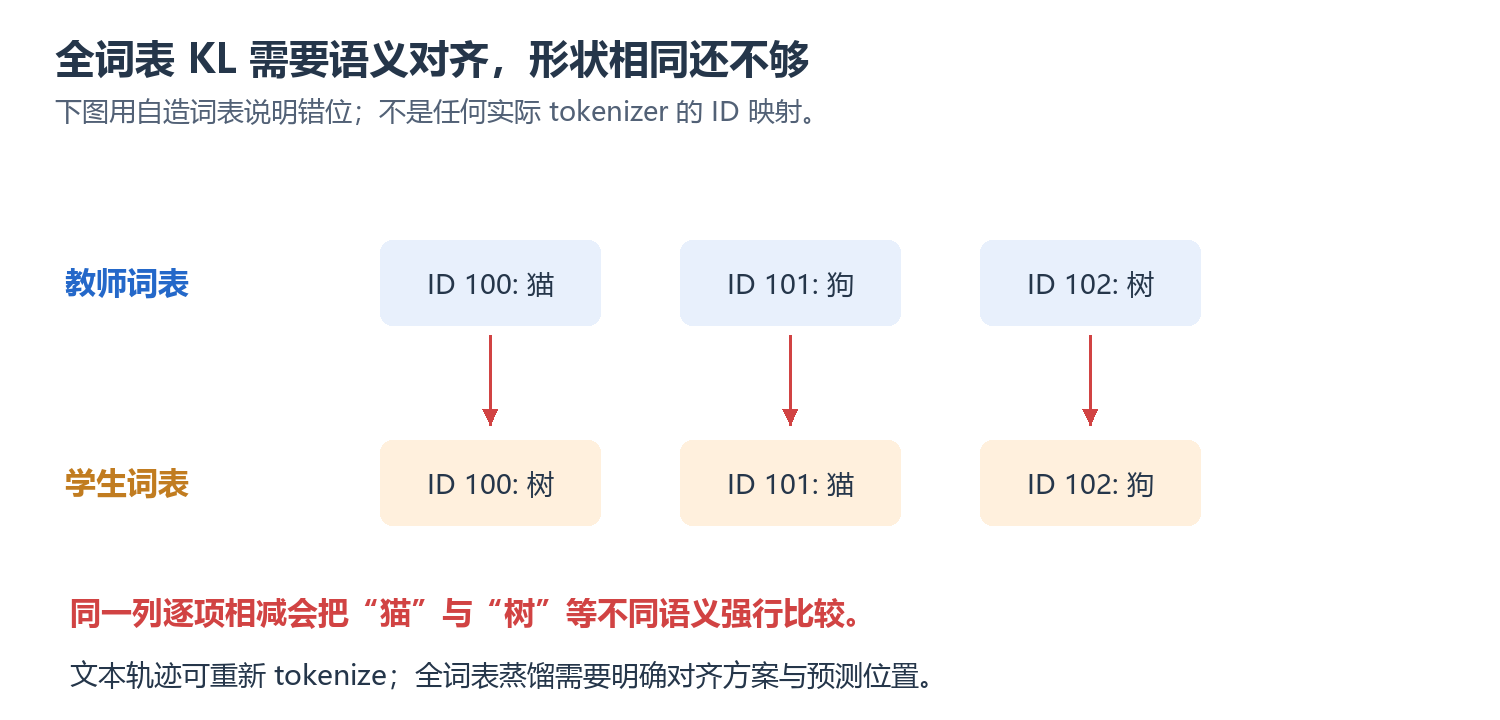
图 5b|同 ID 的语义不同,不能因为张量形状一致就逐项 KL
必须保证词表语义一致。不同 tokenizer 的第 个 ID 不一定代表相同 token,不能仅因张量都是 就逐项 KL。文本轨迹蒸馏可由学生重新 tokenize;全词表蒸馏需要明确对齐方案。还应检查预测位置的错位:前缀截止到第 个 token 时,监督的是第 个 token。
5.3 多教师监督与 MoE 内部专家
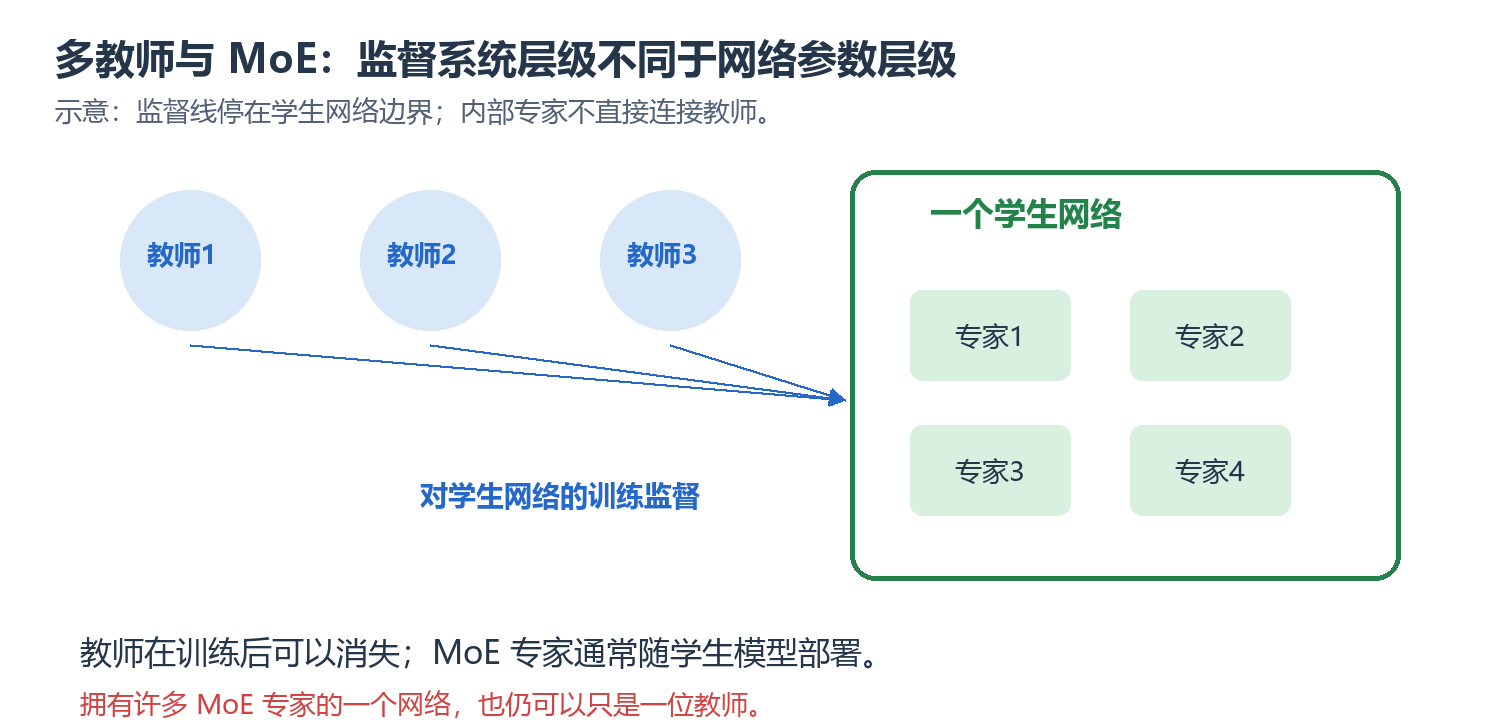
图 5c|教师位于训练系统,专家位于一个学生网络内部
多教师训练可以按领域选教师:代码前缀使用代码教师,视觉任务使用视觉教师;也可以定义分布加权混合,但冲突必须有规则。公开 V4.1 报告披露最终 OPD 使用超过 个教师,教师可能来自不同阶段并有不同架构。这是该报告的公开事实,不是所有顶级 LLM 的共同配方。来源:DeepSeek-V4.1。
该项披露位于报告 §5.2.4:Large-Scale On-Policy Distillation:后训练最后阶段在全领域数据上做 full-vocabulary OPD,使用超过 个教师;每个领域的较优教师可以来自不同训练阶段,教师与学生也可能具有不同架构。“全词表”“学生实际前缀”和“多位异构教师”描述三个不同维度,不能仅因都有“蒸馏”一词就省掉这些条件。
多教师是训练系统中的多个监督模型,MoE 专家是单个网络内部被路由调用的参数模块。 教师可以在训练后消失;MoE 专家通常随学生模型部署。一个拥有很多 MoE 专家的教师仍可以只是一个教师;多个 dense 教师也能监督一个 MoE 学生。两种“专家”称呼需要用所在层级来区分。
5.4 两位教师的分歧,为何不能靠学生把总 KL 降到零?
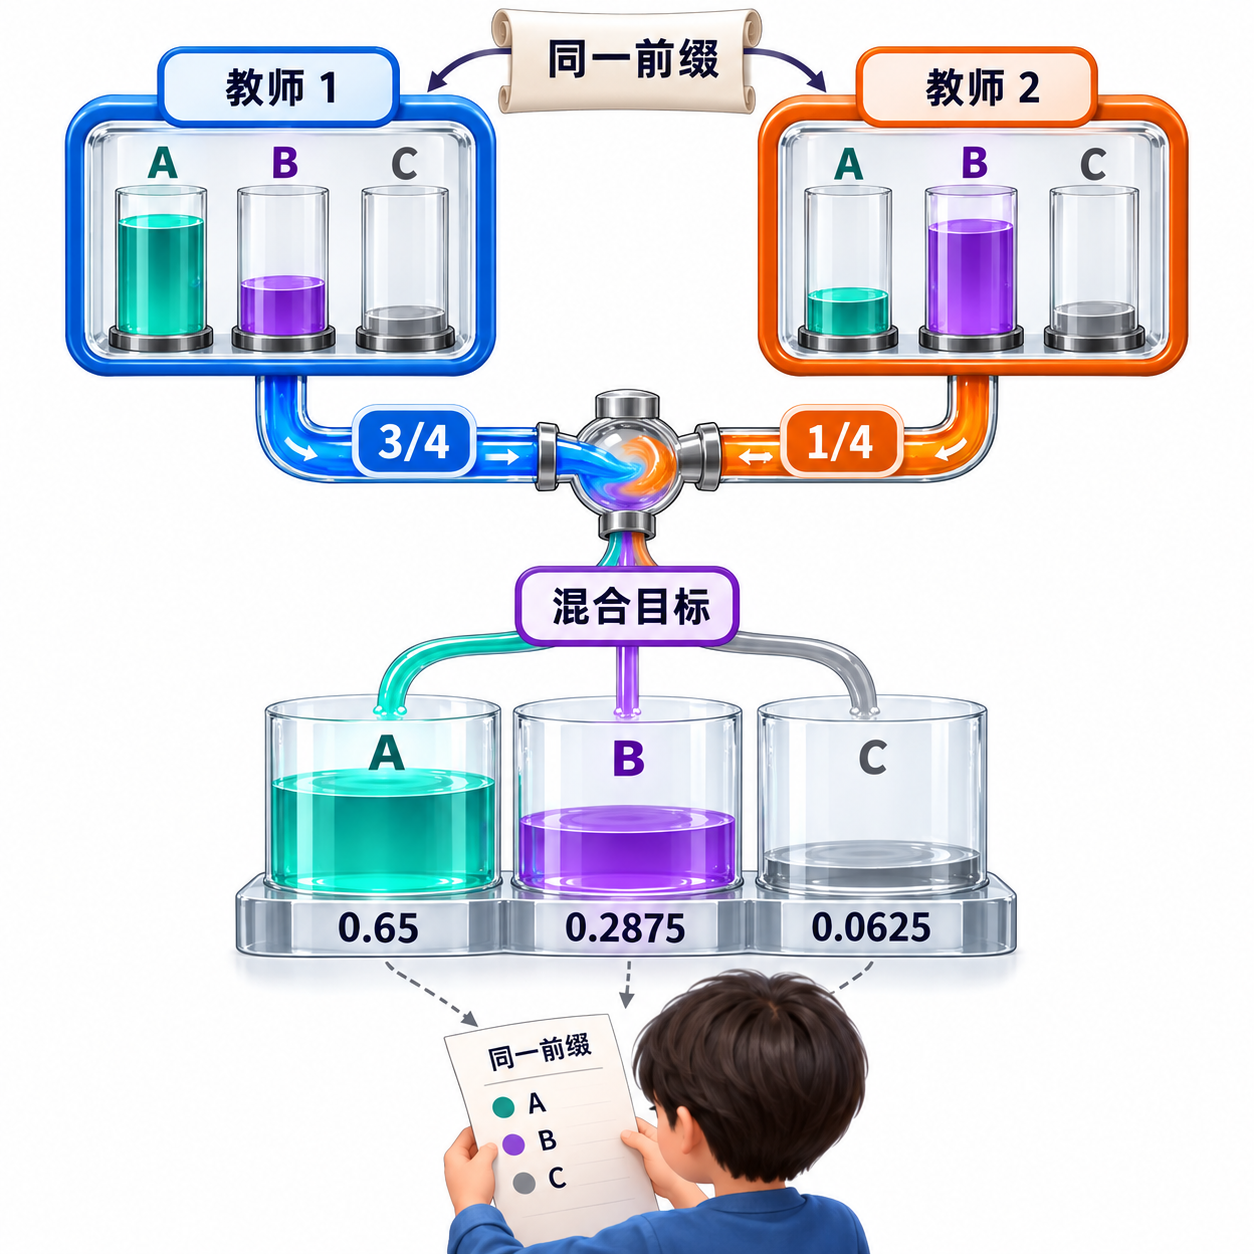
图 5-4|先明确混合规则,再让学生拟合目标;这是教学设计(ImageGen)
多教师不只是在图上多画几个老师,必须写清冲突的处理规则。构造同一前缀、同一预测位置的三候选 A/B/C:冻结教师 1 给 ,教师 2 给 ,权重 。选择这些权重只为了演算,不代表真实报告采用固定混合。
将同一候选的概率加权相加;蓝橙管道表示教师权重,目标水槽颜色表示候选,二者不能混成一种含义:
现在取学生 ,温度固定为 1。两位教师到学生的 KL 分别为 、 nat/position;按给定权重加起来是 。可学生直接拟合混合分布的 KL 只有 。少掉的部分去了哪里?
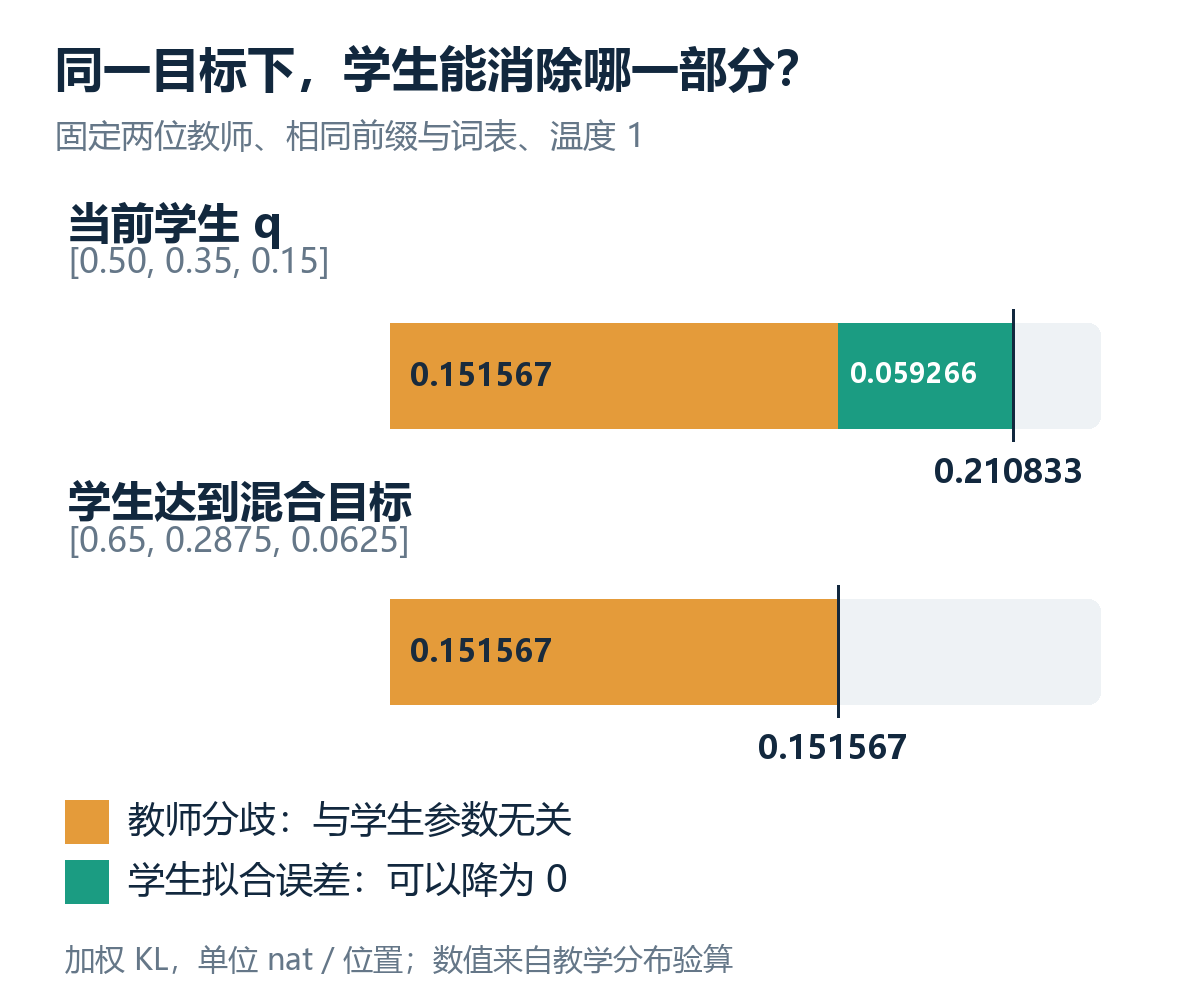
图 5-5|精确计算图:橙色常数不随学生改变,绿色才是当前拟合差距
定义加权目标 。对每一项插入 ,再把与教师编号无关的项合并,就能看到两个部分:
这里 遍历两位冻结教师, 遍历 A/B/C;权重非负、和为 1,所有用于比值的概率为正。 只取决于教师分歧,不依赖学生参数。因此 时拟合项为零, 的最小值仍为 ,而不是零:
这不是“学生还没学好”的残差,而是两位教师不能同时被逐项完全匹配。若各自都想把学生拉向自己,混合目标给出折中;若任务要求必须采用某领域教师,固定平均反而可能不符合需求,需改成按领域选择或其他明确规则。
还可检查学生 logits 的真实梯度。令 ,由冻结教师的交叉熵得到:
在这个小例中,梯度下降增加 A 的 logit、减少 B/C 的 logit,把学生拉向混合目标。两种目标相差常数,梯度相同;这不等于所有多教师训练都能如此化简。若采用 reverse KL、可训练权重、不同前缀或词表,推导条件已经改变。
本次 float64 独立计算的分解误差约 ,学生 logit 梯度中心差分最大误差约 。这些是所列分布的数学验算。V4.1 §5.2.4 披露的异构多教师、全词表 OPD 是来源事实;它没有因为“多教师”三个字,就证明实际训练采用本节的 3∶1 凸混合或本节损失。
6. 接口检查、独立评测与迁移边界
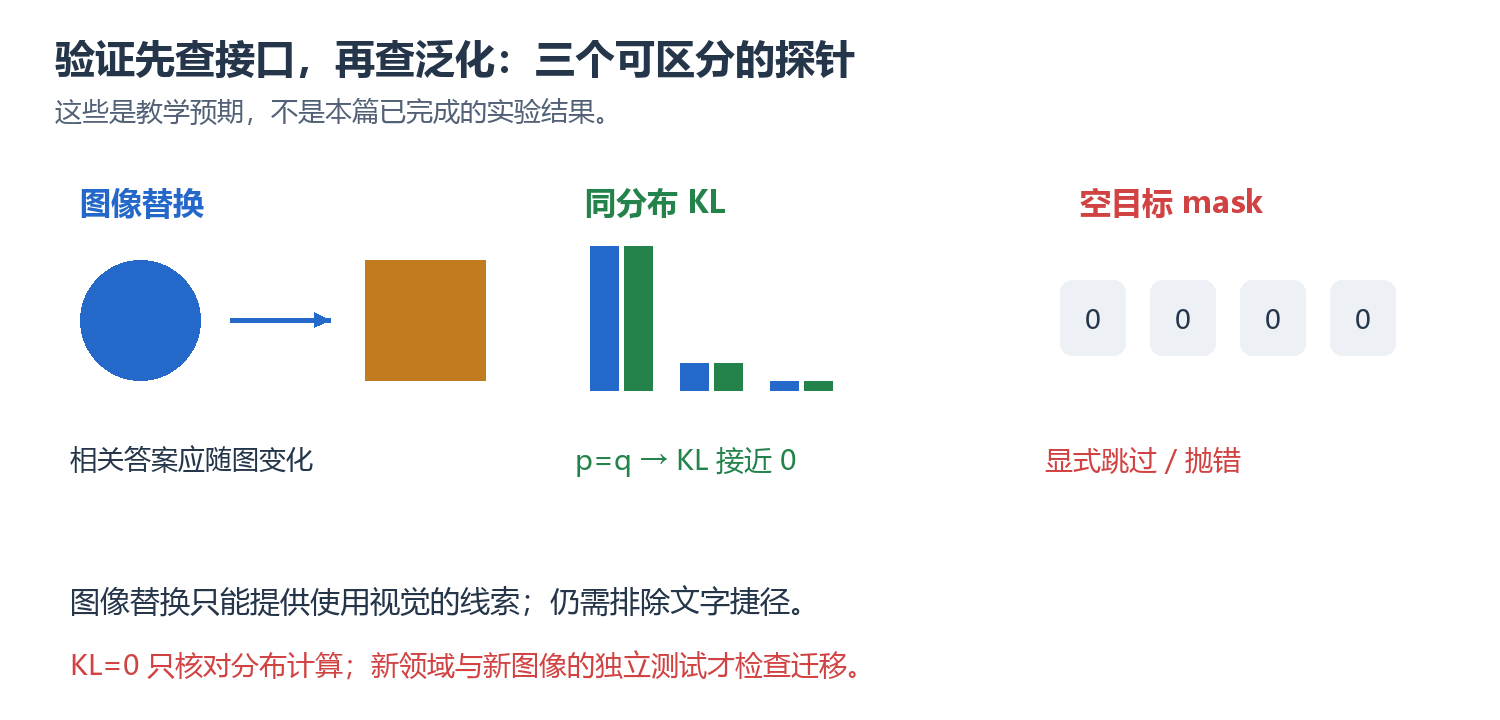
图 6a|图像替换、同分布与空 mask 分别检验不同性质
验证应从接口走向泛化。先检查图像 patch 数、projector 输出宽度、目标 mask;再用手算例比较两方向 KL;最后在独立图像、难题和真实请求上评估迁移结果。本篇数值均为示意演算,代码均未声称复现实验,完整运行与测量见本专题实验附录。
| 检查 | 预期 | 能说明什么 |
|---|---|---|
| 将图片换成无关图片 | 依赖图片的答案应有相应变化 | 主干可能使用视觉输入;还需排除文字捷径。 |
| mask 全为零 | 训练应显式跳过或报错 | 避免对空目标平均产生 NaN。 |
| 教师与学生概率相同 | KL 应接近零 | 当前分布计算与方向实现的一部分正确。 |
| 教师轨迹与学生轨迹分别评测 | 对比偏离前缀后的表现 | 检查分布差异,不能只报告训练 loss。 |
| 新领域、新图像上的测试 | 独立报告正确率与错误类型 | 检验泛化,不能用筛选数据本身当测试集。 |
蒸馏可以压缩推理成本,也可能继承教师的错误与偏见;学生有时在某个窄任务超过教师,并不代表完整复制了教师的所有能力。多模态能力也不是一个开关:OCR、空间定位、视觉推理与图像生成要分别验证。理解输入表示、目标和反馈路径,才能判断一个公开报告实际证明了什么。
正在连接 GitHub 评论…