09|分布式训练、数值稳定性与评测证据
把状态分开保存,只完成了一半工作:执行到某个模块时,还要把它需要的参数临时收回来。看清这次变化,再计算内存与同步。
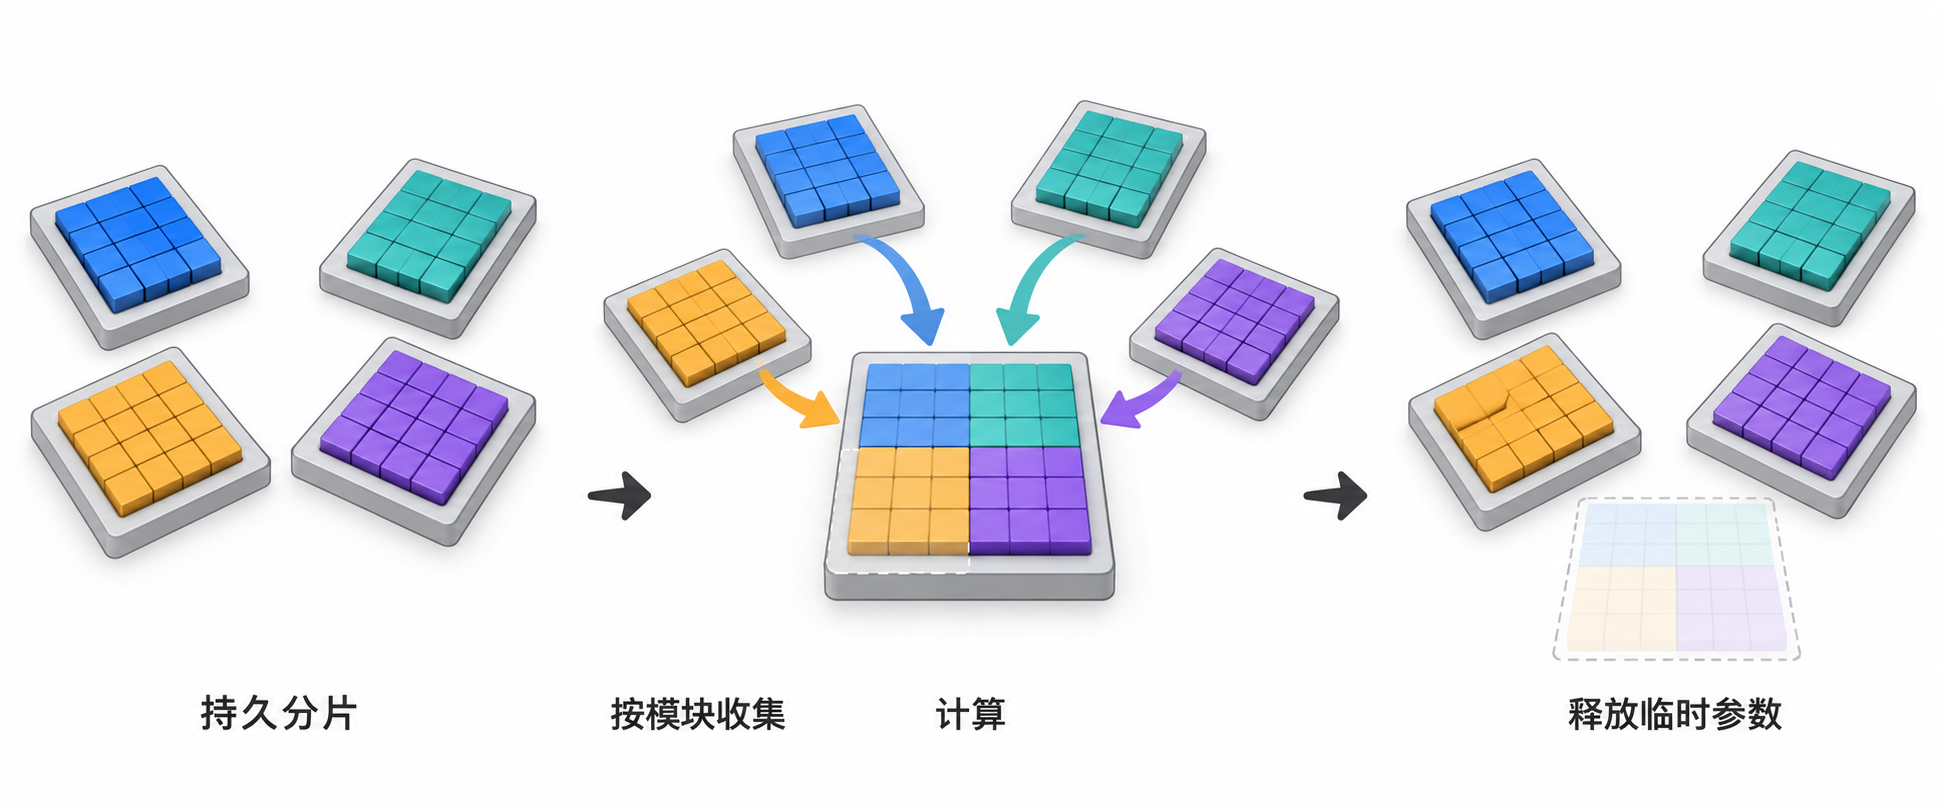
图 1|持久分片与单个 rank 的临时完整参数视图(原创教学示意)
阅读路线:先把“多少计算、多少持久状态”分别算清,再沿切分对象进入并行与分片;随后检查每个优化器步的目标、精度和可恢复状态,最后判断评测究竟测到了什么。本文没有执行多卡训练或恢复实验,数值均保留原有教学口径。
本页目录:1. 计算与内存预算 · 2. 计算与状态怎样分布 · 3. 一个优化器步的执行 · 4. 评测目标与独立证据
本篇沿“状态放哪里、何时收集、一个更新步怎样归一化、结果怎样独立评测”展开。计算和系统安排须与要优化的数学目标对应。
本篇以公开分布式方法为基础,用自定配置演算内存、计算和损失归一化。这些方法构成可选工具箱,并不意味着 GPT-6.1 或 Claude 采用了本篇的设备规模、切分比例和优化器配置。 闭源模型未披露的训练细节仍应留白。
1. 计算与内存预算
1.1 参数量、训练 FLOP 与时间
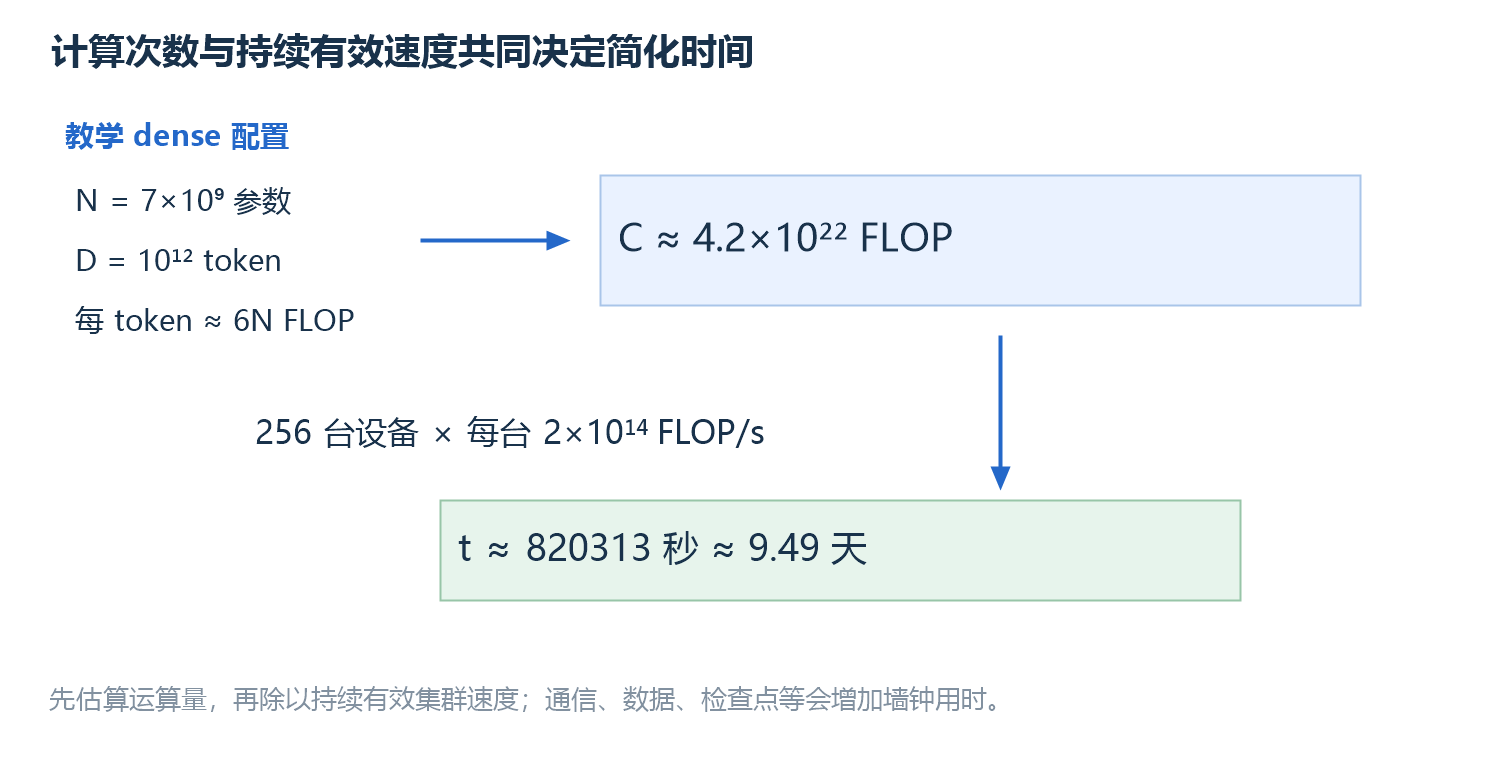
图 2|教学配置下的运算量、有效速度与时间代入
图中先把参数量与处理 token 数转成运算量,再除以集群持续有效速度。右下的天数只属于这组自定条件。
Dense Transformer 的大部分线性层前向计算,可粗略理解为每个参数参与一次乘加。把乘法和加法各计一个 FLOP,前向约为每 token ;反向还需计算参数梯度和输入梯度,合计常用近似为每 token 。这个口径来自忽略若干次要项和上下文相关成本的估算,不是精确计时器。来源:Scaling Laws for Neural Language Models,第 2.1 节。
计算与时间估算:符号、单位和手算
| 符号 | 含义与本例 |
|---|---|
| 估计训练浮点运算次数,单位 FLOP。 | |
| 本近似涉及的非 embedding 参数数;教学 dense 模型取 。 | |
| 训练实际处理 token 总数,重复轮次重复计数,取 。 | |
| 线性层前向与反向的常用近似系数。 | |
| 同时工作的设备数,取 。 | |
| 每设备假定持续有效计算速度,取 FLOP/s;不是显卡宣传峰值。 | |
| 简化计算时间,单位秒。 |
代入: FLOP;集群有效速度为 FLOP/s,得 秒,即约 天。这是自定参数的示意结果,不是实际训练用时。
长上下文注意力还包含序列位置之间的运算,稠密注意力关系数量随长度平方增长;重计算、词表投影、路由和优化器也可能增加成本。等待网络、读数据与写检查点还会增加墙钟时间。若用理论峰值代替持续有效速度,再忽略这些环节,得到的时间通常过于乐观。
MoE 需要再区分总参数与每 token 激活参数。前者影响完整权重与优化器状态的存储,后者更接近单 token 经过的计算规模,但直接把激活参数代入 仍只是初估:共享层、router、通信、专家负载和未充分利用的 kernel 都要计算。Switch Transformer 是公开的条件计算路线;它并没有把所有专家都在每个 token 上执行。来源:Switch Transformers。
1.2 每参数 16 字节的假设
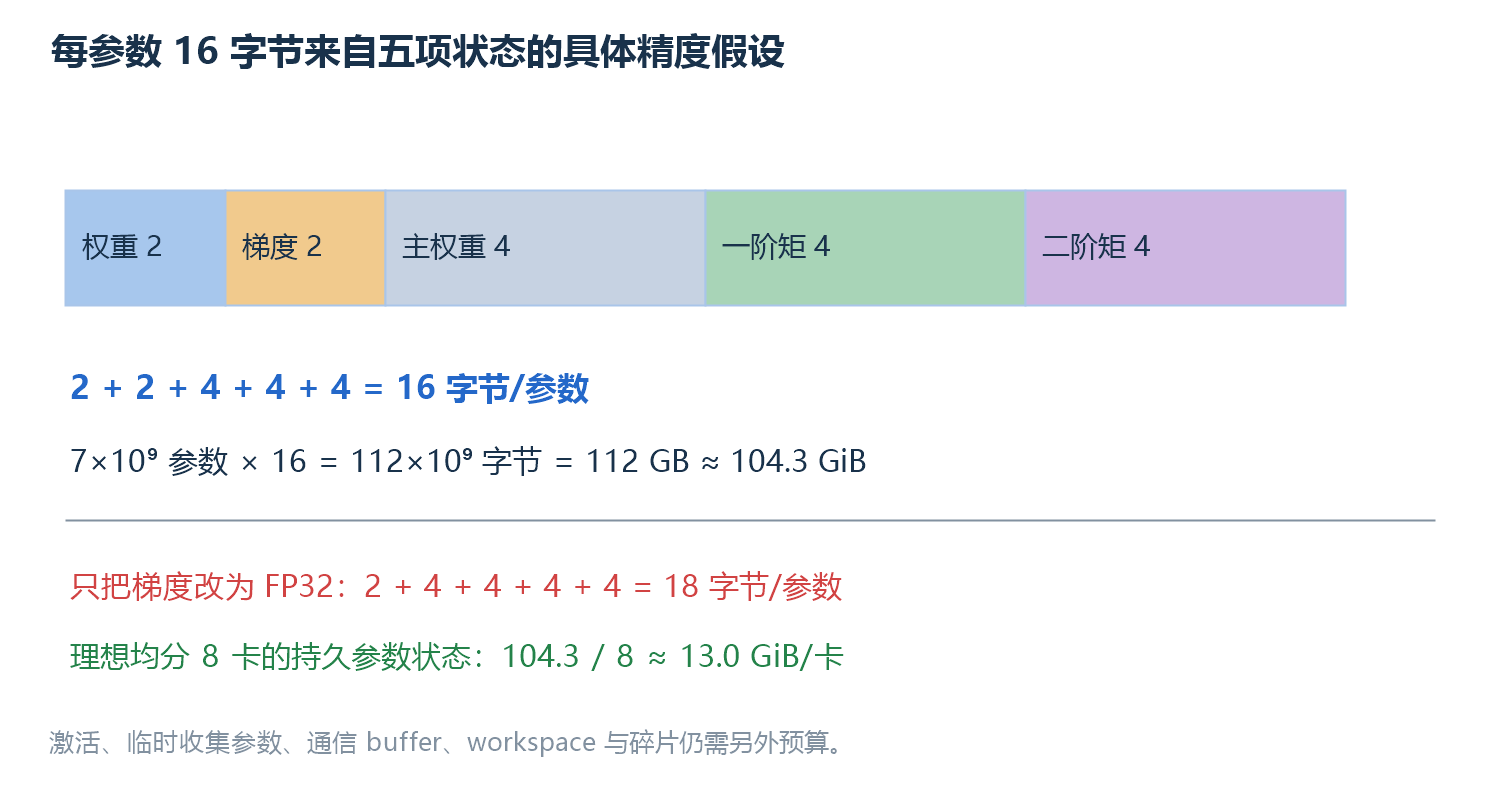
图 3|五种参数状态累加为 16 字节,梯度精度改变时总量也改变
图中条带的宽度与各状态字节数成比例。先确认每种状态是否存在、采用何种精度,再相加,不能从一个“混合精度”名称直接推出总内存。
训练内存不仅有模型权重。常见 Adam 类训练还保存梯度、一阶矩、二阶矩;某些混合精度方案另外保留 FP32 主权重。一个经常引用的 字节估算来自下面的具体配置,而不是任何模型的固定规律。
五种状态的精度与字节清单
| 状态 | 本例精度 | 每参数字节 |
|---|---|---|
| 用于部分计算的权重 | FP16 或 BF16 | |
| 保存的梯度 | 16-bit | |
| 主权重副本 | FP32 | |
| Adam 一阶矩 | FP32 | |
| Adam 二阶矩 | FP32 | |
| 合计 | 以上假设同时成立 |
为参数相关状态的原始字节数; 为参数数; 分别为权重、梯度、主权重、一阶矩和二阶矩的每参数字节数。缺少某项时该项记零。本例 ,得到 字节,即 GB,约 GiB;GB 用 字节,GiB 用 字节。
如果梯度为 FP32,其余保持表中配置,合计就是 字节。若没有单独主权重,或采用不同优化器,数字又会变。全 FP32 的“权重、梯度、两个矩”也恰好是 字节,却不是相同的精度方案。ZeRO 的内存分析展示了这种参数状态拆分方式。来源:ZeRO。
参数状态能放下,不代表训练能放下。 激活、attention workspace、通信 buffer、临时优化器张量和内存碎片仍需空间。序列长度、microbatch 与是否重计算会显著改变激活峰值。推理只加载权重时的内存,不能用来推断全参数训练内存;RL rollout 还会占用生成缓存和环境资源。
2. 计算与状态怎样分布
2.1 DP、TP、PP 与 EP 的切分对象
分布式训练的关键是明确切分对象和状态所有权。 “把训练分到多张卡”至少有四种不同含义:分数据、分层内矩阵、分层序列、分专家。它们可以组合,但通信发生在不同位置。
DP、TP、PP、EP完整对照
| 方法 | 分什么 | 主要同步或交换 | 主要代价 |
|---|---|---|---|
| Data Parallel,DP | 不同训练样本 | 合并梯度 | 普通复制模式每份都保存完整模型状态。 |
| Tensor Parallel,TP | 同一层的矩阵或张量轴 | 层内结果汇合 | 通信频繁,依赖互联与算子切分。 |
| Pipeline Parallel,PP | 连续层组成的阶段 | 阶段之间传激活和反向梯度 | 流水线空泡与负载不平衡。 |
| Expert Parallel,EP | MoE 的专家 | token 分发和结果回收 | 路由通信与专家负载不均。 |
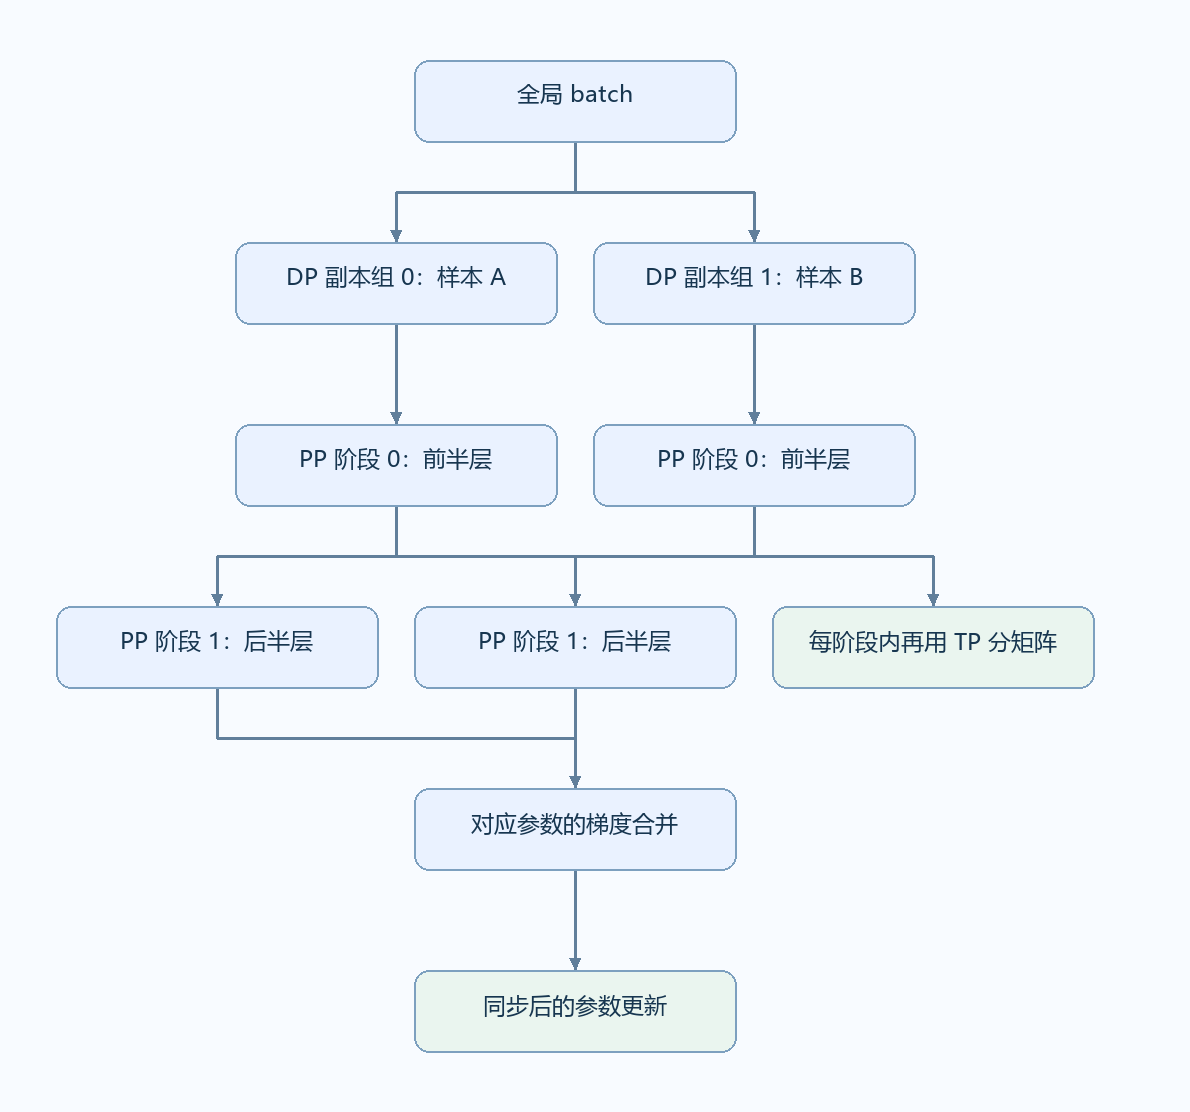
图 4|数据轴、层轴与矩阵轴可以组合(原有教学图)
例如 DP 为 、TP 为 、PP 为 ,共用 张卡构成两个完整模型副本组;每组四张卡协作执行相应样本。EP 可能配置在已有设备组内或与其他轴组合,不能在不了解框架分组规则时再机械乘一个 EP 数字。
2.1.1 TP:层内矩阵切分与局部贡献
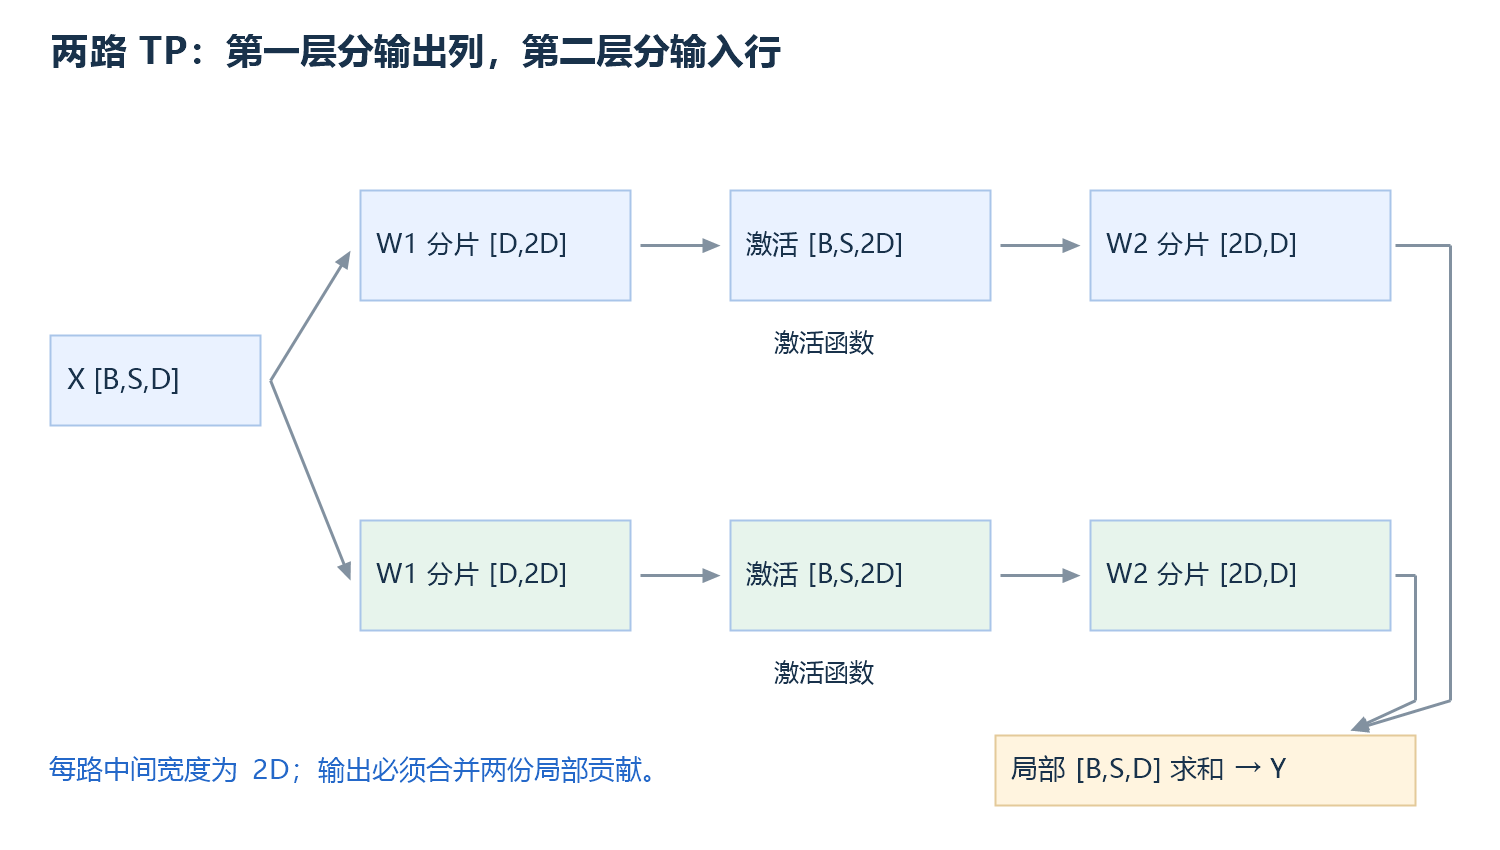
图 5|两路 TP 中的中间宽度与输出合并
图中两种颜色代表两路设备。第一层得到两份不同的中间通道,第二层产生相同输出形状的两份局部贡献;它们相加后才得到完整输出。
TP 可用一个两层 MLP 理解。第一层权重为 ,按输出列切成两份,各设备得到 。激活后,第二层 按输入行切成两份,各计算一份 的局部贡献,求和后才是完整输出。Megatron-LM 的公开工作展示了层内模型并行。来源:Megatron-LM。
2.1.2 PP:沿层顺序安排 microbatch
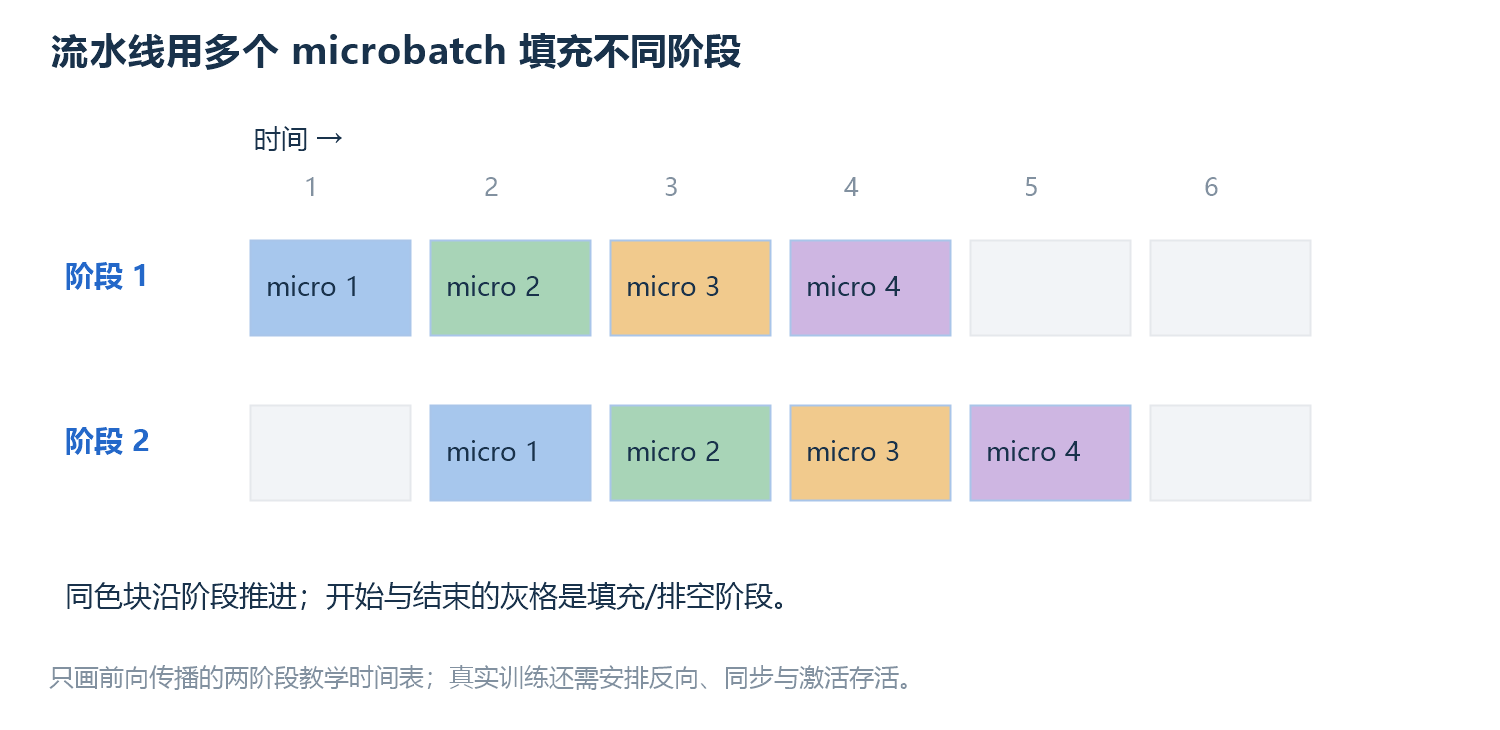
图 6|两阶段前向流水线中的填充与排空(教学时间表)
同色块表示同一个 microbatch;它在下一时刻进入下一阶段。图只呈现前向的填充关系,真实训练仍需安排反向与激活管理。
PP 则让前半层处理 microbatch 1 时,后半层可以处理已经传来的更早 microbatch。更多 microbatch 有助于填满流水线,但也增加调度与激活管理;不同安排的前向、反向交错方式不同。GPipe 是公开的 microbatch 流水线实例。来源:GPipe。
2.1.3 EP:token 分发与原位置回收
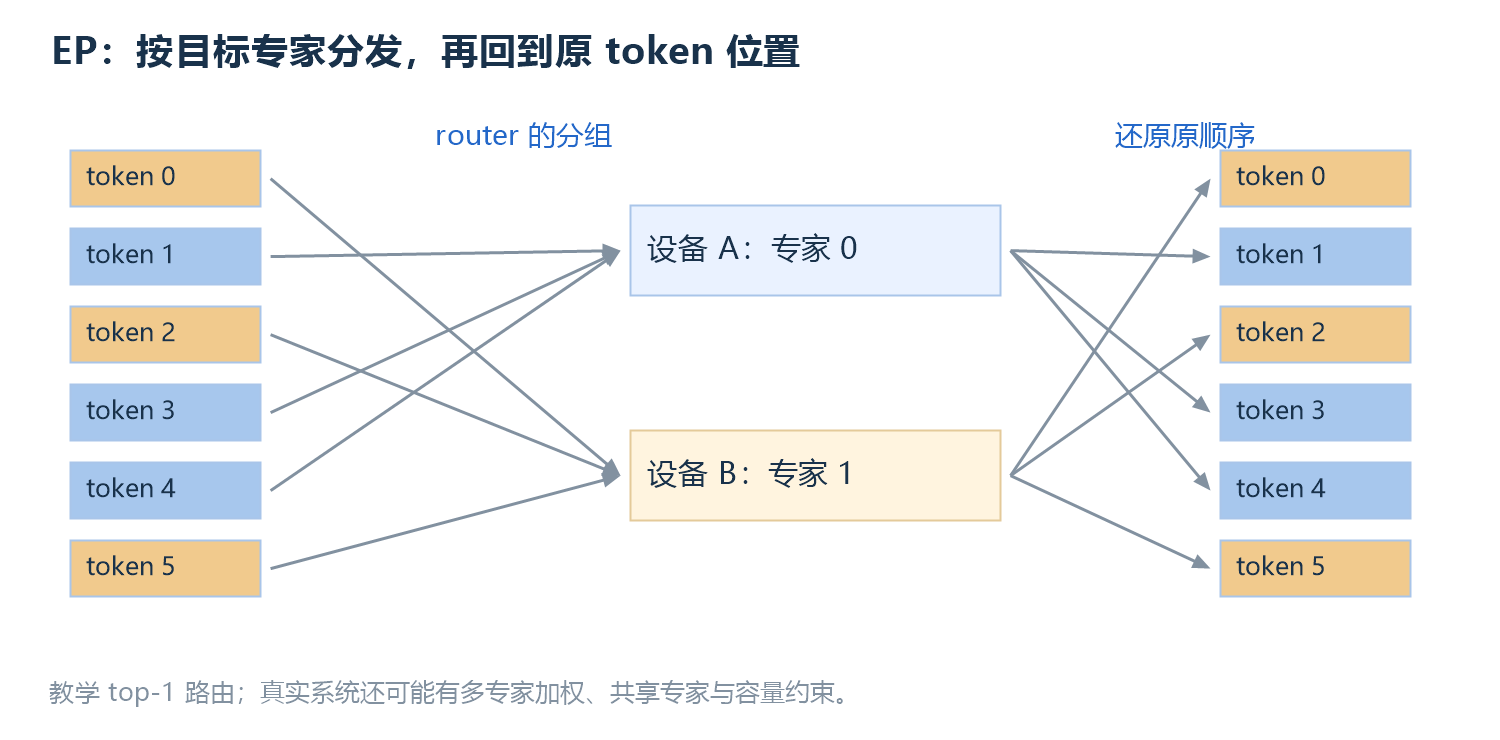
图 7|按专家分组交换,完成后还原 token 顺序
观察左侧同色 token 汇入同一专家,右侧又回到原位置。这里画的是便于观察通信的 top-1 教学例。
EP 的输入 token 先由 router 决定目标专家,再按目标设备发送;结果回到原 token 位置。把专家权重摆到多卡只解决存储,吞吐量还取决于网络、负载均衡和可重叠通信。并行策略的目标是安排原计算及状态,通常不是改变要学习的数学任务。
2.2 ZeRO 与 FSDP 的状态分片
首屏的分片图只展示选定rank的瞬时视图,其他rank仍有各自数据与同时执行的过程。
普通 DP 复制完整状态,让每个副本独立计算,然后同步梯度;ZeRO 通过消除副本间冗余来降低内存。经典阶段分别分片优化器状态、再分片梯度、再分片参数。不能把所有名为“分片”的配置都当作相同阶段。来源:ZeRO。
FSDP 在完全分片模式中,把参数、梯度和优化器状态分散保存;执行相应模块前收集需要的参数,之后按策略释放或重新分片。它仍让各 rank 处理各自数据,其通信和内存行为与普通复制式 DP 不同。来源:PyTorch FSDP。
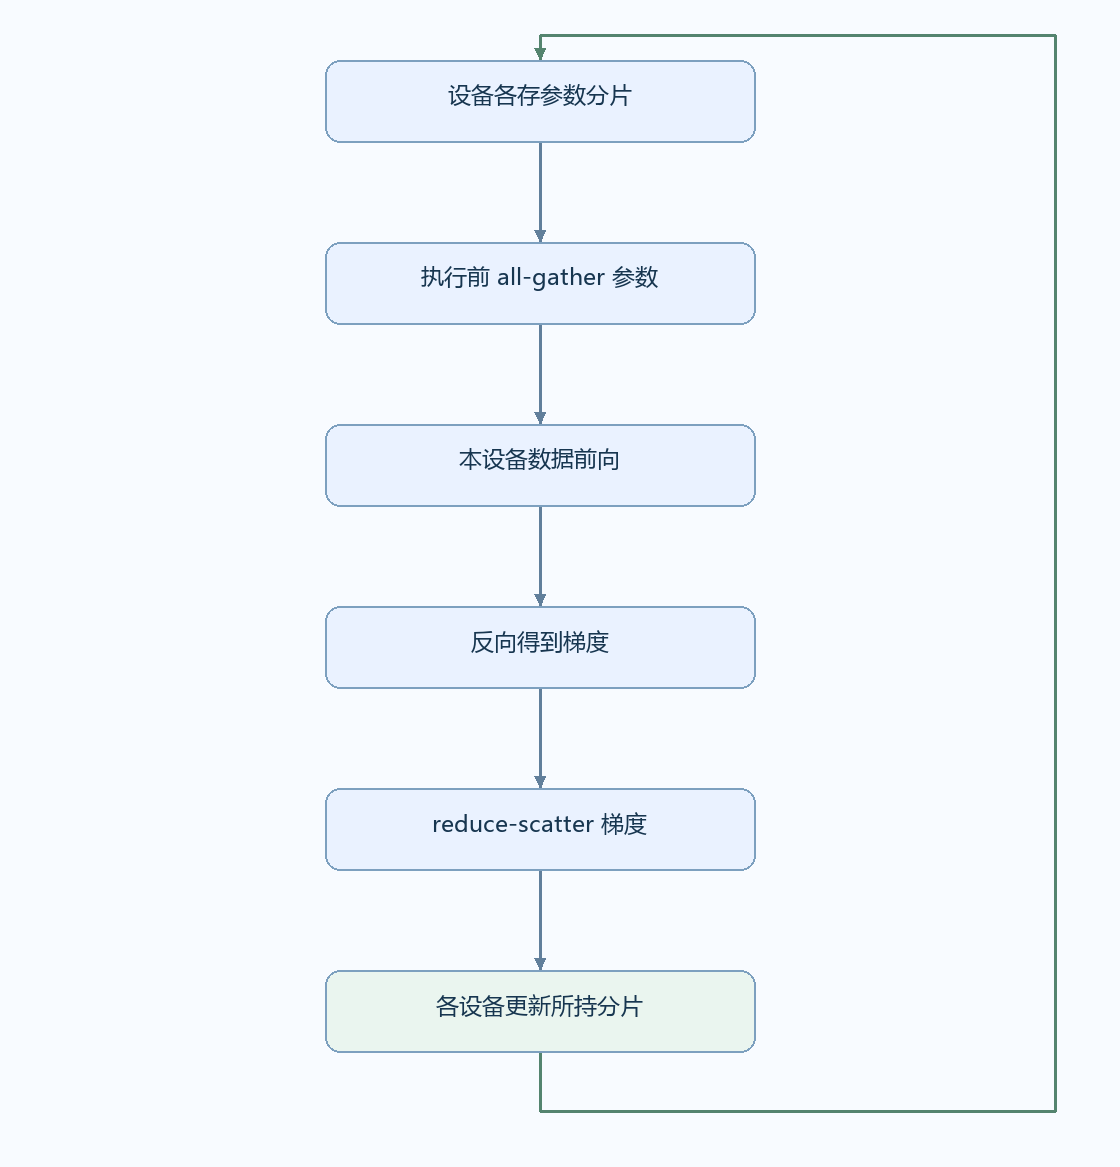
图 8|完全分片训练的简化状态循环(原有教学图)
若上一节 GiB 参数状态理想均分到八卡,持久状态约为每卡 GiB。这只是持久状态的除法,不是峰值预算:all-gather 暂存、激活和通信仍会出现。包裹模块过大可能抬高峰值,过小可能增加通信次数;预取可以隐藏等待,却增加同时存活的参数。
TP 在层内分开算矩阵,FSDP 则在计算需要时重组参数。两者都可降低某些存储压力,但通信模式不同。CPU offload 又把部分状态移出显存,可能受到 PCIe、CPU 内存和优化器吞吐限制;减少 GPU 数量不一定减少总训练用时。
2.2.1 持久分片之后,为什么仍会出现内存峰值
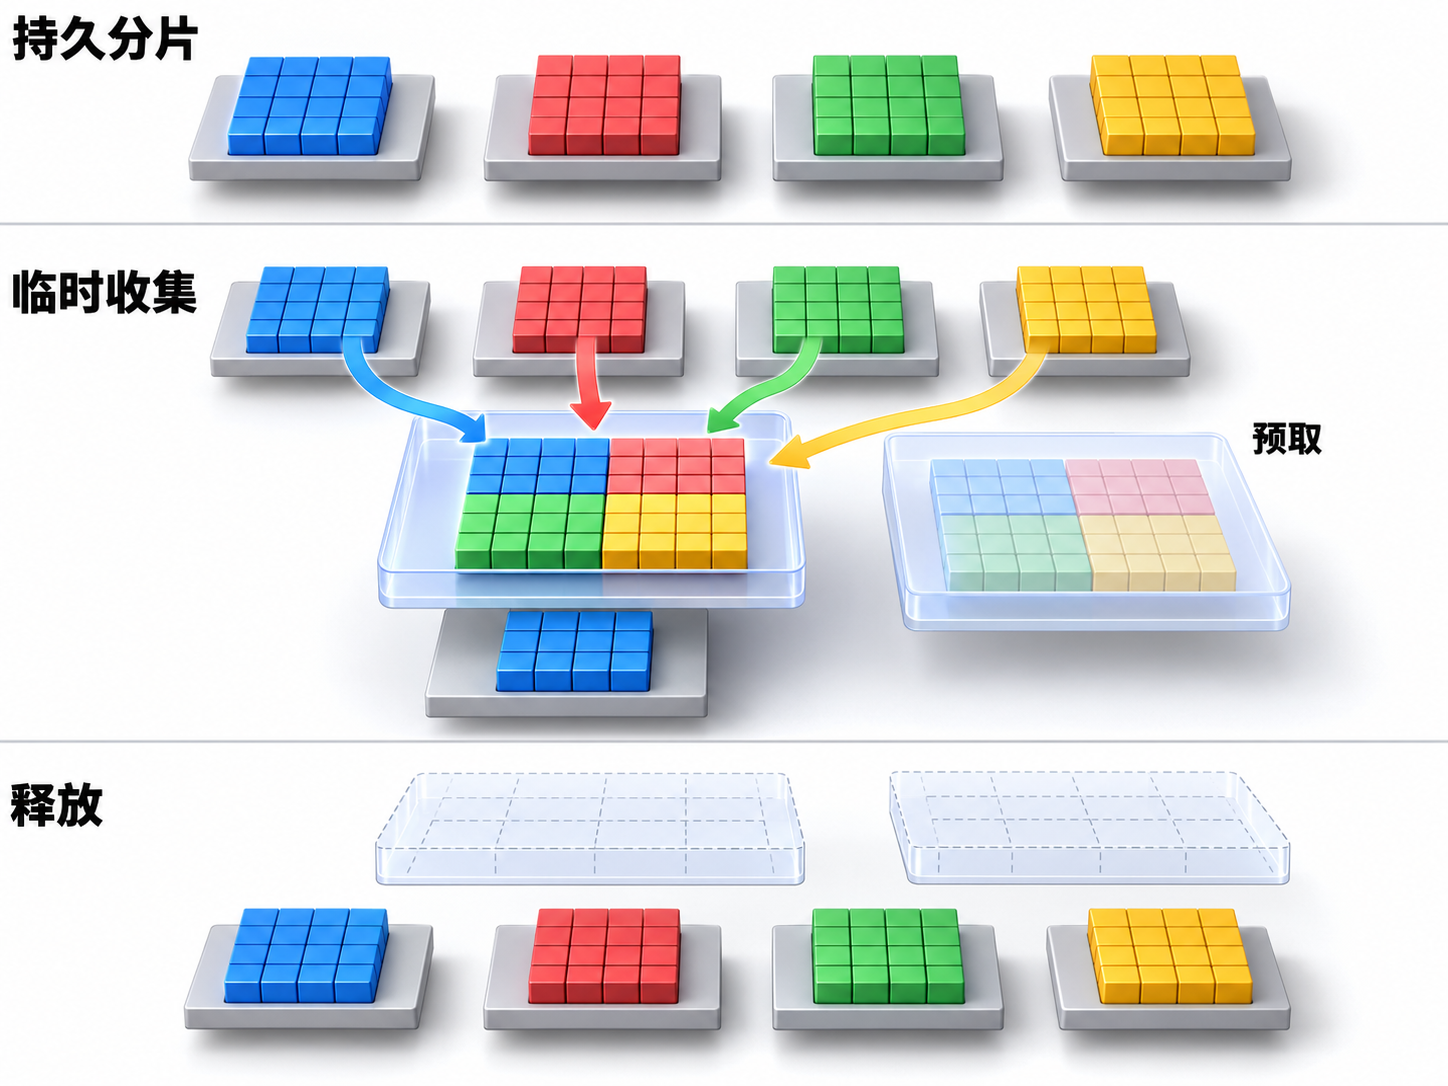
图 9|持久切片没有消失,临时完整参数又在其上出现(原创教学示意)
图上排每台设备保留一种颜色;中排选择其中一个 rank 展示计算时的瞬间:它原有的蓝色切片仍在,上方又出现按模块收集的完整参数。右侧浅色矩阵代表下一模块可能被提前预取。这两份临时空间与持久切片可以同时存活。图下排释放的是临时收集视图,四台设备各自拥有的切片仍然保留。
所以,104.3 GiB理想分成八份得到约13.0 GiB,只回答“长期由本rank保存多少参数状态”。估计峰值还要沿时间问:当前模块收集了多少,下一模块是否已经预取,哪些激活尚未释放,通信是否还有在途buffer。可以用下面的预算关系追踪,而不能把13.0 GiB当成训练卡的完整需求:
各项分别是持久状态、当前模块收集视图、预取视图、存活激活与其他临时缓冲。它们的实际峰值取决于重叠时间,某些实现还会复用底层存储,所以这是一张需要按执行时序填写的预算表,而不是保证所有最大值恰好同时相加的定理。
包裹模块变小,会缩小单次完整收集的对象,却可能增加收集次数;预取更积极,可以用额外存活内存换更少等待。把这两条变化沿中排画出来,比只比较“开了FSDP/没开FSDP”更容易定位显存峰值。颜色在这里仅标示分片来源,不表示不同模块有相同权重值。
3. 一个优化器步的执行
3.1 Microbatch 积累与有效 token 归一化
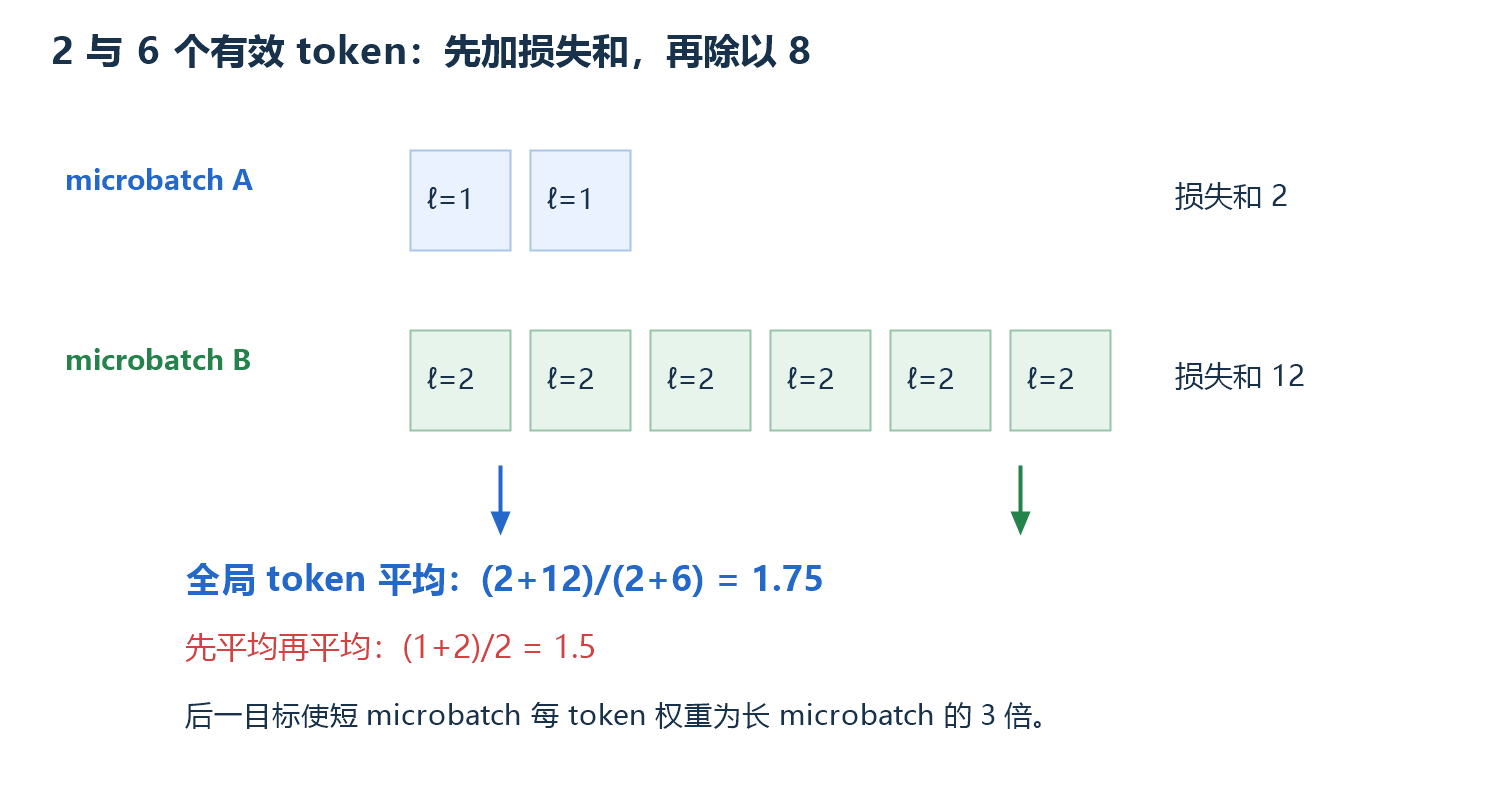
图 10|两组不等长 microbatch 的损失和与归一化
图中上排只有两个目标,下排有六个;等权平均两个 microbatch,会改变每个 token 的权重。先确定想优化的统计单位,再选择分母。
梯度积累把一个优化器步拆成多个 microbatch,分别反向,再执行一次更新。若 DP 组数为 、每组每 microbatch 为 个样本、积累次数为 ,等长条件下全局 batch 为 ;TP 和 PP 设备不是新的独立数据副本,不能算进这个乘积。
变长文本尤其要注意损失权重。如果两个 microbatch 分别有 和 个有效目标 token,直接平均两次“各自平均 loss”会让短 microbatch 的每个 token 获得三倍权重。选择 token 平均目标时,应先累计损失和,再除以整个优化器步的有效 token 总数。
积累目标:符号与不等长手算
| 符号 | 含义 |
|---|---|
| DP rank 索引与 DP 组大小,不含 TP/PP 内部设备数。 | |
| 本优化器步内 microbatch 索引与积累次数。 | |
| microbatch 展平后的目标位置索引与位置总数。 | |
| 有效目标 mask,取 或 。 | |
| 该位置的损失;对 SFT 可为下一 token 交叉熵。 | |
| 全局有效目标 token 平均损失。 |
这里新增的 仅表示整个优化器步的有效目标损失总和; 表示同一范围的有效目标数。先分别求和,再取 ,与把两项求和直接写在一个分式中完全相同。
两个 microbatch 的有效 token 数为 ,损失和为 ,则 。先求各自平均再平均得到 ,目标已经不同。
3.1.1 DDP 平均规则与代码中的缩放
代码阅读地图是 一组 microbatch → 汇总有效目标数 → 各自 loss_sum/backward → 同步 → 一次 step。以下为未实测教学片段,假定纯 DDP 默认平均梯度、各 rank 积累相同次数,global_count 已通过 all-reduce 获得且大于零。为简洁,每次 backward 都同步;生产实现可在合适步骤使用 no_sync。
# Each rank holds different data; masks exclude padding/prompt targets.
# global_count is the count over ALL ranks and ALL microbatches.
optimizer.zero_grad(set_to_none=True)
for batch in microbatches:
    loss_sum = causal_cross_entropy_sum(model, batch)
    # DDP averages across R ranks, so compensate that average here.
    loss = loss_sum * dp_world_size / global_count
    loss.backward()
optimizer.step()
DDP 先对 rank 梯度求平均,因此每个 rank 使用 归一化后,最后得到全局损失和除以全局 token 数 。换成梯度求和的通信规则,就不应再次乘 ;若已有框架替你归一化,也不能重复补偿。来源:PyTorch DDP 文档。
这是 token 平均的特定目标。某些训练需要每样本等权、按领域加权或按 trajectory 归一化,应明确选择,不能默认它们数学等价。梯度积累增加有效 batch,未必与另一种执行配置逐位相同;dropout、数值精度和其他批相关计算会造成差异。
比较积累配置时,应固定一个小 batch,把它拆成不同数量的 microbatch,再比较归一化后的梯度;先关闭 dropout,使用相同的输入、参数和目标 mask,才能定位纯粹的归一化问题。通过这个检查只说明当前目标下的实现一致,不证明更大的全局 batch 训练效果更好。大 batch 会减少处理同量 token 所需的优化器步数,学习率与调度按步还是按 token 定义,也必须一起核对。
3.1.2 两个 rank 的反例:错误平均可以让整个梯度抵消
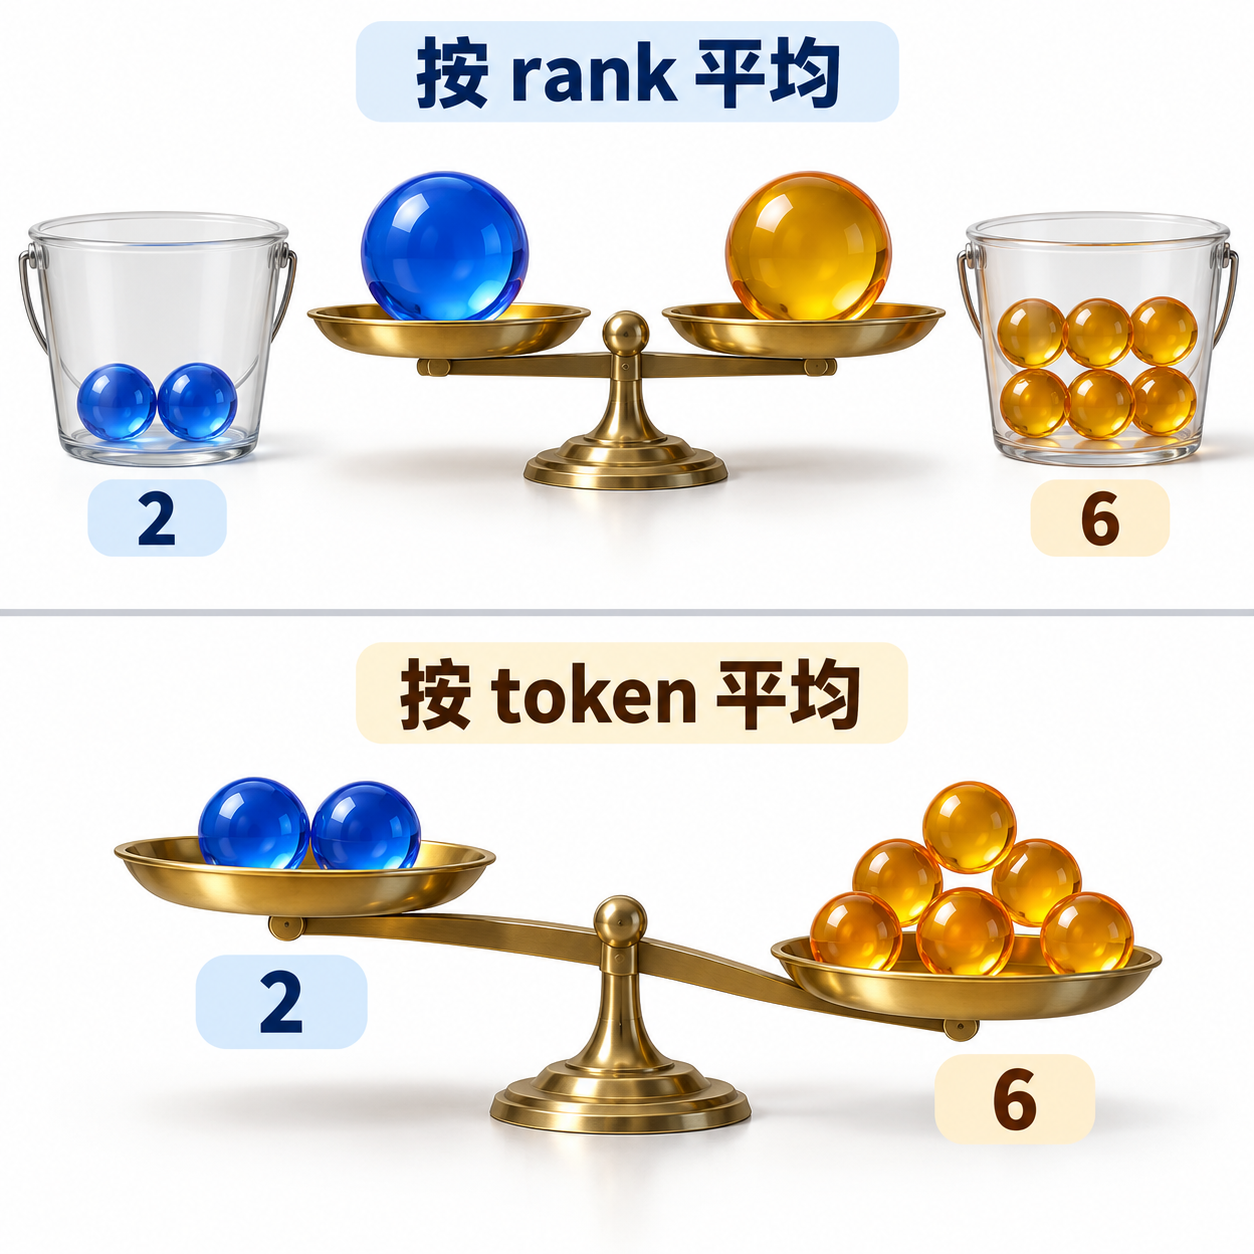
图 11|先把每桶压成一个均值,会丢掉2对6的数量关系(原创教学示意)
图上排把装有两枚与六枚 token 的桶各压成一个同样大小的“组摘要”,天平因而平衡。下排保留每枚 token 的同等权重,六枚的一侧占优。这个差异不只改变显示出来的 loss:它可以把应当更新的参数直接留在原地。
用一个实际运行的标量二分类实验检查。每个位置的特征都为 ,预测概率为 ;rank 0有两个目标 ,rank 1有六个目标 。从 开始,。每个位置交叉熵对参数的导数为:
蓝色两个位置的导数各为 ,橙色六个位置各为 :
| 中间量 | rank 0:2个目标 | rank 1:6个目标 |
|---|---|---|
| 导数之和 | ||
| 各rank自己的平均导数 | ||
| 乘 后的本地导数和 |
如果先各自平均,再让DDP把两个rank等权平均,结果是 。正确的全局token平均则是 。第三行正是前面代码中 loss_sum * dp_world_size / global_count 的补偿:DDP最后再平均 ,恢复正确目标。
取学习率0.4,正确一步把 从0移到 ,概率降到0.4750208;这与八个目标中只有两个正例的方向一致。全局平均loss由0.693147降到0.669397。错误平均因为梯度为0,参数和全局loss都不变。不能因为两次“本地平均loss”都有正常数值,就认为实现优化了同一个目标。
该检查在2026-10-19用Python 3.12.14、NumPy 2.3.5、float64实际执行;它是单进程重现DDP平均的标量算术,没有运行多卡训练。对应结果与故障注入脚本一起保存在实验附录的V2补充实验中。若任务选择每样本等权或每trajectory等权,目标可以不同;必须先说明要保留哪一层权重,再实现归一化。
3.2 混合精度与激活重计算
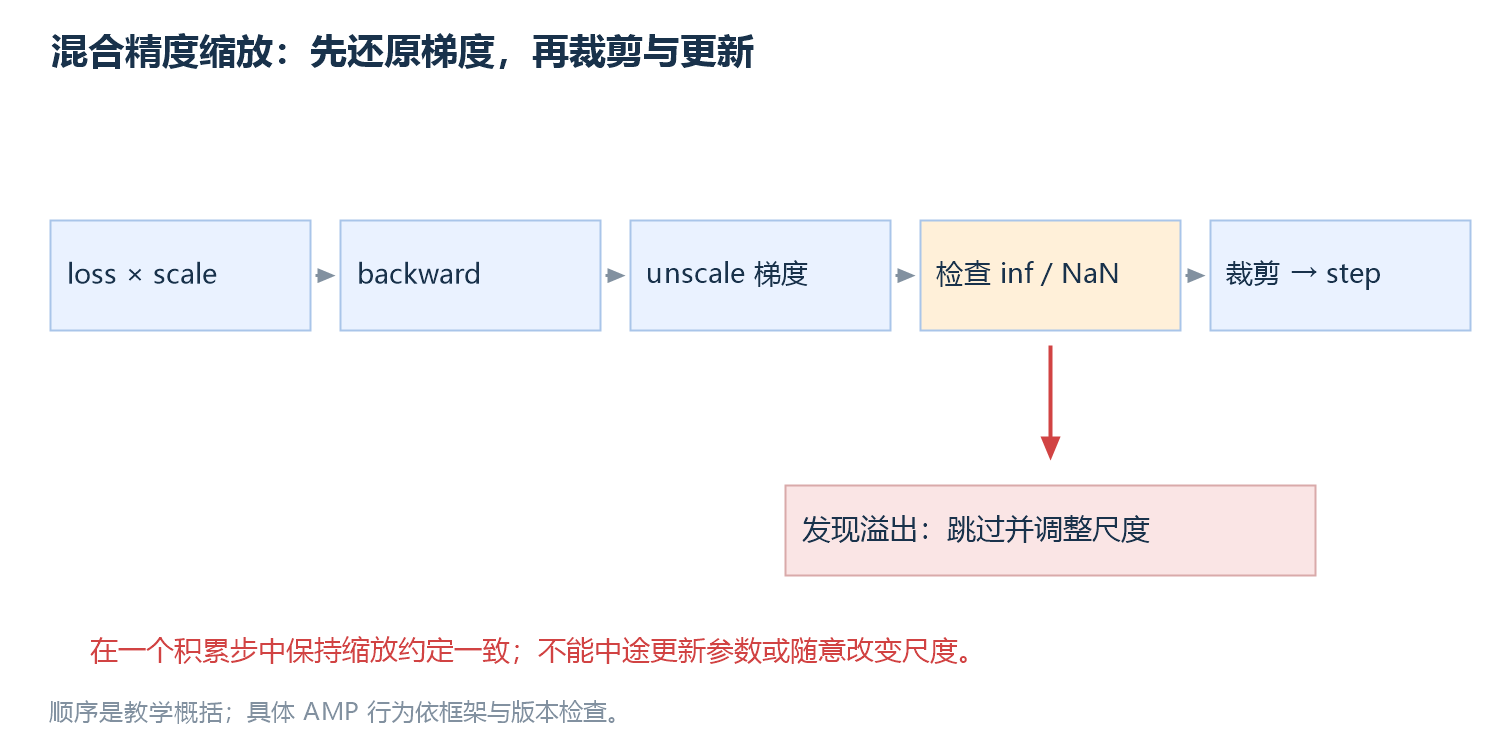
图 12|缩放、还原、溢出检查与裁剪的执行关系
图中先把梯度还原到统一尺度,再进行裁剪与更新;溢出路径需要跳过更新并调整尺度。
混合精度把适合的矩阵运算放到较低精度,同时保留敏感计算或状态的较高精度。FP16 的动态范围较小,小梯度可能下溢;loss scaling 在反向前放大损失,更新前再还原梯度。检测到 inf 或 NaN 时,可跳过该步并调整尺度。经典混合精度论文给出了这些基本策略。来源:Mixed Precision Training。
BF16 拥有接近 FP32 的指数范围,但有效精度较低,并不意味着所有运算都可以随意降低精度。梯度裁剪必须在适当还原尺度后进行;积累中途调整缩放尺度或执行 optimizer step 会破坏该步的一致性。AMP 的执行规则应以所用框架与版本为准。来源:PyTorch AMP examples。
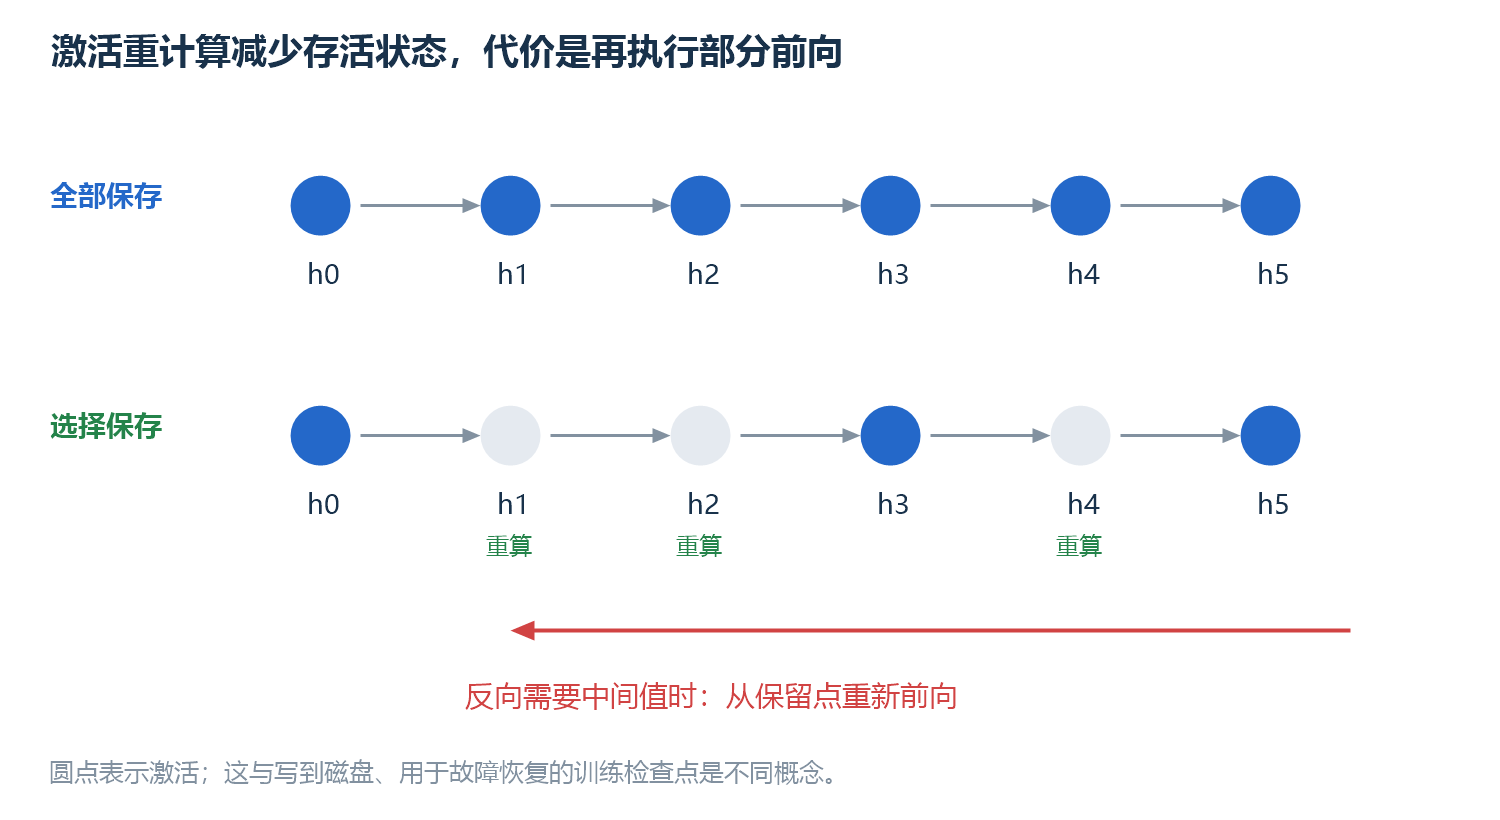
图 13|保留部分激活,并在反向需要时重算
图中蓝色实心点是保留的中间激活;浅色位置需要从保留点重新计算。少存储的代价是额外执行前向,而不是删除原来要做的计算。
激活 checkpointing 与磁盘检查点是两个不同概念。前者少保存部分前向中间结果,在反向时重算,以额外 FLOP 换显存;后者保存训练状态,以便故障恢复。重计算要控制随机状态和副作用,不能把带外部状态修改的 forward 当作无成本重复执行。
数值稳定性的监控也不应只看平均 loss。应记录梯度范数、溢出、异常激活、学习率、有效 token、各领域 loss,以及 MoE 专家负载。一个领域改善而另一个领域恶化,可能被平均值遮蔽。FP8 等更低精度方案需要具体的缩放、累积和异常值设计;公开案例中的稳定性结论仅适用于其实现与实验范围。
3.3 检查点与 RL Rollout 的状态管理
3.3.1 同一逻辑步的可恢复状态
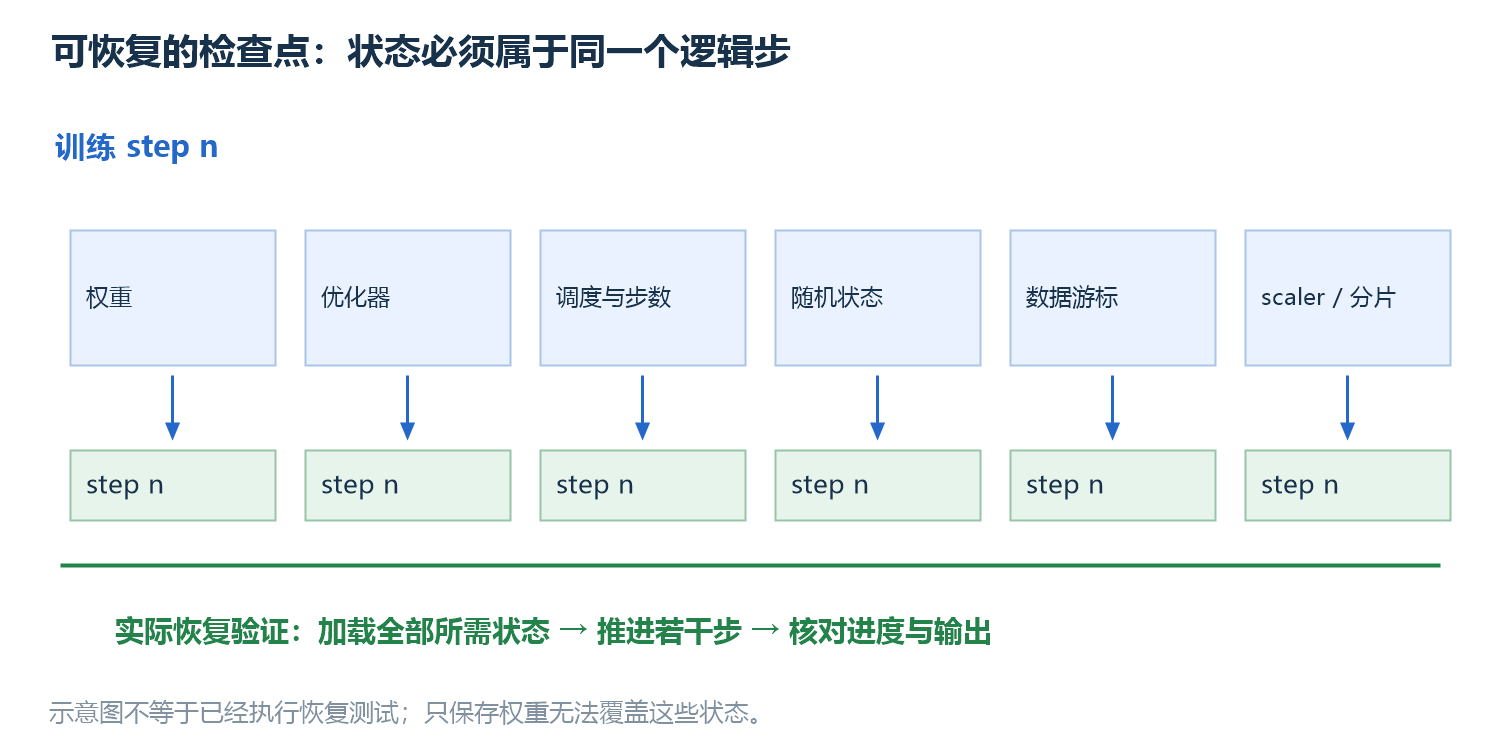
图 14|完整训练检查点需要对齐多种状态
沿图中同一行的 step n 检查所有状态:数据游标、随机状态与参数属于不同步时,恢复后的行为就可能偏离原训练过程。
可恢复训练的检查点通常需要模型权重、优化器状态、学习率调度、步数或已处理 token、随机状态、数据读取位置,以及可能的 scaler 和分片元数据。只保存模型权重足以部署或另起微调,却不能保证接着同一步训练。分片系统还需明确恢复时的设备布局与重分片方式。来源:PyTorch Distributed Checkpoint。
写入中断也要考虑一致性:全部分片是否属于同一逻辑步,元数据是否完整,数据游标是否与权重匹配。恢复测试应真正加载并推进几个步骤,而不是仅确认文件存在。精确复现还受 kernel、随机序列和执行次序影响,应区分“恢复训练进度”与“逐位复现原轨迹”。
3.3.2 生成、评分、更新与异步陈旧样本
RL 加入一条新循环:当前 policy 在题目或环境中生成 trajectory,验证器或 reward model 评分,然后训练器根据这些样本更新 policy。生成阶段受长尾响应、KV 内存、工具等待和环境吞吐影响,训练阶段则需要反向与同步,两者的最优资源安排未必相同。
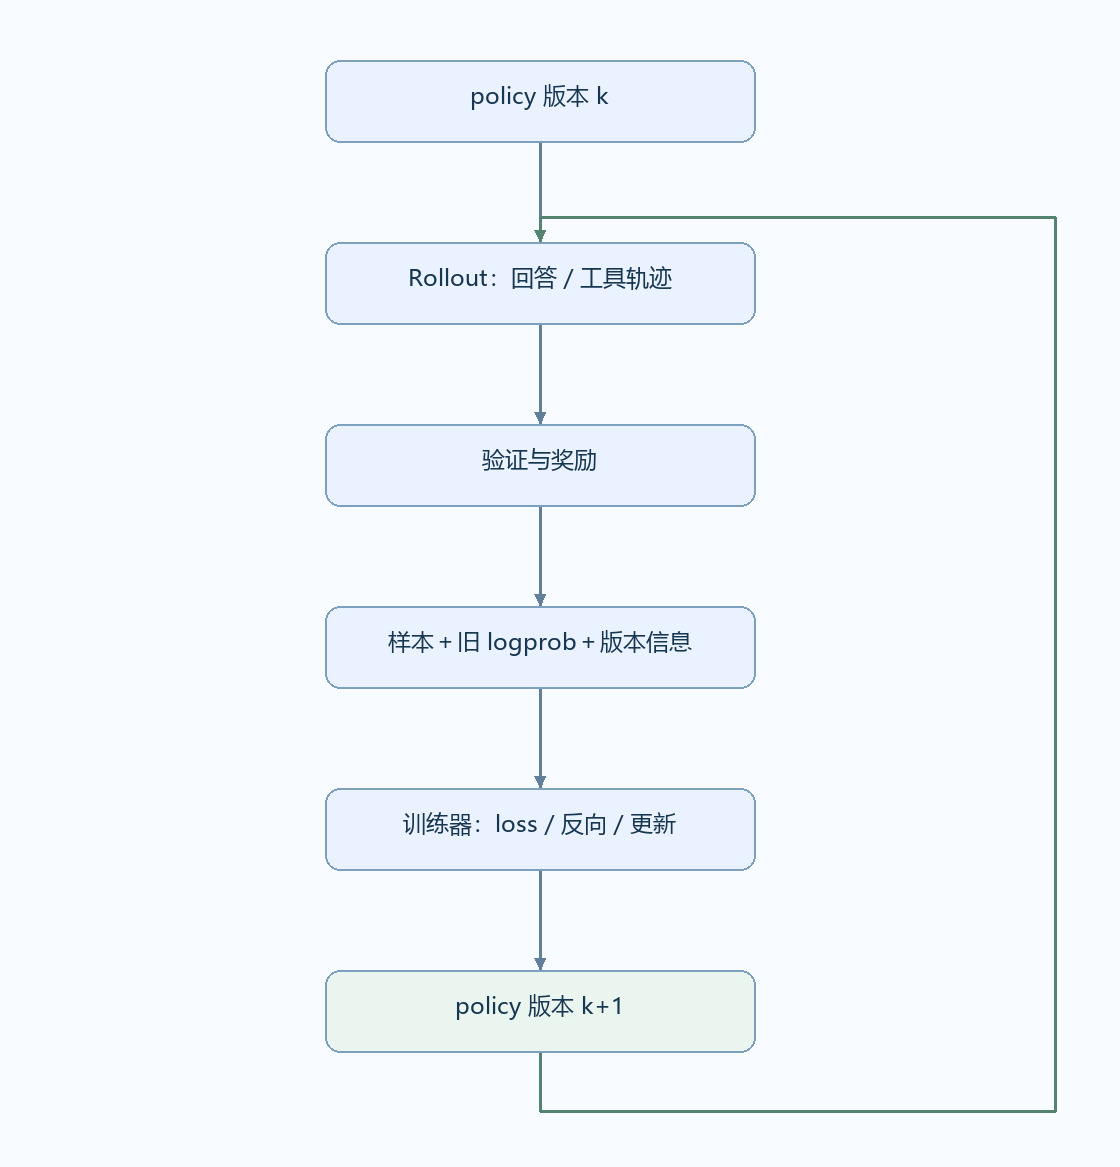
图 15|RL 生成与参数更新形成闭环(原有教学图)
异步 rollout 可让生成和更新更灵活,却可能产生由旧 policy 生成的样本。训练器需要追踪行为策略概率与样本陈旧程度,不能默默当成当前 policy 的新样本。公开 V4.1 报告讨论了异步生成的长度偏差和 off-policy 问题;其处理措施是该系统的方案,不是唯一解。来源:DeepSeek-V4.1。
4. 评测目标与独立证据
4.1 Pass@k 与实际选择能力
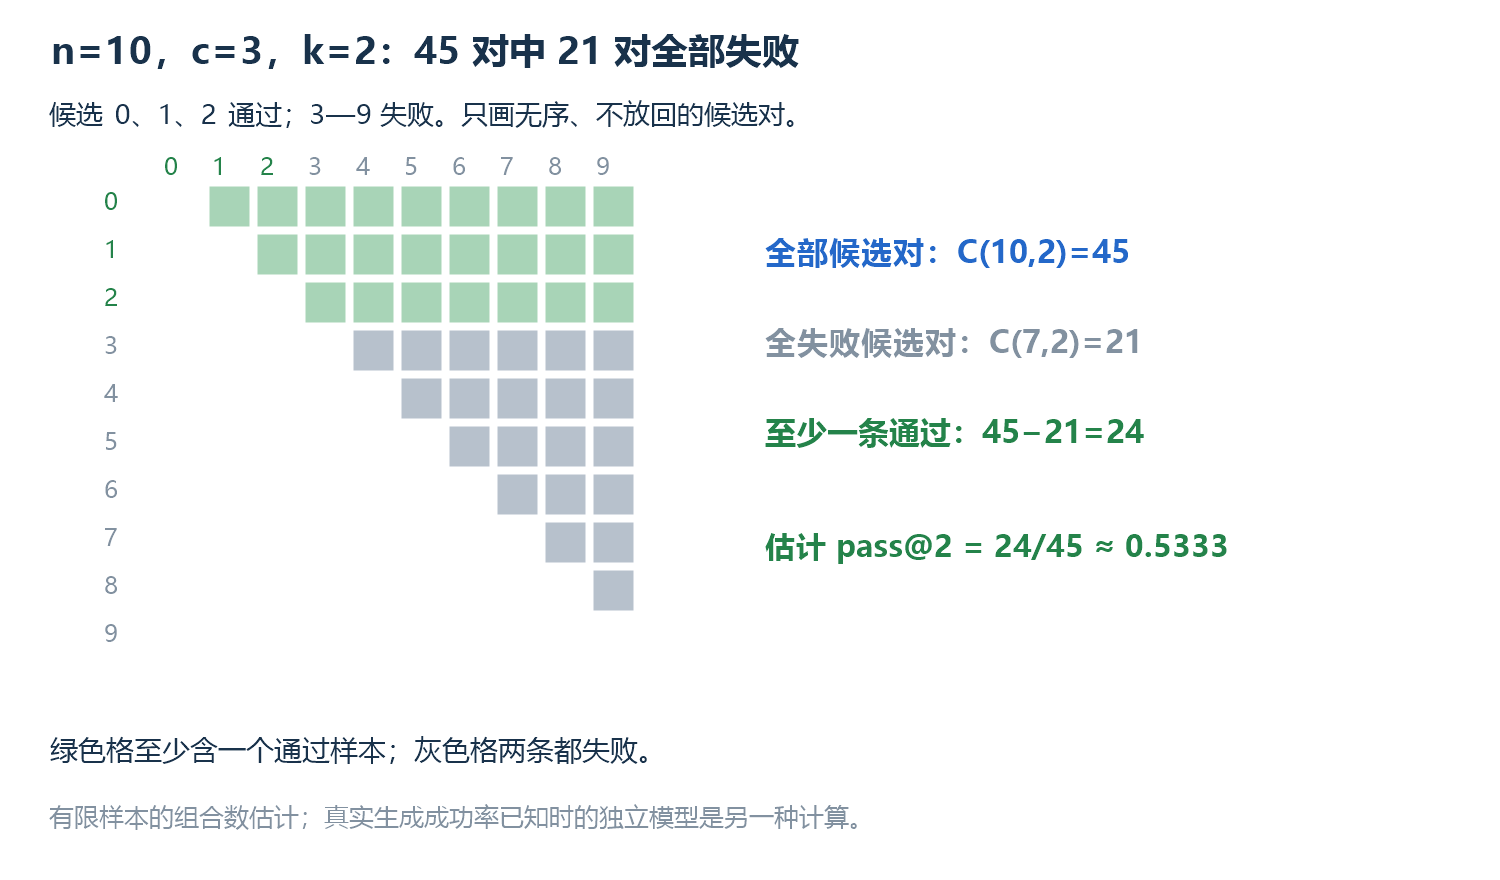
图 16|十个已有样本中,两两组合的通过与失败格
图中每一格是一对不同候选,只计上三角,所以总共有 45 对。右下的灰色三角由七个失败样本构成,其中 21 对全部失败。
代码任务可用测试检查功能正确性。Pass@1 反映一次候选的成功概率;pass@k 问“生成 个候选,至少一个通过”的概率。它通常带有一个知道测试结果的理想选择器,因此不能直接当作产品从候选中挑对答案的能力。
公开 Codex 评测给出了从每题 个生成样本、其中 个正确,估计 pass@k 的公式。来源:Evaluating Large Language Models Trained on Code。
为一题实际生成样本数; 为其中通过样本数; 为要估计的候选预算,要求 ; 是从 个元素中选 个的组合数。若 ,该组合数取零。
取 。全部候选两两组合有 种,两条都错有 种,故估计值为 。 时得到 。整个 benchmark 对题目级估计值再平均。
把经验值 直接塞进 得到 ,与上述有限样本估计不同;对独立初始生成样本,组合数方法给出相应无偏估计。第八篇的理想概率模型是假定真实 已知,不能混淆两个用法。自适应重试、相互反馈的 agent 轨迹则需要按实际协议评测。
Pass@k 不等于 best-of-k 的最终正确率,多数投票正确率也不是 pass@k。 测试不完备时,通过不代表对全部输入正确;只看公开样例可能奖励硬编码。应同时报告隐藏测试、超时、资源限制、采样参数及重试预算。
4.2 污染、可比性与失败分析
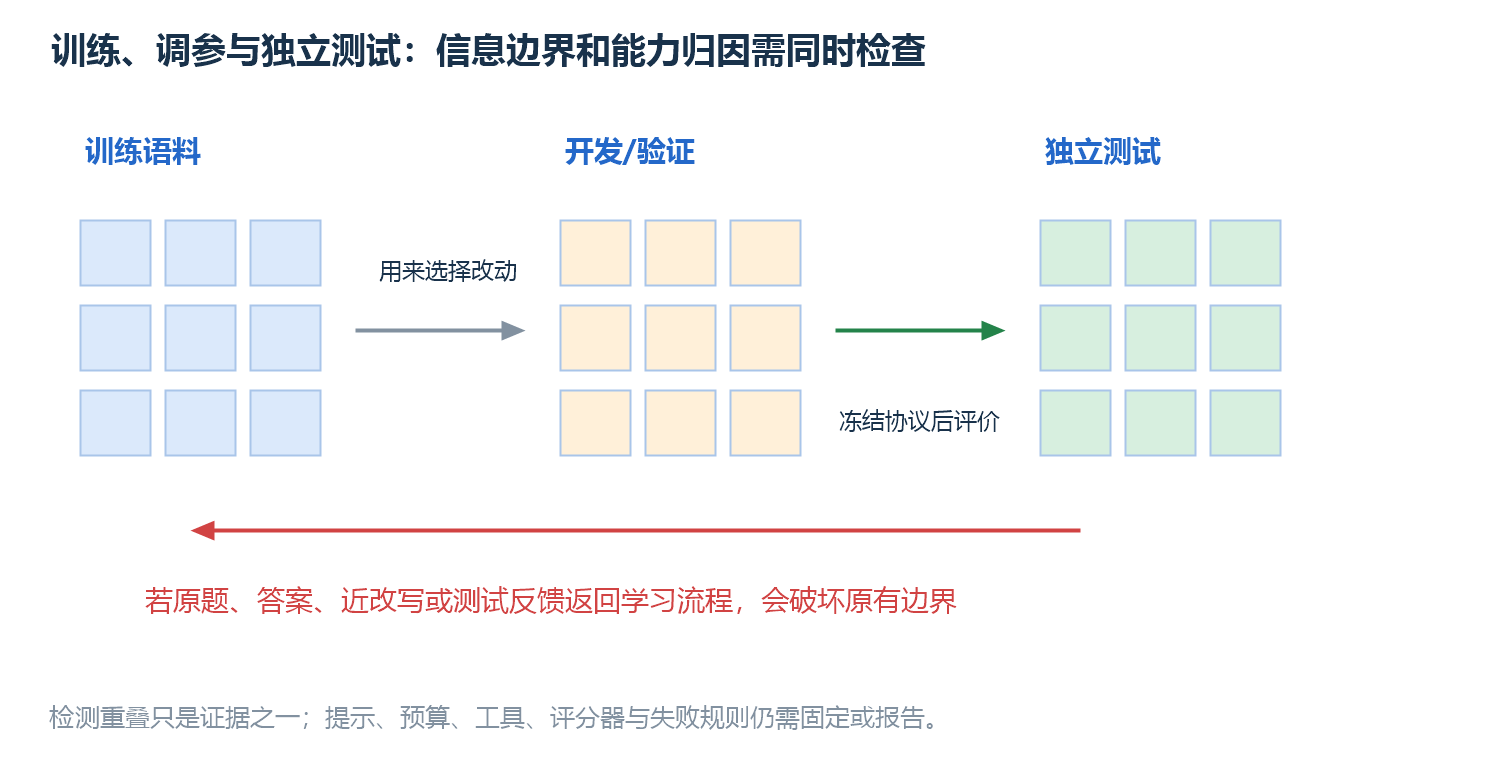
图 17|开发信息与最终测试之间的边界
图中红色回流表示评测题目或反馈进入学习流程;它可能来自直接复制,也可能经改写、合成数据或反复调参进入。
污染发生在评测信息以某种方式进入学习或评测流程:原题、答案、近似改写、官方测试,甚至讲解该 benchmark 的合成数据。训练数据删除 benchmark 文件名,还不能排除网络转载与改写;生成者也可能从先前训练中记住题目。
公开 Llama 3 报告分析了训练语料与评测样本的重叠,并指出污染检测会有误报和漏报。重叠可能来自常见知识或引用背景,不能把每个 n-gram 匹配都当作记住答案;也不能由“未检测到匹配”宣布绝对无污染。来源:The Llama 3 Herd of Models,第 5.1.4 节。
较可信的证据组合包括时间切分、来源切分、近重复检查、独立编写的新题、私有测试,以及对疑似污染子集和较干净子集分别报告。它们各有盲区,应该互相补充。训练开发阶段反复依据一个验证集调参,也会让它变成事实上的开发数据,最终还需保留独立测试。
| 比较时固定或报告的条件 | 不固定会产生的混淆 |
|---|---|
| 模型快照、日期、输入模态 | 不同版本或文字子集被混为同一结果。 |
| 提示、few-shot、上下文长度 | 模板差异被误认为权重差异。 |
| 温度、候选数、reasoning 预算 | 更多计算被误认为同预算能力提升。 |
| 工具、权限、harness、时间 | 外围系统能力被归给模型本身。 |
| 验证器、测试、失败和超时规则 | 评分捷径或部分通过被当作完整成功。 |
| 重复试验与不确定性 | 小差距被当作稳定排名。 |
训练过程中的 loss 下降证明模型更适合当前监督,不自动证明知识更真实、推理更可靠或 agent 更安全。评测应该保留失败样本,按知识缺失、推理错误、视觉误读、工具误用、格式失败和环境失败分类。只有记录训练目标、计算口径和独立测试,才有依据判断一次改动改善了什么。
若一个训练改动只提升特定领域,应优先验证其代价:其他领域是否退化、回答是否更长、工具调用是否更多、格式是否更不稳定。对 agent 任务,应把模型错误与基础设施失败分开统计,同时保留原始总成功率;否则排除所有失败环境可能美化结果。小 benchmark 的几道题就能改变百分点,重复运行、置信区间和逐题结果通常比单一小数点排名更有解释力。
本篇数值均为自定演算,代码为教学片段;没有将未执行的多卡训练或恢复测试写成实测结果。实验附录将把形状、损失归一化、缓存和采样机制转换为可运行检查;大规模配置的吞吐与稳定性仍须在对应硬件和数据上验证。
正在连接 GitHub 评论…