07.1.4|OPSD、SDFT 与 SDPO:教师上下文与更新
“同一个模型给自己当老师”容易掩盖真正的变化:老师比学生多看到了什么?OPSD 给教师参考推理,SDFT 给教师专家示范,SDPO 则让教师看到学生尝试之后的反馈。它们把模型的上下文学习能力转成训练信号,但教师如何更新、对齐哪些概率、实验测什么,各有不同。
本文先沿计算路径看三种信息来源,再读散度、参数更新与结果。论文分别依据 OPSD:Self-Distilled Reasoner,v3(2026-03-20)、SDFT:Self-Distillation Enables Continual Learning,v2(2026-08-07)、SDPO,v2(2026-02-16)。
- 一、共同骨架:学生走轨迹,教师多看上下文
- 二、OPSD:看参考解,在学生位置对齐全词表
- 三、SDFT:从示范学新技能,同时观察旧能力
- 四、SDPO:用环境反馈重评原始尝试
- 五、教师更新、成本与自举边界
一、共同骨架:学生走轨迹,教师多看上下文
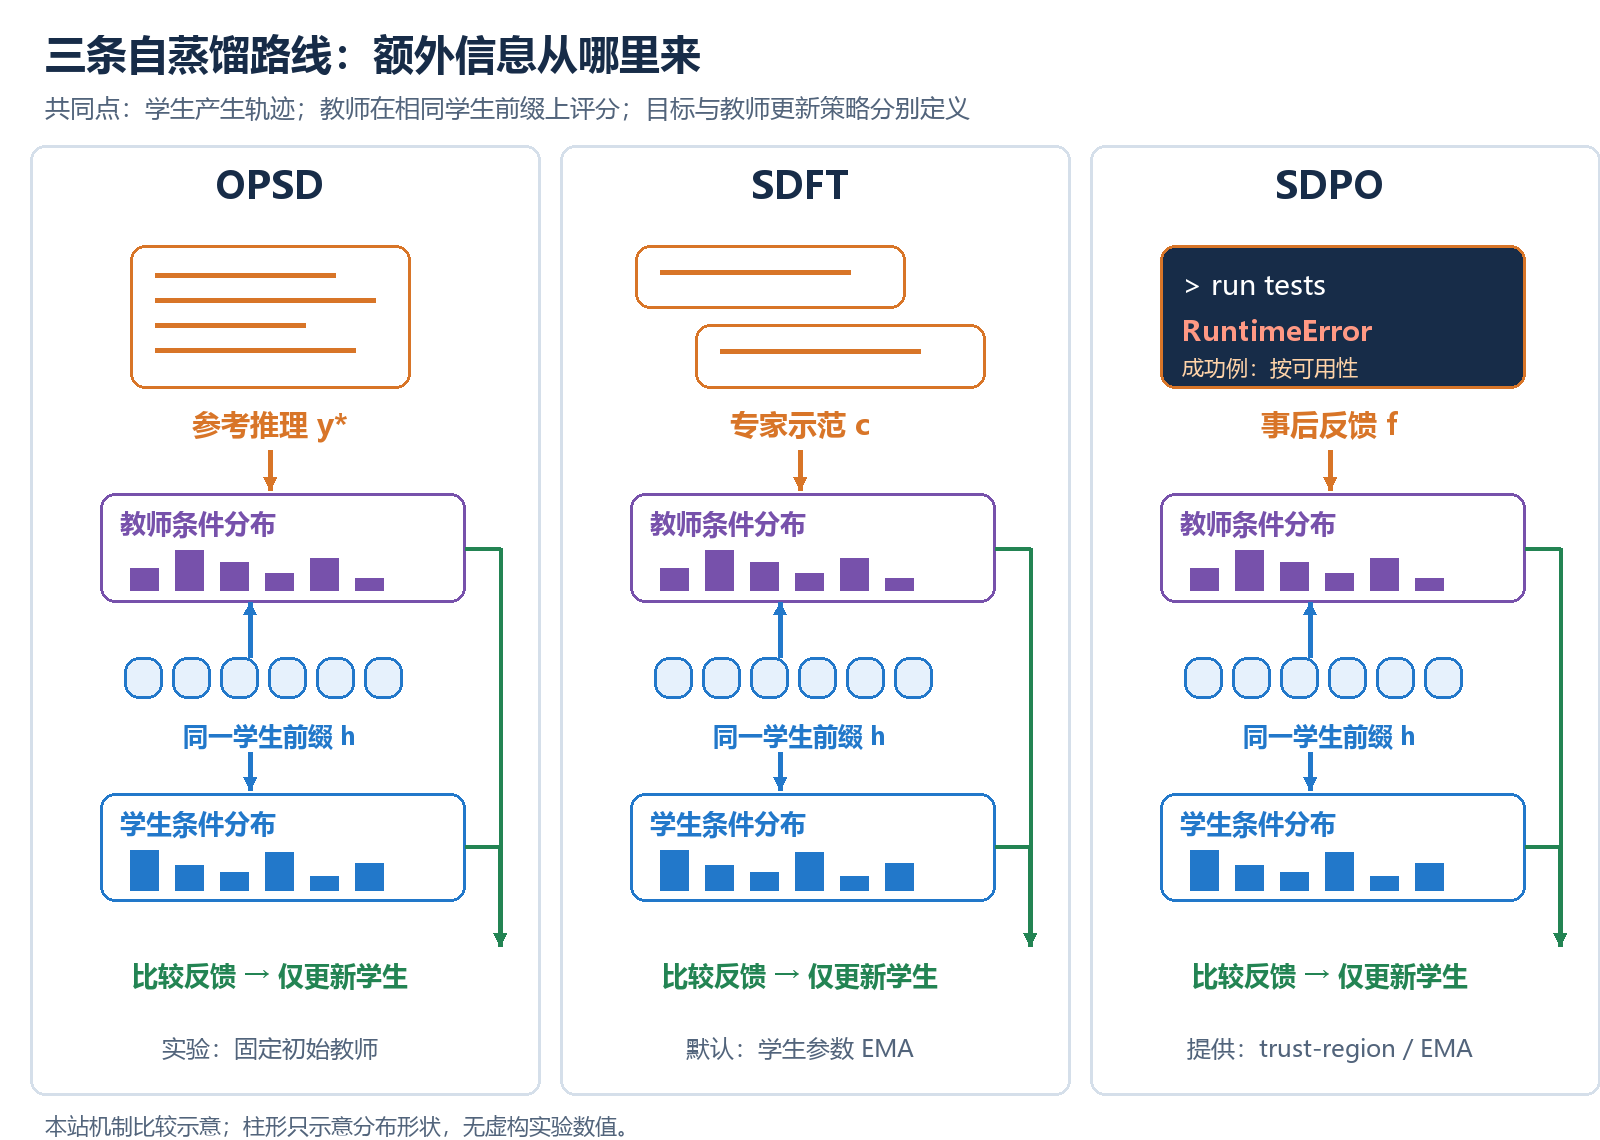
图 1|三条路线共享学生前缀,区别首先在教师多读的信息(本站示意)
图中蓝色格子都是学生已经生成的历史。它同时进入蓝色学生分布和紫色教师分布,比较发生在同一个下一 token 位置。上方橙色材料只额外送给教师:左列是参考解,中列是示范,右列是运行错误或按可用性提供的成功样本。“自”描述模型来源,“蒸馏”仍然需要可用的信息差。 它们并非没有监督地凭空制造正确性。
下文统一用 表示问题, 表示学生回答, 表示第 个文本位置之前的前缀; 为学生下一 token 分布, 为教师分布。教师在评分时多看上下文,学生的原始生成条件仍与部署条件一致。若让教师重新生成另一条答案,再按位置比较,两条轨迹可能已经走向不同分叉,便不再是图中这个共同对象。
“教师不接收本次梯度”还有另一层含义:教师评分当作固定目标,避免目标分支通过梯度迁就学生。它不决定教师下一训练步是否换参数。固定初始教师、EMA 教师和正则化动态教师,是后面必须另行检查的跨步选择。
今天学习了吗的上下文内化解读把这个共同骨架拆成三步:不带特权材料的学生先生成;教师带额外上下文 ,在原学生前缀上评分;最后逐位置比较分布。对照图 1,蓝色格子始终是同一份尝试,橙色材料只进入紫色教师。它进一步提出三个检查问题: 是什么、散度 怎样选、如何避免学生依赖部署时拿不到的材料。共同模板说明比较轴,实际 recipe 仍须分开。
kxzxvbk 的自蒸馏入口以 表达“同一模型多看示范”的信息差;龟壳的综述则用开卷指导闭卷作类比。开卷的是评分者,学生原生成条件保持不变。若教师另生成一条示范,它是另一条序列;OPSD、SDPO 这里讨论的评分却落在原学生前缀上。两者不能只按 token 序号直接互换。
| 中文读法 | 在图 1 中对应什么 | 必须保留的边界 |
|---|---|---|
| 多读上下文后“自己教自己” | 橙色材料改变紫色条件分布 | 信息更多不自动等于评分正确;教师更新另查实际配置 |
| 开卷指导闭卷 | 教师可看材料,学生首次生成不看 | 不能把参考解泄入学生 rollout,再声称检验了部署条件 |
| 把暂时信息内化到权重 | 评分信号通过学生梯度更新参数 | 具体散度、教师固定/EMA/正则选择不由这个类比决定 |
二、OPSD:看参考解,在学生位置对齐全词表
参考解帮助评分,不替换学生轨迹
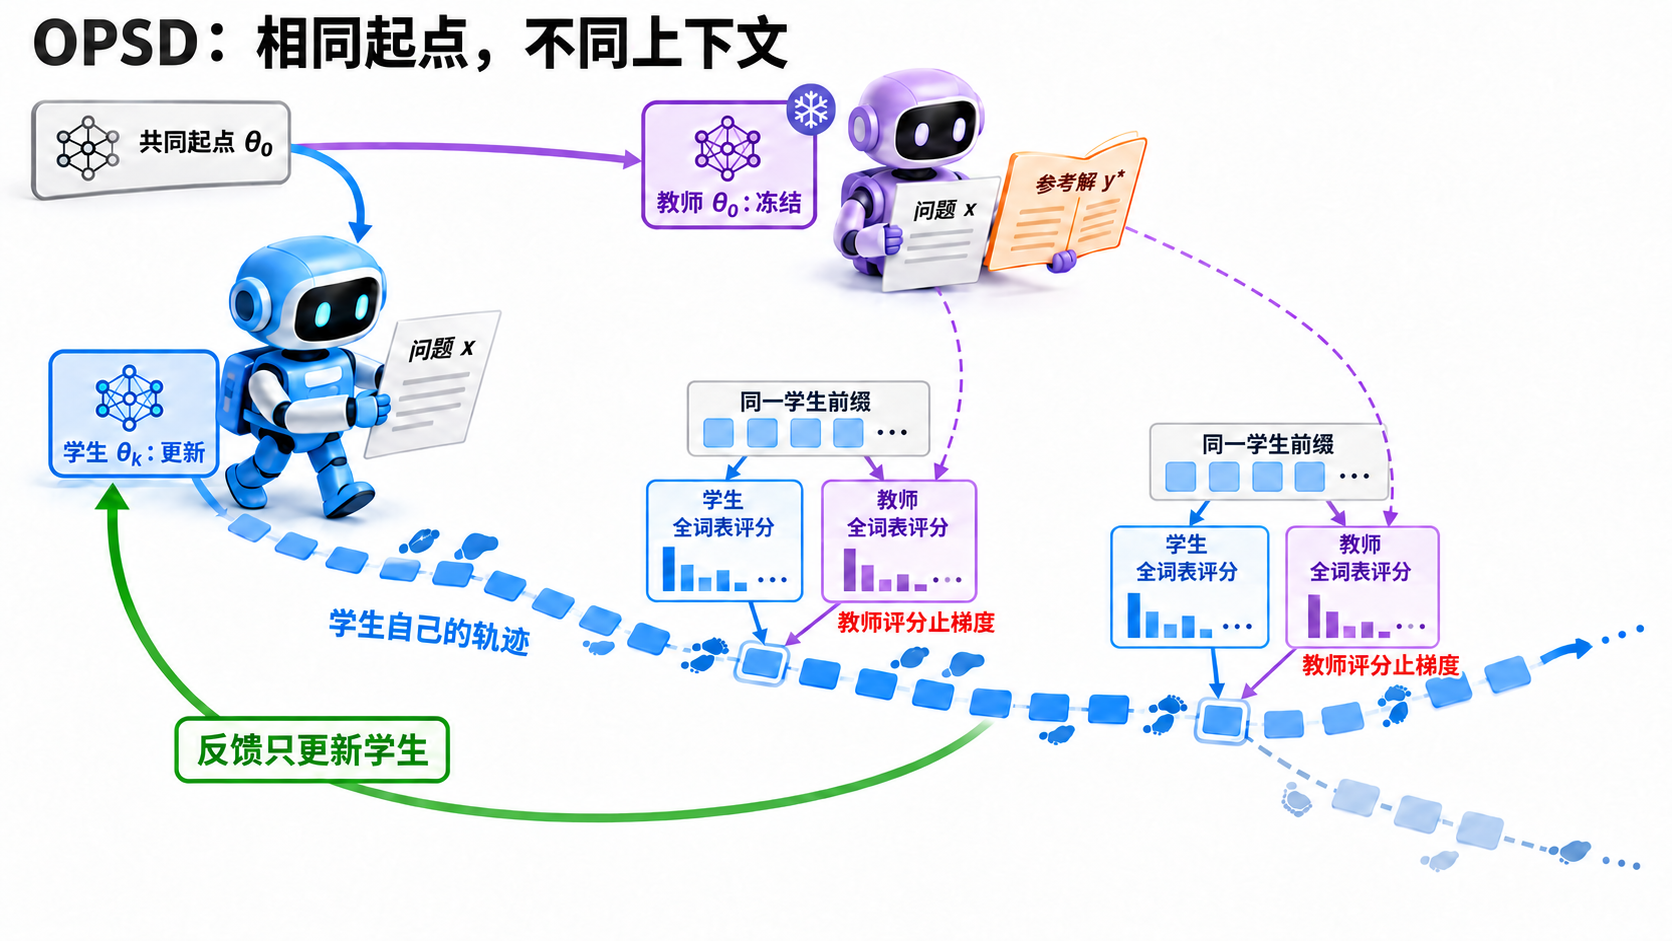
图 2|OPSD 实验教师保持初始权重,参考解只进入教师条件(原创教学图)
图中教师拿着问题 与参考解 ,学生只有问题。论文 §3 的形式化从同一模型、不同条件出发:学生为 ,教师为 。学生先产生轨迹,教师再沿同一学生前缀计算下一 token 分布。Figure 2 的教师提示虽要求理解参考解后用自己的方式解题,实际评分通过 prefill 前向完成,并不另生成一条教师推理轨迹。
这里必须接上 §4.1 的实现选择:实验将教师固定为初始策略。图中的紫卡一直是 ,蓝卡才更新为 。因此,不能把方法段“同一参数模型的两种条件分布”直接改写为实验中教师每步跟随学生同步更新。参考解可以含思维链,它就是训练时的特权信息;推理学生没有这份参考解。
完整词表与逐项 clipping
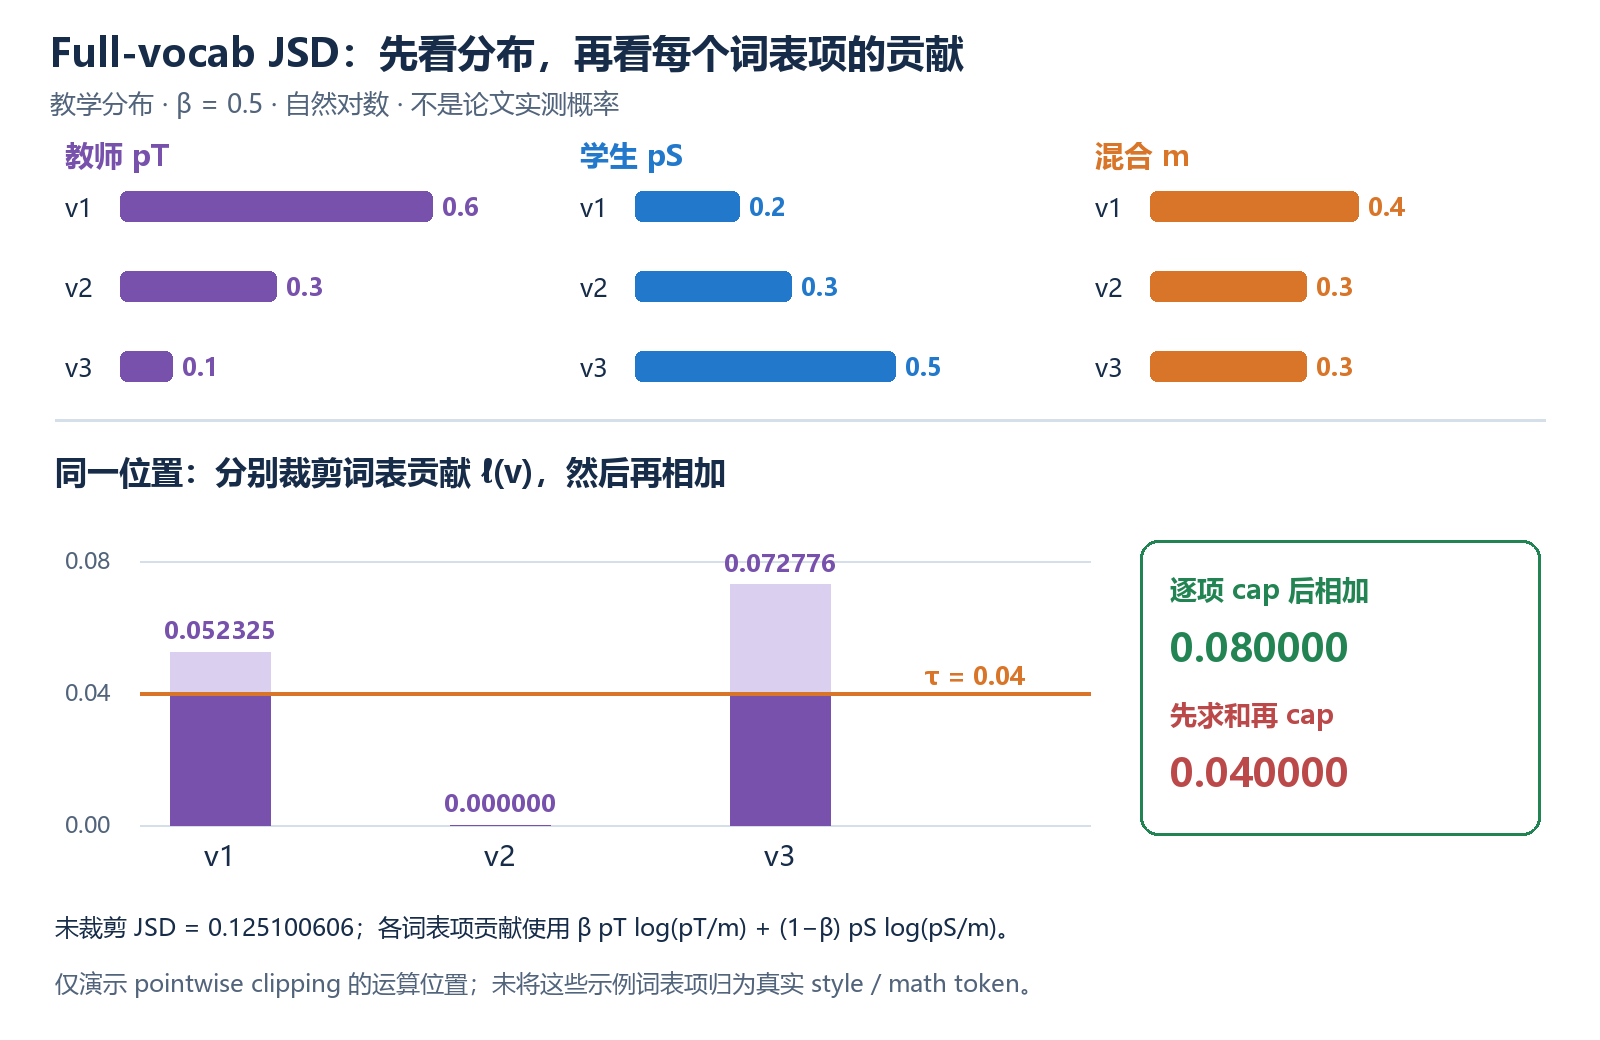
图 3|完整词表贡献先分别裁剪,再求和;概率与阈值为教学设定
设学生轨迹长度为 ,位置为 。OPSD 在每个学生前缀上比较完整词表分布,用 对轨迹平均,再在问题—参考解数据与学生采样上取期望,最小化这个差异;教师分支停止梯度。 可以选不同分布散度,其中 generalized JSD 为:
是混合权重, 是混合概率分布;, 为词表、 为词表项, 是自然对数,散度无量纲。图中取 ,教师 、学生 ,得到 。两项 KL 分别为 、,JSD 为 。
这里混合的是某个位置的输出概率,不是教师权重。它与后面 EMA 对模型参数求均值处在不同层级。图中的第二项概率两边同为 ,所以这一词表项的 JSD 贡献为零;其余两项贡献不同,正好展示完整词表监督包含了“还没采到的候选如何调整”的信息。
论文进一步对每个位置、每个词表项的贡献设上限。对生成函数为 的 f-divergence,写成:
是贡献上限。作者观察少数风格 token 的高差异可能压过数学相关 token,因此希望限制它们的主导程度。图中三个 JSD 贡献为 ;教学取 ,逐项裁剪后和为 。若先求和再裁剪,只得 ,运算已经不同。这不是 PPO 对新旧策略概率比的 clipping。 图中数值也不是论文实际超参数或模型 logits。
“Per-token”指回答中的位置,“pointwise”进一步落到该位置的词表项。即使同一个回答 token 是数学符号,其分布比较仍覆盖其他候选。图中没有给词表项贴上实测风格/数学类别;原文关于风格主导的观察,不能由这组三项教学概率代替。
OPSD 另给 sampled-token 替代目标:在实际采到的 token 上令 ,最小化 ;这里省略了前面已定义的条件, 表示停止梯度。它只看被采到的项,与主目标的完整词表匹配不同。这也是比较 X-OPD 的 token 反馈 时应保留的支持集区别,不能只见到对数差就称目标等价。
数学成绩与训练预算一起读
实验使用 Qwen3-1.7B/4B/8B instruct、OpenThoughts 数学子集至多 30k 问题—解答对,以 LoRA 在 A100/H100 上训练;SFT 与 GRPO 使用相同数据。Table 2 的原值如下,列为 AIME24、AIME25、HMMT25 与三任务平均:
| 模型 | 配置 | AIME24 | AIME25 | HMMT25 | 平均 |
|---|---|---|---|---|---|
| 8B | Base | 75.8 | 65.6 | 43.9 | 61.8 |
| 8B | SFT | 72.3 | 64.2 | 42.9 | 59.8 |
| 8B | GRPO | 76.4 | 68.9 | 46.7 | 64.0 |
| 8B | OPSD | 77.8 | 70.8 | 45.8 | 64.8 |
| 4B | Base | 74.9 | 66.4 | 42.2 | 61.2 |
| 4B | SFT | 70.2 | 62.3 | 43.4 | 58.6 |
| 4B | GRPO | 75.6 | 68.1 | 44.4 | 62.7 |
| 4B | OPSD | 76.4 | 68.3 | 46.1 | 63.6 |
| 1.7B | Base | 51.5 | 36.7 | 23.1 | 37.1 |
| 1.7B | SFT | 48.4 | 36.3 | 22.7 | 35.8 |
| 1.7B | GRPO | 51.1 | 38.3 | 23.7 | 37.7 |
| 1.7B | OPSD | 57.2 | 43.9 | 29.2 | 43.4 |
评测为 Avg@12、temperature 1.0、最大生成长度 38k;OPSD 每 20 步评估,取 100 步内最好成绩;GRPO 取 500 步内峰值,SFT 用与 OPSD 相同样本数。OPSD 三个模型的平均分更高,但 8B 的 HMMT25 是 GRPO 更高,不能说逐任务全胜。
作者报告 OPSD 每题单 rollout、1024 sampled tokens,100 步内收敛;GRPO 为每题 8 条、每条 16k。评测的 38k 上限、训练采样预算和 checkpoint 选点是不同口径。作者还在当前数据上观察到 GRPO 后期熵塌缩、组内奖励标准差常为零;SFT 的退化被归因于简短参考解缩短推理。它们是当前设置的观察与归因;较早 token 可能处在关键分叉的解释,原文也仍是推测。
三、SDFT:从示范学新技能,同时观察旧能力
EMA 教师与理论、实践的两层目标
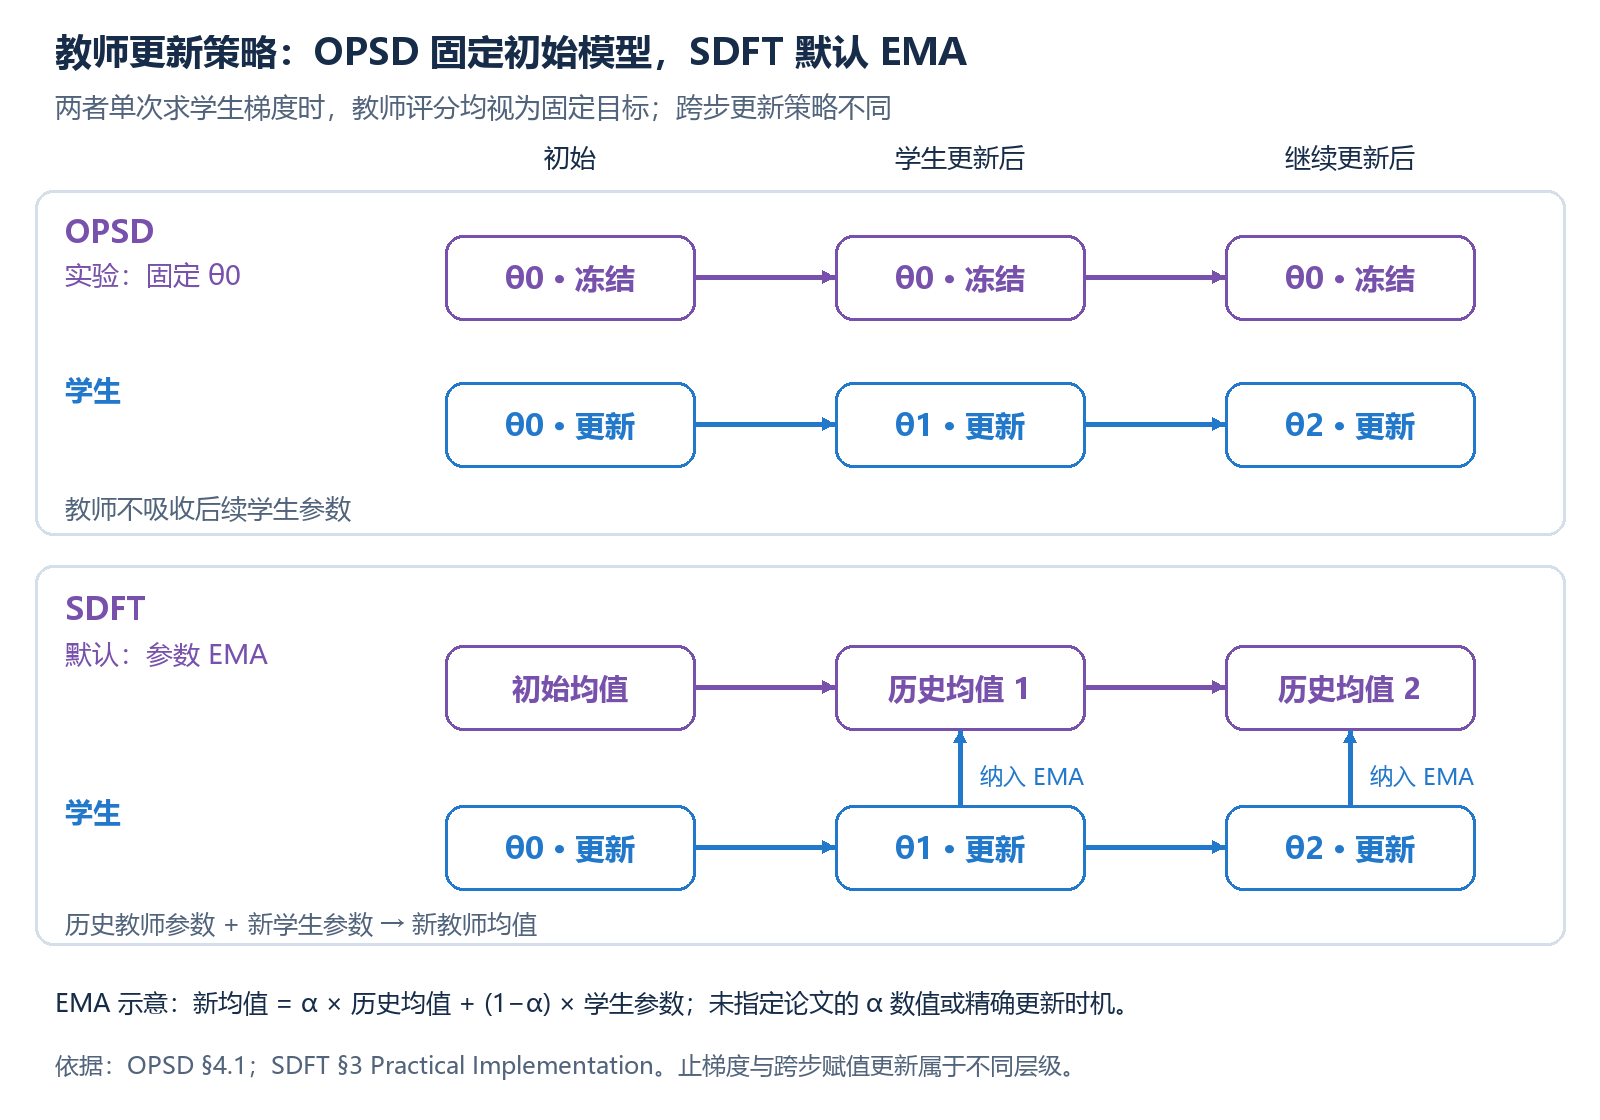
图 4|单步止梯度不妨碍跨步通过 EMA 更新教师(本站示意)
图中上排教师一直保持初始权重,下排 SDFT 教师则把历史教师均值与新学生参数混合。EMA 是参数的指数移动平均;图没有指定论文的系数或精确赋值时机。论文 §3 的 Practical Implementation 明确默认采用 EMA,因此不能沿用 OPSD 的固定初始教师描述。
SDFT 的教师多看专家示范 ,学生仍只读 并产生回答。理论目标是完整序列的 reverse KL:
这里 是整条生成序列, 为学生参数,教师分布在求学生梯度时固定。§3.1 的逆 RL 解释依赖 In-Context Assumption:示范条件策略近似最优下一策略。这个假设让条件概率变化可以解释为隐式奖励,但不是任意模型都自动满足的定理前提。
具体地,带 trust-region 正则的 RL 最优更新可写为 。 是策略迭代索引, 为奖励, 为正则强度;移项得到 ,其中 是对固定问题不随回答变化的归一化项。再用示范条件策略近似 ,才得到“看示范前后的 log 概率变化”这一奖励解释。若上下文并未把策略推向更优答案,关键替换便不可靠。
更关键的是,实践段明确说 Forward KL 的效果最好,方向为 。因此,论文的 reverse-KL 理论论证、EMA 参数实现与 forward-KL 实际选择必须分别写清,不能合成“已经证明实际 recipe 等价于理想 RL 更新”。
Figure 4:学到新技能,旧能力有没有掉
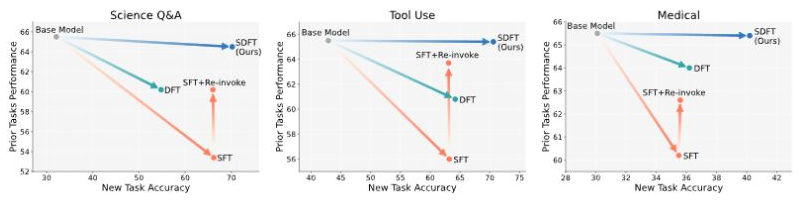
图 5|Shenfeld、Damani、Hübotter、Agrawal,SDFT Figure 4(裁切),CC BY 4.0
三个面板横轴是新任务准确率,纵轴是旧能力平均;每一点是一份训练模型,右上更理想。SFT 的箭头向右也向下:学新任务的同时,旧能力下降;SDFT 在这些面板保持较高纵坐标并向右移动。DFT 通过重要性加权处理离线数据,SFT+Re-invoke 则在 SFT 后补充 on-policy 蒸馏来恢复旧能力,二者展示另一些折中。箭头不是每一步训练轨迹,面板轴范围也不同,不能按箭头长度计算跨任务提升倍率。
默认模型是 Qwen2.5-7B-Instruct,各基线先做超参数扫描,再选目标验证成绩最高模型。三个技能分别是 SciKnowEval Chemistry L3、ToolAlpaca 和 HuatuoGPT-o1(stage1 训练、stage2 评估)。旧能力为 HellaSwag、TruthfulQA、MMLU、IFEval、Winogrande、HumanEval 六项平均。这张图支持所列任务的新旧能力权衡改善,并不保证所有旧技能完全不变或无限任务序列中永不遗忘。
新知识不是旧技能,指标也要换
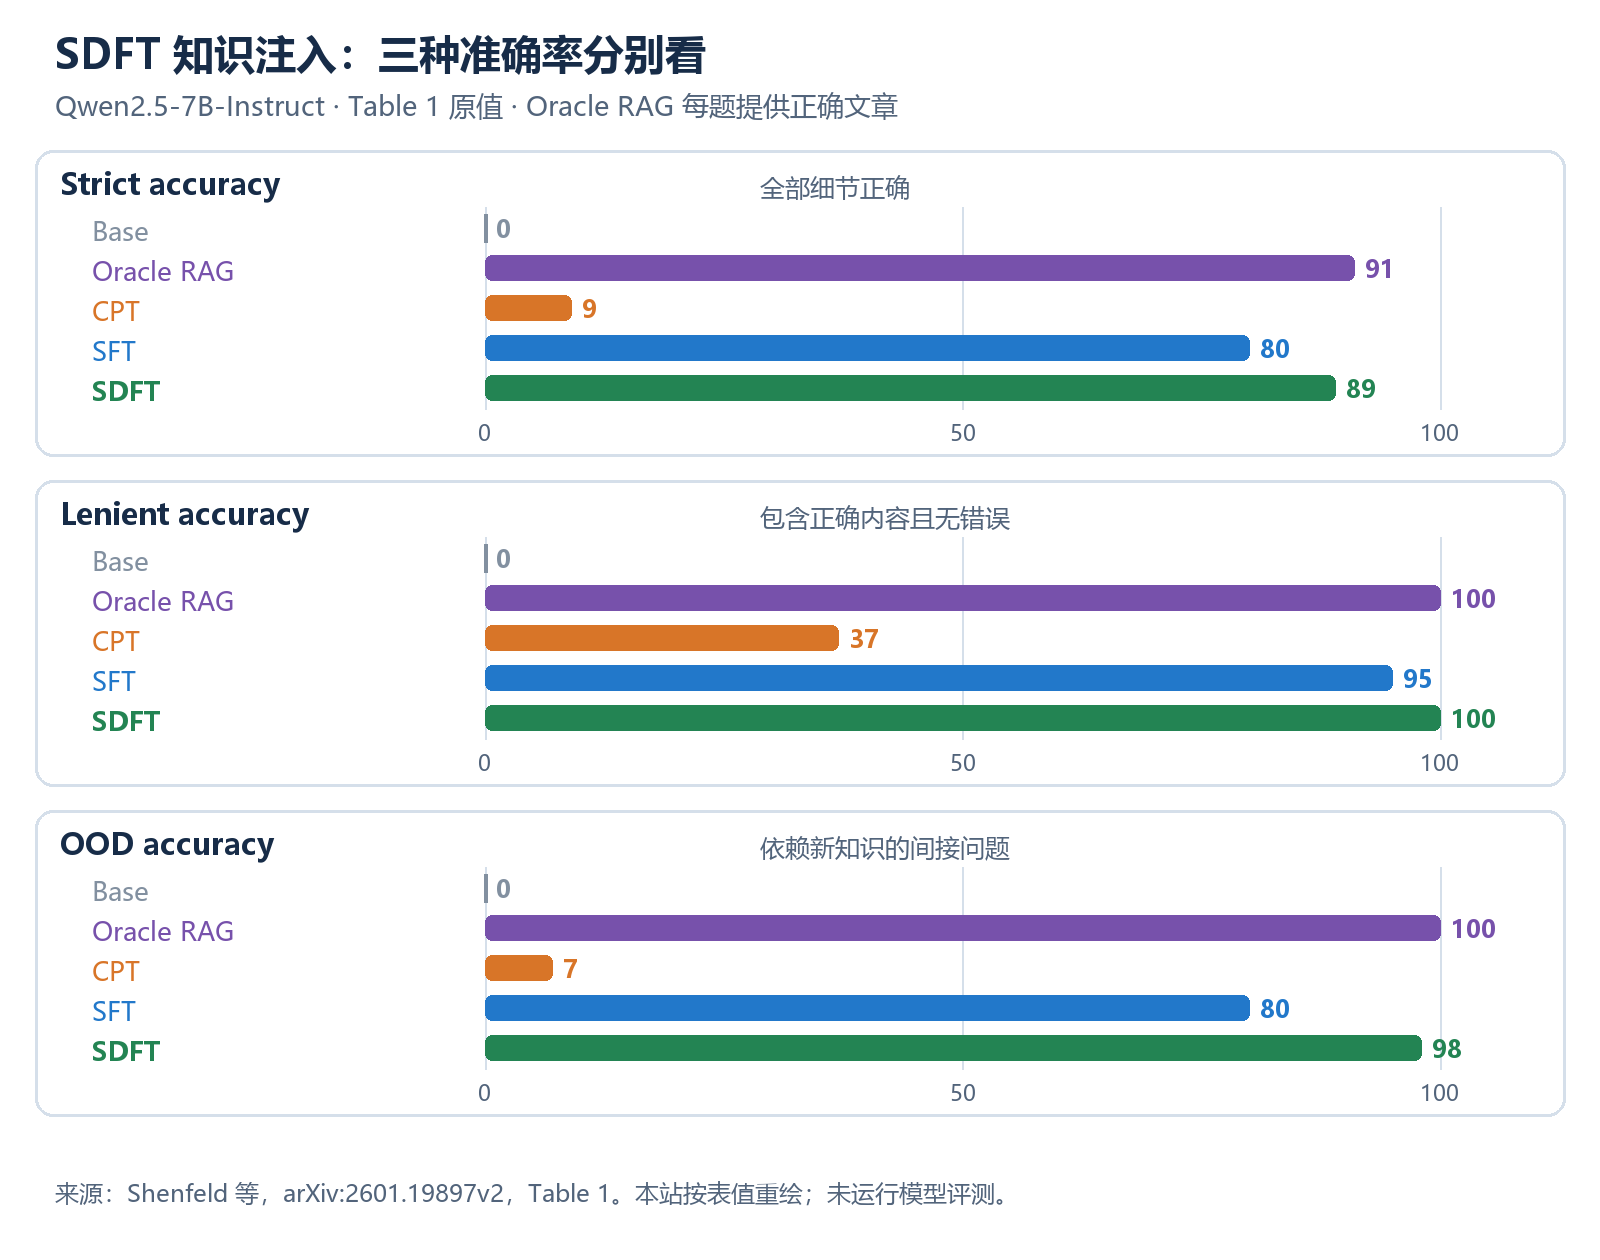
图 6|Table 1 的三种准确率分别比较,Oracle RAG 每题获得正确文章
知识注入实验使用约 200k tokens 的 2025 自然灾害 Wikipedia 文章,生成 QA 后数据约为原语料五倍。Strict 要全部细节正确;Lenient 要包含正确内容且无错误;OOD 问题间接依赖新知识,检验知识是否能用于不同问法。图中的 Base 为 ,只说明这套新知识评测结果,不能解读成模型通用能力为零。
按 Strict/Lenient/OOD 顺序,CPT 为 ,SFT 为 ,SDFT 为 ;SDFT 相对 SFT 的绝对点差是 。CPT 是在原文章上做持续预训练,SFT 则在构造的 QA 上训练。Oracle RAG 为 ,但它的检索器对每题都提供正确文章,是受控 oracle 条件,不是普通 RAG 的可达保证。三列也不能相加成一个通用准确率。
四、SDPO:用环境反馈重评原始尝试
先尝试,再反馈,最后重评分
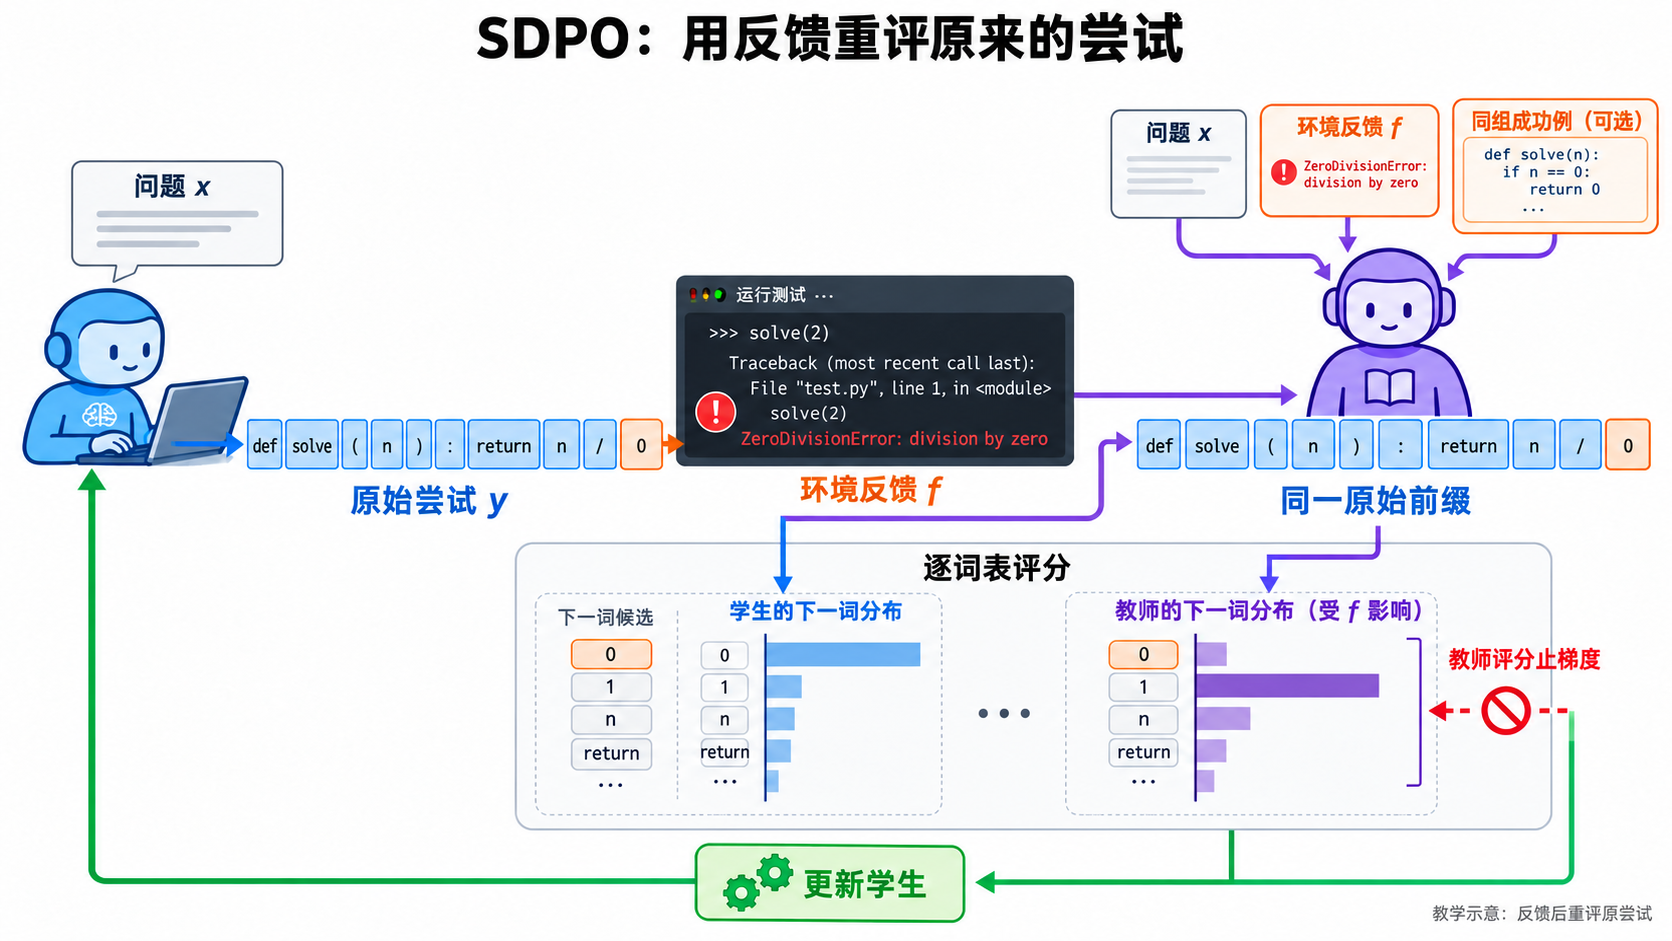
图 7|除零示例为原创教学图;教师重评分原尝试,不生成替代答案
左侧学生先写出代码,之后才看到运行结果。右侧教师读问题 与反馈 ,在原来的学生前缀上重新计算概率。图中除数 被反馈指出,教师降低这一候选的评分;两侧蓝色代码条保持原样,没有偷偷换成成功答案。数值分布形状只作机制示意。
Lei Tian 的 SDPO 解读把参考答案、专家示范、文档与环境反馈放到同一张信息来源表中,适合作为这张图的读法。对本节而言,关键是反馈能否改变对原尝试的局部评价。运行错误进入的是右侧教师条件,没有回到左侧让学生首次作答时预先知道错误。这种信息差不能被简写为教师总是更强,也不能保证任何反馈都有用。
降低除数 的概率只演示定位局部错误,并不证明替换成 就能满足整个任务。反馈后的分布是否更好,依赖模型能否理解错误与原题;这也是后面弱 ICL 与反馈质量限制的具体落点。
原文 Table 2 对反馈材料还有具体选择:若同组已有成功尝试,可加入成功解;若原尝试失败且没有成功解,加入环境输出;若原尝试本身成功,它自身可充当 correct solution。assistant 侧始终放原响应供重评分。因此,图中的环境输出与同组成功例表示可用信息类型,不表示实际 prompt 永远同时包含两者。它也不是先把反馈塞给学生、再让学生的首次生成变容易。
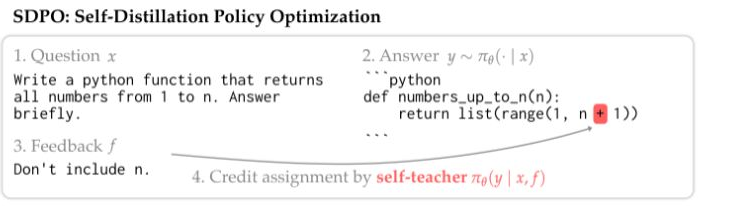
图 8|SDPO 原论文 Figure 4(裁切),CC BY 4.0
原图给出另一种更直接的观察:反馈要求结果不包含 ,红色落在原代码的 附近,表示该处教师相对学生的 log 概率比为负;白色区域接近零。它展示反馈如何在原尝试中定位信用,而非把所有 token 一律判为错误。这是采到 token 的诊断着色,也不意味着主损失只匹配这一格。
Full-vocab KL 与 top-K 加尾部
主目标沿原回答位置求和:
为按可用性构造的反馈, 遍历原回答位置, 阻断教师分支梯度。这里匹配的是每个位置的词表分布。§2.1 虽将梯度解释为 logit 层的信用分配,它仍不同于 GRPO 把一个回答级标量 advantage 沿该条回答的已采 token 广播。
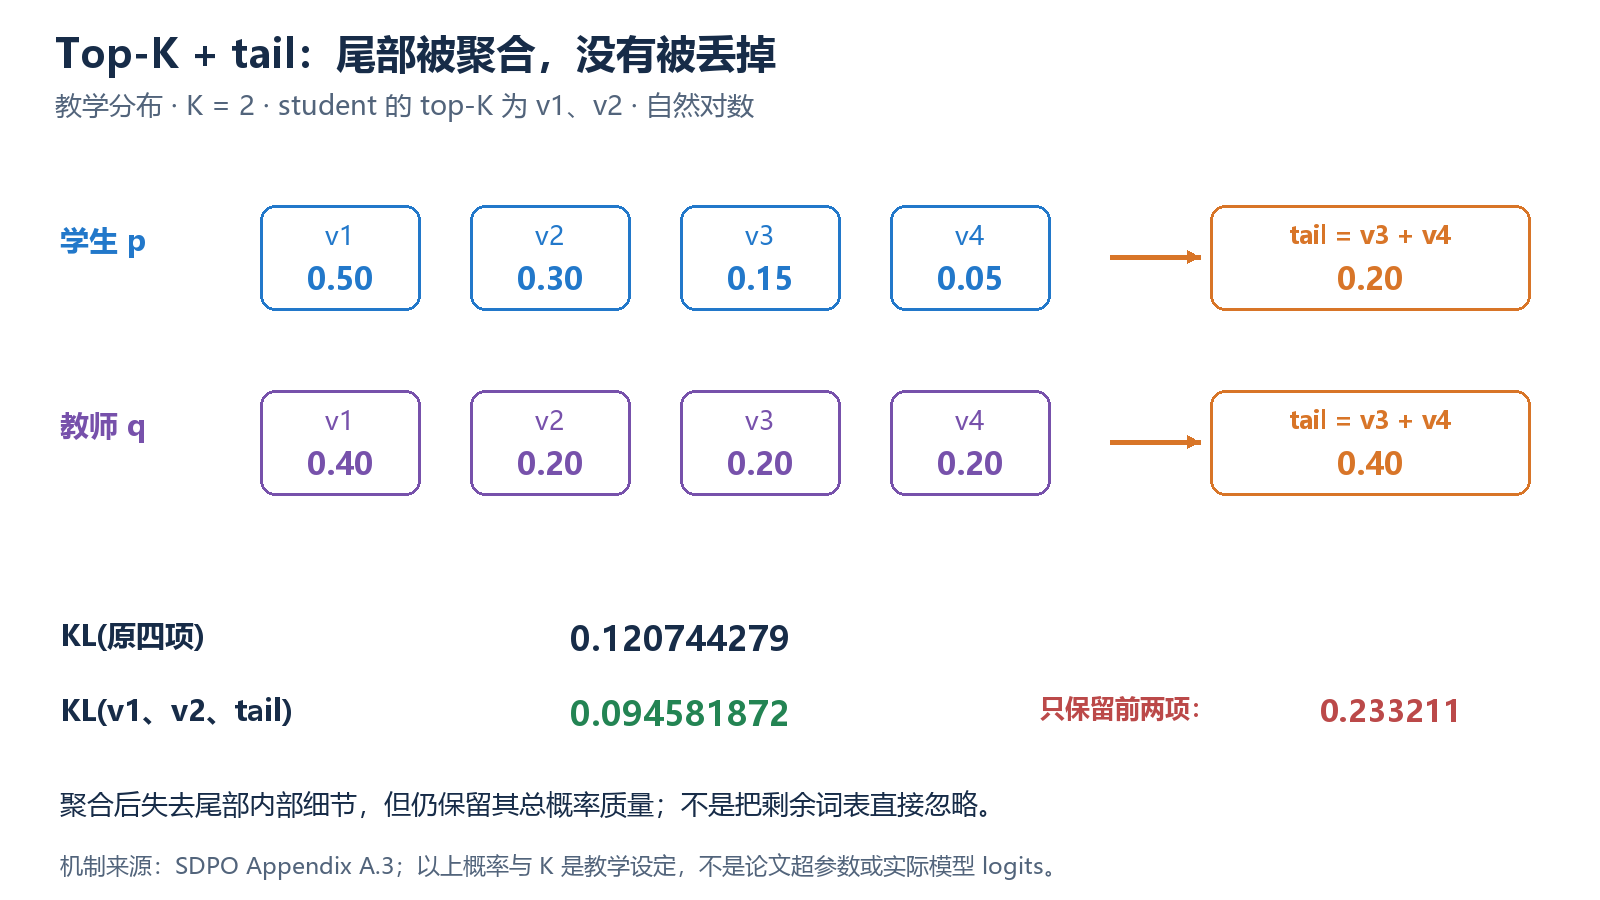
图 9|保留 top-K 单项与尾部总概率;教学设定为 K=2
为节省显存,附录 A.3 近似处理学生 top-K,并把剩余概率聚合成 tail。令 为学生选出的 K 项,当前位置学生概率为 、教师为 ,则 , 同理。近似 KL 保留:
图中教学分布为 、,合并后 tail 为 。完整 KL 为 ,聚合 KL 为 ;若把尾部贡献直接丢掉,前两项之和却为 。聚合会失去尾部内部细节,但保留其总概率,不能写成“只看 top-K,其余忽略”。
tail 是多个候选概率质量的合并,通常不是词表里真的新增了一个 token。因而需要区分三种支持集:完整词表、top-K 加尾部聚合、仅实际采到的 token。它们各自保留的信息不同,不能只用“token 级监督”这一个名字抹平差异。
附录 A.1 还区分了 token 层目标与完整 sequence-level 目标:后者另考虑前缀分布依赖产生的梯度项。作者实验未见足以抵消额外复杂度的可测增益,因此不能把两种梯度无条件当作同一个式子。
丰富代码反馈下的结果
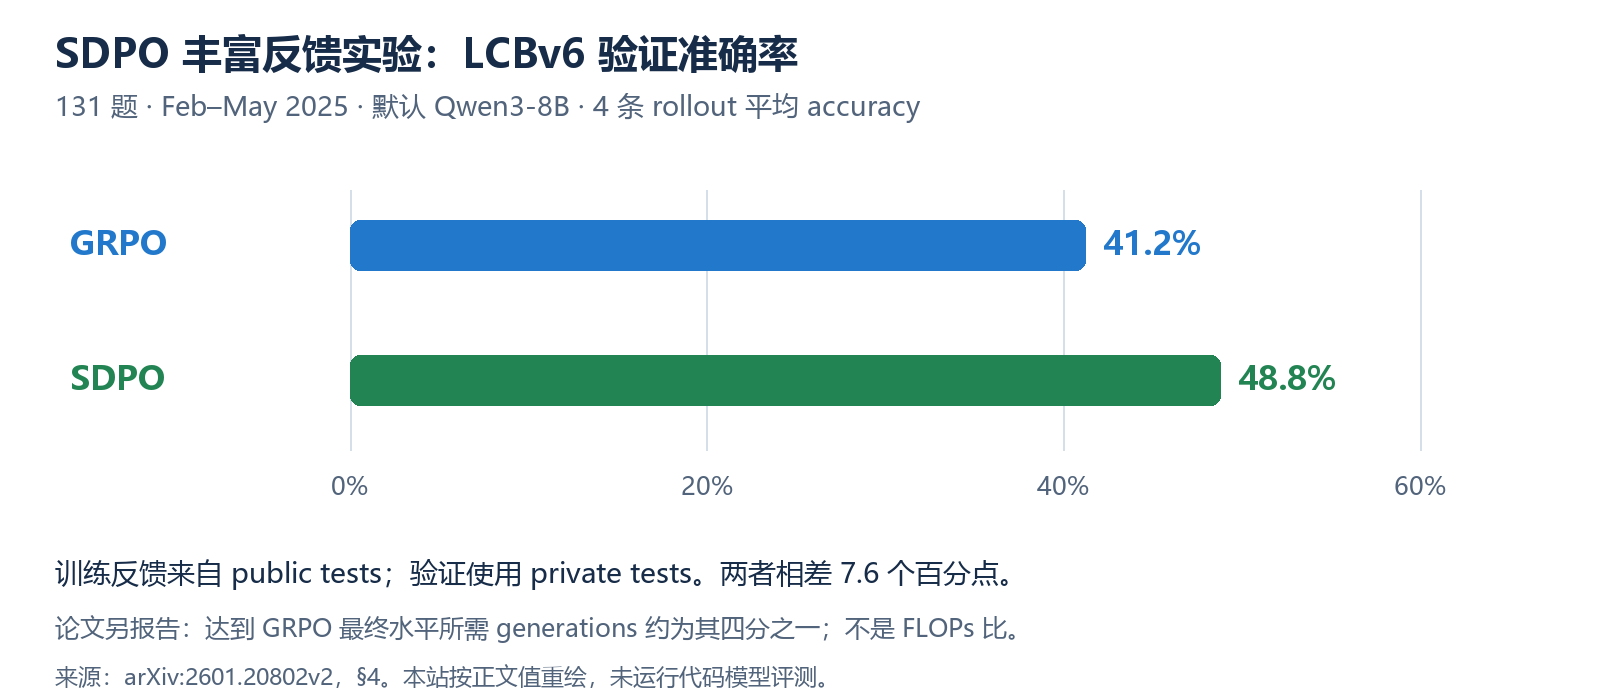
图 10|LCBv6 结果与公开测试/私有测试协议(按 §4 正文值重绘)
论文使用 LCBv6 中 2025 年 2—5 月发布的 131 道题,public tests 提供训练反馈,private tests 用于验证;默认 Qwen3-8B,指标为四条 rollout 的平均 accuracy,并非 pass@4。最终 SDPO 为 48.8%,GRPO 为 41.2%,相差 7.6 个百分点。作者报告,SDPO 到达 GRPO 最终水平所需 generations 约为其四分之一;这限定该实验协议,不能翻译为总 FLOPs 减少四倍。
五、教师更新、成本与自举边界
三种跨步选择不能混成一种默认配置
回看图 1 下方:OPSD 实验固定初始教师,SDFT 默认 EMA;SDPO 附录 A.2 则提供两种稳定动态教师的方式。显式 trust-region 在初始与当前教师的 log 概率间混合,可写成 ,其中 为混合系数,最后需归一化;另一方式直接对参数做 EMA。这里保留两种实现的差别,不把 SDPO 简写成默认 EMA。
参数 EMA 需额外保存教师参数;显式 trust-region 需额外的初始教师 log-prob 计算,若初始模型已用于显式 KL 正则,则不必额外常驻另一份。EMA 参数平滑本身省去的是这次参考分布计算,教师重评分的成本仍在。它们都与本次教师输出止梯度兼容。检查一个实现时,应分别问“谁反传”“教师哪一步换参数”“新目标离初始策略多远”,而不是用“同一个模型”代替这些选择。
生成便宜、训练便宜与总成本便宜是三回事
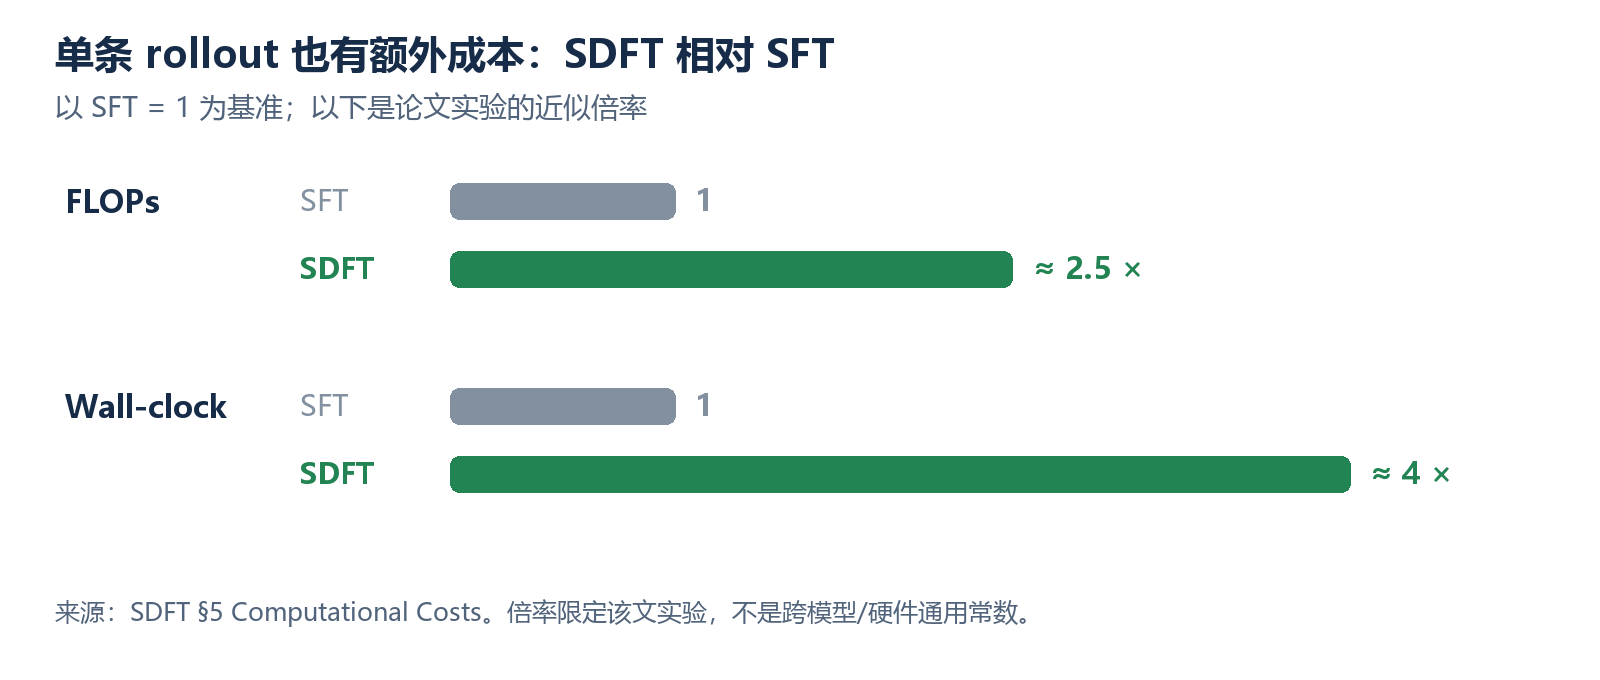
图 11|SDFT 单 rollout 仍带来额外生成与评分成本;倍率限论文实验
OPSD 的 与 GRPO 的 是采样配置;SDPO 的四倍是达到指定水平所需 generations;SDFT 则直接报告相对 SFT 约 2.5 倍 FLOPs、四倍 wall-clock。三个量的分母不同,不能拼成通用效率排行。教师 prefill、完整词表评分、优化与显存也要计入实际成本。
龟壳的 OPSD 简述用一个较短的成本比例帮助建立直觉;实际引用时必须补齐分母。少生成几条轨迹,不直接等价成同倍数的端到端训练成本下降。本篇因此保留前面的 OPSD 采样配置、SDPO generations 与本图 SDFT 的实测成本三种单位,教师评分和训练仍需要分别计时。
SDFT 将自己定位为与 on-policy RL 互补的学习方式,也可作为后续 RL 初始化;这不等于替代全部 RL。SDPO 的教师重评分同样有额外计算,小模型、短序列时,生成较便宜,这部分成本占比反而可能更突出。
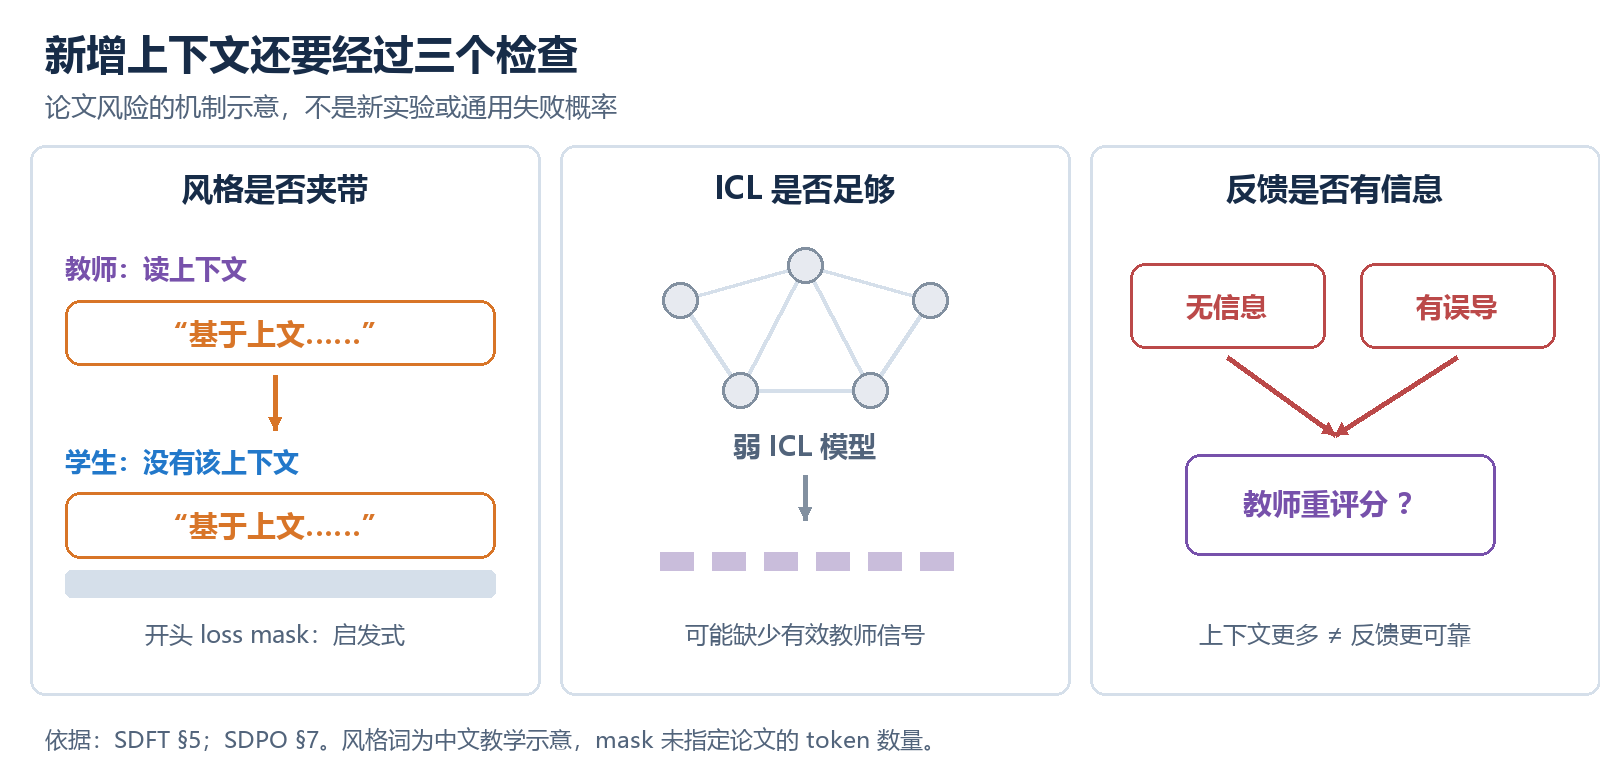
图 12|信息更多还要通过风格、模型能力与反馈质量检查(本站示意)
最后要检查教师的信息差是否真的有用。SDFT 观察到学生可能学会引用“上文”的风格残留,尽管部署时并没有那段文本;mask 开头若干 token 的 loss 是有效的启发式,作者并未将它视作根治方案。弱 ICL 小模型可能给不出有用教师,从非推理模型转成显式 CoT 行为也有困难。SDPO 同样报告弱模型可能不如 GRPO;无信息或误导反馈可能无法带来有效学习。
Lei Tian 的文末讨论还把 Biology 差异列为待解释问题,并明确将“成功样本多样性较低、教师被样本锚定、熵收缩”等原因标为作者推测。它们可以转成研究假说,不能作为已证实的 SDPO 失败机制。若要检验,应分别观察反馈覆盖、教师条件分布和学生多样性,再做受控反馈对照;使用同一模型本身不构成无遗忘保证。
这些边界让比较落到具体问题上:是否有参考推理或示范,是否能取得可信环境反馈,学生的 ICL 能力能否把新增上下文转成更好的分布,以及成本是否按一致口径计算。本文只复核论文材料、概率算例与图表算术,未运行模型训练复现;更专门的稳定性问题可继续读 自蒸馏的反馈与失败机制。
正在连接 GitHub 评论…