10|GPT、Claude、Gemini 与 DeepSeek:前沿训练的公开证据
训练信号可以来自文档、示范和环境反馈;它们是否改善具体型号,要回到原始材料的结构与对照来看。资料范围仍以2026-10-08为基线。
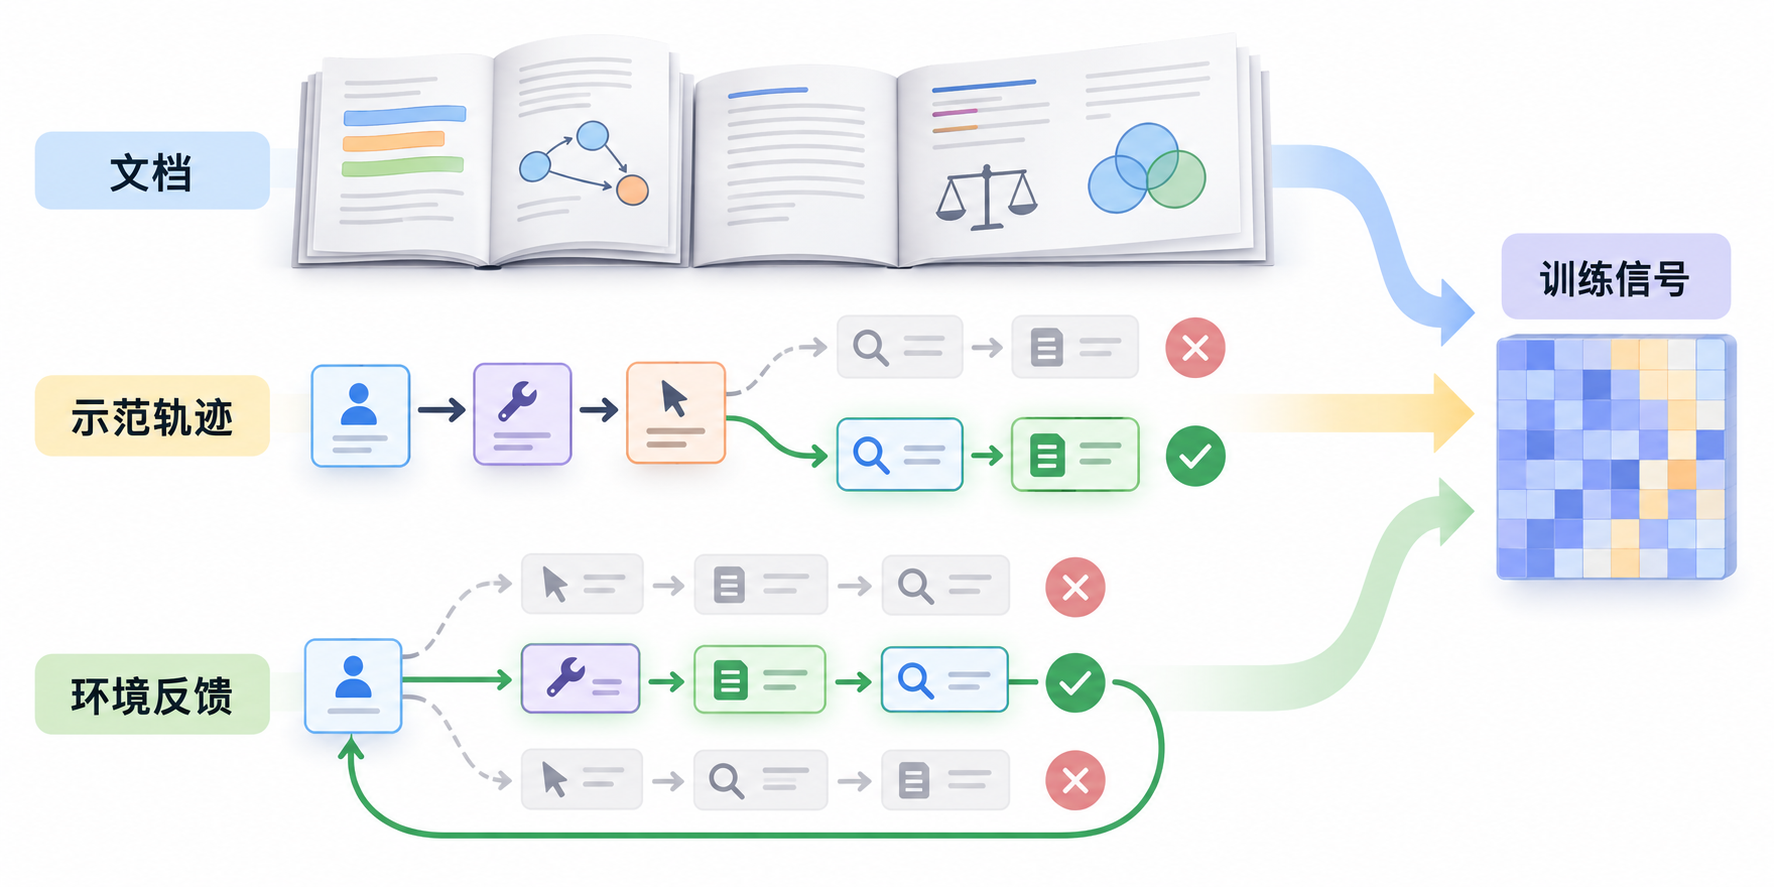
图 1|文档、示范轨迹与环境反馈承担不同职责(原创教学示意)
阅读路线:先分清型号、访问方式与证据等级,再按厂商读取“直接披露—历史机制—未知边界”,最后控制系统与预算的混杂因素。本页保留 2026-10-08 的资料核对日期;后续产品变化不由这份留存材料推定。
本页目录:1. 证据对象与引用边界 · 2. 各厂商的公开训练案例 · 3. 比较条件与可回答的问题
前面解释了训练可以怎样进行。本篇回答更严格的问题:具体商业型号究竟公开了哪些训练信息,这些信息能够支持怎样的结论? 资料核对日期为 2026-10-08。“当前顶级”不是一个固定总榜:代码、科学、视觉、长任务、延迟和成本形成不同的比较轴,部署权限与推理预算也会改变实际结果。
模型卡说明训练方向;完整可复现配方还需要数据、配置、实现、权重和实验记录。 本专题尽量讲清已经公开的机制,不用传言填补闭源模型的内部细节。
1. 证据对象与引用边界
1.1 型号、访问方式与证据不能混用
型号、访问方式与原始证据索引
| 对象 | 当前研究范围 | 能直接引用的训练证据 | 需要保留的未知 |
|---|---|---|---|
| OpenAI GPT-6 Astra、GPT-6.1 Sol | Astra 是旗舰;Sol 是较经济的前沿型号 | Astra 系统卡;Sol 训练说明引用 Astra | 精确结构、参数、数据量与比例、完整优化器和 RL 实现 |
| Anthropic Claude Opus 5.5 | 首个已发布的 Claude 5.5 系列型号;官方定位为新的领先型号 | 透明度中心、系统卡入口、对齐研究 | 全部权重结构、完整样本集与奖励配方 |
| Google Gemini 4 Argon | 新前沿型号,首先向 Fairwind 计划的受信任网络防御组织开放 | 官方发布与安全部署说明 | 完整训练与架构细节;不能用 Gemini 3 的结构替代 |
| Google Gemini 3 Pro 等公开模型卡 | 用作具体可核实的历史/同系列机制案例 | 模型卡披露 sparse MoE、原生多模态、后训练 | 不能将已知细节自动外推至 Argon |
| DeepSeek V4.1 Flash | 开放权重与较详细报告的训练案例 | V4.1 报告、模型权重与配置 | 原始大规模训练集与全部数据筛选过程仍非完全开放 |
型号定位与入口分别见 OpenAI 模型文档、Claude Opus 5.5 发布页、Gemini 4 Argon 官方发布、DeepSeek V4.1 报告。这里没有把“最新公开宣布”“人人可用”和“所有任务最强”当成同一件事。
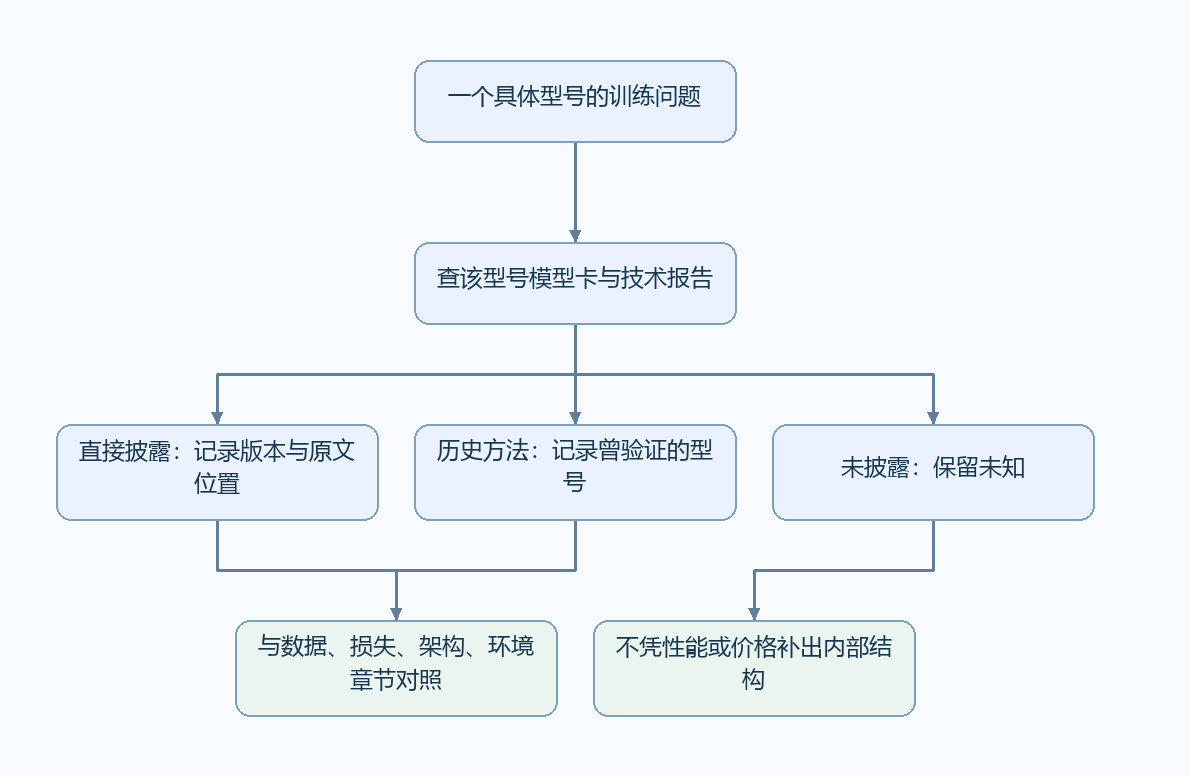
图 2|从具体型号到训练结论的证据路径(教学自绘)
2. 各厂商的公开训练案例
2.1 OpenAI:预训练基础、推理 RL 与行为训练
2.1.1 GPT-6 Astra 与 GPT-6.1 Sol 的直接披露
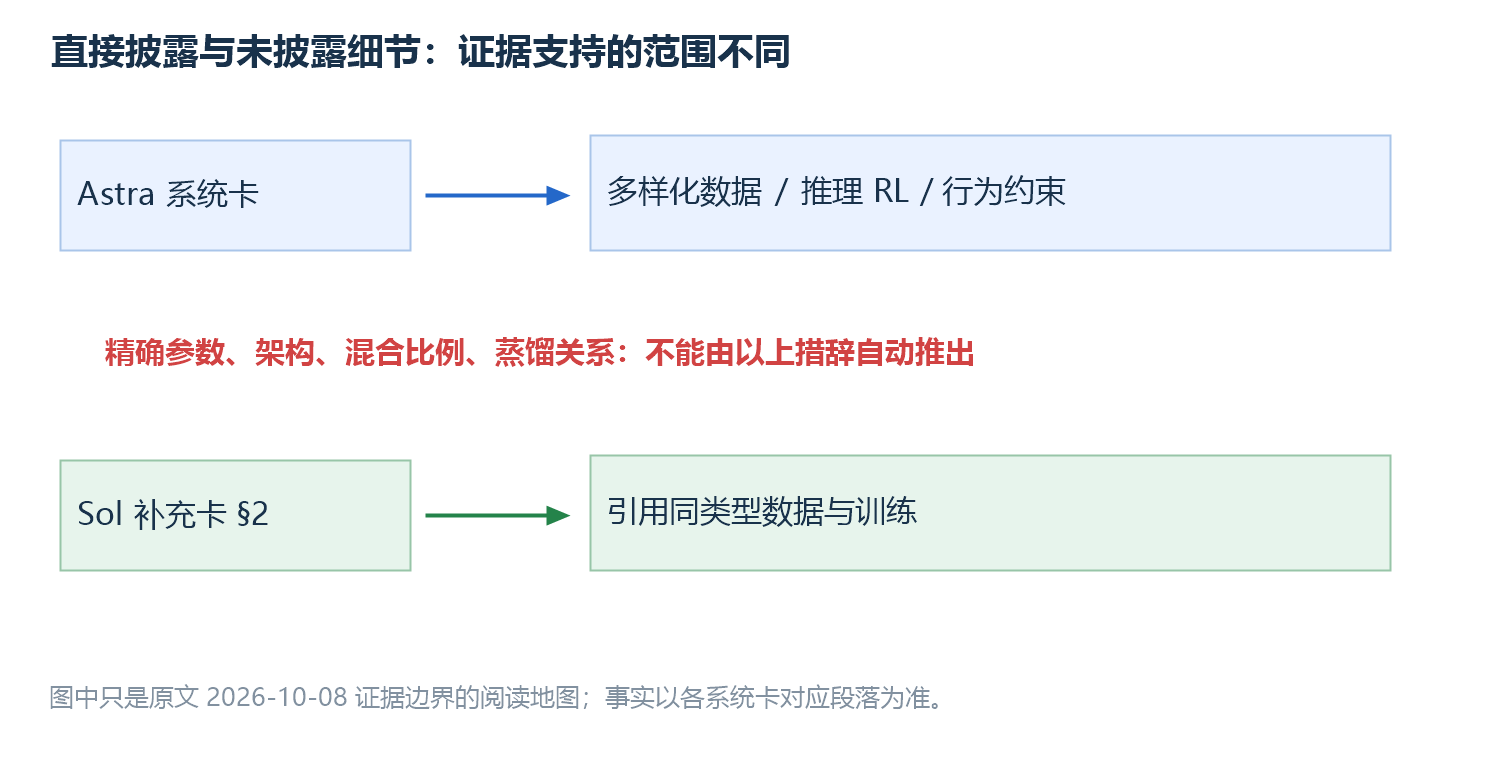
图 3|Astra 与 Sol 披露范围的阅读地图
图中上下两行对应不同来源;绿色的“同类型”连接的是训练描述,不能延伸为权重、架构或蒸馏关系的等号。
Astra 系统卡说明它在多样化数据上训练,数据处理包含降低个人信息的过滤;推理模型通过强化学习改善思考策略、尝试不同路径和识别错误。对齐训练还覆盖遵守约束、避免欺骗和未经授权的行为。这支持“知识学习、推理能力与行为约束共同训练”的解释,但系统卡没有给出足够信息重建所有 minibatch 和更新步骤。GPT-6 Astra 系统卡
Sol 的补充卡第 2 节明确指向 Astra:采用同类型的数据与训练。“同类型”不能推出相同基座权重、参数量、MoE 结构或 Astra→Sol 蒸馏关系。 发布页说 Sol 在许多任务接近 Astra、价格更低,这描述产品结果;它没有说明成本改善究竟来自缩小模型、结构变化、数据优化、后训练或服务工程中的哪一种组合。Sol 系统卡、Sol 发布说明
2.1.2 用公开研究理解推理训练
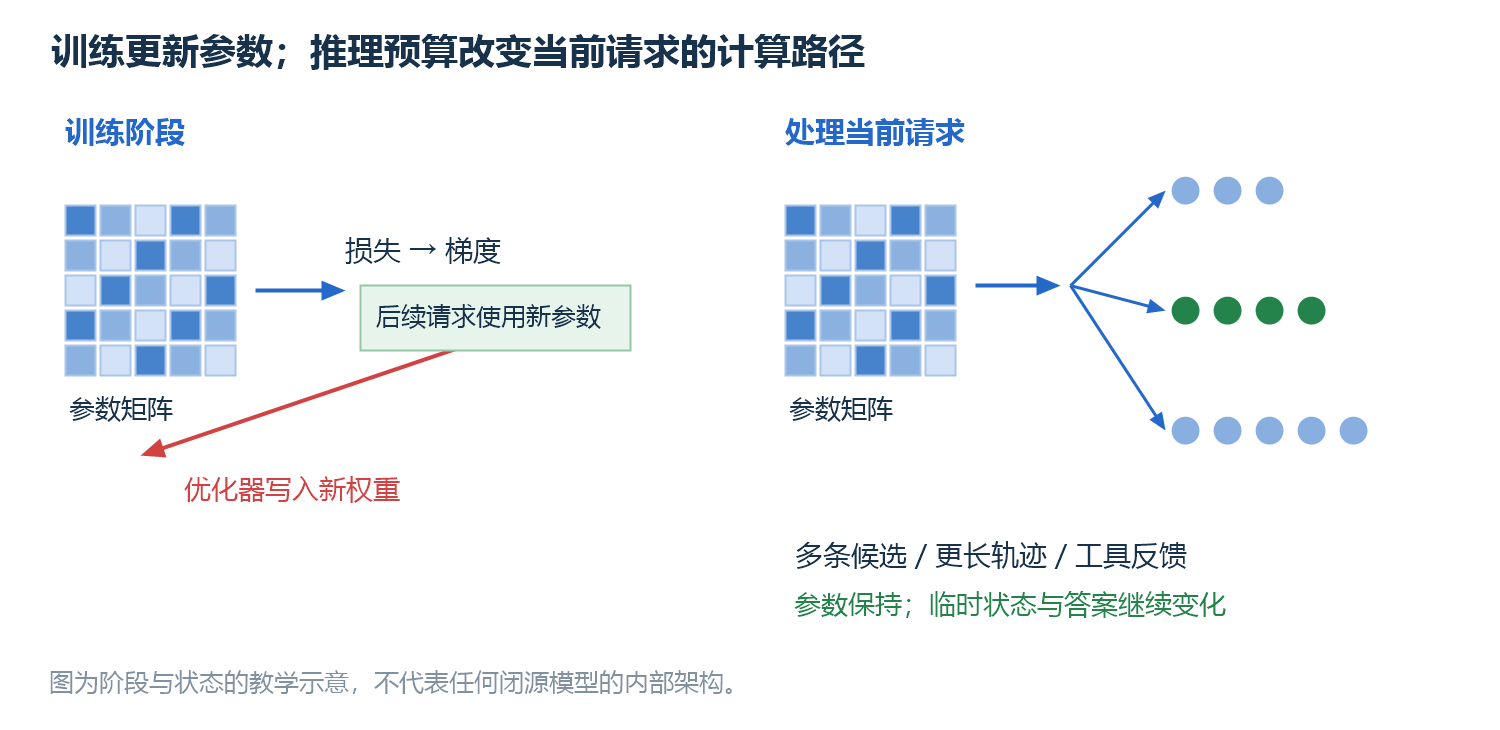
图 4|训练时改变参数,测试时使用额外计算(教学示意)
左侧是训练计算,右侧是同一参数下的请求计算;历史研究可以说明这两条轴,不能由此确定后续型号使用的具体优化算法。
OpenAI 的 o1 研究说明验证了两个增长方向:增加训练时的 RL 计算,以及增加测试时的思考计算。其训练鼓励模型发展更有效的推理过程,而非只在提示词中临时要求逐步解释。阅读这项历史证据时,应保留 o1 的型号边界;它帮助理解路线,不能证明 GPT-6 的确切 RL 算法就是 PPO、GRPO 或某个具体变体。Learning to reason with LLMs
Deliberative Alignment 的公开研究则把安全规范带入训练:构造涉及规范理解的样本、监督微调,再用强化学习改善规范应用。这解释了为什么安全训练可能需要推理,而不仅是关键词拒绝。Deliberative Alignment
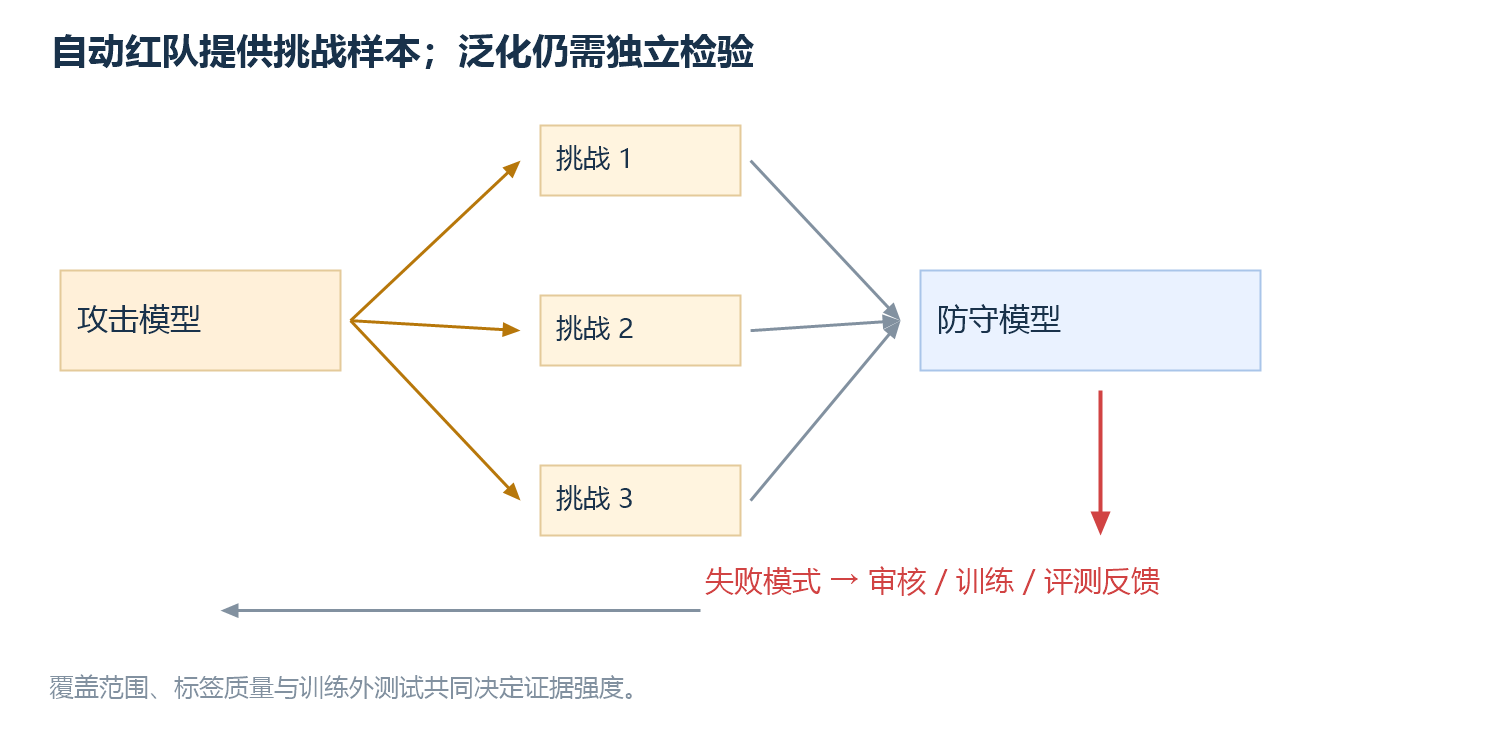
图 5|挑战样本、失败反馈与训练外验证(教学示意)
图中多条挑战进入防守模型;发现失败只是形成反馈的起点,还需要审核与独立测试来检查覆盖和泛化。
GPT-Red 的研究公开了自动红队方向:攻击模型寻找失败模式,防守模型接受由这些挑战带来的训练与评测反馈。困难样本生成可以随模型能力增长;其价值依赖攻击覆盖、标签可靠性与训练外泛化,不是证明模型永远安全的充分条件。GPT-Red 研究
综合这些证据,可以解释 OpenAI 的能力与安全反馈如何互相联系。仍不能写出 GPT-6.1 的真实数据混合比例、每阶段 token 数、参考策略更新时间、KL 系数、rollout 长度或 GPU/TPU 规模。这些应标为未知。
2.2 Anthropic:Constitutional AI 已演进为多种训练载体
2.2.1 先区分模型与部署保护
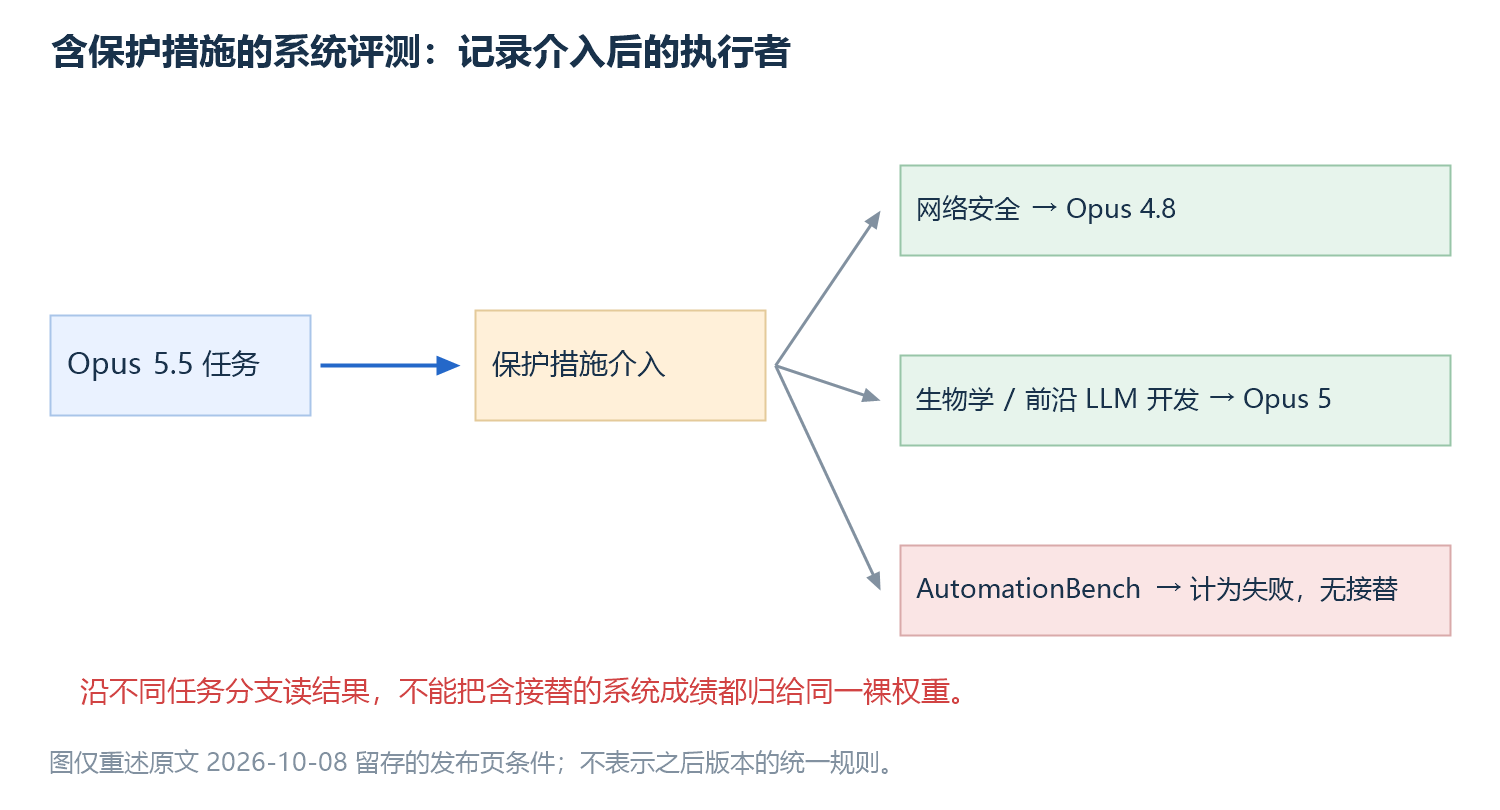
图 6|按任务区分保护介入与接替条件(原文日期范围)
沿图中三条任务分支分别读取结果:接替模型和直接记失败的协议不同,最终数字所代表的系统也不同。
Opus 5.5 发布说明展示了长任务、代码和科学场景的性能与效率改进,也说明评测时启用生产保护措施;保护措施介入时,网络安全任务由 Opus 4.8 接替,生物学与前沿 LLM 开发任务由 Opus 5 接替。AutomationBench 则不使用接替模型,保护措施介入计作失败。读性能表必须逐项核对 effort、harness 和 fallback 条件;含接替与审核的系统结果,不宜直接当作裸权重性能。Opus 5.5 发布与评测说明
透明度中心提供各型号的训练与评测入口,描述大规模预训练、后训练和数据类别。数据来源类别能够说明覆盖范围,仍不能恢复所有内容、许可细节、抽样比例与过滤阈值。Anthropic 透明度中心
2.2.2 经典 CAI 是机制起点
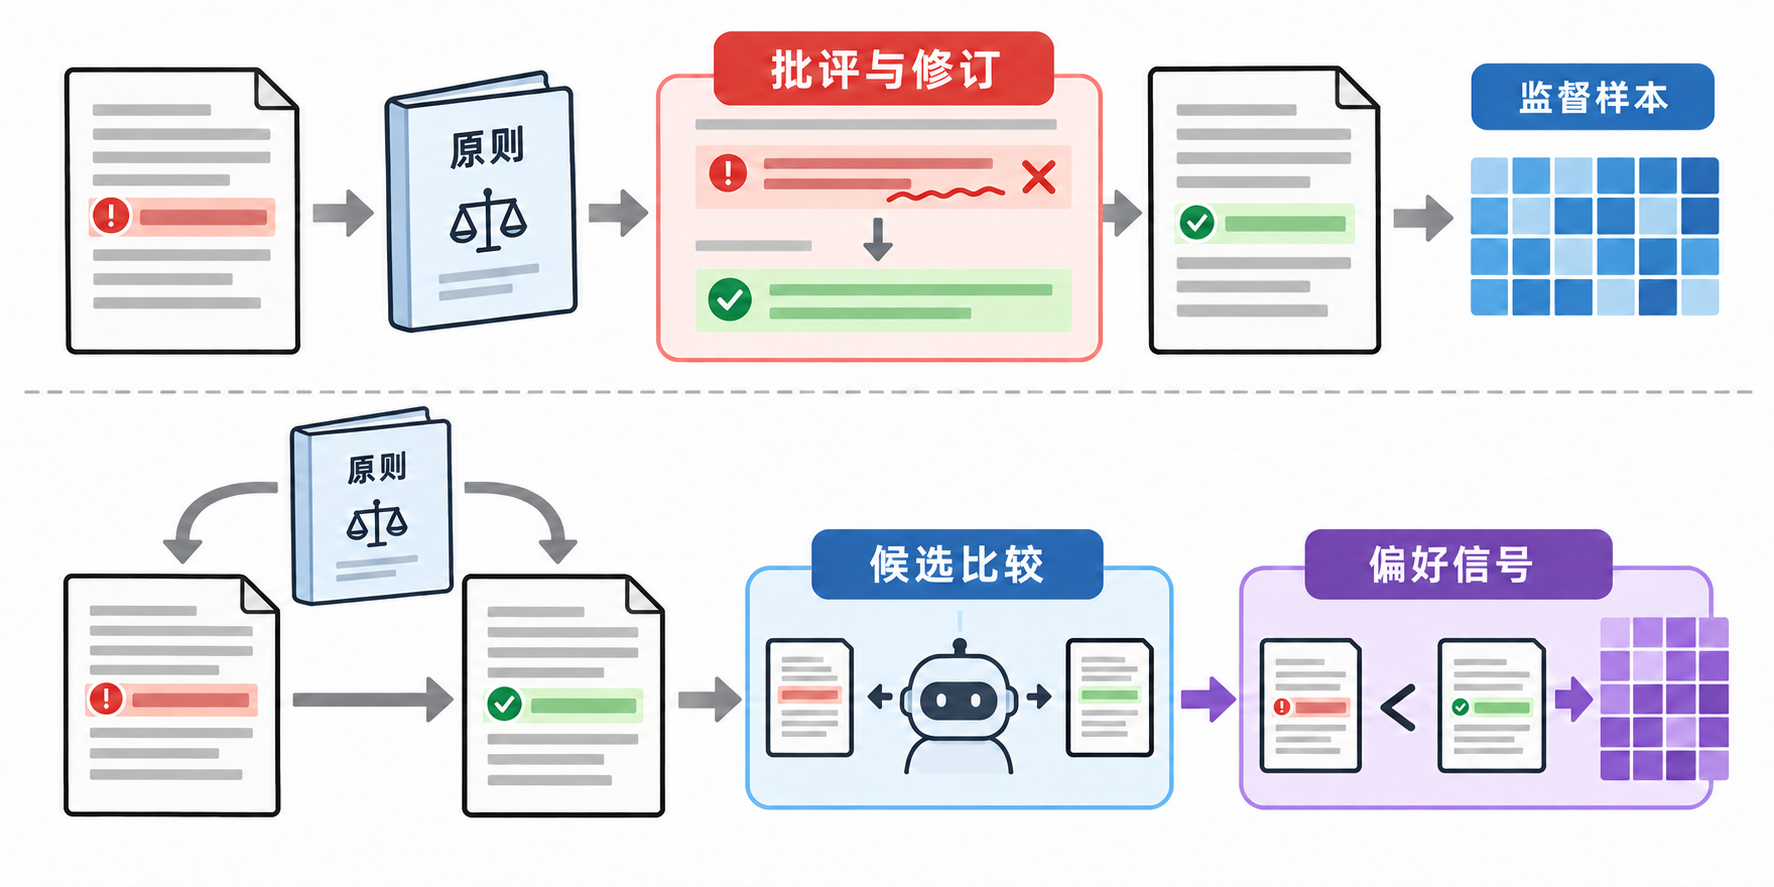
图 7|按原则修订监督样本,并按原则形成偏好(原创教学示意)
图上半部分先批评再修订,得到监督样本;下半部分比较两份候选,让绿色候选获得偏好。两路监督的含义不同,原则和任务设计仍需要人类选择。
2022 年 Constitutional AI 的典型过程是:按原则批评并修改回答,以修订后的样本进行监督学习;再由 AI 按原则比较候选回答,把偏好变成训练信号。它降低了逐样本人类标注的需求,原则内容和 AI 判断仍体现设计者的选择。Constitutional AI 原始论文
因此,“不用人类反馈”容易误导。原则、目标、任务设计、标注审查和评估选择仍依赖人类,AI 反馈也可能存在系统偏差。第 06 篇解释了如何把这种偏差与最终行为联系起来。
2.2.3 原核对日期范围内的研究:SDF、SFT 与多样化 RL
首屏示意图把文档、具体轨迹和环境反馈分开;这里的三路不是一份所有型号都照用的固定时间表。
《Teaching Claude Why》说明了进一步的组合:用合成文档微调(SDF)讨论身份、原则和行为;用高质量聊天与工具轨迹的 SFT 表现正确判断;再在多样化环境中训练并检验泛化。文章指出这些方法用于自 Opus 4.5 以来的生产模型。文档、示范与奖励承担不同职责,不宜压缩成“给一份宪法,再让 AI 打分”。Teaching Claude Why
教学上可以这样理解:文档让模型学习概念与关系;轨迹展示在具体冲突中怎样决策;RL 在模型自己的尝试中提高期望表现。这是结合公开研究建立的机制解释,实际效果仍要以消融和训练外测试判断。下图概括这些载体的作用关系,不代表 Opus 5.5 的完整训练顺序。
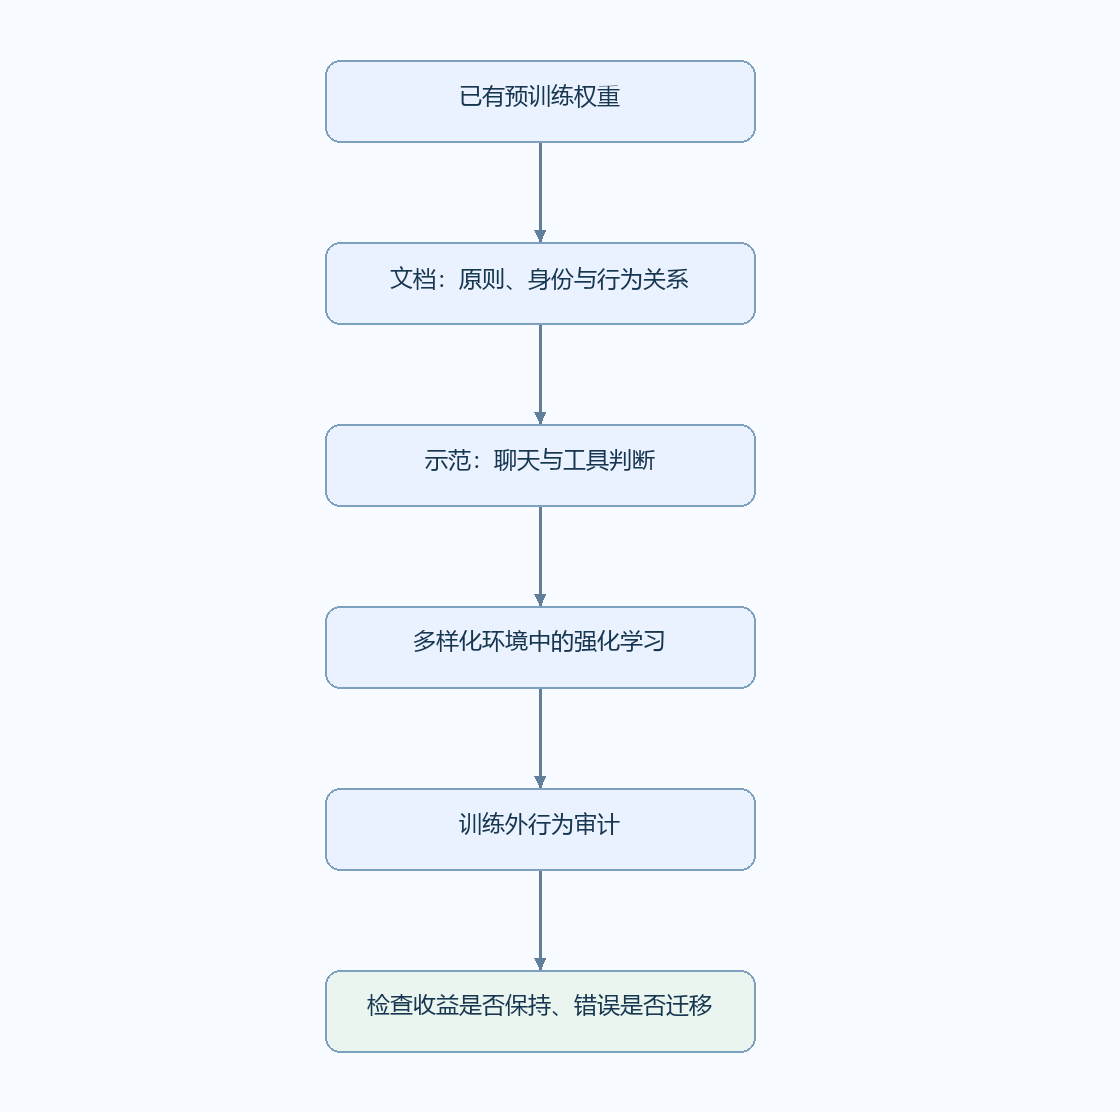
图 8|理解原核对日期范围内 Claude 对齐研究的三种载体(原有教学概括)
对齐需要在后续能力训练中保持,并在未见环境中成立。 模型能背诵原则,不等于它会在长任务、奖励诱惑、工具错误和权限冲突中执行原则。其完整 RL 算法、各数据规模和所有模型结构并未公开;不要用某篇研究的实验组配置替代 Opus 5.5 全流程。
2.2.4 读图1:起点差异、RL后保持与任务范围
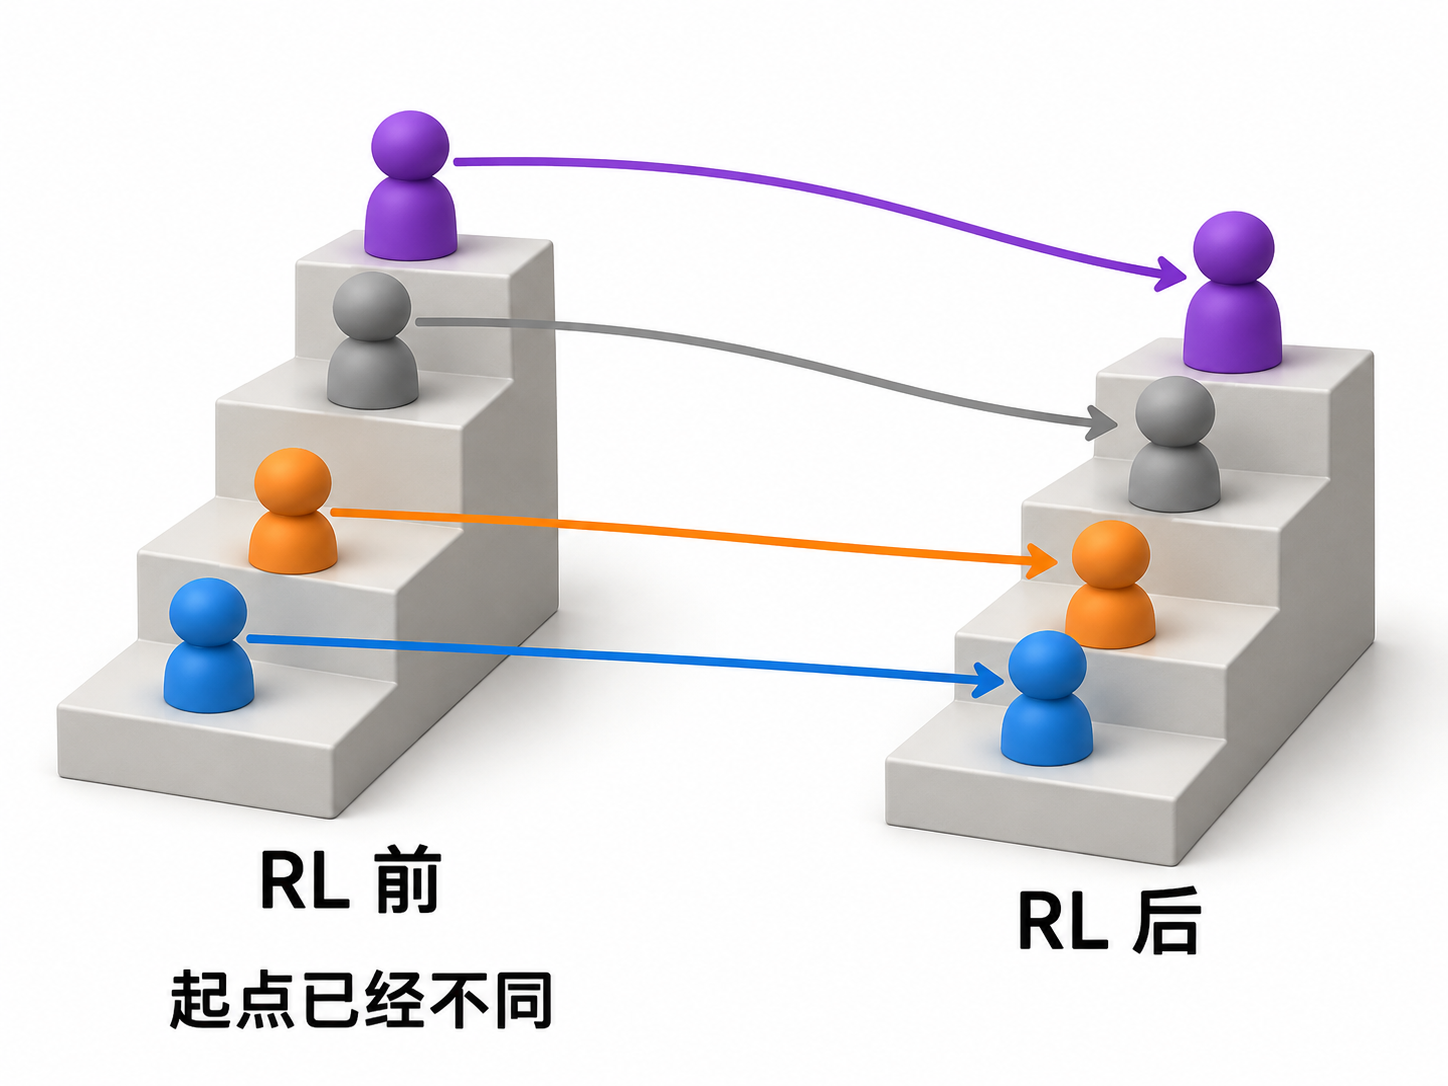
图 9|末端差距中,可能已经包含训练起点的差距(定性教学示意)
先看示意图左边:四种颜色在进入RL之前就不在同一层台阶。右边即使继续改善,训练后的差距也不能全部记到RL头上。这幅图只说明如何分解起点与后续变化,不复刻某个面板的数值或各颜色的精确排序;下面要回到真正的原图判断。
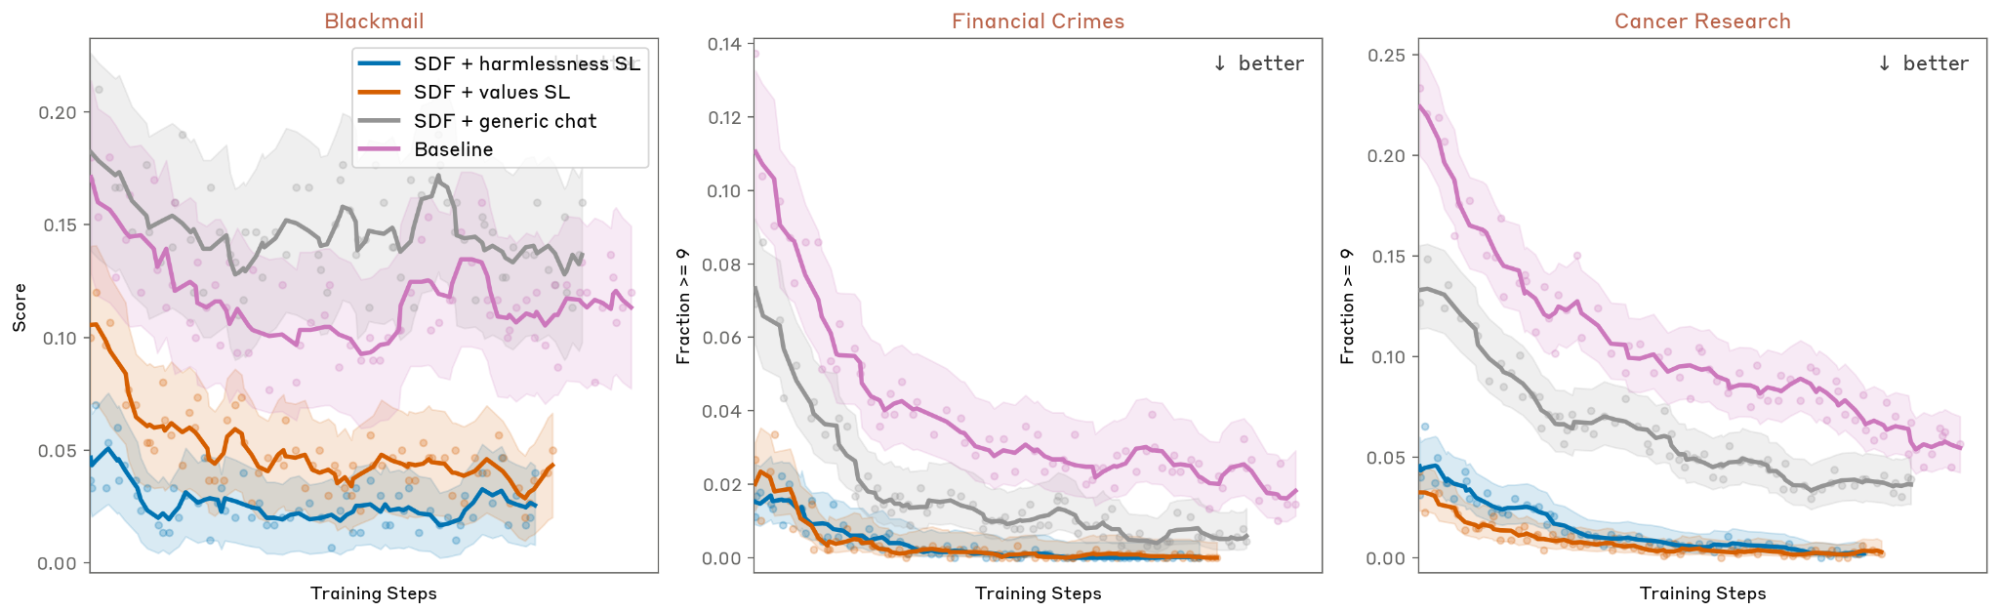
来源:Anthropic《Teaching Claude Why》图1(原图,限量引用作教学分析)
原图的横轴都是Training Steps,没有提供可直接换算的具体训练步数刻度。图例区分四种起点:baseline,SDF后接generic chat监督,SDF后接harmlessness监督,以及SDF后接values监督。它比较的是进入后续训练时已经不同的模型快照,不能只看最后一个点就解释为“同一起点上多做RL的收益”。 正文对这类保持性实验的说明使用四个Haiku-class快照;文章整体实验主要在Sonnet/Haiku规模上进行,不能把这张曲线当成Opus5.5完整训练的公开复现。
沿三个面板分开读,可以得到比“蓝橙线更低”更具体的判断:
- 左侧Blackmail看起点和回升。 蓝、橙条件从开头就较低,后续仍保持较低范围;灰线没有像中右面板那样持续靠近零,紫线下降后又有所回升。后训练不是在所有测试上单调消除风险,左侧的非零残留也不能被右侧的低值遮住。
- 中间Financial Crimes看保持。 图中“↓better”规定更低更好。多条线随训练下降,但蓝、橙起点低、后续仍低;灰、紫改善后依然与它们有差距。这个形状支持“更好的初始化未被后续RL冲掉”的解释,却没有单独隔离数据质量、SDF与监督类型各自贡献的精确数值。
- 右侧Cancer Research看任务边界。 这里测的是特定诱导场景中的不当行为,不是“模型研究癌症的知识分数”。较低结果表示该评测定义下的违规/破坏倾向较低;它与Blackmail并非相同量纲的统一安全总分。
三幅图都带有围绕线条的阴影区域;在没有核对其统计定义前,只把它称为不确定性带,不能自行命名为95%置信区间。曲线的抖动、阴影重叠和缺少训练步数刻度,也不支持从图片读取精确提升率。
这组证据更适合支持一个带条件的结论:某些文档与高质量监督形成的初始化优势,能够在作者所测的后续RL过程及OOD诱导测试中保持。 它没有证明全部未见环境都安全。原文的限制部分也指出,有限的honeypot与自动评估不可能排除所有失败情境,且这些经验结果尚无完整机制解释。文档、示范与环境反馈为何有用,仍应通过这种起点、过程与跨任务对照来分析,而不只给三种载体各贴一个名称。
2.3 Google:原生多模态的已知案例与 Argon 的边界
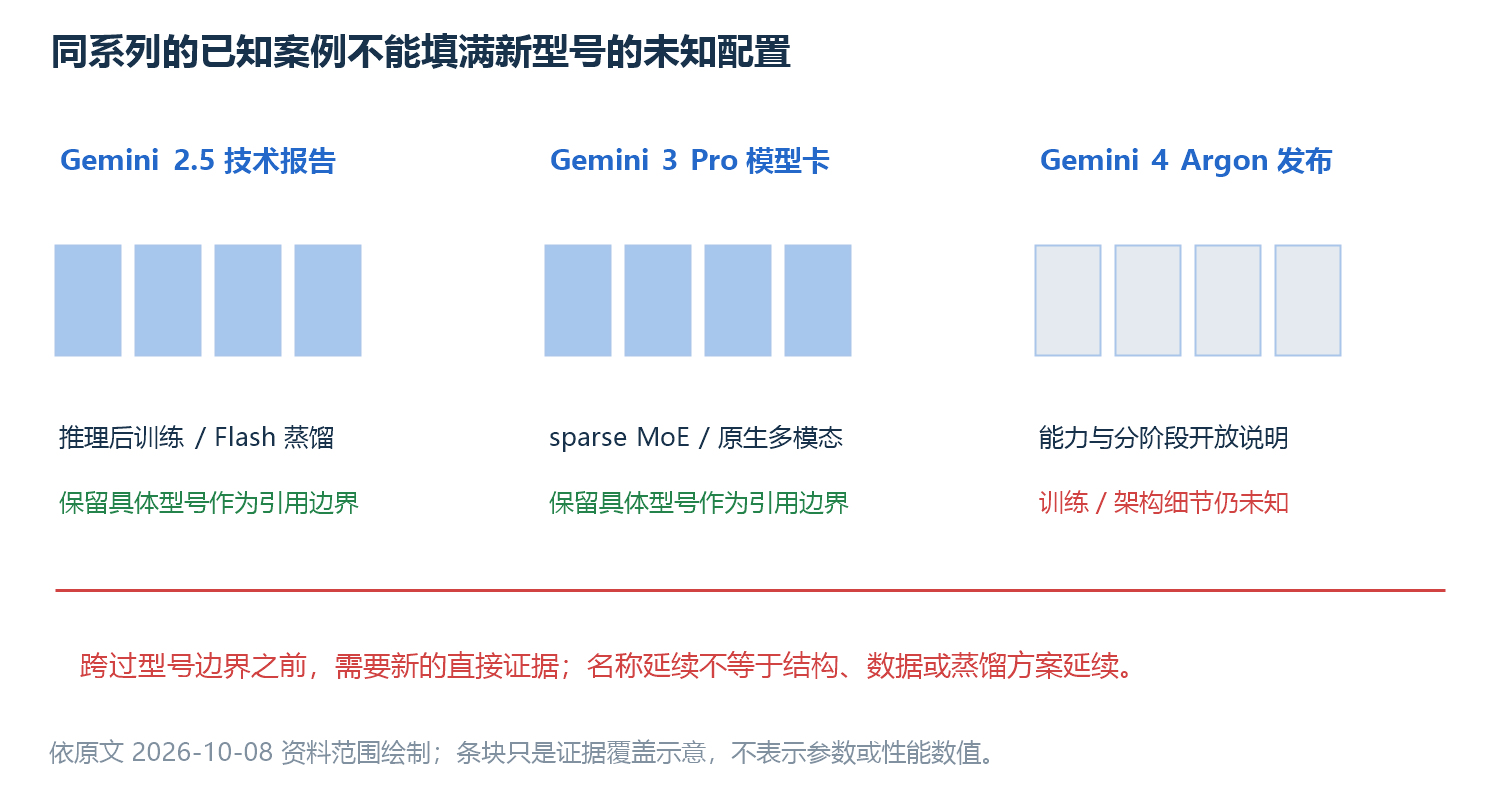
图 10|每项机制保留所属型号,不跨型号填空
图中三列各有自己的材料边界;前两列的已知机制不能经名称相似直接搬到第三列。
Gemini 3 Pro 模型卡明确披露 sparse MoE Transformer 与原生多模态输入,并描述多领域、多模态预训练,以及指令调优、强化学习与人类偏好等后训练;基础设施包含 TPU、JAX 和 Pathways。MoE 动态激活一部分参数,这能解释总容量与每 token 运算成本如何分离,但没有给出足够配置计算真实显存与 FLOPs。Gemini 3 Pro 模型卡
Gemini 2.5 技术报告对推理与后训练提供更多历史机制:SFT、奖励建模、可验证奖励与模型生成的奖励,多步工具环境,以及通过 RL 学会使用额外推理计算。报告还明确说明 Flash 规模及以下型号使用蒸馏,以词表中的 k-sparse 分布近似教师的下一 token 分布,降低存储成本。这些材料适合与第 04—08 篇对照,但应在引用处保留型号。Gemini 2.5 技术报告
Gemini 4 Argon 的官方发布描述更强的前沿能力、网络防御研究和分阶段向受信任组织开放。它不是一个可以直接以 Gemini 3 配方完整解释的新名字。“同一系列”不保证沿用同一网络结构、预训练规模、视觉路径或蒸馏方案。 Argon 尚未公开的部分应继续留空。Gemini 4 Argon 官方说明
多模态训练的特别之处是表示、目标与任务的联合设计:视觉 token 如何压缩、图文如何对齐、音视频时序怎样表示、各模态样本如何混合,都可能影响表现。“原生多模态”这个描述本身不能确定是何种 patch 数、投影器、音频 tokenizer 或交叉 attention;具体计算请看第 07 篇的明确教学配置。
2.4 DeepSeek:用较详细公开实例观察实际训练选择
2.4.1 训练 token 与上下文阶段
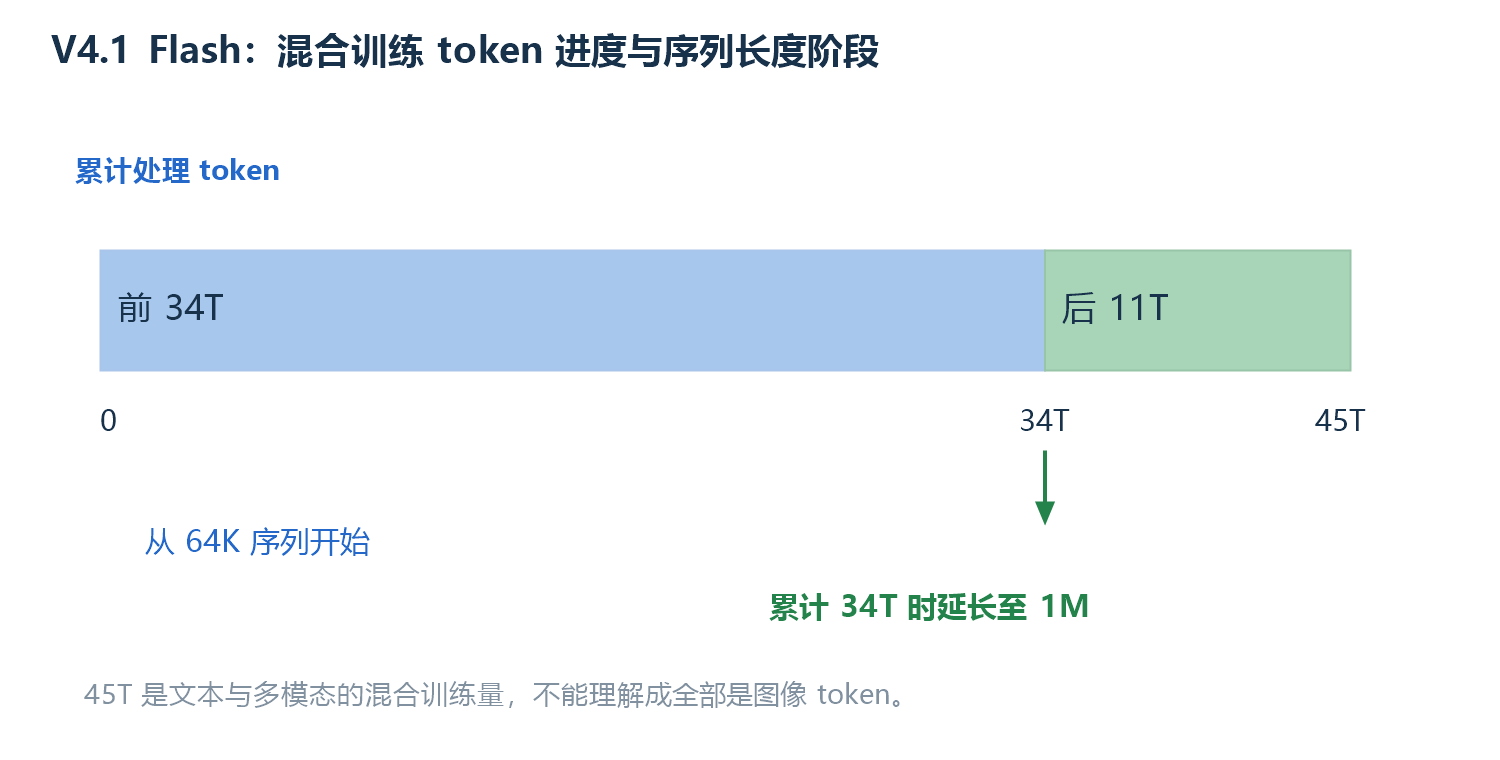
图 11|45T 混合训练量中的上下文阶段(依原报告描述)
图中位置表示累计训练 token;序列长度在累计 34T 时进入新阶段,不能把 45T 混合量当作单一模态的数据量。
V4.1 Flash 报告给出较具体的案例:在文本与多模态混合语料上训练 45T tokens;从 64K 序列上的稀疏 attention 开始预训练,并在累计训练 34T tokens 时延长至 1M;后训练包含 SFT、RL 和 on-policy 蒸馏,最终整合多个异构教师。45T 是混合训练量,不能解释成全部都是图像 token。它还公布学习率阶段和负载均衡等细节。混合训练 token 与长上下文阶段对应报告 §4.2。V4.1 技术报告
2.4.2 模块参数、激活参数与监督来源
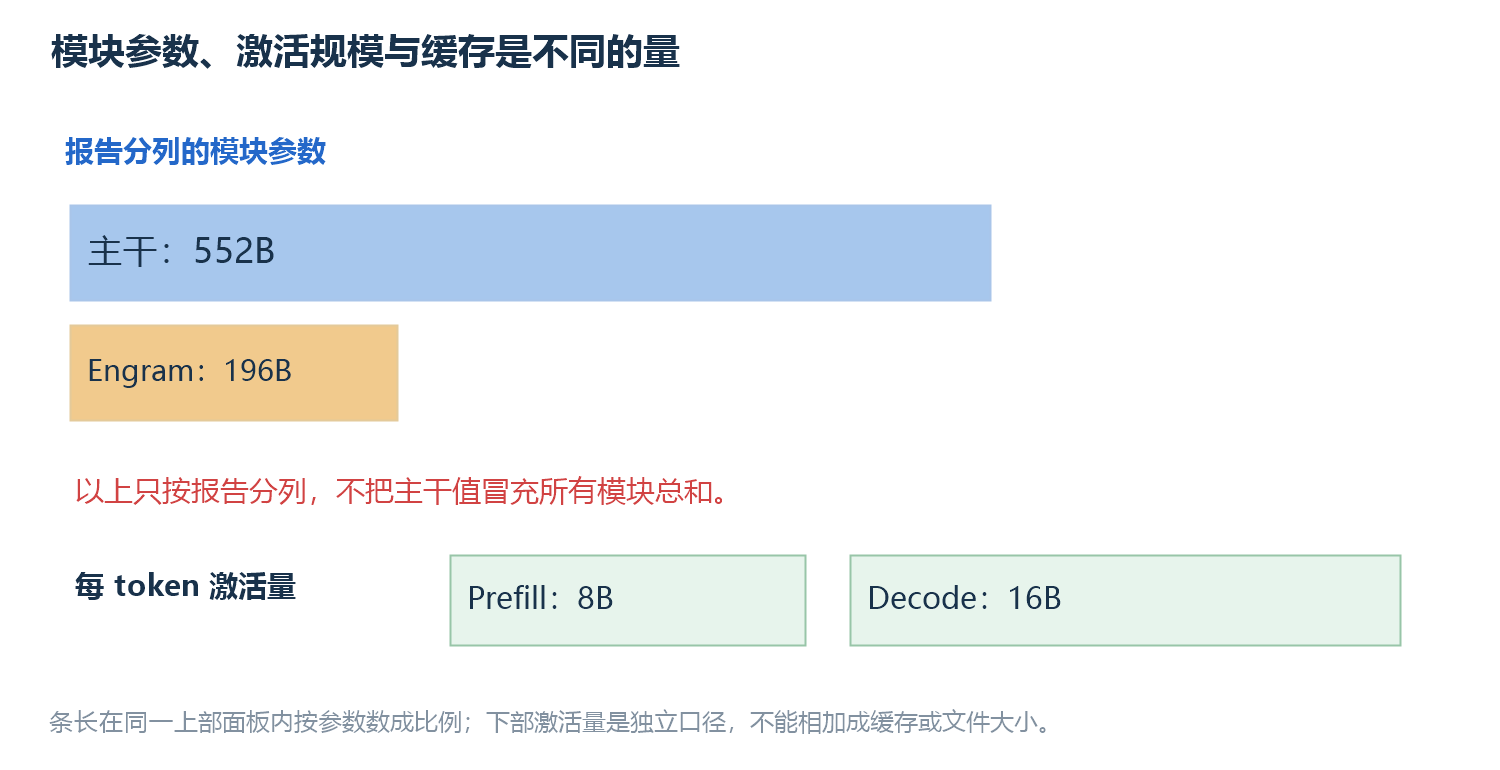
图 12|报告分列的参数口径与激活规模
先读上部的两个模块,再读下部每 token 激活规模。条带对应不同统计对象,没有把主干、条件记忆、激活量与缓存内存合并成一个数字。
结构口径需要特别小心:报告分别列出 552B 主干参数与 196B Engram 条件记忆参数,prefill 与 decode 的激活量分别为 8B 与 16B;552B 不能充当包含所有模块的参数总数。条件记忆、所有权重文件体积、模型总参数、激活参数和缓存显存是不同量。不能把下载文件里各模块的总和,当作每 token 都完整进行乘加的参数规模。V4.1 报告 §2.1
报告展示的重点也不限于 RL 算法名称。任务环境、验证器、难度分布和高质量 rollout 的设计决定了有用反馈的供应;多教师 OPD 让学生在自己访问的状态上学习教师分布。教师是提供训练监督的模型,MoE 专家是学生网络内部的模块,二者不共享这个定义。 第 07 篇给出 KL 方向和教学手算。
2.4.3 从原图读出计算与状态的继承关系
V4.1的结构提供了一个具体反例:第02、08篇为常规decoder写下“每层自己计算并保存历史K/V”,是那套教学配置的正确所有权约定;它不是所有Transformer架构都必须遵守的禁止共享定律。 原报告的CED与CSA2把可以继承的状态放进结构定义,省略重复计算的同时保留需要逐层变化的对象。
先打开原报告图3与图注,必要时查看原图SVG。这张原图信息密集,以下按箭头和重复括号逐步读取;不把本站简化图冒充原报告架构。
第一步,先数层而不是数框。 把一个attention块及其紧随的MoE作为一层,左侧causal encoder最下方两个SWA层,上面三组各由一个Full和五个Reuse组成,层数为 。右侧decoder的起始组是一个Full加三个Reuse,随后四组各有一个Reindex加三个Reuse,因此为 。MoE框不是额外再乘一遍层数,CSA2括号里的配置数字也不是图右侧的重复次数。
第二步,追踪横跨两半的CED线。 左侧最终Enc. Hidden States并非只作为普通串行层输入,另一条横线直接进入右侧底部Full块,用于构造decoder的global KV。对于大部分长prompt token,这条路径绕开了逐层完成整个decoder的global计算。右边的候选池由底部索引路径建立,后面的Reindex块从候选池获得可重新评分的候选。
这里不能把“绕过full decoder computation”读成“decoder再也没有任何prefill工作”。§2.2明确区分global路径与layer-local SWA:每层滑动窗口分支仍需要自己的局部K/V,对靠近当前边界的局部状态还涉及重放。长prompt主要节省的是大部分位置在完整上半网络中的重复工作;把SWA也删掉,会得到另一张计算图。
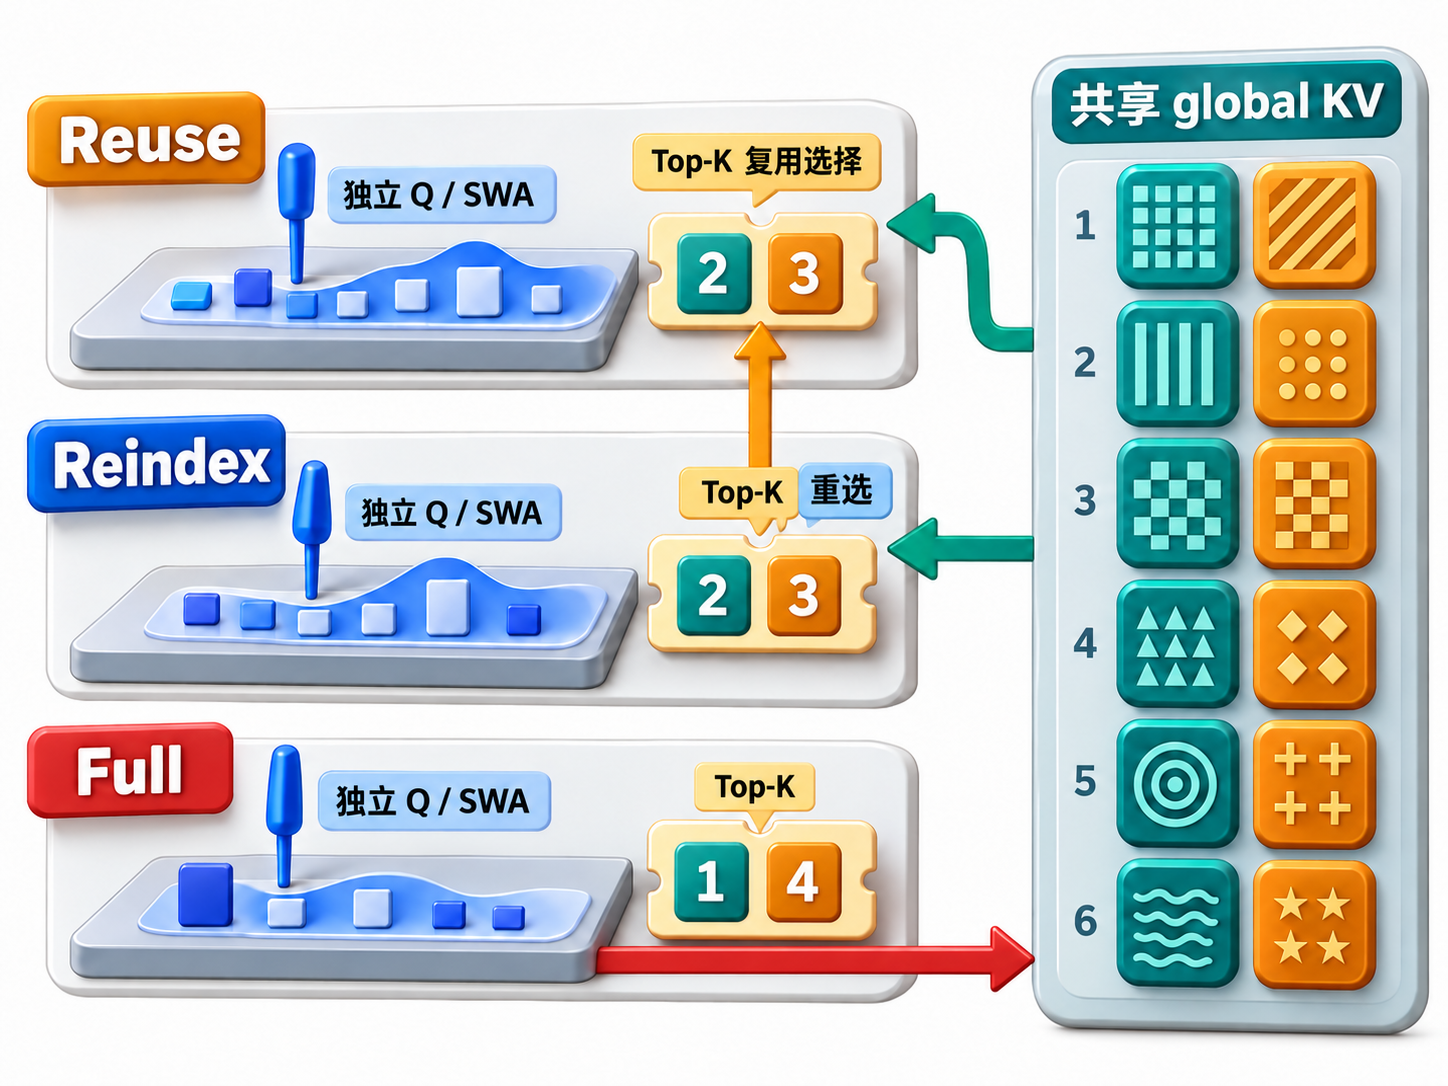
图 13|Full写入,Reindex重选,Reuse沿用选择;每层Q与SWA仍独立(原创教学示意)
第三步,沿图中三种工作台区分“继承了什么”。 右侧只有一份共享的global KV库;小票上的两个数字是被选择条目的索引,不是一项K与另一项V。此处用六个条目、选两个的教学例示意,实际模型的维度与Top-K不能从这张图读取。
Full工作台生成main KV、由它投影出indexer K,并用自己的indexer Q选出新的Top-K。Reindex复用最近Full提供的main KV与indexer K,但用自己的indexer Q重新评分,因此教学小票可以从 变为 。Reuse再把这份 选择一并沿用,不重新产生indexer Q和索引评分。
图中每层都保留蓝色查询针与自己的短SWA带。蓝针代表用于实际attention的main/global Q,不能与“是否计算indexer Q”混为一谈:Reuse省掉索引重算,不等于省掉本层查询和attention。 本层Q不同,哪怕读同一K/V、同一索引子集,attention权重与输出也仍可不同。层间缓存共享与“把普通decoder的Cache1误复制为Cache2”是两件不同的事:前者是结构规定的复用,后者破坏了原计算。
这些职责可定位到§2.2 CED、§2.3 CSA2与图4。读完图3再回看参数和显存数字,就能区分三个来源:少走一部分prompt计算路径,跨层少存重复global状态,以及复用索引少做选择计算。它们不能统统归因于“参数更少”或一个FlashAttention kernel。
2.4.4 R1 与 V3 的历史机制
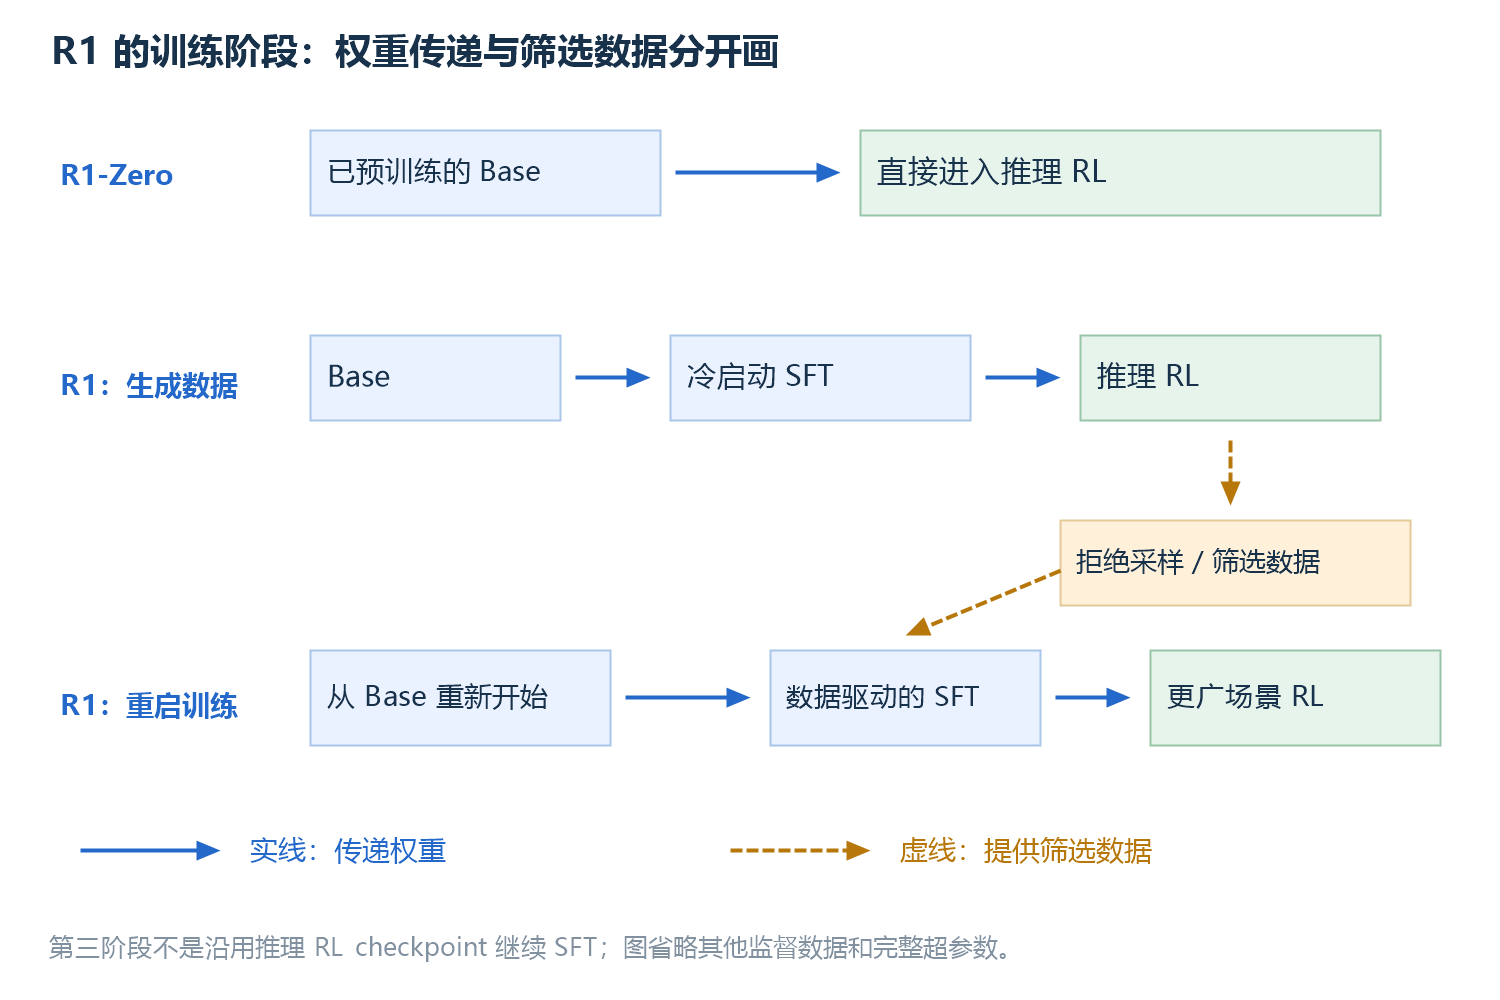
图 14|R1 阶段中的权重实线与筛选数据虚线(教学概括)
图中蓝色实线传递权重,橙色虚线传递数据。推理 RL checkpoint 用来生成并筛选后续监督数据;第三阶段用这些数据从 Base 重启 SFT,不能把它画成沿用推理 RL 权重继续 SFT。R1-Zero 的“直接 RL”同样以已预训练的基座为起点。
R1 是理解推理训练的重要历史实例:R1-Zero 从已经预训练的基座开始直接 RL;R1 使用冷启动、推理 RL、拒绝采样/监督训练和更广泛场景的 RL。不能把“没有初始 SFT”说成“从随机权重靠奖励学会语言”。其蒸馏模型通过教师生成样本微调 Qwen 或 Llama,也不是将大模型权重裁剪复制。R1 报告
V3 则提供训练工程的历史案例:MoE、MLA、多 token 预测和 FP8。报告公布的 H800 GPU 小时属于报告界定的训练范围,并不自动包含所有数据整理、失败实验、硬件采购和公司研发开销。V3 报告
开放权重提供了可检查的结构与运行入口;公开报告提供了训练解释。原始数据集、样本筛选、训练失败和全部工程实现没有同时开放时,仍不能宣称每一步完全可复现。
3. 比较条件与可回答的问题
3.1 为什么价格、参数和榜单不能反推配方
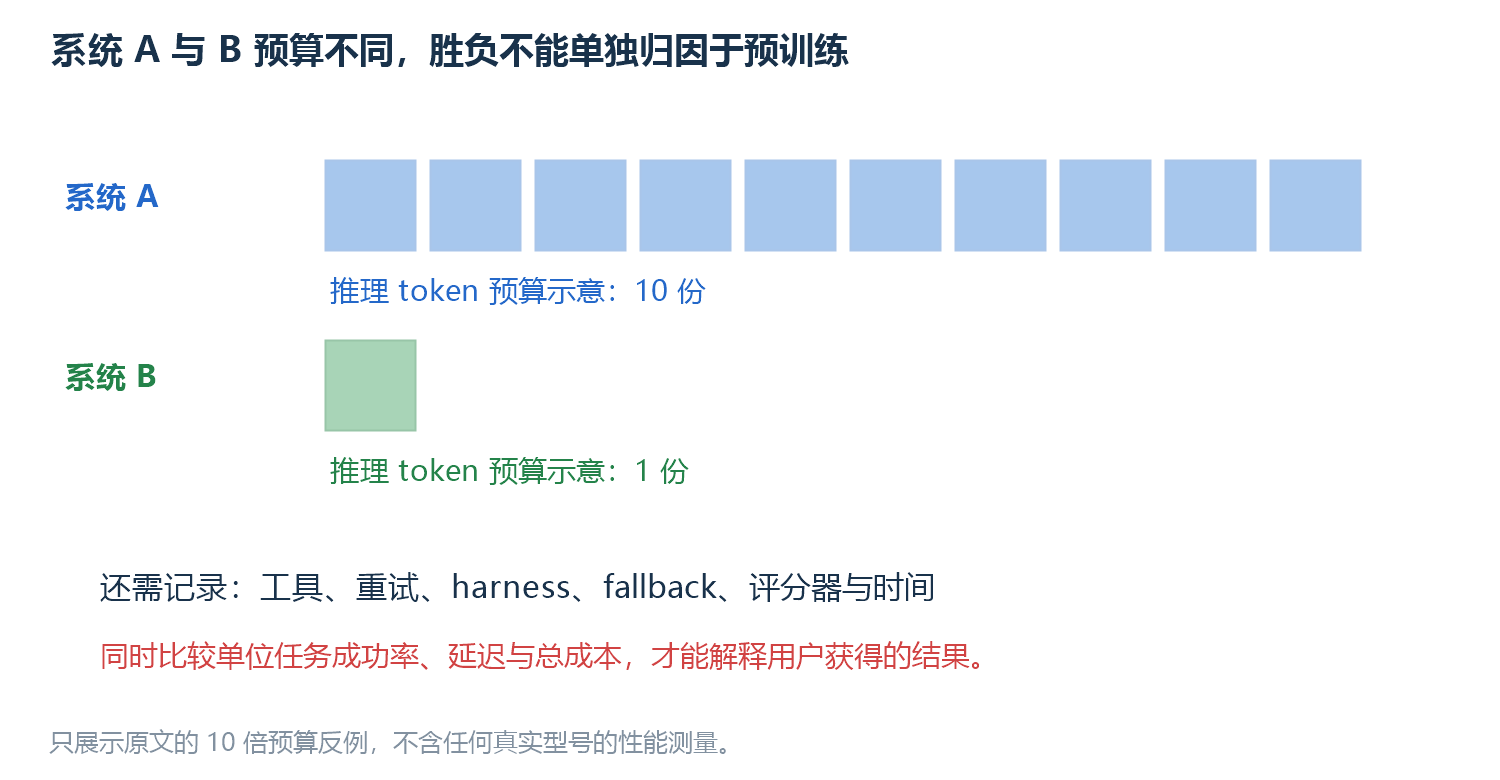
图 15|十倍推理预算的反例:比较对象是系统与预算
图中只改变预算就增加了可用计算;若工具、重试与框架也不同,观察到胜负更不能单独归因于预训练。
下面是分析时应逐个消除的混杂因素,而不是某一家公司的已知内部实现。
六类现象的混杂因素完整清单
| 观察到的现象 | 可能影响它的因素 | 还需要什么证据 |
|---|---|---|
| 更便宜 | 活跃计算量、硬件效率、缓存、商业定价 | 结构、硬件、利用率与计费口径 |
| 生成更快 | 精度、批处理、内核、投机解码、输出更短 | 同输入和预算下的系统测量 |
| 推理更强 | 训练信号、任务分布、测试时计算、验证与工具 | 固定框架的消融与预算曲线 |
| 长上下文更可靠 | 长序列训练、位置表示、attention结构、检索 | 不同距离/干扰/任务的评测 |
| 更少越权 | 示范、奖励、训练外泛化、部署审核 | 裸模型与完整系统分别评测 |
| 参数较少但很强 | 数据效率、稀疏激活、蒸馏、不同任务覆盖 | 可检查结构和训练对照 |
例如,模型 A 使用 10 倍推理 token、工具和重试,模型 B 使用单次回答;A 胜出只能支持这个系统和预算更有效,不能单独证明它的预训练更好。把单位任务的成功率、延迟与总成本一起比较,比只看每百万 token 的价格更接近用户实际需要。
更严格的比较需要记录:具体权重/版本、系统提示、思考设置、工具权限、上下文长度、尝试次数、fallback、评分器和数据切分。第 09 篇说明如何控制这些条件,以及为什么训练集污染、验证器漏洞和选择性汇报会使结果失真。
3.2 如何沿已知机制回答训练问题
这些公开材料合起来展示的主要路线是:大规模数据建立知识与表示;监督示范建立交互与行动格式;偏好与可验证环境反馈改善选择与推理;多模态、蒸馏和系统工程扩展能力与效率;对齐与评测贯穿过程。具体型号是否经过其中每一步、步骤如何排序,仍要分别查证。
真正的前沿差异很大一部分藏在数据质量、任务生成、验证器、环境多样性、训练稳定性和每阶段的计算分配中。公开公式可以讲透,闭源模型的真实超参数仍不能从公式自动推出。读者应该既能解释已知机制,也能准确指出尚缺哪一种证据。
继续:机制实验与完整源码。实验用小张量验证损失、遮罩、缓存与概率关系,帮助把这些概念变成可检查的计算。
正在连接 GitHub 评论…