00|TTS 技术路线:2016—2026 的问题、架构与实现
这组文章以有深度学习基础、尚不熟悉 TTS 的读者为对象,从采样点和频谱开始,逐步走到语义 token、多码本模型与流式服务。资料核对截止 2026-09-29;年份用于定位问题背景,阅读时更应关注“哪种计算或监督被替换了”。
TTS 的演进不是一个模型完全淘汰前一个模型,而是表示、对齐、生成与部署的多个问题持续重组。
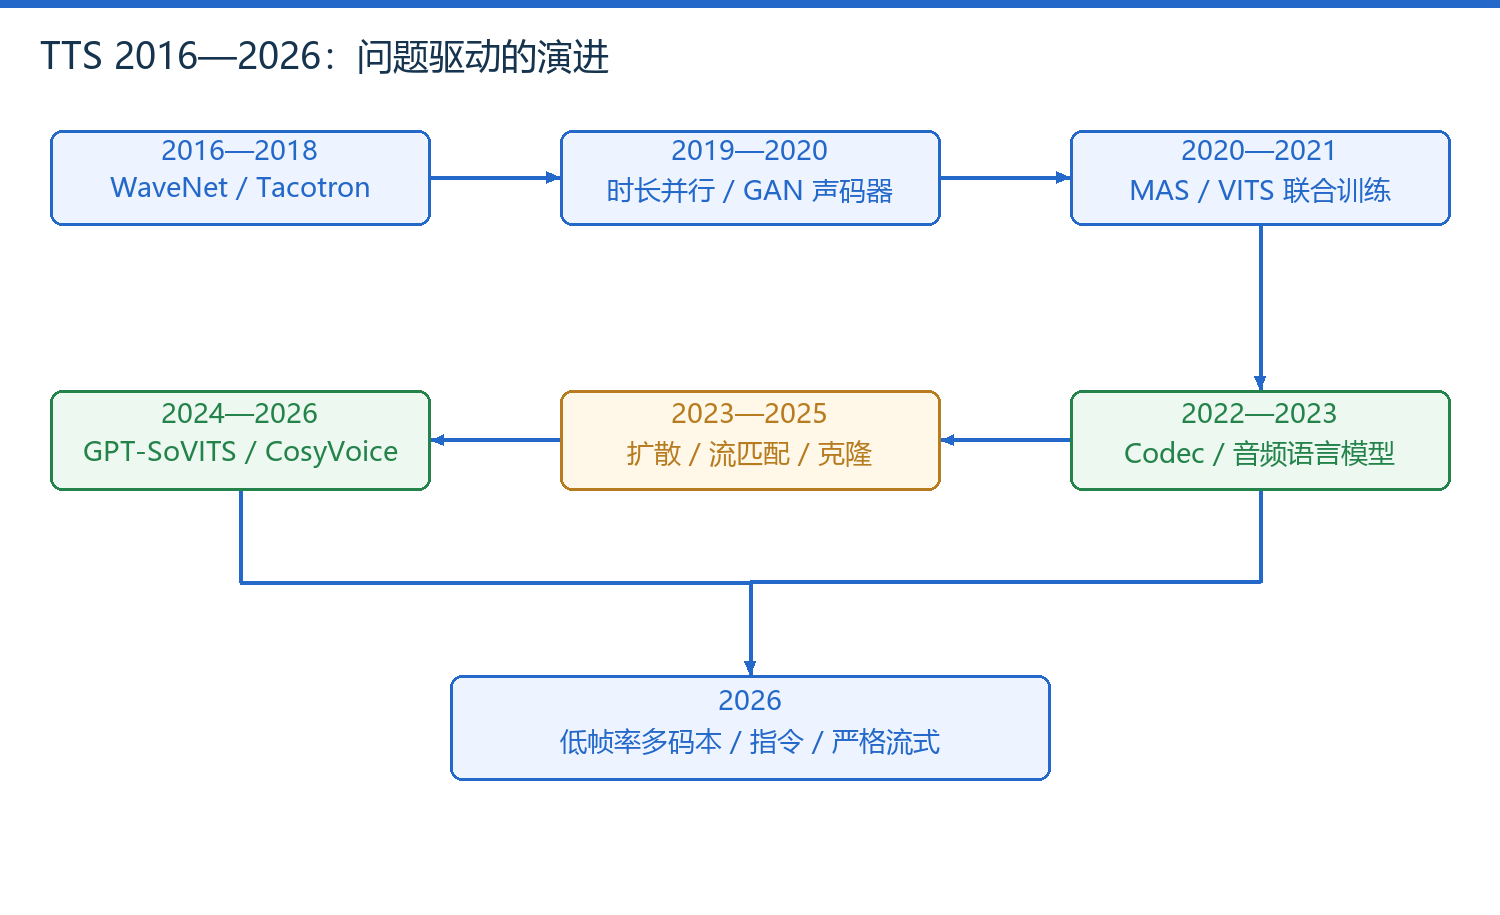
图 1|从波形自回归到多码本、流匹配和在线合成的技术路径
1. 按问题组织的阅读路线
| 路径 | 章节 | 核心问题 |
|---|---|---|
| 波形生成 | 01 WaveNet | 怎样学习采样点之间的条件分布? |
| 文本与声学对齐 | 02 Tacotron | 文字为什么对应可变长度频谱? |
| 声学接口与身份 | 03 Tacotron 2 | mel、声码器与参考身份如何分工? |
| 并行声学预测 | 04 FastSpeech / FastSpeech 2 | 时长、音高与能量怎样解除逐帧依赖? |
| 并行波形 | 05 HiFi-GAN | 多周期判别怎样约束细节? |
| 对齐与联合训练 | 06 Glow-TTS / VITS | 硬对齐、潜变量与波形训练怎样连接? |
| 音频离散表示 | 07 EnCodec / VALL-E / NaturalSpeech | 压缩后的语音如何成为生成目标? |
| 连续生成 | 08 F5-TTS | 速度场怎样把噪声变成 mel? |
| 两阶段克隆系统 | 09 GPT-SoVITS | 语义 GPT、参考条件、版本与微调怎样配合? |
| 监督 token 与流式 | 10 CosyVoice | 多模块系统怎样在线连续合成? |
| 低帧率多码本 | 11 Qwen3-TTS | 大主干与帧内预测怎样分工? |
| 当前进展 | 12 MOSS / Fish / OmniVoice / 严格流式 | 新路线的改动与证据边界是什么? |
| 动手验证 | 机制实验源码 | 用 CPU 检查长度、对齐、量化、遮罩与积分 |
2. 贯穿全专题的表示单位
| 表示 | 时间单位 | 内容 |
|---|---|---|
| 波形 | 采样点 | 单/多声道振幅 |
| mel 频谱 | 帧 | 一组频带的声学能量特征 |
| 连续潜变量 | 编码帧 | 神经网络学习的隐藏向量 |
| 语义 token | 语义编码步 | 离散编号,保留内容与时序线索 |
| 多码本 token | 帧×码本层 | 每帧多个离散编号 |
| 文本 token / 音素 | 文字或发音位置 | 与音频时间轴不等长 |
看到一个速度或码率数字时,先检查它对应哪种表示、哪段链路。
3. 每章如何使用
导读讲位置与架构;子文集中处理机制、公式或实现。核心公式旁的符号表默认展开,可以收起。蓝色突出概念,绿色标示可验证关系,红色标示容易混淆的条件。原论文图保留短来源链接;教学图中的数值例会明确说明,不伪装成真实模型测量。
| 想完成的任务 | 建议入口 |
|---|---|
| 理解 TTS 全链路 | 01→06,再进入 token 与流匹配 |
| 学习 GPT-SoVITS | 06、07、08 的基础,再读 09 全章 |
| 研究流式语音助手 | 10、11、12,并核对输入等待与首个可播音频 |
| 阅读模型源码 | 先看本章架构/形状,再运行附录小实验 |
本轮运行的是教学机制实验;没有以未执行的大模型训练或试听冒充复现结果。
4. 资料与更新边界
每篇就近链接原论文摘要页或官方实现。当前进展分别标明已发布权重、论文方案、在线服务和预告功能。本文是一份截止日期明确的技术整理,不包含自动定时监控。对任何后续更新,优先比较表示、条件、计算路径和评测设置是否真的改变。
正在连接 GitHub 评论…