02|长度调节器实现:形状、梯度与边界检查
本实验只实现音素向量展开,目标是弄清最容易出错的时间轴与梯度累积。FFT、音高预测和声码器仍需由完整模型提供;函数输出的是隐藏矩阵,没有声音意义。
repeat_interleave 复制条件行,反向传播把重复行的梯度加回原位置。
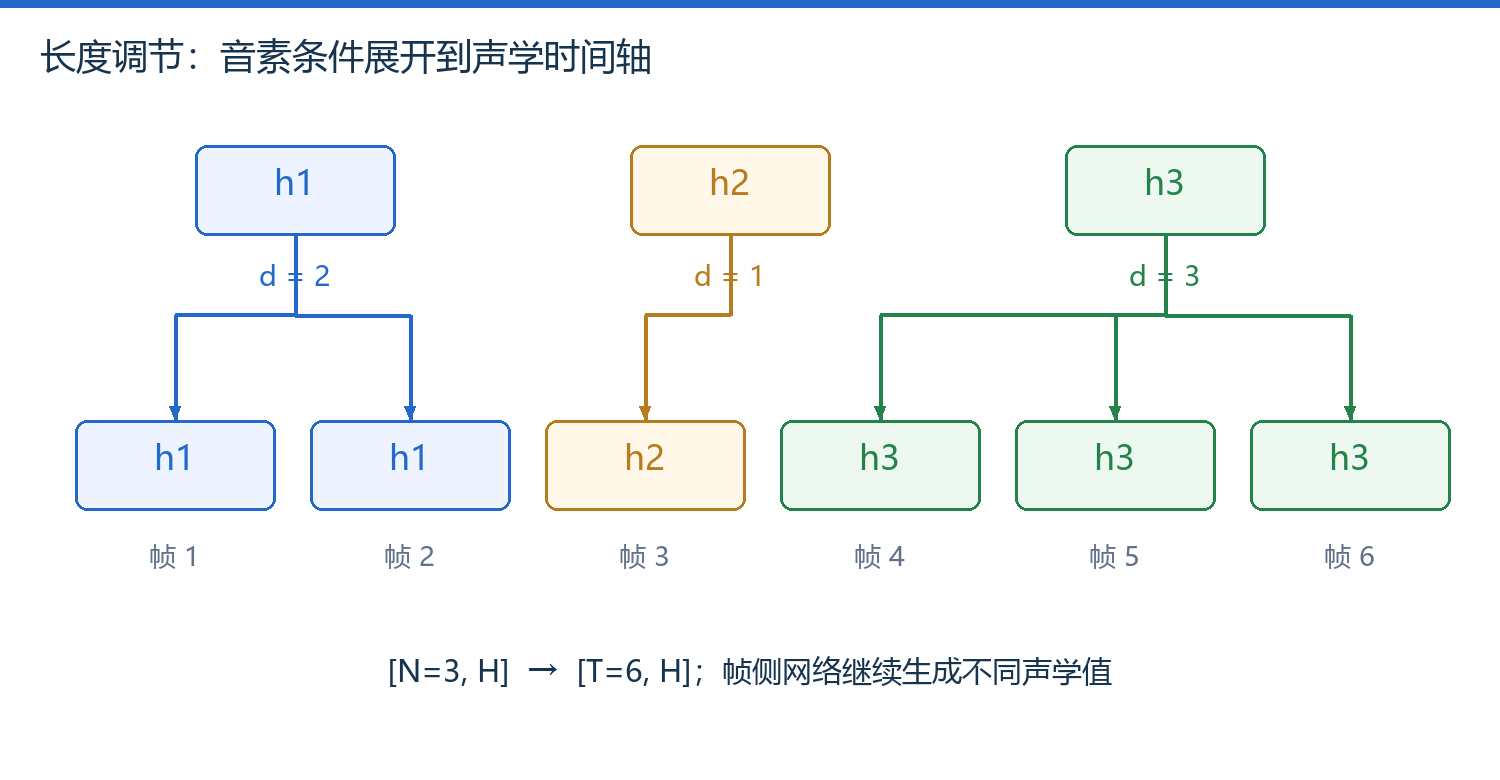
图 1|length_regulate 的输入、重复次数与输出行
1. 接口与调用关系
| 对象 | 输入 | 输出 / 状态 |
|---|---|---|
length_regulate | hidden[N,H] float;durations[N] int64 | [sum(d),H];无跨调用缓存 |
| 调用方 | 去除 padding 后的单条样本 | 负责 batch 逐条展开并重新 padding |
| 时长预测器 | 文本隐藏状态 | 连续预测需先转换成非负整数 |
def length_regulate(hidden, durations):
    """One unpadded item: [N,H], integer [N] -> [sum(d),H]."""
    if durations.dtype != torch.long or (durations < 0).any():
        raise ValueError('durations must be non-negative int64')
    if len(hidden) != len(durations): raise ValueError('length mismatch')
    return torch.repeat_interleave(hidden, durations, dim=0)
代码先拒绝负值与错误 dtype,再沿第 0 轴重复。把 dim=0 错写成 dim=1 会扩大通道数,不能通过随后 reshape 修复语义。代码允许零时长,以适应某些特殊符号约定;普通发音音素是否必须至少一帧,应由前端与训练标签共同规定。
2. 梯度为何等于重复次数
用输出元素之和作教学损失,每个被复制元素对损失的导数都是 1,因此原行接收所有副本的和。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 本实验展开矩阵所有元素之和;不是 FastSpeech 实际训练损失。 | |
| 第 i 个音素、第 j 个隐藏通道的值。 | |
| 分别为音素索引、隐藏通道索引。 | |
| 该行重复次数,教学例为 2、1、3。 | |
| 偏导数,固定其他变量时的局部变化率。 |
| 实测检查(CPU) | 结果 | 说明 |
|---|---|---|
输入 [3,2],时长 [2,1,3] | 输出 [6,2] | 时间轴展开正确 |
| 输出求和后反向传播 | 每通道梯度 [2,1,3] | 重复行的梯度正确累积 |
| 时长变为负数 | 抛出 ValueError | 防止静默产生非法长度 |
这些检查验证张量机制,可在 CPU 上快速重复。
整数取整和重复次数没有普通的连续梯度;时长预测器需要自己的监督目标。
3. 运行入口与完整实现
完整实验在 机制实验源码,复制为 mechanism_lab.py 后运行 python mechanism_lab.py。结果写入同目录的 results/mechanism-checks.json。本文记录来自 PyTorch 2.14.0+cpu;没有使用预训练模型,也没有测量 MOS 或合成速度。
把输出交给 mel 解码器前,还应检查帧 mask。两条句子分别展开成 6、9 帧时,batch 的 [2,9,H] 中,第一条最后 3 行不能参与声学损失。返回 FastSpeech 2。
正在连接 GitHub 评论…