01|多码本调度:展平、延迟模式与局部自回归
低帧率只缩短时间轴,多层码本仍需要预测。设计者可以把码本展平、错位排布,或者交给每帧的局部模块。三者的主要差异是依赖关系与大网络运行次数,不能仅以 token 总数判断速度。
把时间维与码本维画成网格,才能看出序列调度到底改了什么。
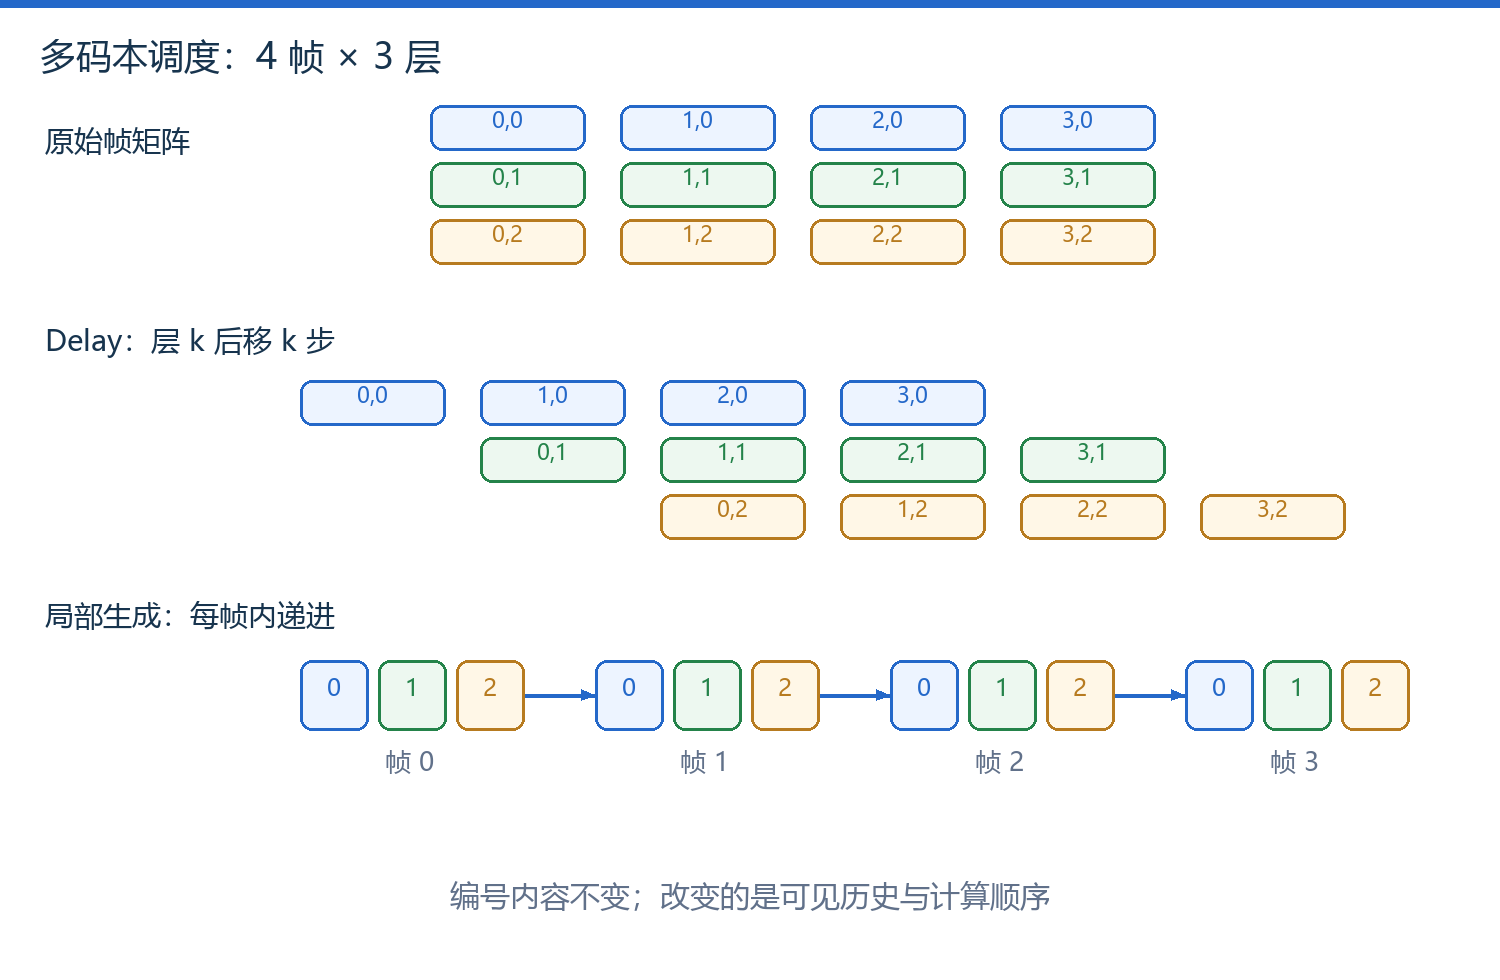
图 1|4 帧、3 码本的展平、延迟排列与帧内生成
1. 三种路径比较
| 调度 | 大主干时间步的教学估算 | 依赖方式 | 代价 |
|---|---|---|---|
| 全部展平 | T×K | 每个码本编号顺序进入同一长序列 | 序列与 KV cache 更长 |
| 延迟模式 | T+K−1 | 不同码本按层错开,多头并行输出 | 首尾有填充,首个完整帧需等待 |
| 局部自回归 | 约 T 个全局步骤 | 当前帧内部由局部模块逐层生成 | 增加模块与帧内串行计算 |
T 为音频帧数,K 为码本数;真实实现还有文本、特殊 token 与边界协议,表格用于分析依赖,不是精确计时公式。Qwen3-TTS 的 MTP、Fish 的 Fast AR、MOSS 的 Local Transformer 各有具体实现,不能仅凭结构相似就宣称权重可互换。
2. 延迟模式的坐标关系
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 原始 token 矩阵,形状 T×K。 | |
| 错位后的调度矩阵,形状 (T+K−1)×K。 | |
| 原始时间帧索引,代码从 0 开始。 | |
| 码本层索引,代码从 0 开始。 | |
| 该编号在错位调度中的步骤位置。 |
4 帧、3 层共有 12 个编号:展平要安排 12 个位置,延迟矩阵有 6 行;其中的空格对应填充,不是要合成的额外语音。第一帧的三层分别在行 0、1、2 出现,因此不能只拿第一行就认为一个完整音频帧准备好了。
3. 教学实现与状态所有权
输入 [T,K] int64,输出带 -1 空位的矩阵;-1 只是教学占位,不是某个真实模型的 BOS/EOS 编号。真实协议必须使用训练时相同的特殊 token。
def delay_pattern(tokens):
    """[T,K] -> [T+K-1,K]; -1 denotes BOS/EOS padding in this demo."""
    t,k=tokens.shape
    grid=torch.full((t+k-1,k),-1,dtype=tokens.dtype)
    for j in range(k):grid[j:j+t,j]=tokens[:,j]
    return grid
实验对每列做逆切片,检查能完整恢复原输入,防止错位一帧。局部自回归的帧内状态通常随当前帧重新建立,全局时间状态则跨帧延续;源码阅读时应分别定位它们的缓存生命周期。
用逆变换检查比只观察网格形状更容易发现 off-by-one 错误。
T+K−1 小于 TK 只说明调度长度较短,不证明实际墙钟时间按同一比例缩短。
4. 实际模型的阅读入口
| 模型 | 官方资料 | 优先核对 |
|---|---|---|
| Qwen3-TTS | 代码与报告 | talker 与 code predictor、首帧输出条件 |
| MOSS-TTS | 官方仓库 | delay 与 local 目录的序列协议 |
| Fish Speech | 官方仓库 | Slow AR 与 Fast AR 的输入融合 |
完整脚本见 机制实验源码。返回 Qwen3-TTS 导读。
正在连接 GitHub 评论…