03|OmniVoice:多码本掩码扩散与多语言生成
OmniVoice 不沿目标音频时间轴逐个采样首层 token,而是给多码本矩阵遮住一部分位置,用双向 Transformer 学习恢复,并在推理时迭代解掩码。它与 F5-TTS 都有迭代过程,但前者恢复离散编号,后者更新连续频谱。论文 · 官方实现
全码本随机遮罩让不同深度与时间位置共同参与离散恢复任务。
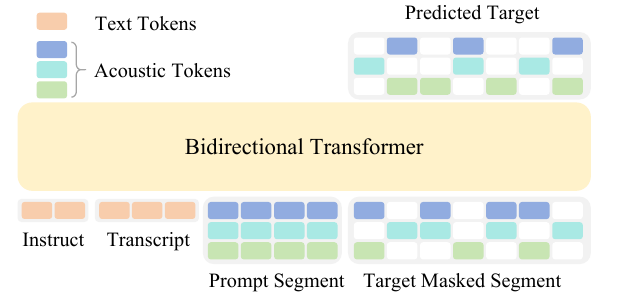
图 1|文字、参考音频与目标掩码矩阵共同进入双向 Transformer
1. 多码本怎样进入单个主干
| 步骤 | 表示 | 作用 |
|---|---|---|
| 文字嵌入 | 指令与转写 token | 提供语言条件 |
| 音频嵌入 | 每层码本独立 embedding | 保留码本身份 |
| 同帧相加 | 每个时间位置一个向量 | 避免把各层展平成更长序列 |
| 双向主干 | 读取可见目标上下文与参考 | 联合推断缺失部分 |
| 独立输出头 | 各码本自己的分类分布 | 恢复被遮住的编号 |
报告中的模型以 Qwen3-0.6B 权重初始化双向主干,并使用 8 码本音频 tokenizer。初始化来自 AR 语言模型,不意味着最终注意力仍必须保持因果;任务和训练遮罩改变了生成方式。
2. 损失只落在需要恢复的位置
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 目标区域内被遮住的位置集合,不包括参考区。 | |
| 音频时间帧索引。 | |
| 码本层索引。 | |
| 当前位置真实整数编号。 | |
| 部分位置替换为 MASK 后的音频矩阵。 | |
| 文字和指令条件。 | |
| 参数 θ 的模型预测的正确编号概率。 | |
| 只累积集合中的位置。 | |
| 自然对数;求和损失单位为 nats。 |
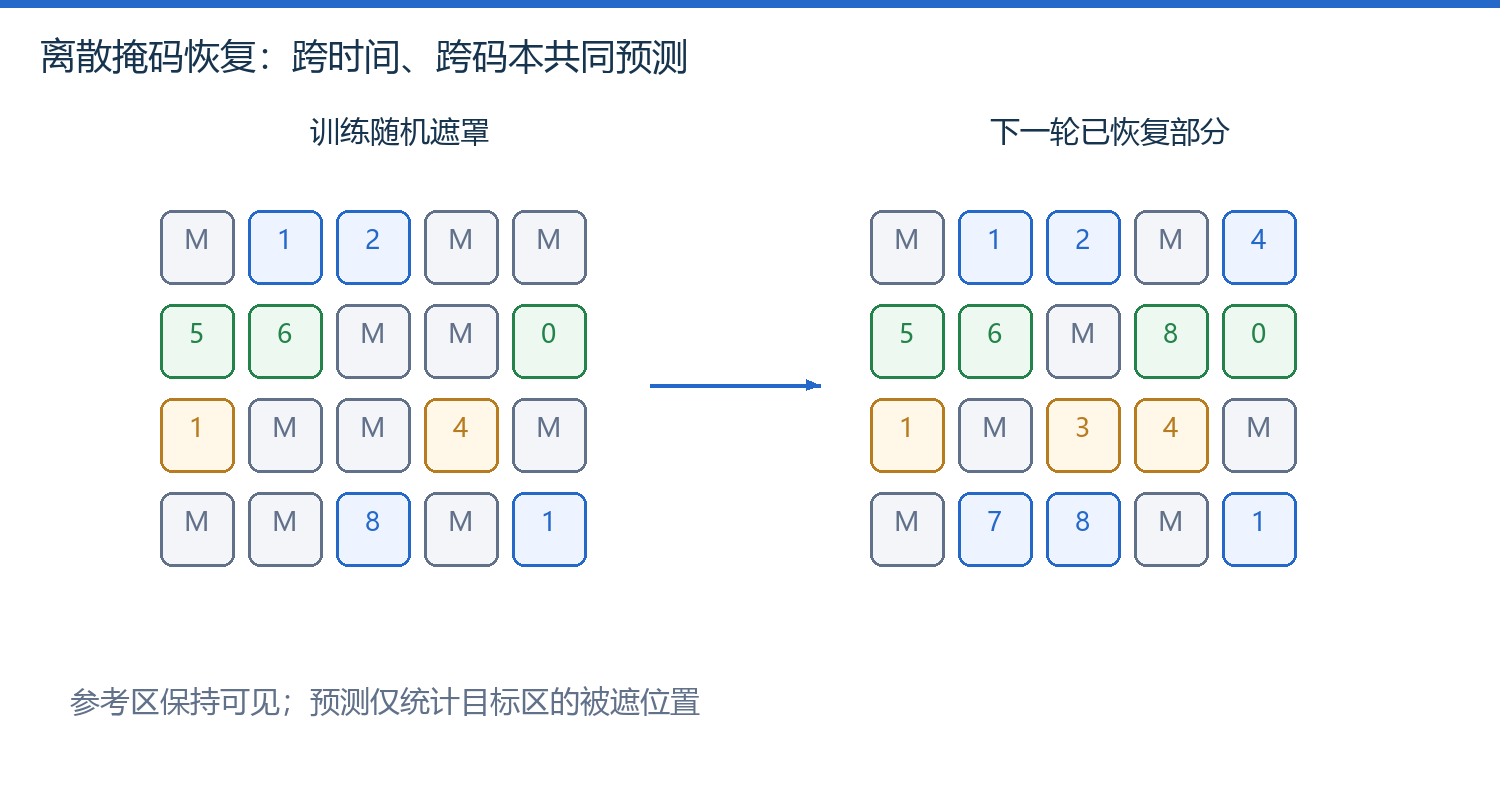
图 2|跨时间与跨码本随机遮罩,而不是只遮一整层
若遮住三个位置,模型给正确编号的概率为 0.5、0.25、0.8,三项损失之和约为 2.3026。没有遮住的位置可以作为条件读取,不应因为它已经可见就被算成一个“预测成功”的样本。
3. 推理不是一次填完所有格子
报告使用多步解掩码:每次预测分布、按置信与调度选择待填位置,再赋值,直到完成。它还使用层偏置与引导来组织恢复顺序。目标总时长通过参考时长与不同文字系统的字符权重估计,说明 NAR 同样需要处理长度。
| 对照 | 保持不变 | 检查 |
|---|---|---|
| 改解掩码步数 | 参考、文本、时长 | 质量与延迟曲线 |
| 改长度估计 | 相同目标内容 | 是否挤压发音、出现拖尾 |
| 改遮罩策略 | 数据与模型规模 | 学习效率与各层错误 |
并行恢复利用双向目标上下文,给离散 TTS 提供了 AR 之外的扩展路线。
“600 多种语言覆盖”不等于每种语言都经过同等规模盲听;论文的广覆盖评测与完整支持列表需要分开阅读。
截至本轮核对,不能把仓库中的未合并流式提案写成已完成的严格文字流式能力。双向目标建模与在线因果约束存在实际张力,需专门的分块和状态设计。返回 2026 年进展。
正在连接 GitHub 评论…