01|VITS:变分推断、随机时长与波形联合训练
VITS 将文本条件的潜变量建模与波形生成放进同一训练框架。它不要求推理时先输出一个显式 mel 再调用外置声码器,但训练时仍会使用频谱监督。论文 · 官方实现
训练从真实录音学习后验;推理只能从文本条件先验采样。
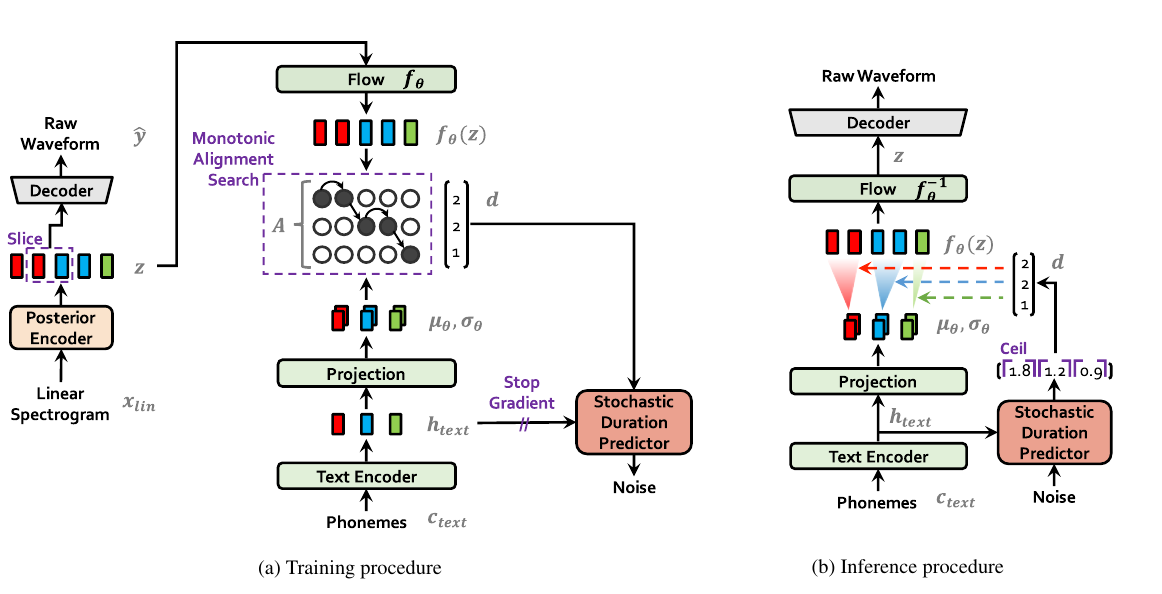
图 1|VITS 的训练后验路径与推理先验路径
1. 两条路径共享哪些部分
| 模块 | 训练用途 | 推理是否需要 |
|---|---|---|
| posterior encoder | 真实线性频谱 → 潜变量分布 | 不需要目标录音后验 |
| text encoder + flow | 文本条件先验与潜变量密度匹配 | 需要,反向 flow 生成潜变量 |
| MAS | 从潜变量与文本得分估计时长 | 不需要,使用预测时长 |
| stochastic duration predictor | 学习时长分布 | 从噪声生成可变节奏 |
| waveform decoder | 潜变量 → 波形 | 需要 |
| discriminator | 真实/生成波形反馈 | 不需要 |
2. KL 项怎样连接文本与录音
完整 VITS 的先验经过 flow。先用不带 flow 的一维高斯例理解 KL,再回到原架构;以下公式是教学特例,不是把论文整个目标简化成单个 KL。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 由录音得到的高斯后验。 | |
| 由文本条件给出的高斯先验,本教学例尚未加入 flow。 | |
| 后验均值。 | |
| 先验均值。 | |
| 后验标准差,必须大于 0。 | |
| 先验标准差,必须大于 0。 | |
| 后验相对先验的散度;使用自然对数时单位为 nats。 | |
| 表示散度的有方向比较,不是除法或向量范数。 |
取后验均值 1、先验均值 0,两个标准差均为 1:对数比为 0,分式为 ,减去 0.5 后得到 0.5 nats。若均值也一致,散度变成 0。这说明 KL 在促使推理时可用的文本先验覆盖训练录音中的潜变量。
flow 提高先验表达力,波形判别和重建约束共同保留听感细节。
3. 多种随机性分别控制什么
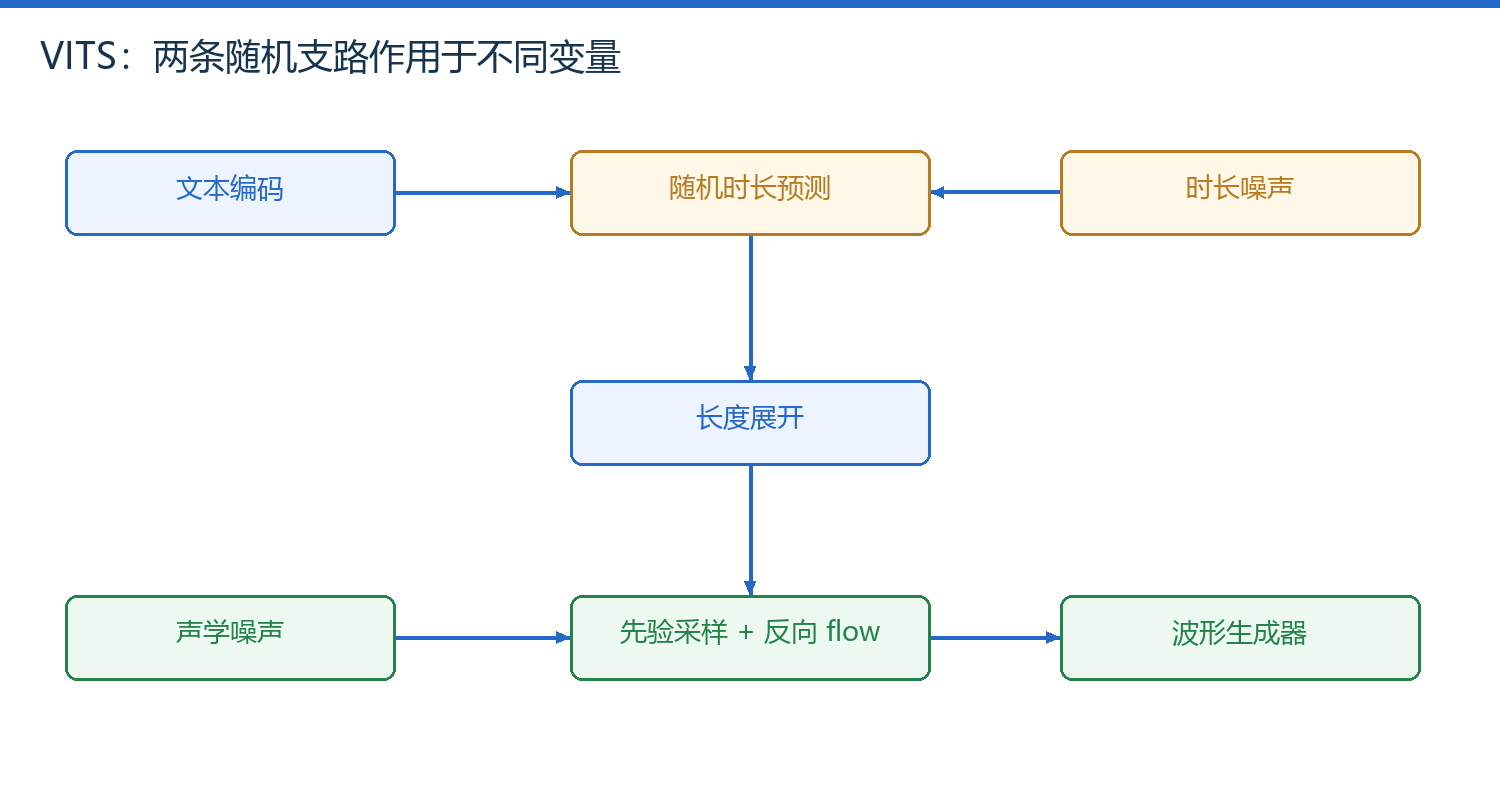
图 2|时长噪声与声学潜变量噪声进入不同分支
| 干预 | 主要影响 | 验证方法 |
|---|---|---|
| 固定时长随机种子 | 稳定分配给各音素的帧数 | 比较生成时长 |
| 改变声学噪声幅度 | 改变潜变量采样的变异程度 | 固定文本与时长进行听感对照 |
| 改变整体长度系数 | 改变语速 | 检查音素比例是否保留 |
较大的噪声不保证更自然,较小的噪声也不保证最接近参考说话人。随机时长解决“一句话有多种合理节奏”的建模需求,不能替代准确的文本与录音配对。
把 posterior encoder 留在推理链路并输入目标录音,会把重建任务误当成 TTS。
4. 训练排错顺序
先在小批量检查 MAS 是否覆盖文本,再核对随机裁剪的潜变量片段与真实波形片段的采样边界,然后检查 mel 重建、KL、判别器梯度。只看合成器总损失容易掩盖某一项失衡。GPT-SoVITS 的早期声学解码继承 VITS 类组件,但加入语义 token、参考条件与版本分支;详见 GPT-SoVITS 解码路径。
正在连接 GitHub 评论…