02|文本与声学对齐:ConvNeXt 文本建模与 DiT 主干
F5-TTS 没有显式的逐音素时长展开器,但它仍需要把短文字序列与长声学序列建立对应。它先将文本补到声学长度,通过专门的 ConvNeXt 文本模块准备特征,再与噪声状态和可见参考频谱一起送入 DiT。没有显式时长标签,不等于没有长度约束或对齐学习。
本篇以原论文的 F5-TTS 结构为主,不把后续模型权重变体的全部实现细节倒填进首版。原论文 §3 · DiT 实现
文本补齐只统一张量长度;文字与发声位置的对应关系仍需要网络学习。
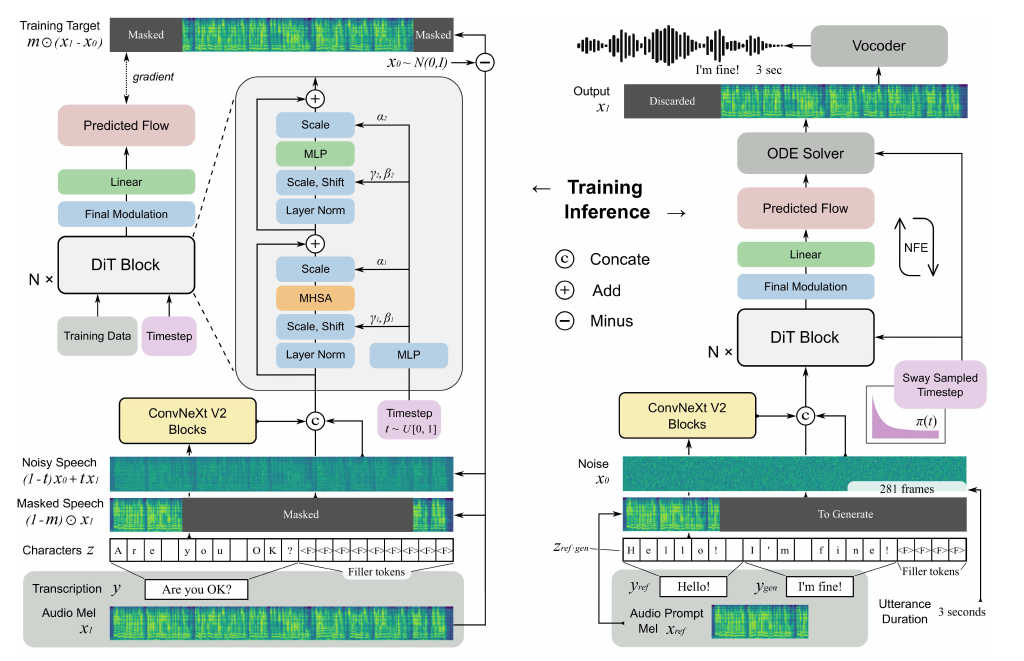
图 1|F5-TTS 训练补全与推理积分的原始架构
1. 三路输入的定义与张量形状
| 输入 | 教学轴顺序 | 信息来源 | 是否包含目标答案 |
|---|---|---|---|
| 带噪声状态 | [B,T,F] | 训练中插值;推理中 ODE 当前状态 | 训练时受目标参与构造 |
| 可见条件 mel | [B,T,F] | 参考或未遮盖语音 | 目标生成区必须遮掉 |
| 文本特征 | [B,T,H] | 全部参考文字与目标文字 | 提供要说的内容 |
| 流时间 | [B] | 区间 0 到 1 的当前时间 | 描述去噪进程,不是音频位置 |
其中 B 是批大小、T 是总 mel 帧数、F 是 mel 频带数、H 是文本隐藏维度。实际源码可能换轴顺序;本文先固定 [B,T,*],避免把特征拼接误写成时间拼接。
2. 文字补齐与显式时长调节的区别
假设有 3 个文字 token、8 帧声学位置:
| 做法 | 长度 8 的序列 | 先验约束 |
|---|---|---|
| F5 式补 filler 的教学示意 | A B C F F F F F | 不指定 A/B/C 各占几帧 |
已知时长 [2,1,5] 的展开 | A A B C C C C C | 明确指定每个文字的时长 |
F 是 filler 符号而非真实字符。它有自己的嵌入约定,不能把字符串字母 F 当 filler 填进实际输入。若文字 token 数已经超过预定声学长度,系统需要处理长度或截断边界;不能靠相同 shape 掩盖内容丢失。
ConvNeXt 沿文本扩展序列建模,给有效文字与 filler 周围的表示提供更合适的结构,之后才和声学特征融合。它不是一个可读出的硬时长表,也没有自动证明每个文字只对应某段固定帧。
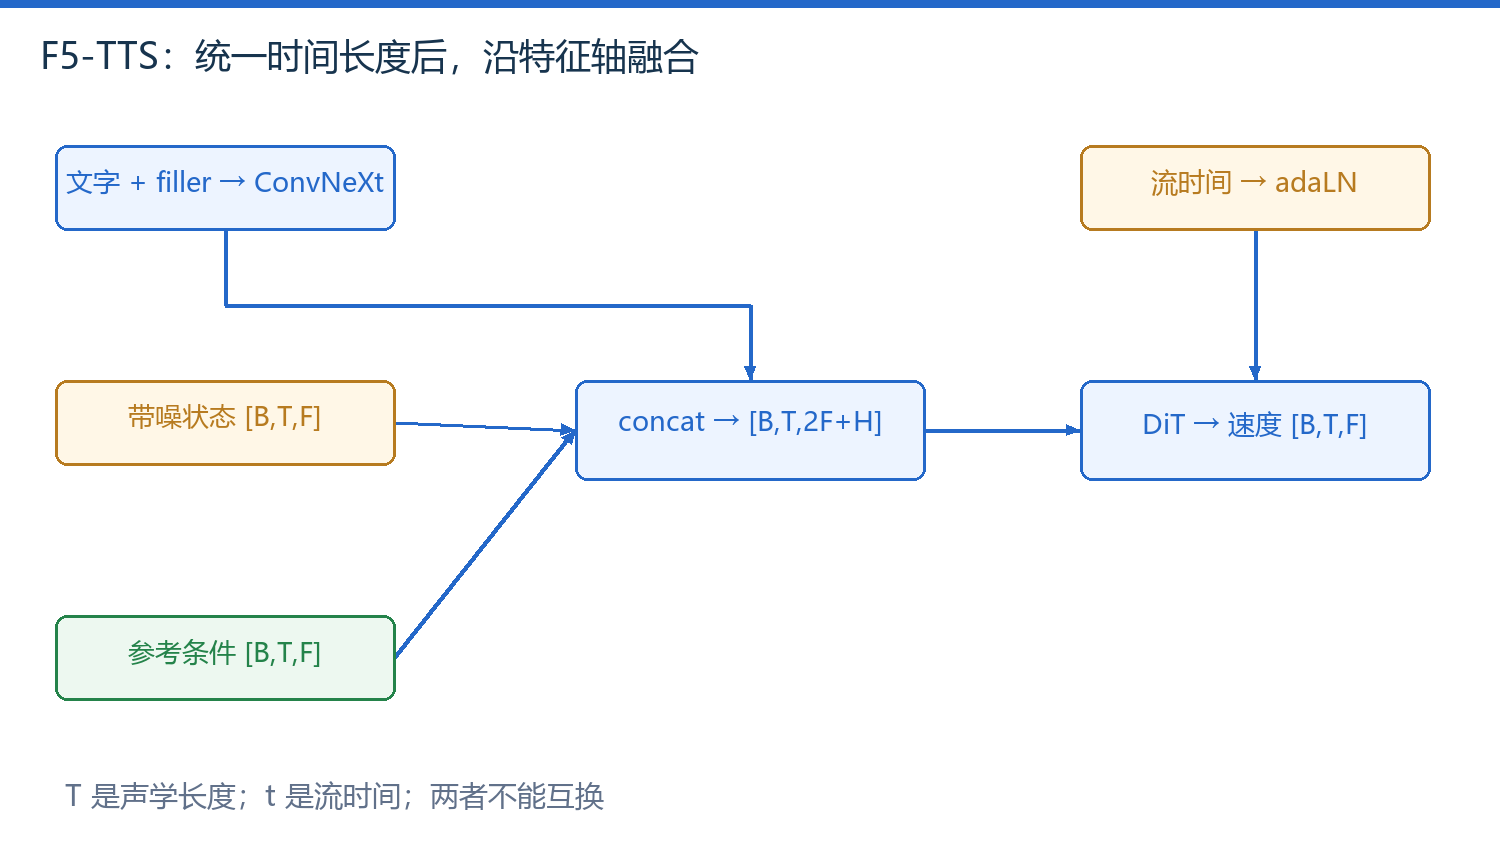
图 2|三路特征在通道维拼接,流时间通过条件归一化进入
3. DiT 的输入融合与条件注入
以下是接口级表达,不把每个实现细节写成单一公式:
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 流时间 t 的带噪声学状态,[B,T,F]。 | |
| 参考条件 mel,未知区域为零,[B,T,F]。 | |
| 补齐后的文本编号及经嵌入/ConvNeXt 得到的特征,[B,T,H]。 | |
| 沿特征维拼接,结果 [B,T,2F+H],不是沿时间维拼接。 | |
| 线性映射到主干宽度 D,得到 [B,T,D]。 | |
| 流时间条件与网络参数。 | |
| 预测速度场,[B,T,F],每个元素对应当前状态的变化速度。 |
若 F=2、H=4、D=8,每个时间位置拼成 2+2+4=8 维,T=5 时仍然只有 5 个位置。把三路拼在时间轴上得到 15 个位置,会改变注意力关系及输出语义。
4. adaLN-zero 的条件控制
时间嵌入产生归一化的缩放、平移与残差门控参数。一个教学化子层可写成:
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 按隐藏维归一化;不把不同句子的统计混合。 | |
| 时间条件生成的缩放、平移、门控向量,广播到时间位置。 | |
| 逐元素乘法。 | |
| 这里代表注意力子层;实际块还含前馈子层与对应参数。 | |
| 残差更新前后的主干状态。 |
当门控 g 初始化为 0,该残差支路初始不改变 U;随着训练再逐步使用条件分支。这说明 zero 指初始化策略,不是推理时把所有条件置零。若取单个位置 U=2、子层输出 3、门控 0.2,残差后为 2+0.2×3=2.6。
流时间告诉网络当前状态有多接近数据分布,位置编码告诉它当前位于音频序列哪里。
5. 对齐错误与采样误差的诊断
| 现象 | 先固定 | 对照变量 |
|---|---|---|
| 文本漏读、拖尾 | 参考及随机种子 | 总时长、文字规范化 |
| 内容正确但音质粗糙 | 长度与文字 | ODE 步数、声码器接口 |
| 模仿到错误发音 | 目标文本 | 参考转写是否准确 |
| 短句正常长句退化 | 音色、推理参数 | 分句与上下文长度 |
整段双向注意力不等于严格在线流式;目标区域的未来位置在一次前向中通常彼此可见。
下一篇 CFM 训练与掩码解释速度标签如何构造。
正在连接 GitHub 评论…