02|Tacotron:文本到声学特征的端到端建模
Tacotron 要解决的关键问题是:没有逐字时间标注,怎样把一串字符变成长度大得多的语音特征序列? 它让文本编码、软对齐和声学预测一起从“文字—录音”配对数据学习。读者需要具备神经网络、卷积和反向传播基础;音频表示、对齐和合成流程会从头定义。
本文以 2017 年原版 Tacotron 为主线。原版最后使用 Griffin–Lim 恢复波形;Tacotron 2 的 WaveNet 声码器、位置敏感注意力与停止预测属于后续设计,不能倒填进原版。原论文 · 官方试听
1. 技术位置与建模对象
Tacotron 学习“文字在什么时候读成什么声音特征”;WaveNet 学习音频采样点的条件分布。
| 比较对象 | 输入与输出 | 主要建模难点 |
|---|---|---|
| 传统分阶段 TTS | 文本分析、时长、声学参数、波形分别处理 | 组件接口与误差传播;人工设计较多 |
| 原版 Tacotron | 字符 → mel 频谱 → 线性频谱 → 波形 | 联合学习文本对齐和连续声学序列 |
| WaveNet | 历史波形与可选条件 → 下一个采样点分布 | 高频率采样点的依赖与逐点生成成本 |
| Tacotron 2 | 文本 → mel 频谱;条件 WaveNet → 波形 | 重新设计声学网络,并使用神经声码器改善波形生成 |
WaveNet 并非只能接在 Tacotron 后面;原始 WaveNet 的 TTS 实验使用语言学等条件。这里比较的是它们建模的对象,不是宣称 2017 年 Tacotron 已由 WaveNet 输出声音。WaveNet 专题 · Tacotron 2 论文
2. 整体架构与数据流
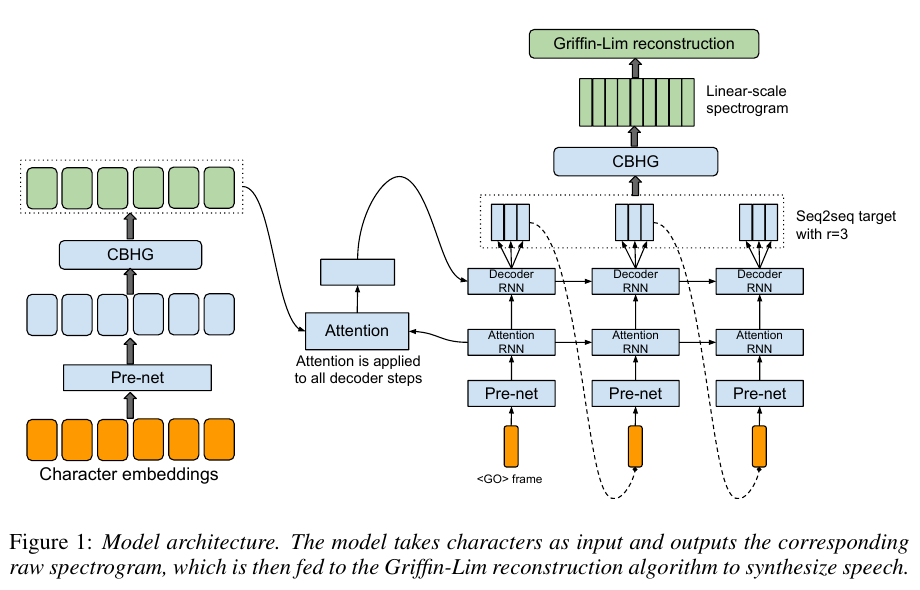
图 1|原版 Tacotron 的文本、对齐与声学预测路径
图从左下的字符开始,向上形成文本记忆;右侧解码器反复读取这份记忆,并逐组输出 mel 帧。顶部 CBHG 后处理网络再将整段 mel 预测转为线性频谱。图中的三步仅用于展开反馈过程,实际解码步数由语音长度决定。
| 阶段 | 数据形式 | 负责的工作 |
|---|---|---|
| 文本输入 | 个字符 ID | 将规范化文本映射为离散输入,不是语音采样点 |
| 编码器 | 每个字符对应一个 256 维向量 | 汇集局部字符组合和前后文 |
| 注意力 | 每个解码步有 个权重 | 决定当前声学输出主要读取哪些字符位置 |
| 解码器 | 每步输出 个 80 维 mel 帧 | 建模语音随时间的变化 |
| 后处理网络 | 每帧 1025 个线性频率格 | 为波形重建补充更细的频率表示 |
| Griffin–Lim | 一维波形 | 迭代估计缺失的相位 |
是文本位置数; 是每步预测的帧数。原论文架构图用 示意,参数表与 MOS 实验使用 。原图示意配置不等于实验配置。
“端到端”在这里指核心文本到频谱网络可联合训练,不等于没有音频预处理,也不等于用波形损失训练所有步骤。
3. 长度差异与注意力的必要性
一句话的字符数由文本确定,录音时长还取决于发音、停顿和语速。一个字符通常对应多帧,空格与标点也可能影响停顿;直接把第几个字符配给第几帧并不成立。
| 教学估算:约 1 秒音频 | 数量 | 与文本长度的关系 |
|---|---|---|
| 24 kHz 波形 | 24,000 个采样点 | 一个采样点仅约 0.0417 ms |
| 12.5 ms 帧移的频谱 | 约 80 帧 | 帧数会因边界补齐约定略有差别 |
| 的解码器 | 约 40 步 | 每步生成两个不同的帧,不是复制一帧 |
| 假设 10 个字符 | 10 个文本位置 | 平均比例不能代替实际对齐 |
注意力把“当前位置该读取哪段文字”变成可微的加权读取,时长由多次读取同一位置自然体现。
4. 分层阅读路线
| 文章 | 读完能完成的任务 |
|---|---|
| 01|声学表示与 CBHG 编码 | 区分采样点、频谱帧和字符位置;解释 mel 与线性频谱;画出卷积 bank 和 highway 的分支 |
| 02|注意力对齐与多帧解码 | 手算注意力权重与 context;写出 的训练、推理输入索引 |
| 03|联合训练与波形重建 | 解释两项损失、相位恢复和结束问题;用对齐图排查重复与漏读 |
| 04|PyTorch 实现与结构验证 | 将公式对应到类、张量与状态;运行验证并解释结果的边界 |
| 附录|教学实现完整源码 | 获取可运行脚本、依赖、输入和输出记录 |
每篇只承担一个主要理解目标。正文先给图和接口,再给必要代码;完整程序独立放在附录,不要求读者通过阅读整份代码来推测架构。
5. 本专题的实验范围
| 内容 | 完成范围 |
|---|---|
| 原理与原始配置 | 对照原论文 §3–4 与表 1;代表性原图用于讲解 |
| 可运行实现 | 缩小的 CBHG、加性注意力、分组自回归解码器 |
| 实际验证 | 手算一致性、padding 掩码、目标索引扰动、训练反传、推理输出形状 |
| 尚未执行 | 真实语音训练、完整后处理与 Griffin–Lim 合成、音质评测 |
代码结果可以证明指定测试范围内的计算和索引关系;不能据此声称训练出了可用 TTS。下一篇从“网络究竟预测什么数值”开始。
正在连接 GitHub 评论…