附录|WaveNet 代码架构、运行入口与完整源码
这份脚本做一件具体的事:用四条可控谐波检查条件 WaveNet 的数据、训练和生成链路。读本页先看架构图与接口表,就能知道代码的职责和入口;完整脚本放在最后供复制,不需要先逐行读完。
1. 代码模块与调用关系
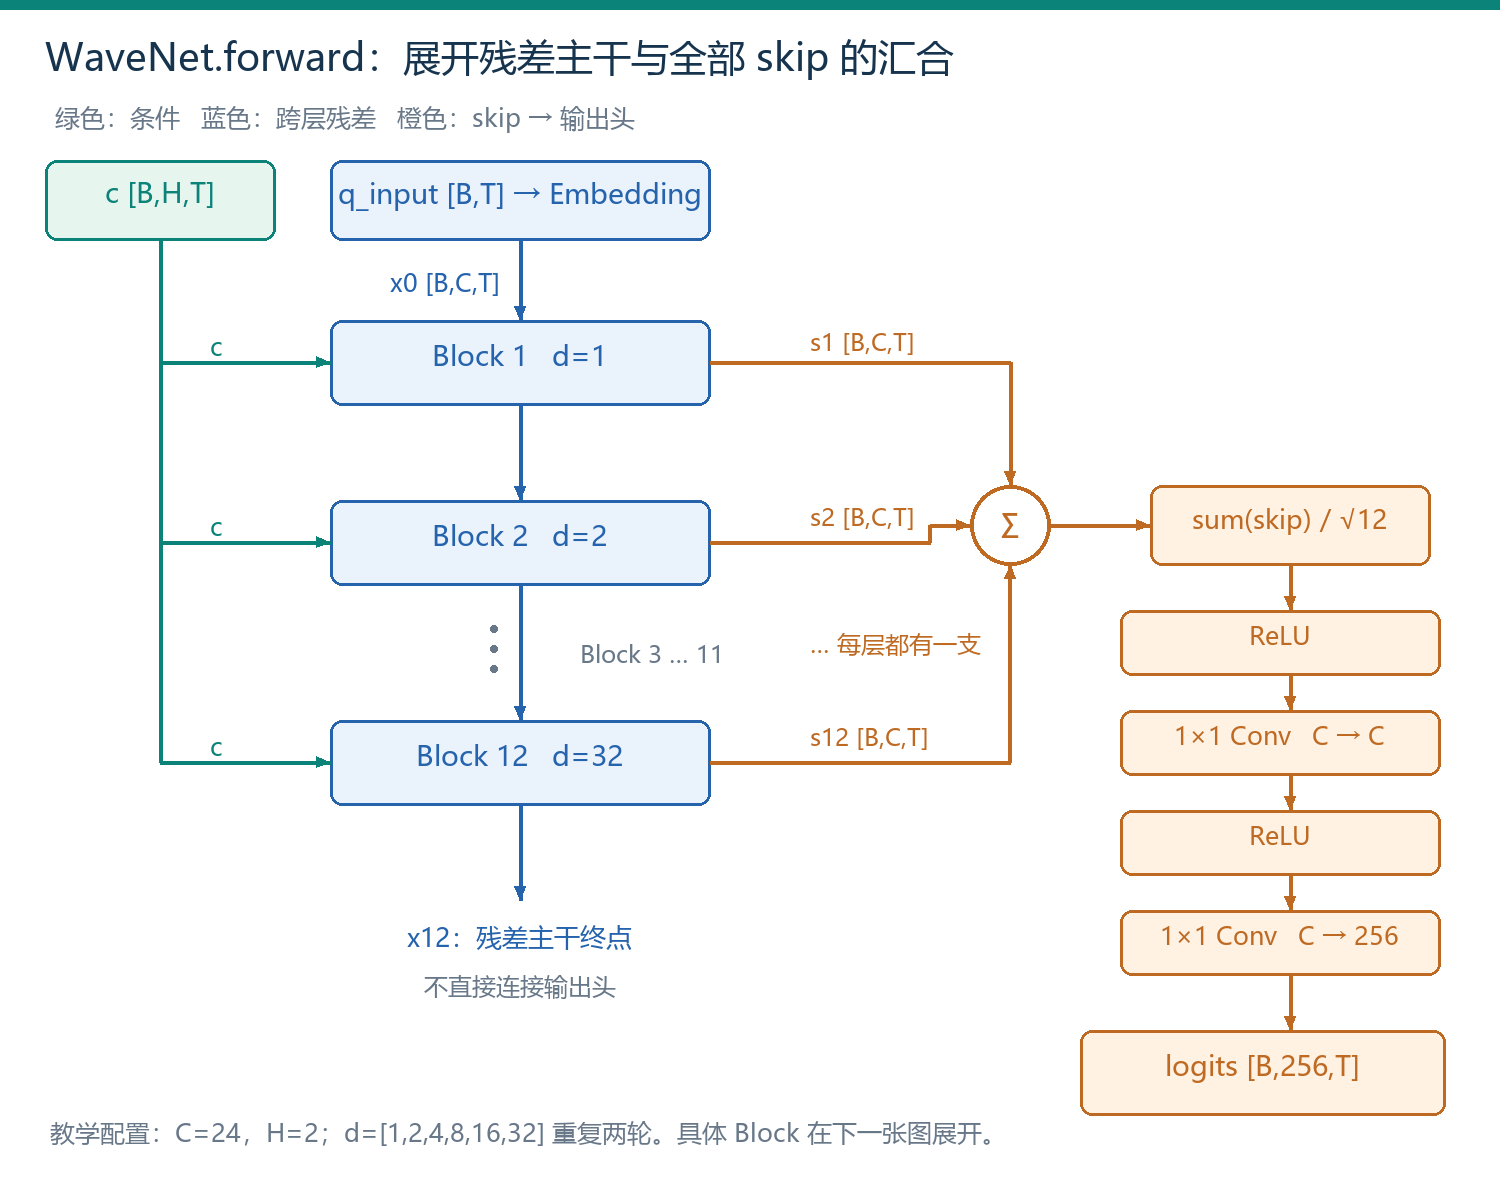
图 1|代码模块与计算架构
先沿中间主干看 WaveNet 包含什么:一个 Embedding、12 个 Block、一个 head。再进入 Block:它拥有 CausalConv、condition、residual 和 skip 四个子模块。最后沿橙色边检查每一份 skip 如何进入求和与输出头。绿色支路把同一时间轴的条件送入每个块;每块的条件投影参数独立。main 的实验组织职责与 step 的逐点接口见下表,下一张图再沿时间展开生成过程。
图中的 [4,24,512] 依次是批大小、隐藏通道、时间长度。类别数是 256,条件通道数是 2。方框里的数字都与下方默认代码一致;“24 维 embedding”和“256 类输出”承担不同角色。
| 对象 | 输入 → 输出 | 读代码时要抓住的约定 |
|---|---|---|
| mu_encode / mu_decode | 浮点振幅 ↔ long 类别 | 改数值表示,不改时间点数;解码有量化误差 |
| CausalConv.forward | [B,C,T] → [B,2C,T] | 只左补零,核位置顺序为旧→当前 |
| Block.forward | 隐藏 与目标条件 → 残差 、skip | 两个返回值分开走;chunk 沿通道轴 |
| WaveNet.forward | [B,T] 和 [B,H,T] → [B,256,T] | 所有 skip 相加后进入输出头 |
| initial_state | 批大小 → 每层一个 [B,C,d] 队列 | 每条新音频重置,零是隐藏向量 |
| WaveNet.step | [B]、[B,H]、state → [B,256]、新 state | 一次处理一个历史采样点,预测下一点 |
| generate | seed [B]、条件 [B,H,N] → 类别 [B,N] | 是新生成点数;输出不含给定 seed |
| verify | 模型 → 结构检查结果 | 同一固定输入比较两条计算路径 |
| main | 命令行参数 → metrics.json、toy_weights.pt | 准备数据、检查、训练、再次检查、生成 |
接口中的维度说明
| 数学记号 | 含义、单位与示例 |
|---|---|
| 批大小。 | |
| 隐藏通道数。 | |
| 输入网络的时间长度。 | |
| 条件通道数。 | |
| 某一层的膨胀率。 | |
| 生成接口中要追加的新采样点数。 |
这些量都是计数,不以秒为单位;时间长度需要用点数除以采样率。
2. 训练与生成的执行路径
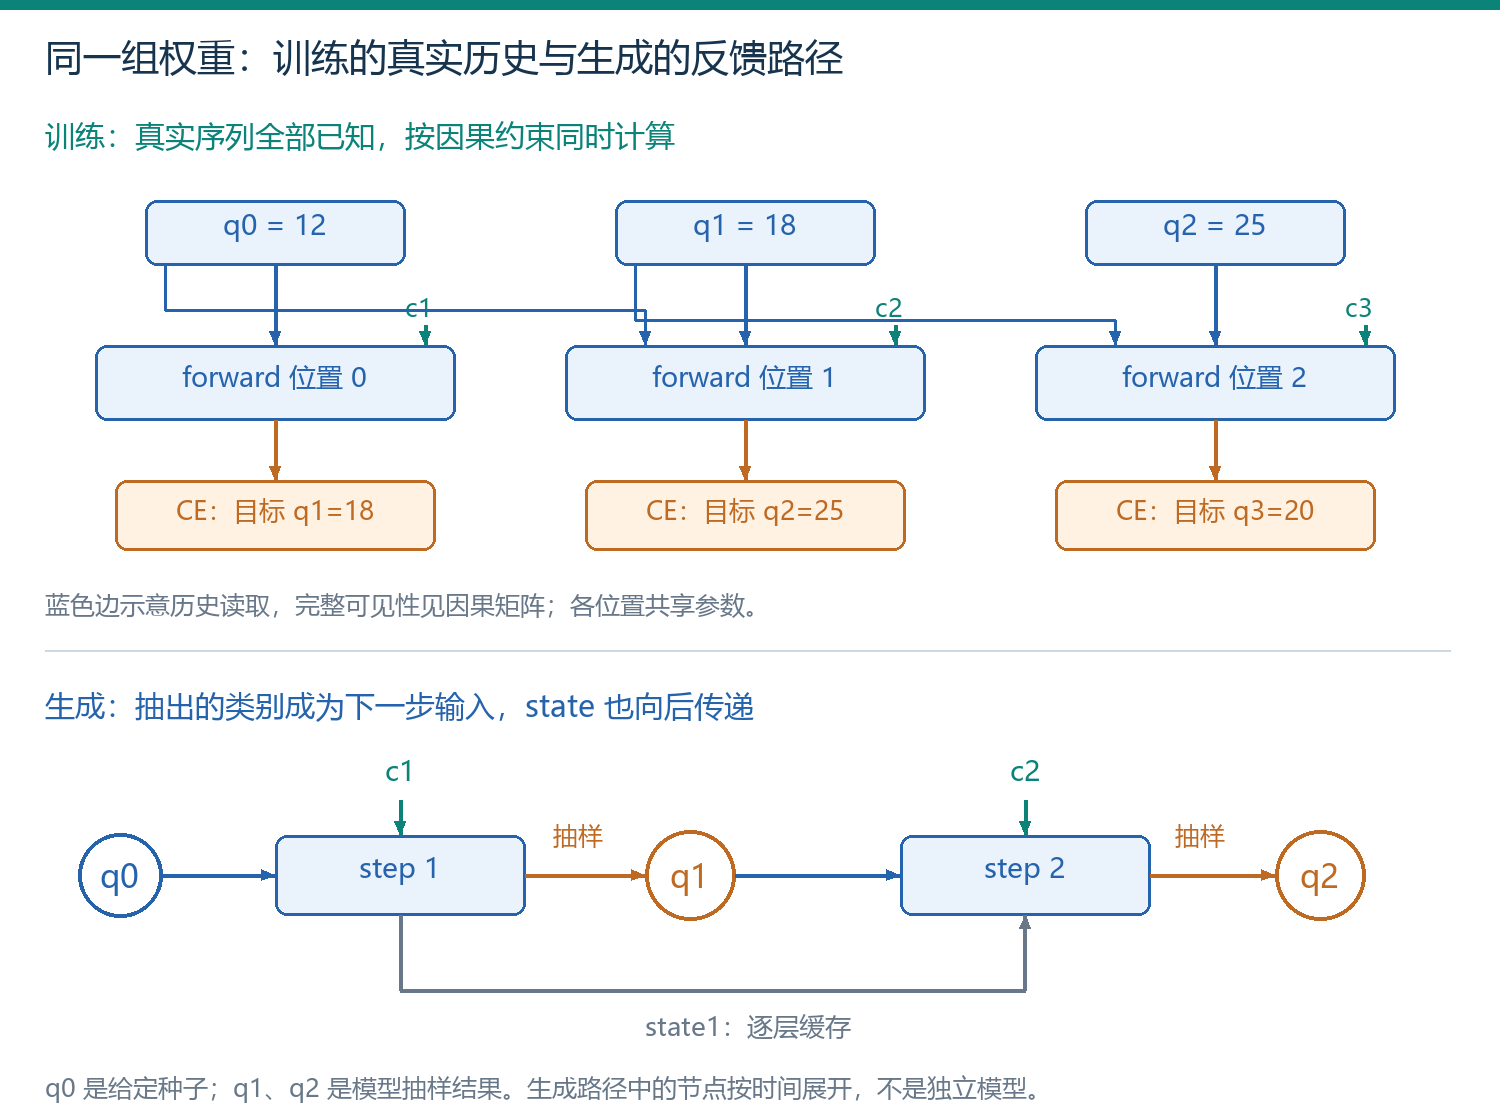
图 2|训练与生成的执行路径
对照时间展开图,按下表追踪两条调用链:
| 阶段 | 训练路径 | 自由生成路径 |
|---|---|---|
| 准备 | main 构造 inp,target,aligned_cond | generate 初始化零 state 与 seed |
| 主网络 | WaveNet.forward | 每轮调用 WaveNet.step |
| 块内计算 | Block.forward → CausalConv.forward | Block.step 读取并更新本层队列 |
| 输出处理 | logits 进入损失,优化器更新参数 | logits → softmax → 抽样 |
| 下次使用的历史 | 数据中的真实历史 | 刚抽到的类别与更新后的 state |
以 [12,18,25,20] 为例,训练输入是 [12,18,25]、标签是 [18,25,20],一次 forward 计算三个位置。生成只有 seed 已知;若抽到 ,下一步必须输入 。生成时参数不变,变化的是历史与缓存。
第一次读只需追踪这两条路线。verify 负责证明它们在固定输入上相符;参数解析、JSON 写出、计时等外围代码可在真正运行时再看。想深挖一个函数时,返回导读进入相应专题:编码看 01,因果卷积看 02,Block 看 03,损失看 04,step 看 05,测试证据看 06。
3. 运行环境、输入与产物
将最后一节代码保存为 wavenet_minimal.py。已验证环境为 Windows、Python 3.12.14、PyTorch 2.14.0+cpu。训练只依赖标准库和 PyTorch,不需要下载语音数据或使用 GPU。
python -m venv .venv
.\.venv\Scripts\python.exe -m pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
.\.venv\Scripts\python.exe wavenet_minimal.py --steps 300 --out results
--steps 300 表示进行 300 次参数更新,记录中 step=0 是更新前损失;--out results 指定输出目录。已有兼容环境可直接执行最后一行。部分环境提示缺少 NumPy,但本脚本没有使用 NumPy 转换。
运行后先核对 metrics.json,再判断是否需要阅读具体实现:
| 产物或字段 | 预期检查 | 含义 |
|---|---|---|
| 参数总数、感受野 | 、 | 结构配置与教程一致 |
| 生成 shape | [1,128] | 短序列生成检查完成 |
| 结构断言 | 全部通过 | 对应的数值与索引测试通过 |
| loss | 已有实测约 | 小样本拟合结果;不要求跨机器逐位相同 |
toy_weights.pt | 仅对应四条人工信号 | 不能用于朗读文本 |
脚本不输出 WAV,不包含文本前端、说话人编码器或真实语音训练集。
4. 实现约定与常见错误
| 看到的实现 | 原因 / 边界 |
|---|---|
| 类别 embedding、24 通道、12 块 | 为可观察的小实验选定;不是原论文完整训练配置 |
| 残差除以 √2,skip 总和除以 √ | 本实现的尺度控制; 是块数 12,不是序列长度 |
| 前 −1 个输出不直接计分 | 是感受野 127;让计分处具备完整真实历史 |
条件 [F0/250,A] | 是 Hz,250 是归一化参照频率; 是振幅系数 |
| state 使用 torch.cat | 易读、便于核对索引,会复制队列;没有实现生产级环形缓冲 |
| float32 / float64 都验证 | 区分浮点累加误差与缓存索引错误 |
下一节是完整可运行参考。理解结构后,只需按表定位关心的类;复制运行时则保留整个文件,不能只复制某个依赖其他类的片段。
5. 完整实现源码
代码保持与已执行实验一致。以下是一个文件,不需要把多个零散片段自行拼接。
"""Educational conditional WaveNet; synthetic plumbing test, not a speech model."""
import argparse
import copy
import json
import math
import platform
import time
from pathlib import Path

import torch
from torch import nn
from torch.nn import functional as F


def mu_encode(x, mu=255):
    x = x.clamp(-1, 1)
    y = x.sign() * torch.log1p(mu * x.abs()) / math.log1p(mu)
    return ((y + 1) * mu / 2).round().long()


def mu_decode(q, mu=255):
    y = 2 * q.float() / mu - 1
    return y.sign() * torch.expm1(y.abs() * math.log1p(mu)) / mu


class CausalConv(nn.Module):
    def __init__(self, channels, dilation):
        super().__init__()
        self.dilation = dilation
        self.conv = nn.Conv1d(channels, 2 * channels, 2, dilation=dilation)

    def forward(self, x):
        return self.conv(F.pad(x, (self.dilation, 0)))

    def step(self, x, history):
        # x: [B,C], history: [B,C,d]; weights ordered old -> current.
        w = self.conv.weight
        y = F.linear(history[:, :, 0], w[:, :, 0])
        y = y + F.linear(x, w[:, :, 1], self.conv.bias)
        history = torch.cat((history[:, :, 1:], x.unsqueeze(-1)), dim=-1)
        return y, history


class Block(nn.Module):
    def __init__(self, channels, cond_channels, dilation):
        super().__init__()
        self.causal = CausalConv(channels, dilation)
        self.condition = nn.Conv1d(cond_channels, 2 * channels, 1)
        self.residual = nn.Conv1d(channels, channels, 1)
        self.skip = nn.Conv1d(channels, channels, 1)

    def forward(self, x, cond):
        a, b = (self.causal(x) + self.condition(cond)).chunk(2, dim=1)
        z = torch.tanh(a) * torch.sigmoid(b)
        return (x + self.residual(z)) / math.sqrt(2), self.skip(z)

    def step(self, x, cond, history):
        a, history = self.causal.step(x, history)
        a = a + self.condition(cond.unsqueeze(-1)).squeeze(-1)
        f, g = a.chunk(2, dim=1)
        z = (f.tanh() * g.sigmoid()).unsqueeze(-1)
        residual = (x + self.residual(z).squeeze(-1)) / math.sqrt(2)
        return residual, self.skip(z).squeeze(-1), history


class WaveNet(nn.Module):
    def __init__(self, channels=24, cond_channels=2,
                 dilations=(1, 2, 4, 8, 16, 32, 1, 2, 4, 8, 16, 32)):
        super().__init__()
        self.channels = channels
        self.dilations = tuple(dilations)
        self.receptive_field = 1 + sum(dilations)
        self.embedding = nn.Embedding(256, channels)
        self.blocks = nn.ModuleList([
            Block(channels, cond_channels, d) for d in dilations
        ])
        self.head = nn.Sequential(nn.ReLU(), nn.Conv1d(channels, channels, 1),
                                  nn.ReLU(), nn.Conv1d(channels, 256, 1))

    def forward(self, q_input, cond_target):
        # q_input[:,n] predicts q[:,n+1]; cond_target is aligned to q[:,n+1].
        x = self.embedding(q_input).transpose(1, 2)
        skips = []
        for block in self.blocks:
            x, skip = block(x, cond_target)
            skips.append(skip)
        return self.head(torch.stack(skips).sum(0) / math.sqrt(len(skips)))

    def initial_state(self, batch_size):
        p = next(self.parameters())
        return [p.new_zeros(batch_size, self.channels, d) for d in self.dilations]

    def step(self, q_previous, cond_target, state):
        x = self.embedding(q_previous)
        skips, next_state = [], []
        for block, history in zip(self.blocks, state):
            x, skip, history = block.step(x, cond_target, history)
            skips.append(skip)
            next_state.append(history)
        s = torch.stack(skips).sum(0) / math.sqrt(len(skips))
        return self.head(s.unsqueeze(-1)).squeeze(-1), next_state


@torch.no_grad()
def generate(model, seed, cond_future, temperature=1.0):
    """One known seed sample; cond_future [B,H,N] aligns to N new samples."""
    if temperature <= 0:
        raise ValueError('temperature must be positive')
    model.eval()
    state = model.initial_state(seed.shape[0])
    previous, samples = seed, []
    for i in range(cond_future.shape[-1]):
        logits, state = model.step(previous, cond_future[:, :, i], state)
        probs = torch.softmax(logits / temperature, dim=1)
        previous = torch.multinomial(probs, 1).squeeze(1)
        samples.append(previous)
    return torch.stack(samples, dim=1)


@torch.no_grad()
def verify(model):
    model.eval()
    q = torch.randint(0, 256, (2, 80))
    cond = torch.randn(2, 2, 80)
    y = model(q, cond)
    q2, c2 = q.clone(), cond.clone()
    q2[:, 41:] = torch.randint(0, 256, q2[:, 41:].shape)
    c2[:, :, 41:] = torch.randn_like(c2[:, :, 41:])
    causal_error = (y[:, :, :41] - model(q2, c2)[:, :, :41]).abs().max().item()
    state = model.initial_state(2)
    steps = []
    for i in range(q.shape[1]):
        z, state = model.step(q[:, i], cond[:, :, i], state)
        steps.append(z)
    cache_error = (y - torch.stack(steps, dim=2)).abs().max().item()
    bins = torch.arange(256)
    assert torch.equal(mu_encode(mu_decode(bins)), bins)
    assert y.shape == (2, 256, 80)
    assert causal_error < 1e-6
    torch.testing.assert_close(y, torch.stack(steps, dim=2), atol=1e-4, rtol=1e-5)
    # Conv1d and Linear may use different float32 accumulation orders.
    # Double precision independently checks the cache indexing after training.
    precise = copy.deepcopy(model).double()
    full64 = precise(q, cond.double())
    state64, steps64 = precise.initial_state(2), []
    for i in range(q.shape[1]):
        z, state64 = precise.step(q[:, i], cond[:, :, i].double(), state64)
        steps64.append(z)
    cache64_error = (full64 - torch.stack(steps64, dim=2)).abs().max().item()
    assert cache64_error < 1e-10
    # Finite receptive field: earliest input cannot affect final position if T>R.
    long_q = torch.randint(0, 256, (1, model.receptive_field + 8))
    long_c = torch.randn(1, 2, long_q.shape[1])
    before = model(long_q, long_c)[:, :, -1]
    long_q[:, 0] = (long_q[:, 0] + 100) % 256
    rf_error = (before - model(long_q, long_c)[:, :, -1]).abs().max().item()
    assert rf_error < 1e-6
    return dict(causal_max_error=causal_error, cache_max_error=cache_error,
                cache_float64_max_error=cache64_error,
                outside_receptive_field_error=rf_error, quantizer_roundtrip=True,
                output_shape=list(y.shape))


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--steps', type=int, default=300)
    parser.add_argument('--out', type=Path, default=Path('results'))
    args = parser.parse_args()
    args.out.mkdir(parents=True, exist_ok=True)
    torch.set_num_threads(2)
    torch.manual_seed(7)
    model = WaveNet()
    checks = verify(model)
    # Fixed 4-example batch: deliberately an overfit test, no validation set.
    fs = 8000
    t = torch.arange(513) / fs
    f0 = torch.tensor([125., 125., 250., 250.])[:, None]
    phase = torch.tensor([0., 0.7, 0., 0.7])[:, None]
    amp = torch.tensor([0.55, 0.75, 0.55, 0.75])[:, None]
    wave = amp * (torch.sin(2 * math.pi * f0 * t + phase)
                  + .2 * torch.sin(4 * math.pi * f0 * t + 2 * phase)) / 1.2
    q = mu_encode(wave)
    cond = torch.stack(((f0 / 250).expand(-1, 513), amp.expand(-1, 513)), dim=1)
    inp, target, aligned_cond = q[:, :-1], q[:, 1:], cond[:, :, 1:]
    warmup = model.receptive_field - 1
    opt = torch.optim.Adam(model.parameters(), lr=2e-3)
    losses = []
    start = time.perf_counter()
    for step in range(args.steps + 1):
        model.train()
        logits = model(inp, aligned_cond)
        loss = F.cross_entropy(logits[:, :, warmup:], target[:, warmup:])
        if step % 10 == 0 or step == args.steps:
            losses.append({'step': step, 'loss': loss.item()})
        if step == args.steps:
            break
        opt.zero_grad(set_to_none=True)
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        opt.step()
    elapsed = time.perf_counter() - start
    assert losses[-1]['loss'] < losses[0]['loss'] * .7, 'overfit smoke test failed'
    post_checks = verify(model)
    samples = generate(model, q[:1, 0], cond[:1, :, 1:129])
    result = dict(python=platform.python_version(), torch=torch.__version__,
                  device='cpu', seed=7, threads=2, steps=args.steps,
                  parameters=sum(p.numel() for p in model.parameters()),
                  receptive_field=model.receptive_field, sample_rate=fs,
                  elapsed_seconds=elapsed, losses=losses,
                  checks_before=checks, checks_after=post_checks,
                  generated_shape=list(samples.shape),
                  warning='Fixed synthetic training batch; no speech quality/generalization claim.')
    (args.out / 'metrics.json').write_text(json.dumps(result, indent=2), encoding='utf-8')
    torch.save(model.state_dict(), args.out / 'toy_weights.pt')
    print(json.dumps(result, indent=2))


if __name__ == '__main__':
    main()
正在连接 GitHub 评论…