Pretrain|语音 Encoder 预训练
从声音和表示出发,依次看 2018—2024 年的目标设计,再看 2025—2026 年的大规模模型与训练框架,最后比较效果。四篇深读沿这条路线展开公式和代码;下方目录先列大章,章内小节再解释具体机制。
阅读目录
- 1. 预训练学习什么:声音、表示与任务
- 2. 2018—2020:从预测未来到遮挡对比学习
- 3. 2021—2024:目标生成与输入扰动的几条路线
- 4. 2025—2026:大规模多语模型与训练框架
- 5. 效果比较与后续阅读
1. 预训练学习什么:声音、表示与任务
先把音频、声学表示和训练答案分开,再看预训练得到的表示怎样用于识别。
1.1 音频与声学表示
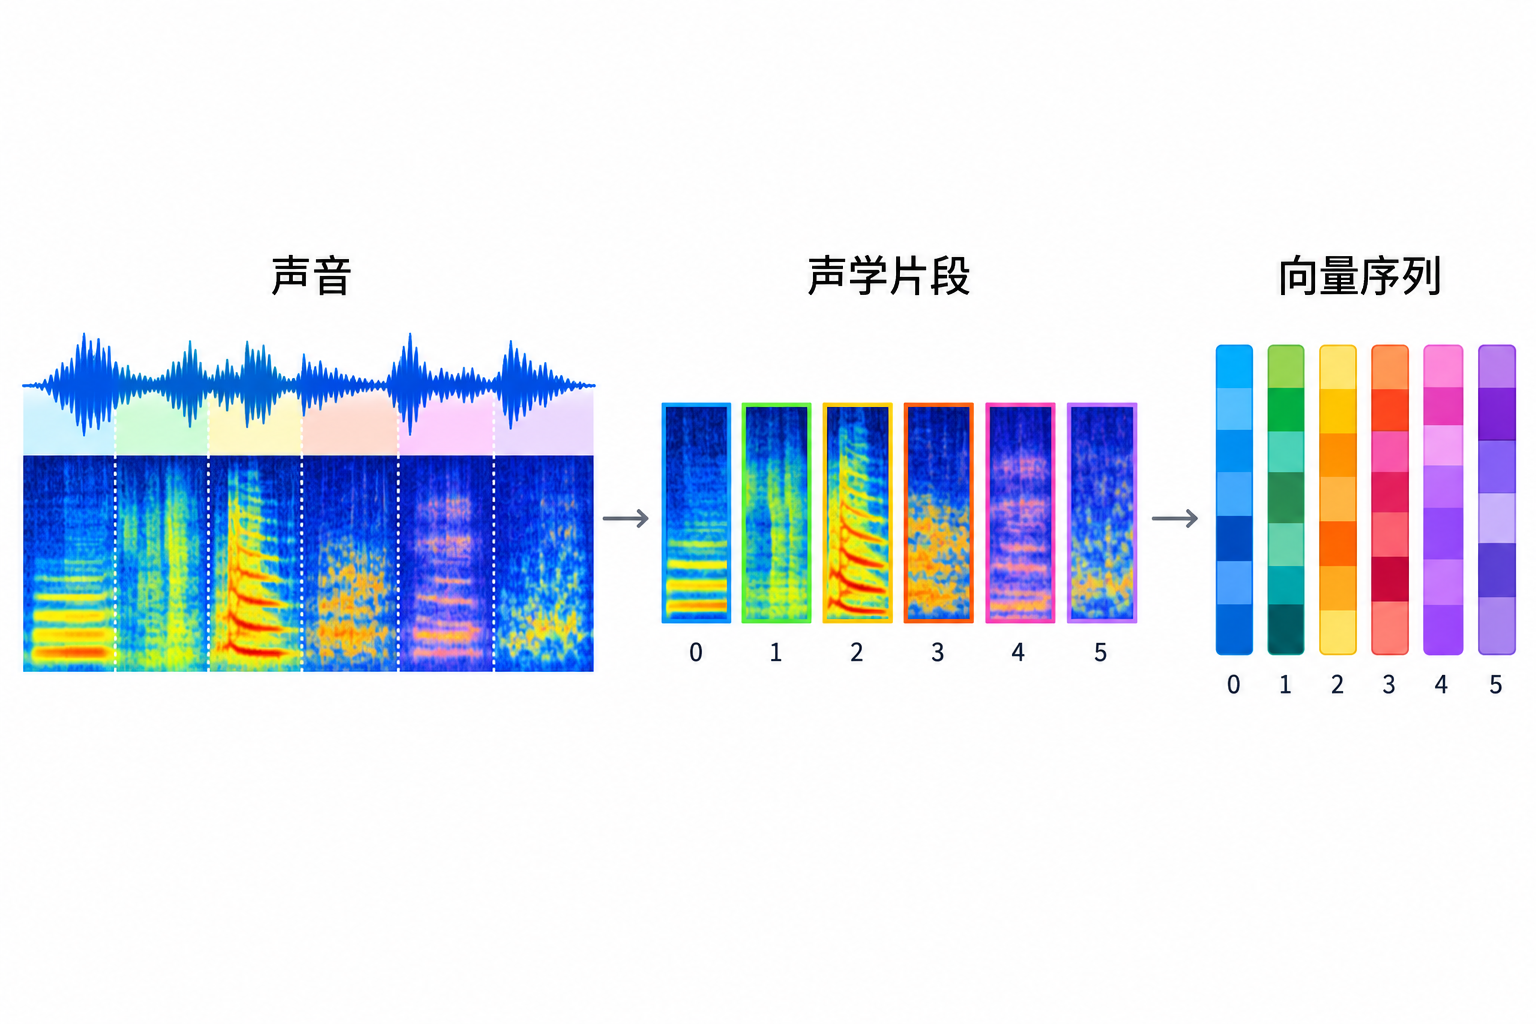
左边听得到的声音,经过声学编码,变成右边随时间排列的向量。ImageGen 教学示意。
沿着蓝、绿、黄这些颜色看:左边是一段连续录音,中间把时间位置示意成几片声学内容,右边每个位置是一列数值。每一列可以记录声音的不同特征,却还不是一个汉字。图里的六片用于说明时间顺序;真实卷积会滑动并重叠,精确长度在深读篇里计算。
把这一过程写成公式:
是音频, 是 encoder。 是一批音频的数量, 是下采样后的时间步, 是每个位置的特征维度。右边这些向量合起来就是 。预训练主要塑造这排表示;之后接什么任务头,决定怎样读出它们。
1.2 由完整声音构造遮挡预测任务
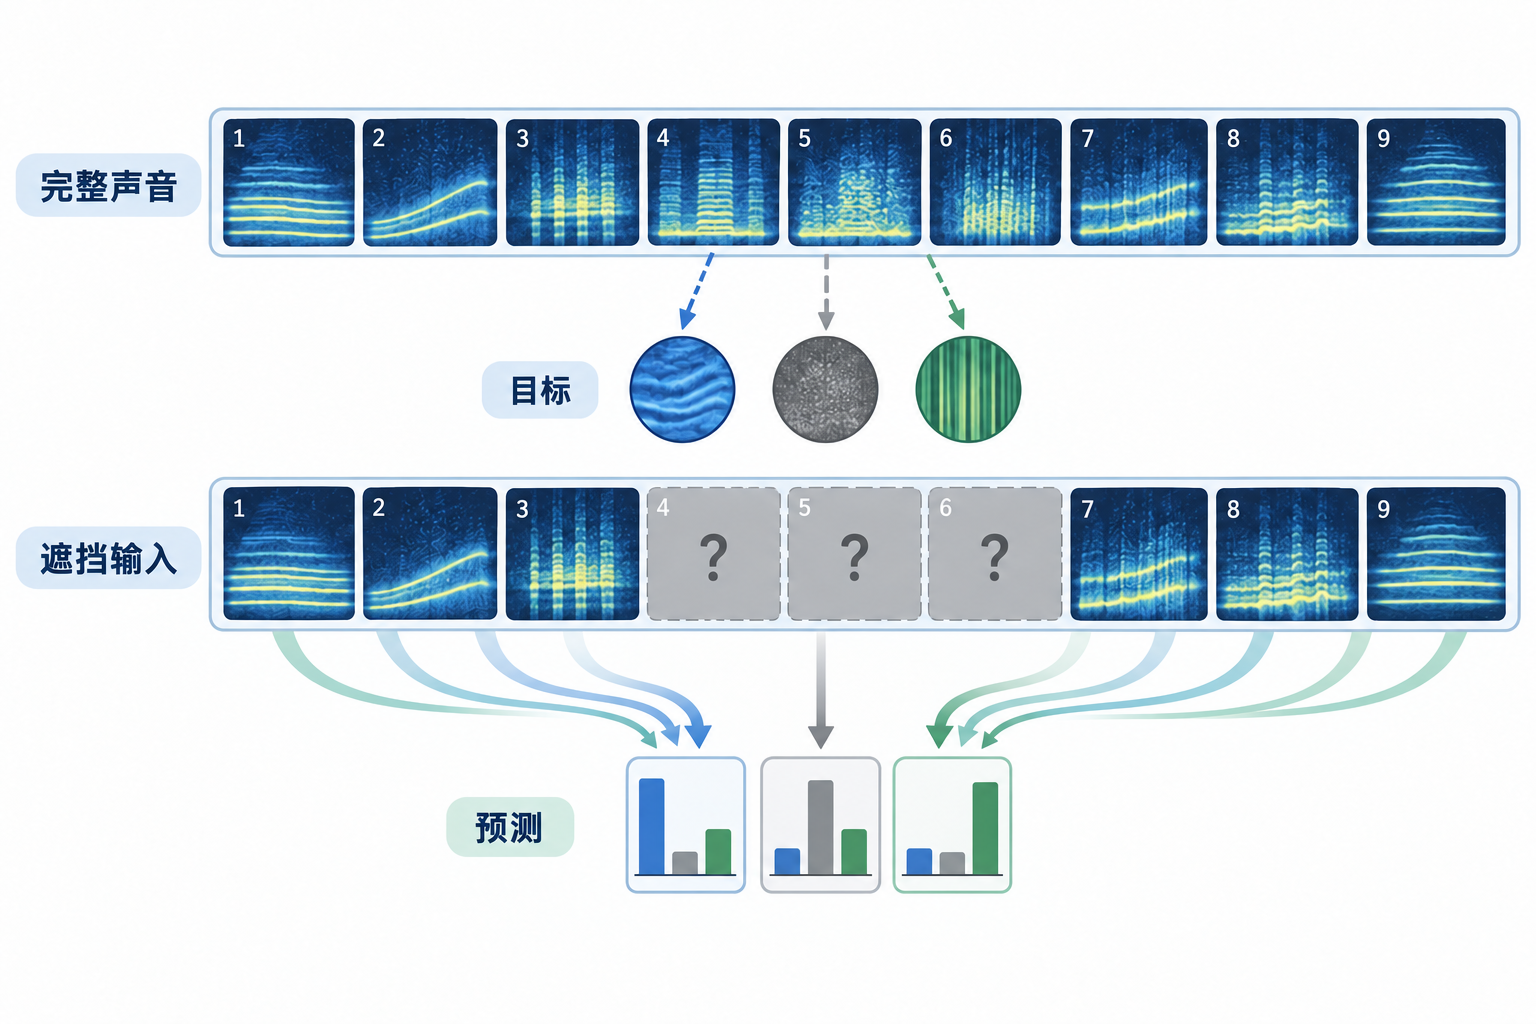
同一段声音,上面完整,下面第 4、5、6 格被遮住。ImageGen 教学示意。
想象录下一句话,然后把中间一小段声音拿掉。模型还听得到前后,却看不到灰格里原本的内容。我们让它利用前后文预测灰格对应的声学类别:完整录音提供答案,缺了一块的录音提供题目。
这就是语音自监督预训练的起点:没有转写文字,也能从声音本身造出学习任务。图中彩色圆片代表离散目标,右边柱子是类别概率。后面还会遇到另一种题目:答案是老师网络给出的连续向量,学生用预测向量去接近它。
1.3 自监督目标与文字转写目标
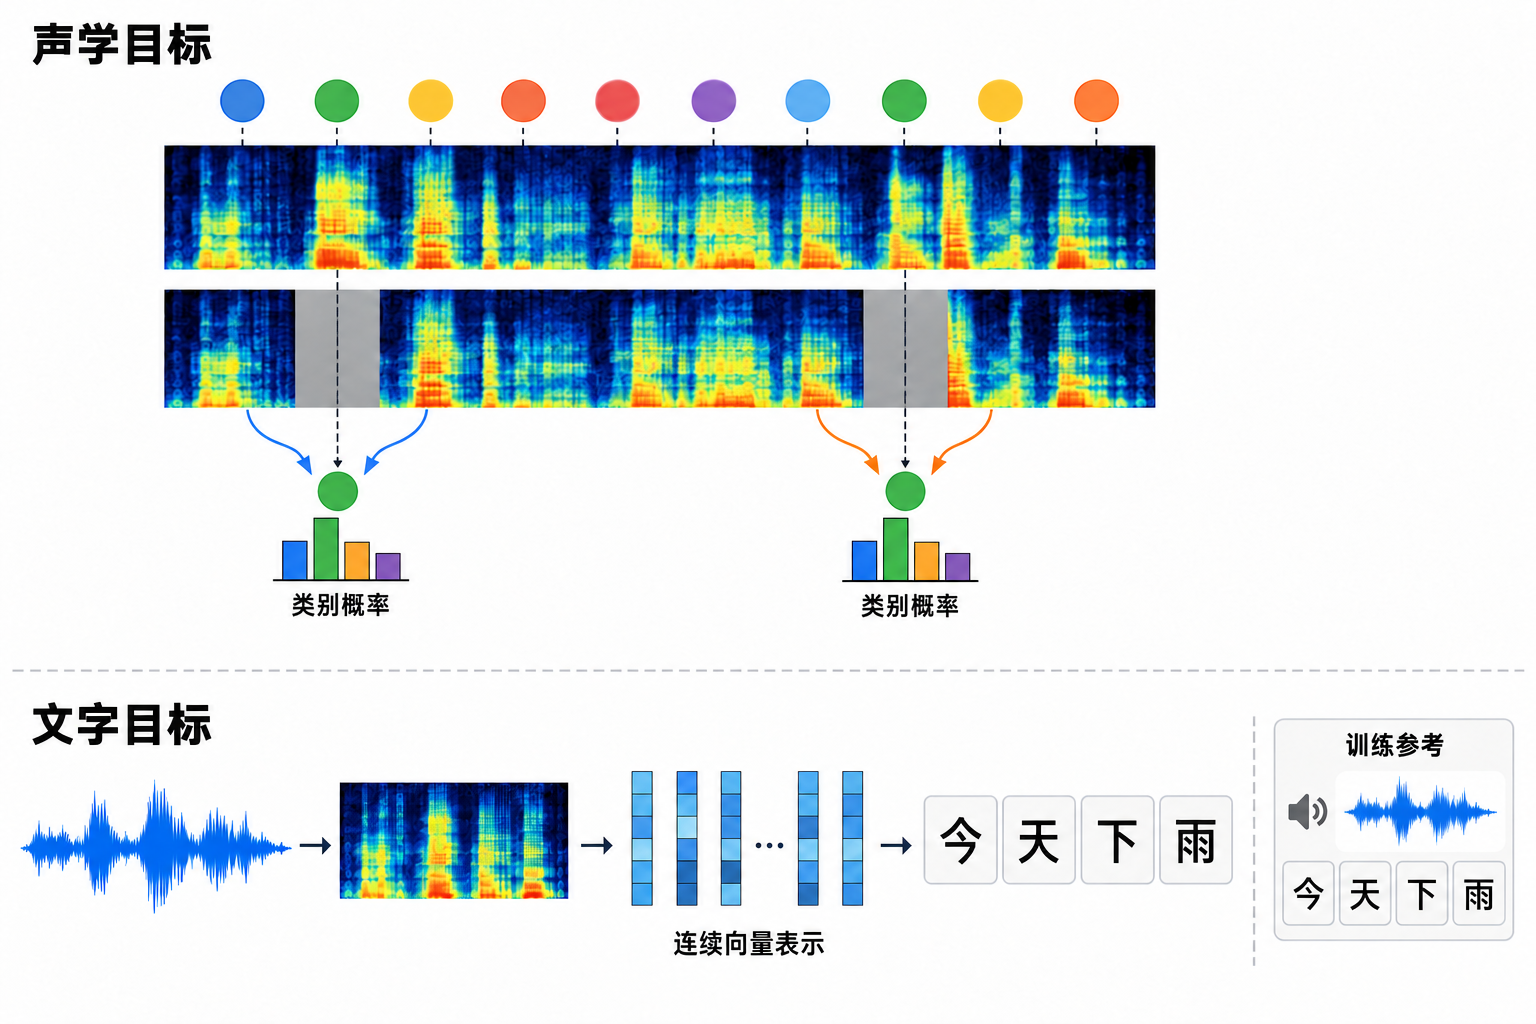
上面预测声学类别,下面学习文字转写。“今天下雨”是教学例句。ImageGen 教学示意。
上半图里,完整声谱给出彩色类别,遮挡输入要预测对应颜色。答案可能是聚类编号,也可能是随机码本 ID。它们从音频导出,通常并没有“这是哪个字”的人工命名。
下半图多了一份文字参考,来自人类标注或伪标注。任务头读取 encoder 表示,学习输出“今天下雨”这样的转写。自监督阶段的目标可记成 ,ASR 微调阶段的目标可记成 。两阶段即使都用交叉熵,所预测的类别也可以完全不同:一个是声学码字,另一个是字符或 BPE token。
1.4 冻结评估与全参数微调
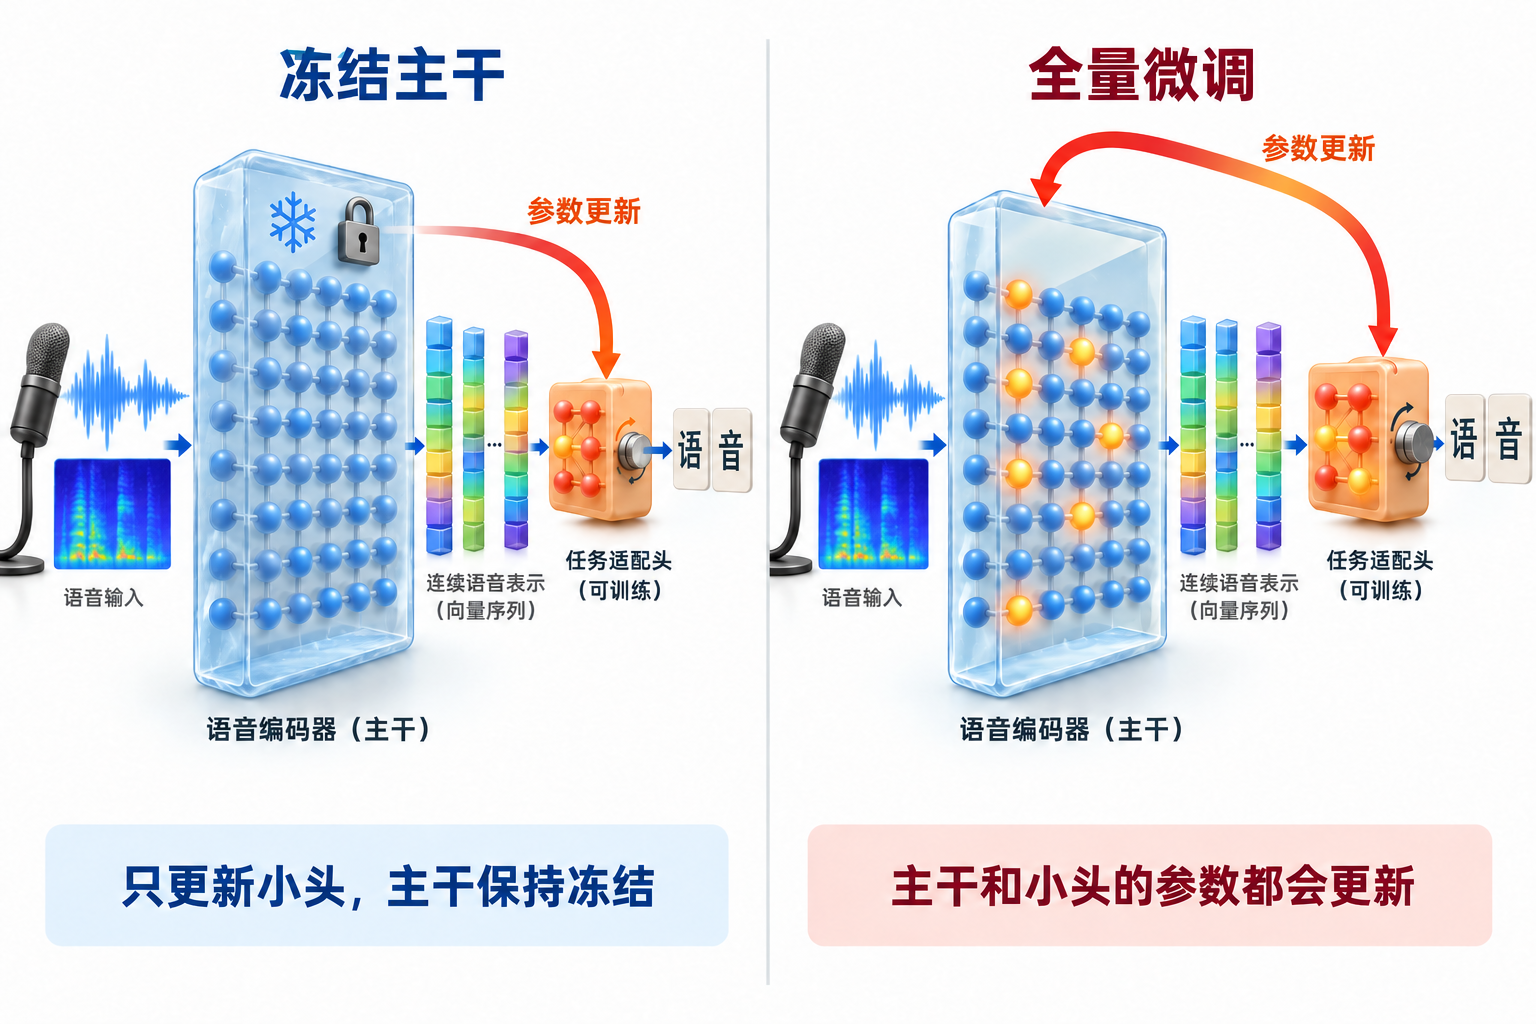
左边只更新任务头;右边主干和任务头一起更新。红线标记更新范围。ImageGen 教学示意。
左边的锁和雪花表示 encoder 参数固定。它继续把声音变成向量,但新任务只训练后面的小头。这时成绩主要说明:已有表示是否容易被这个任务读出来。
右边主干中的珠子也亮起,表示 encoder 继续学习领域数据。全量微调同时检验初始化与适应能力。所以读到“这个 encoder 的 WER 更低”时,要先看是在冻结主干,还是解冻后训练。两种做法都合理,回答的问题不同。HuBERT、NEST
2. 2018—2020:从预测未来到遮挡对比学习
有了声学表示,接下来沿年份看训练题目怎样从未来辨认变成同一位置的遮挡预测。
2.1 CPC 与 wav2vec:预测未来
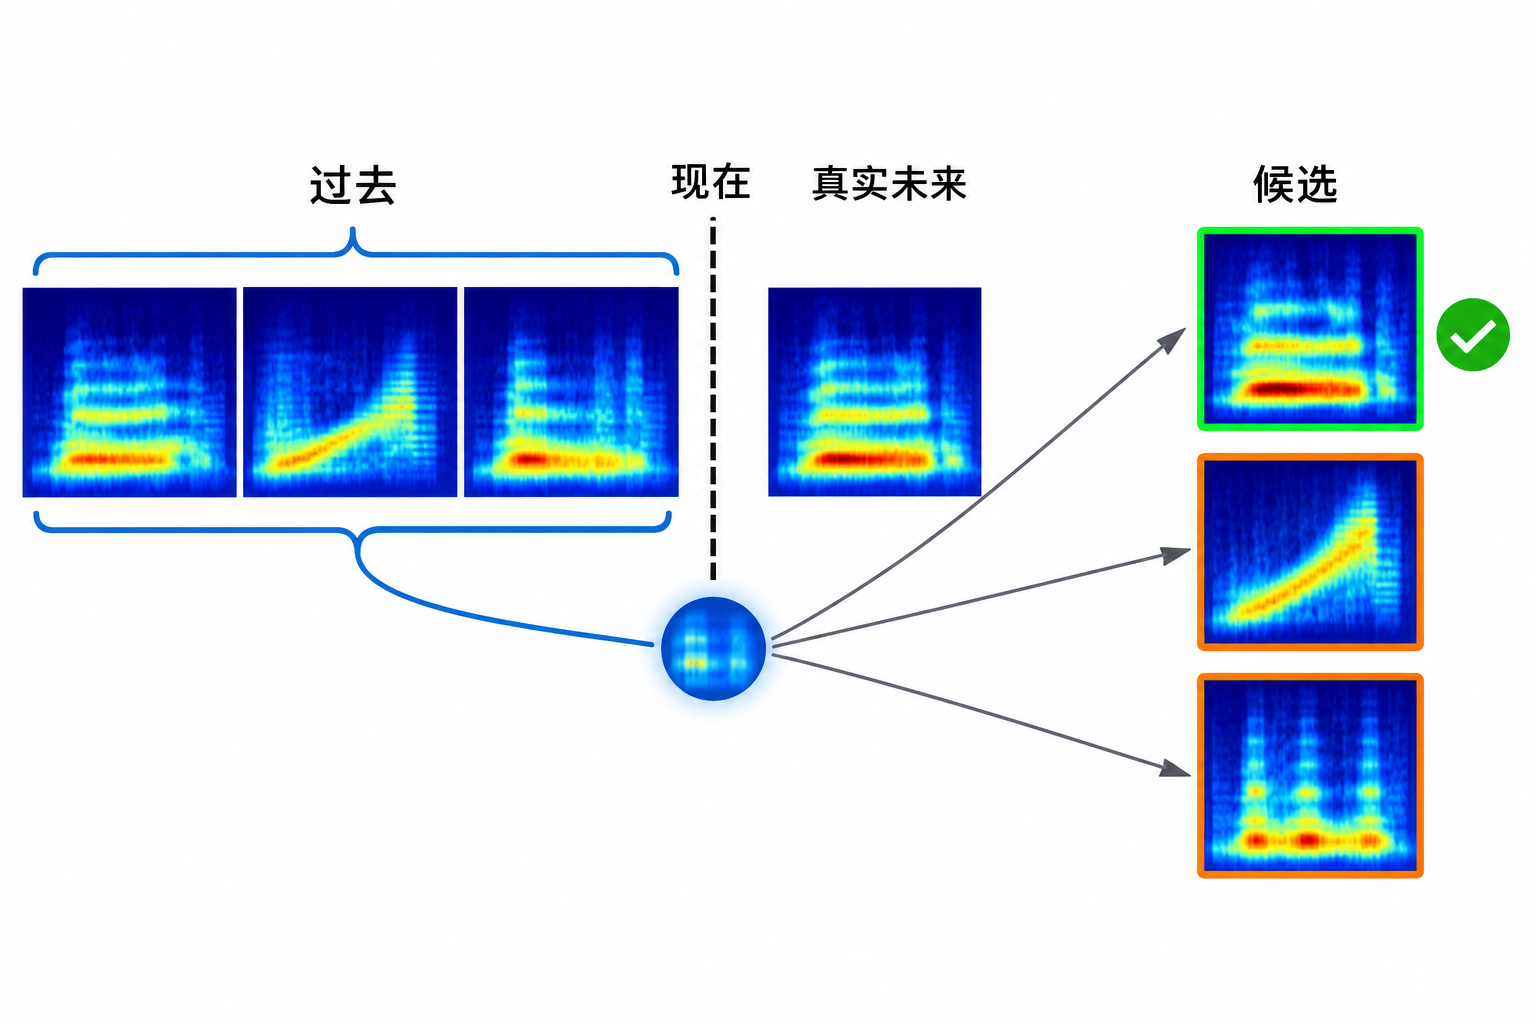
左边只能看过去,右边有真实未来与干扰候选。ImageGen 教学示意。
看图中“现在”这条虚线。CPC 的上下文只汇总左边已到达的声音,再给右边候选打分。绿色候选来自同一录音的真实未来;其他候选提供干扰。模型不用逐个采样点重建波形,也能因为“有没有选对未来”得到学习信号。
2018 年 CPC 用局部特征和自回归上下文建立这道选择题。2019 年 wav2vec 把相关思路推进到语音识别预训练,用真未来与负样本的判别训练声学表示。这一阶段的重要变化,是把声音学习放到特征空间中进行。CPC、wav2vec
2.2 vq-wav2vec 与 wav2vec 2.0:离散化的分工
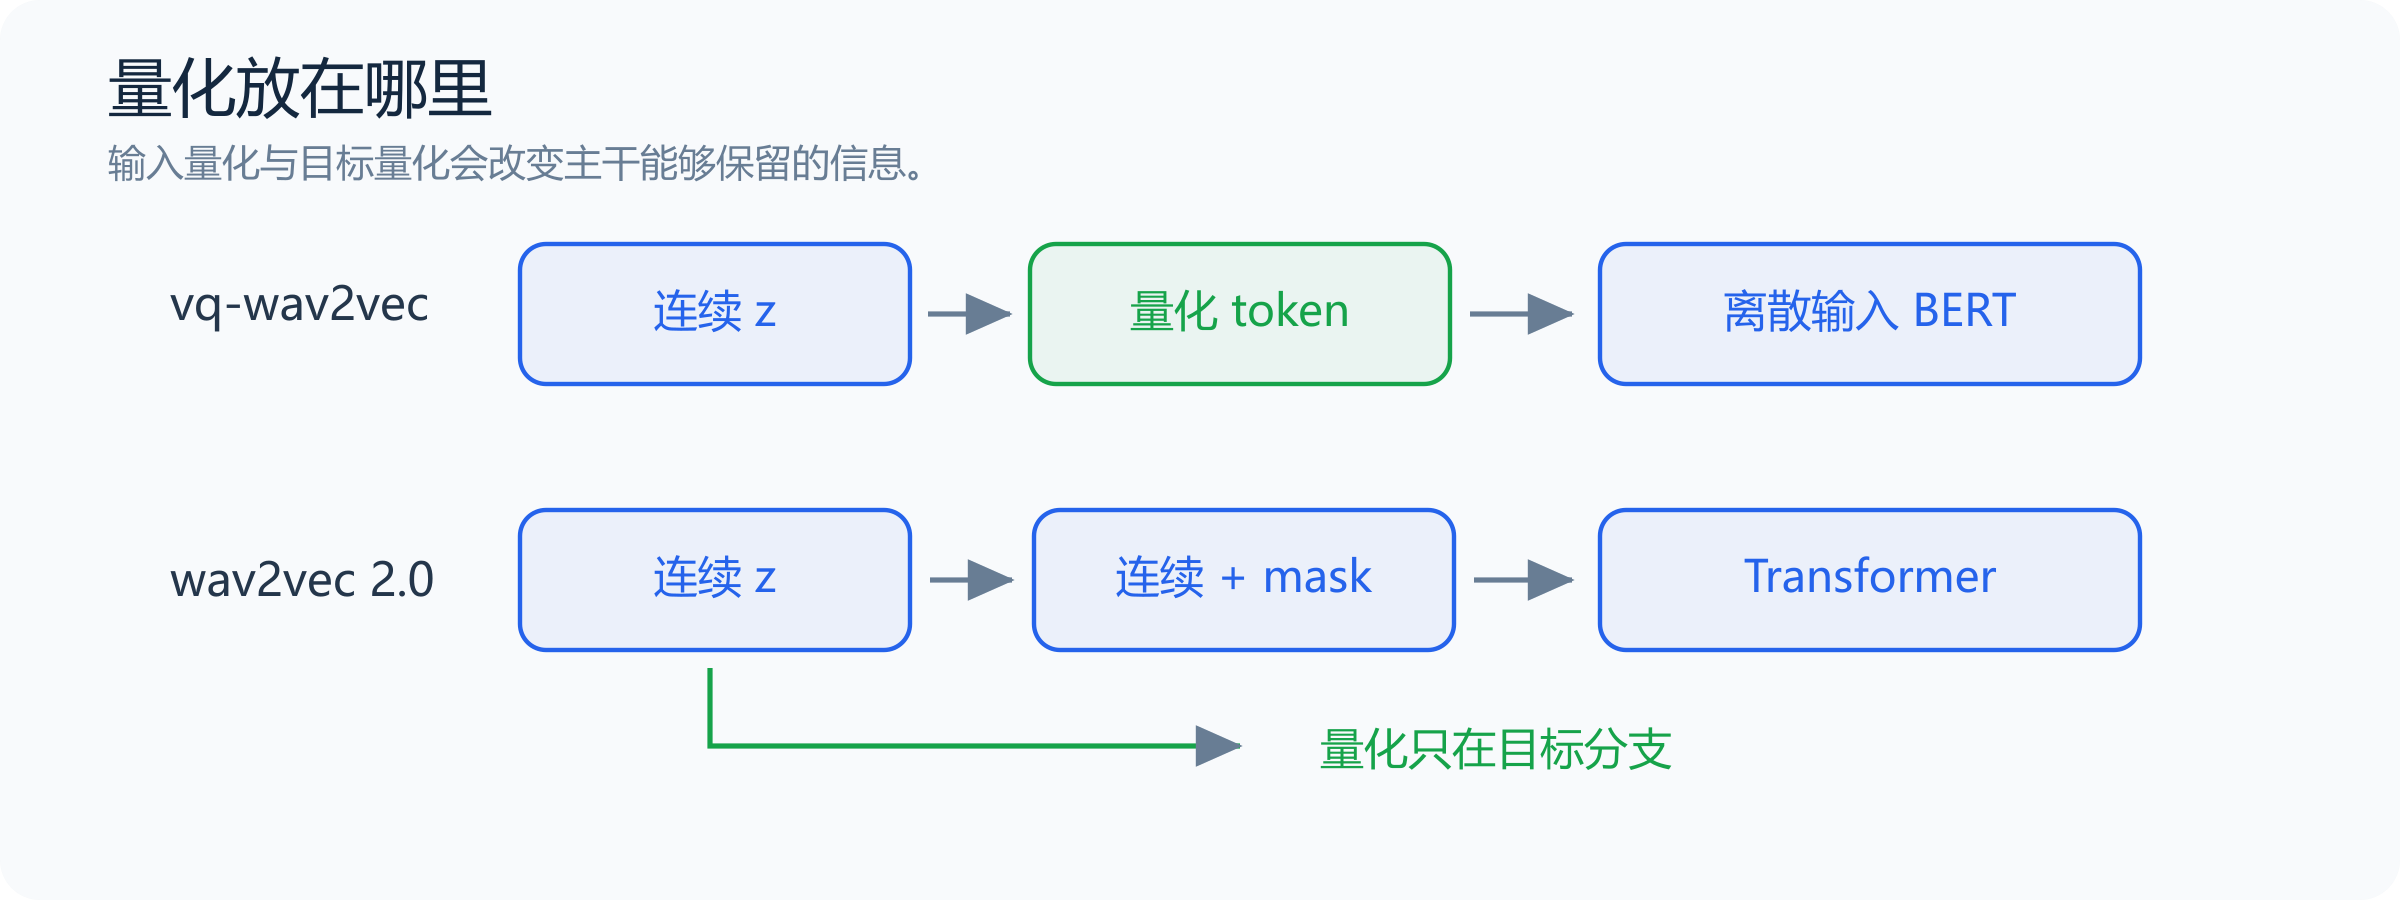
比较离散化发生在输入端,还是发生在目标端。精确教学图。
vq-wav2vec 在 2019 年先学习离散表示,再用这些离散序列做 BERT 式上下文学习。把“声学单元变成可预测的离散序列”看成第一步,再学习它们之间的联系,是理解这条路线的关键。vq-wav2vec
2020 年 wav2vec 2.0 改为让上下文主干读取连续 CNN 特征,将离散量化放到目标支路,并把前端、上下文与可学习量化器联合训练。这样,模型输入什么、模型预测什么,可以分别设计。wav2vec 2.0
2.3 wav2vec 2.0:遮挡支路与完整目标支路
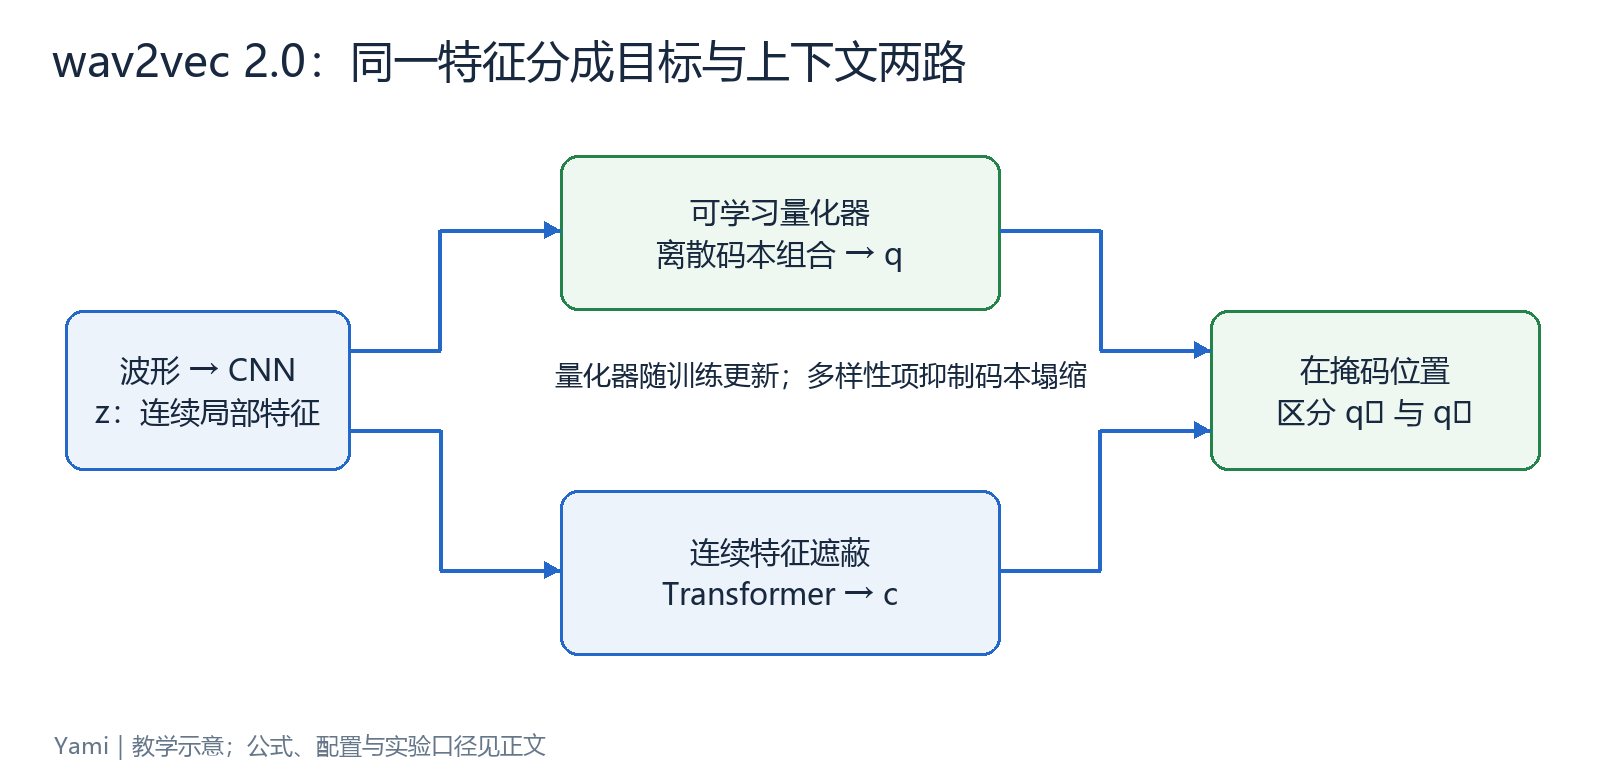
遮挡发生在学生输入;完整特征留在目标支路。
沿图中两条线看:波形先经过 CNN。上下文支路遮住一部分特征,让 Transformer 根据周围内容推断;目标支路保留原特征,经过可学习量化器得到真实候选。训练在遮挡位置比较真实目标与负候选,码本多样性项鼓励使用不同条目。
完整声音没有直接作为答案喂回遮挡输入。它只在损失端告诉模型选得对不对。随后几年,许多方法保留这种“完整目标、困难输入”的分工,主要改变了目标怎样产生。
3. 2021—2024:目标生成与输入扰动的几条路线
下面按提出年份展开:先看聚类目标与困难输入,再看固定随机目标、连续老师目标,以及它们的后续扩展。
3.1 2021 HuBERT:离线聚类目标
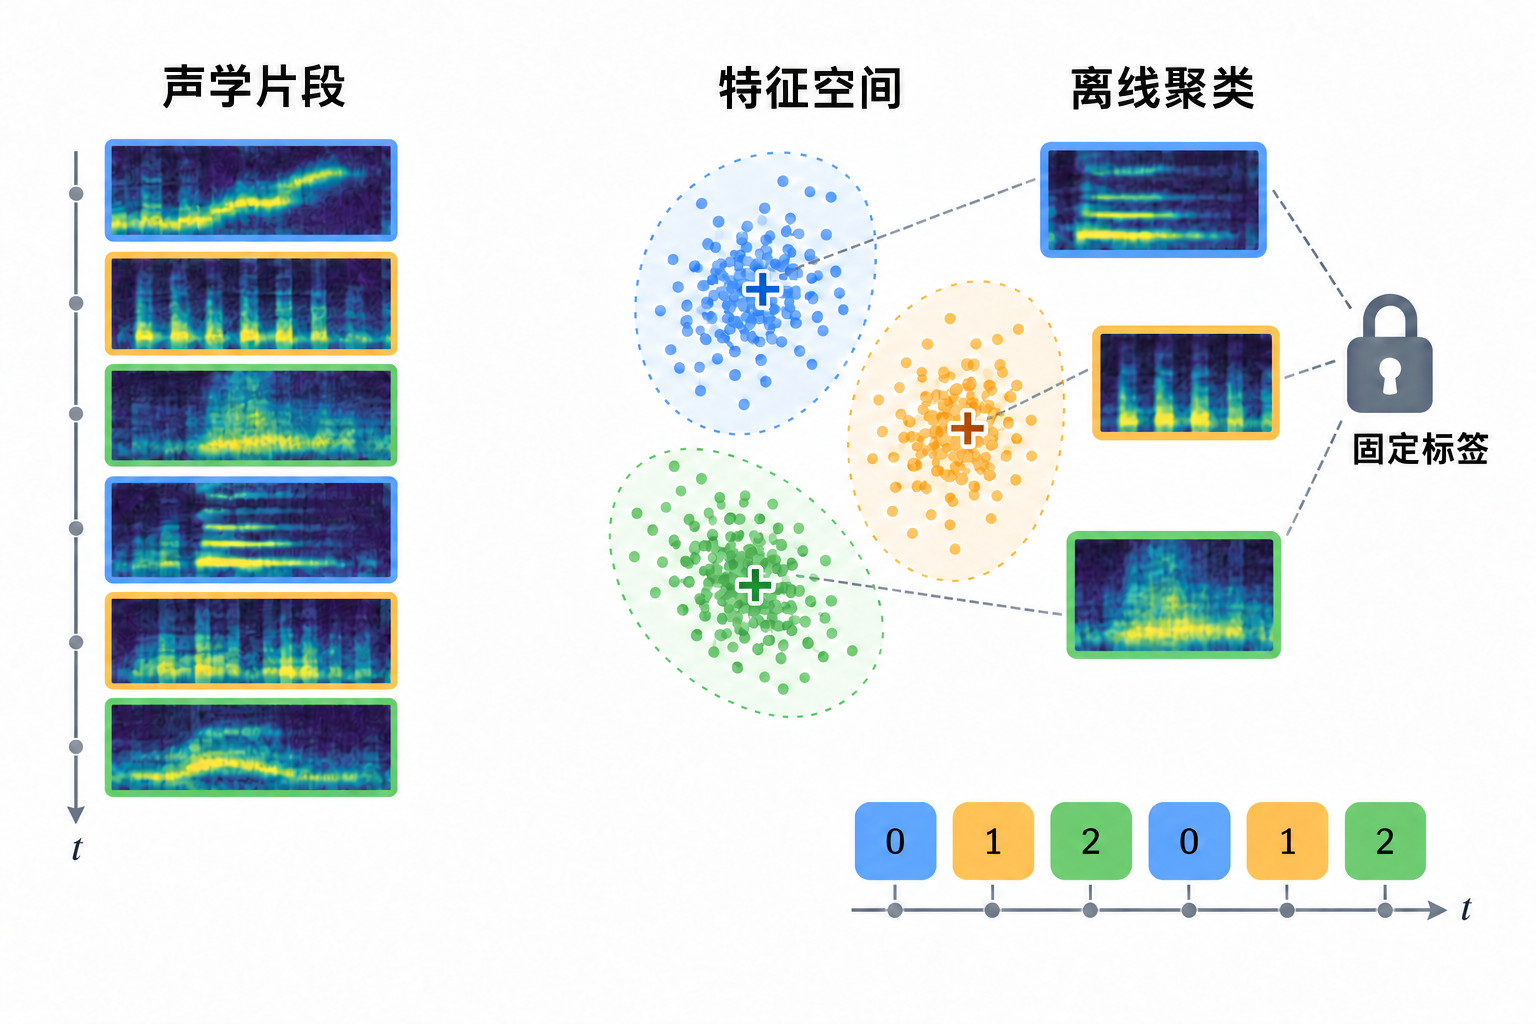
相近特征进入同一簇,簇编号成为当前轮的声学答案。ImageGen 教学示意。
图里同色的点聚在一起,表示 k-means 发现的特征簇。HuBERT 第一轮先提取 MFCC,离线聚类,再把每个时间位置写成整数标签。学生看到遮挡输入,学习预测这些提前准备好的编号。HuBERT 原论文、官方 README
编号不必恰好就是音素。它先提供一个局部一致的预测问题。只在遮挡位置施压,可以减少学生从当前帧直接猜标签的捷径,让它更多依赖周围声音。
3.1.1 HuBERT 的跨轮目标更新
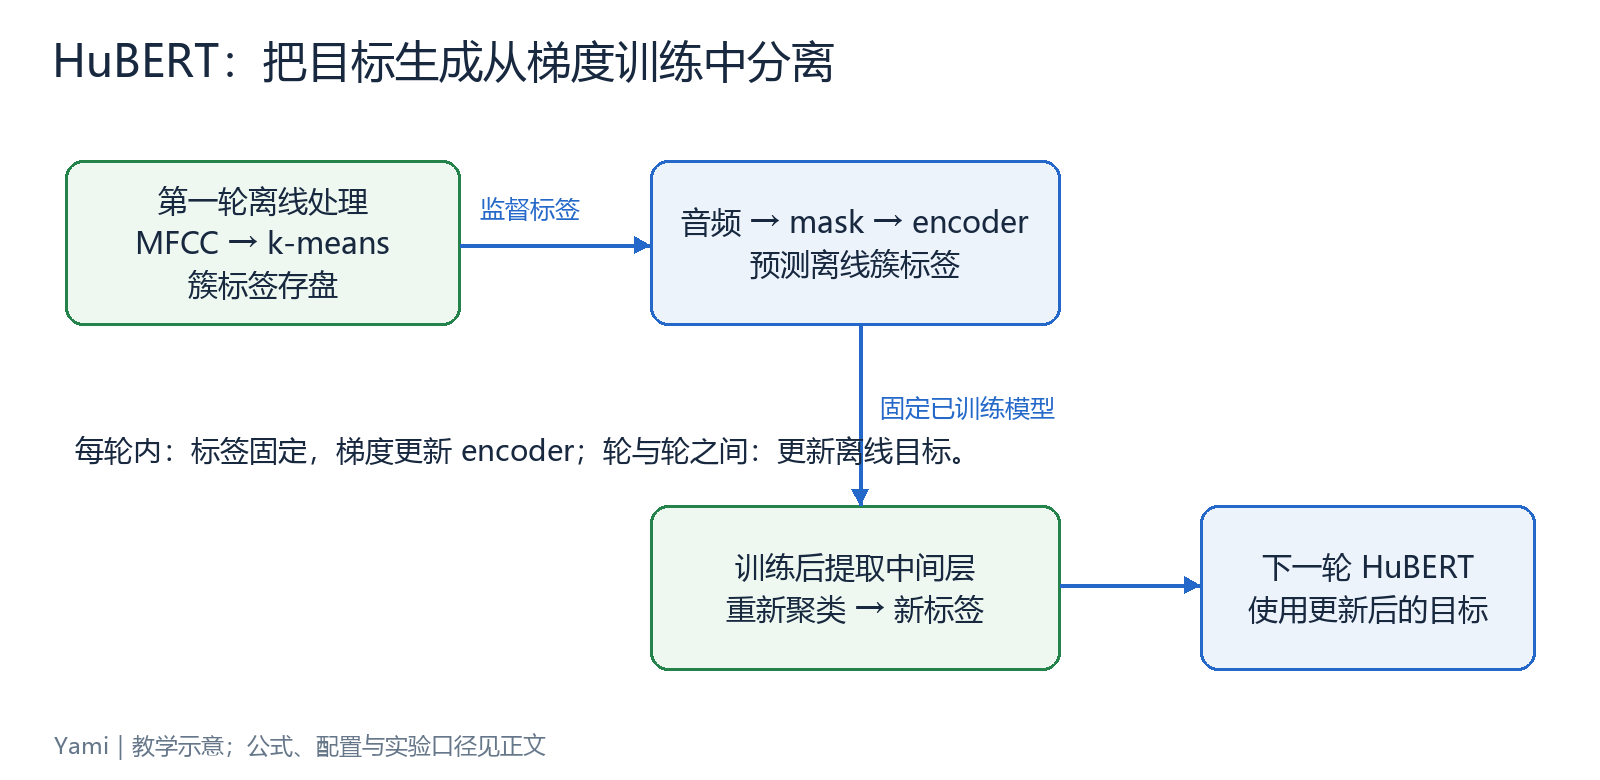
本轮标签固定;本轮训练结束后,隐藏表示用于下一轮聚类。
沿着循环走:先准备标签,再训练学生;等学生学到了更好的隐藏表示,提取这些表示,重新聚类,进入下一轮。HuBERT 的聚类发生在轮与轮之间。训练当前轮时,无需每个优化步再聚类一次。
第一篇:HuBERT 与前史继续把每一步展开:CPC、wav2vec、vq-wav2vec 和 wav2vec 2.0 怎样改变目标;MFCC 的 100 Hz 标签怎样与 CNN 约 50 Hz 表示对齐;官方 positive-at-column-0 分类头为何使用全 0 target。每一个计算步骤都接着对应的小图与手算。
3.2 2021 WavLM:保留干净目标,扰动学生输入
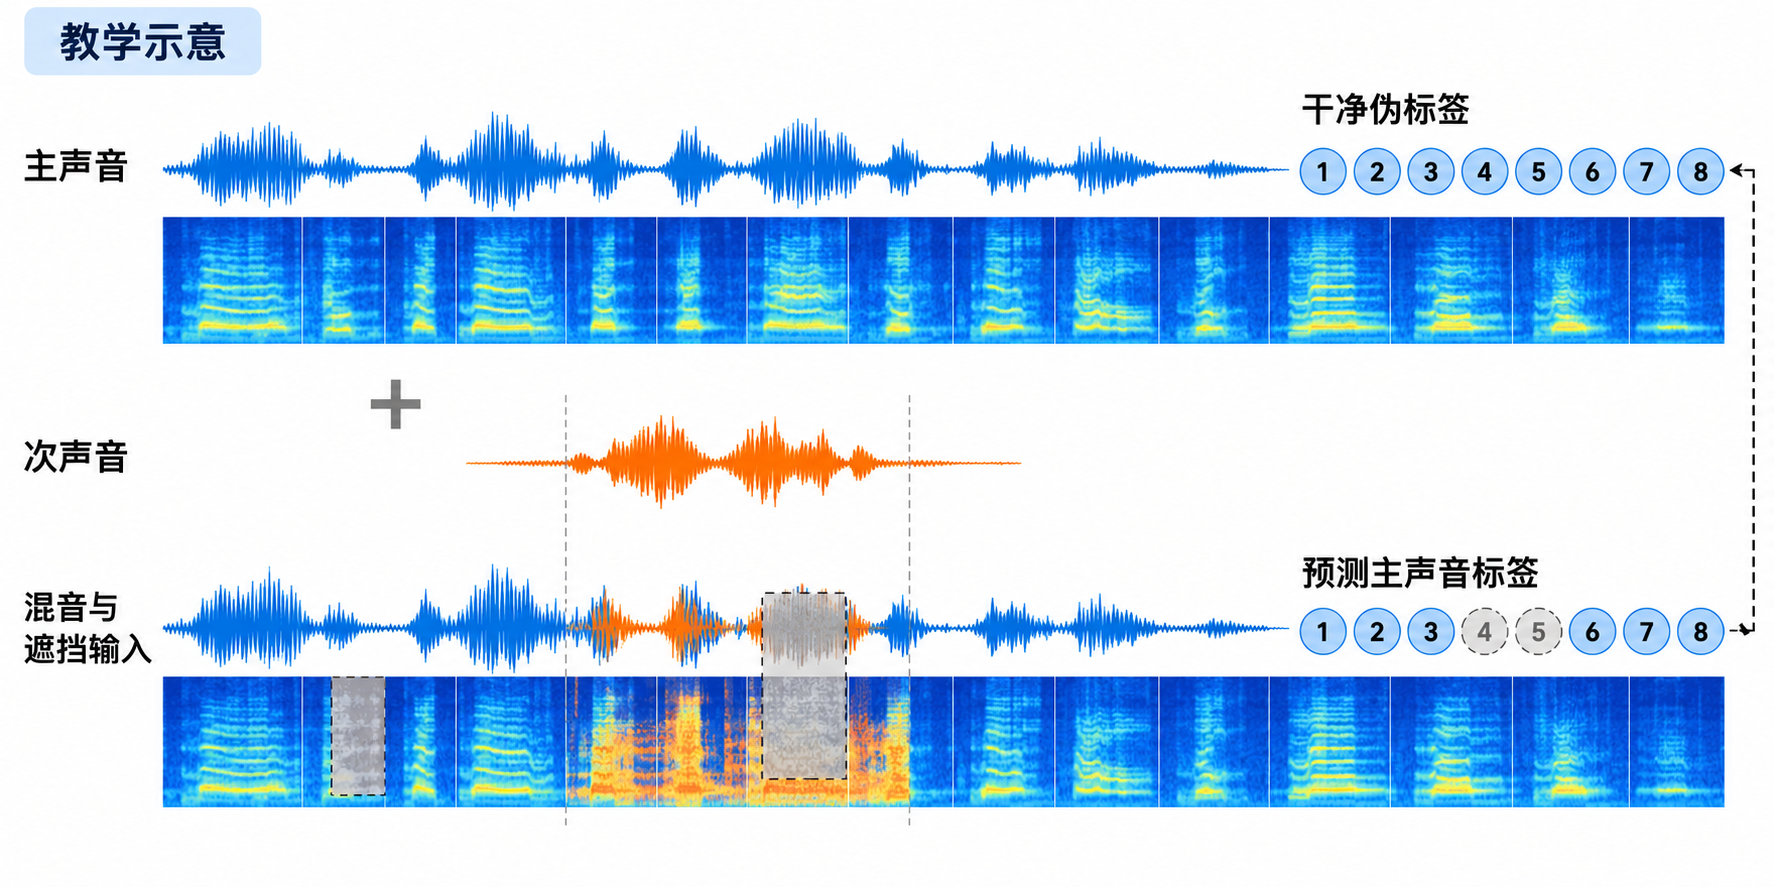
学生输入有混音,目标仍来自干净主声音。ImageGen 教学示意。
再看图中不同颜色的波形:主声音还在,另一段声音或噪声混进了局部区域。WavLM 在 2021 年提出让学生面对这种更困难的输入,监督仍来自干净声音的聚类伪标签。WavLM
它改变的是输入难度。BEST-RQ 简化目标系统,data2vec 改成连续老师目标,WavLM 增加混音与噪声;几条路线分别探索不同方向。第二篇:BEST-RQ 与支路保留固定投影的矩阵手算、SpeechBrain 公开重实现、USM 多头,以及 data2vec、WavLM 的公式与源码。
3.3 2022 BEST-RQ:固定随机投影与码本
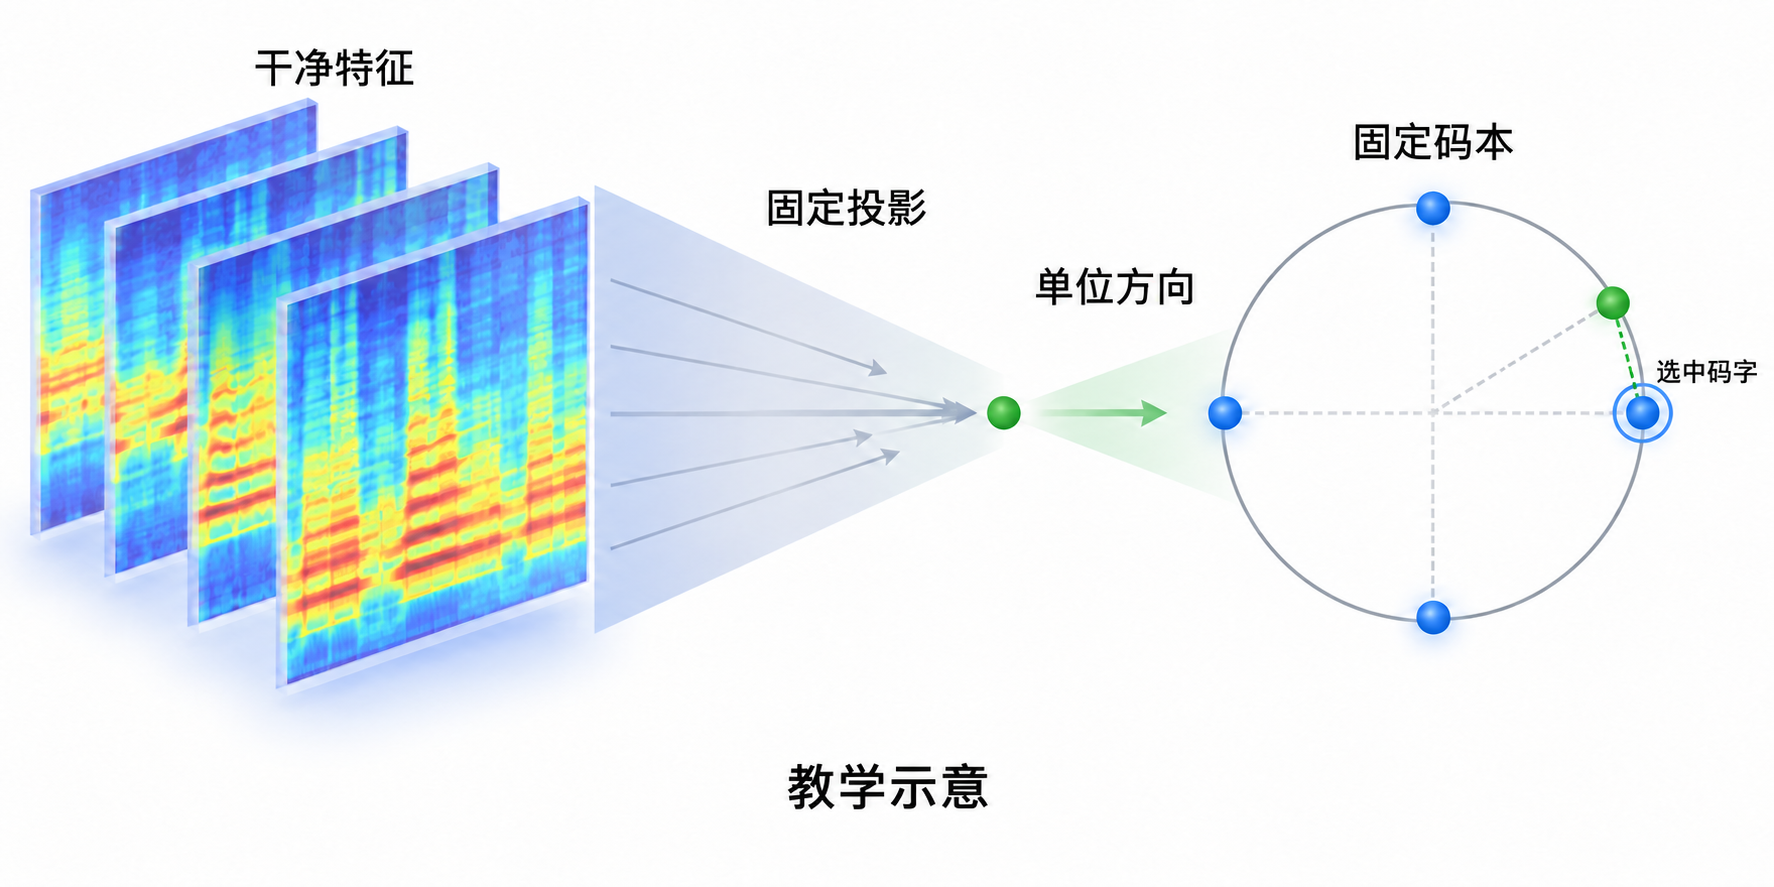
声学向量投影成一个方向,再选择最近的固定码字。ImageGen 教学示意。
看绿色点与蓝色码字。BEST-RQ 用一次初始化的随机投影和随机码本,把干净声学特征变成整数 ID。它们在训练中固定,更新的是预测这些 ID 的 encoder 和分类头。因此不用离线聚类迭代,也不需要可训练量化器的离散梯度近似。BEST-RQ
这些编号没有预先命名的语义,仍可以构成有用的题目:同一区域的输入共享目标,边界两侧的相近输入仍可能得到不同 ID;输入被遮住后,模型要靠时间上下文预测它落在哪个区域。第二篇会把这个“最近”从圆上的位置,一路算到真实距离和类别 ID。
3.4 2022 data2vec:连续老师表示
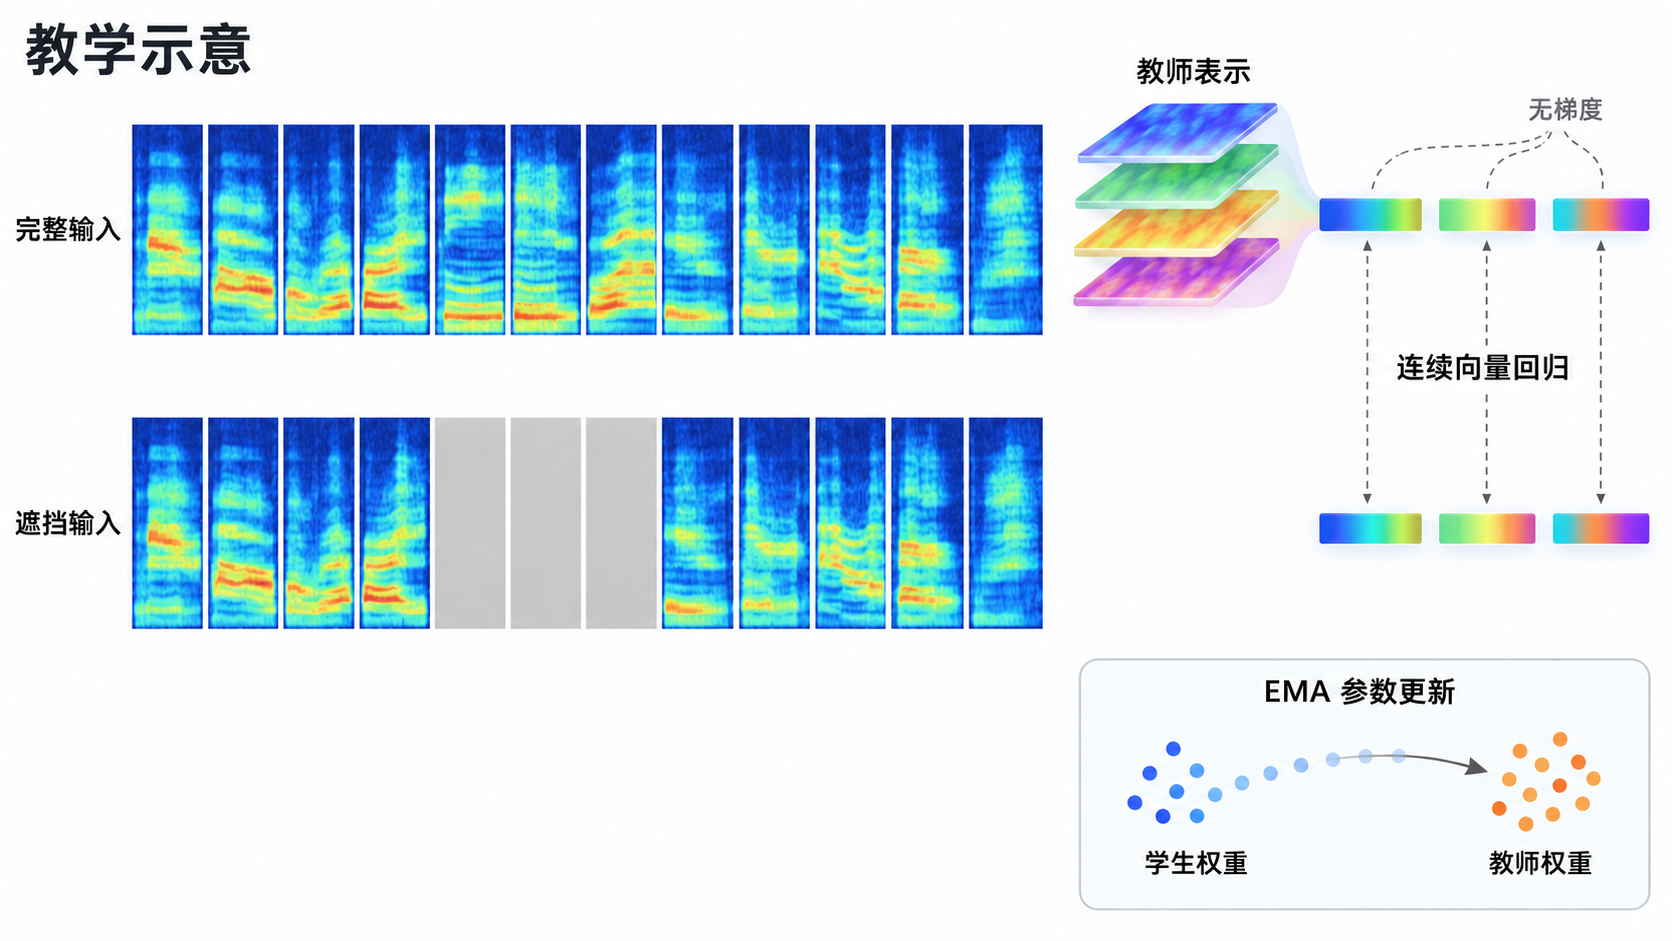
老师看完整输入,学生看遮挡输入;比较的是连续表示。ImageGen 教学示意。
看图中两排向量。data2vec 在 2022 年用老师的上下文表示作为目标,学生去接近它。这里没有要求学生输出某个码本 ID,目标可以包含老师已经整合的上下文信息。data2vec
老师前向不接收反传梯度,参数由学生参数的指数滑动平均更新。缓慢更新的是网络参数;每一段声音的目标向量,仍由完整输入的老师前向重新计算。第二篇把 teacher、顶部隐藏层、归一化与回归损失逐步对应到官方语音代码。
3.5 2023 USM:固定目标的多头扩展
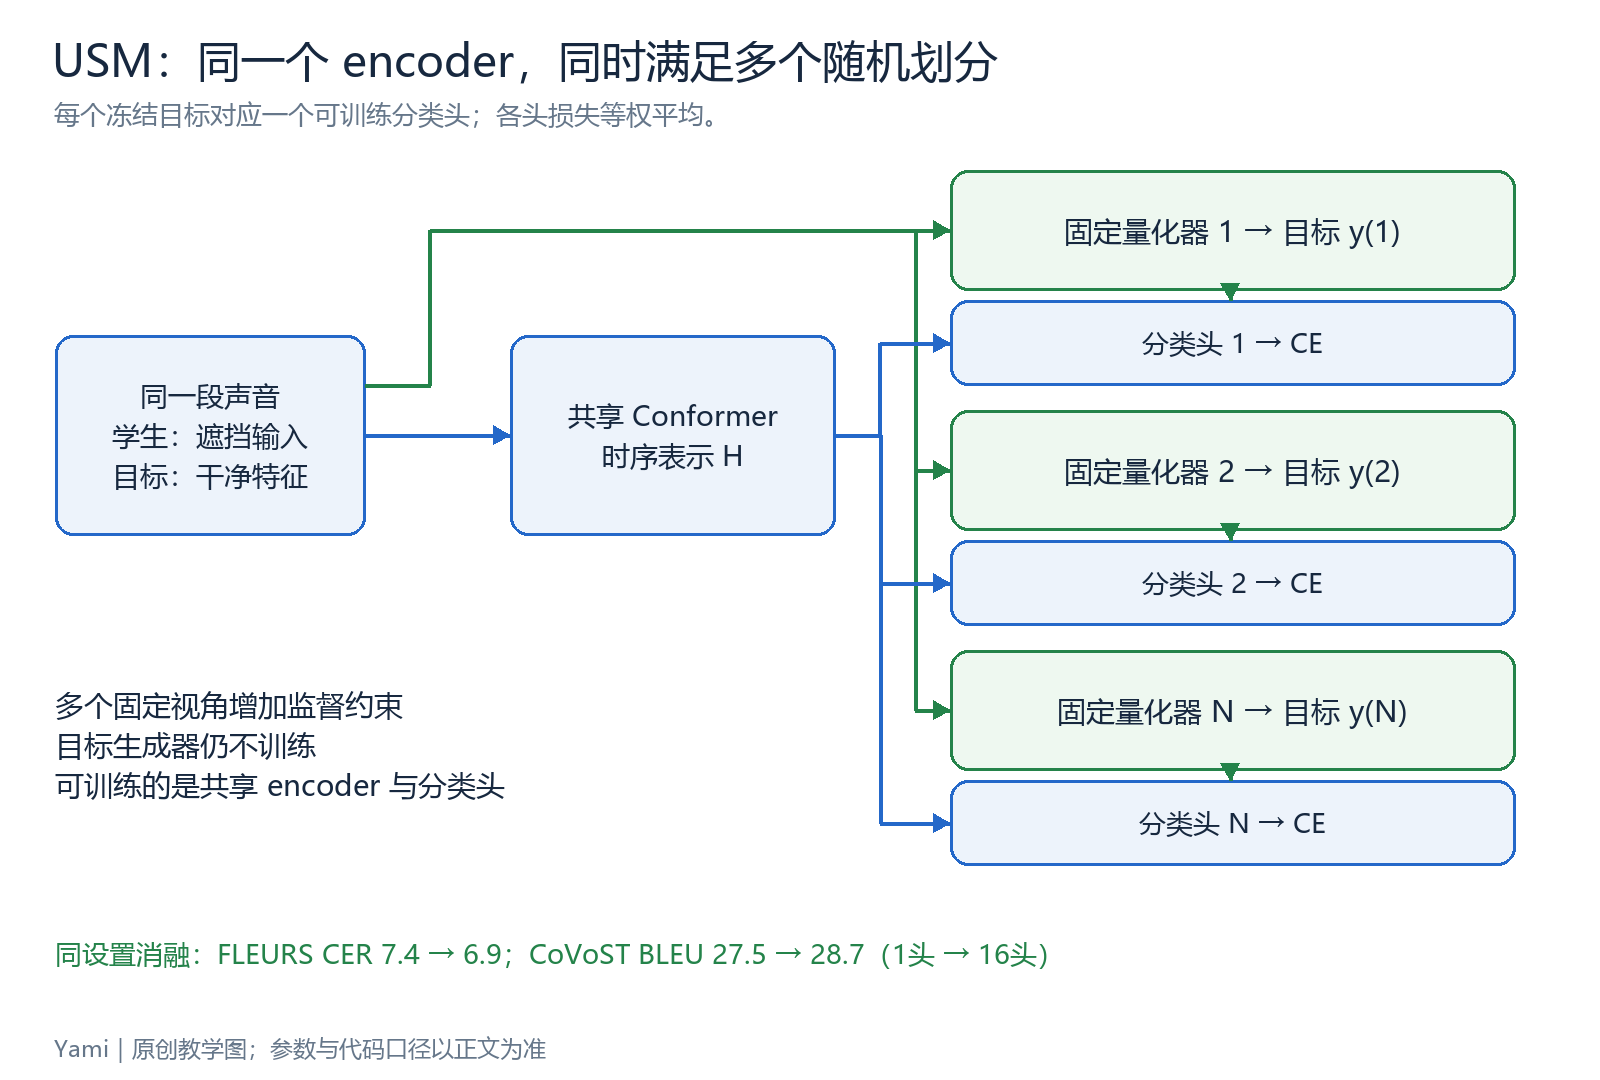
多个固定目标提供不同观察角度,共同训练同一个主干。精确教学图。
2023 年 Google USM 用多头 BEST-RQ 放大这条路线。不同随机目标可以从不同角度划分声学空间,让共享 encoder 同时解决多道预测题;之后还可加入 MOST 模态训练和任务微调。USM
大规模训练的进步,不一定来自更复杂的目标生成器。USM 让我们看到:简单目标与数据、模型和训练规模结合,也能形成强的系统。具体消融仍要在同一配置下读,第二篇保留原论文条件、CER/BLEU 变化与多头实现解释。
3.6 2024 NEST:随机目标与去噪训练
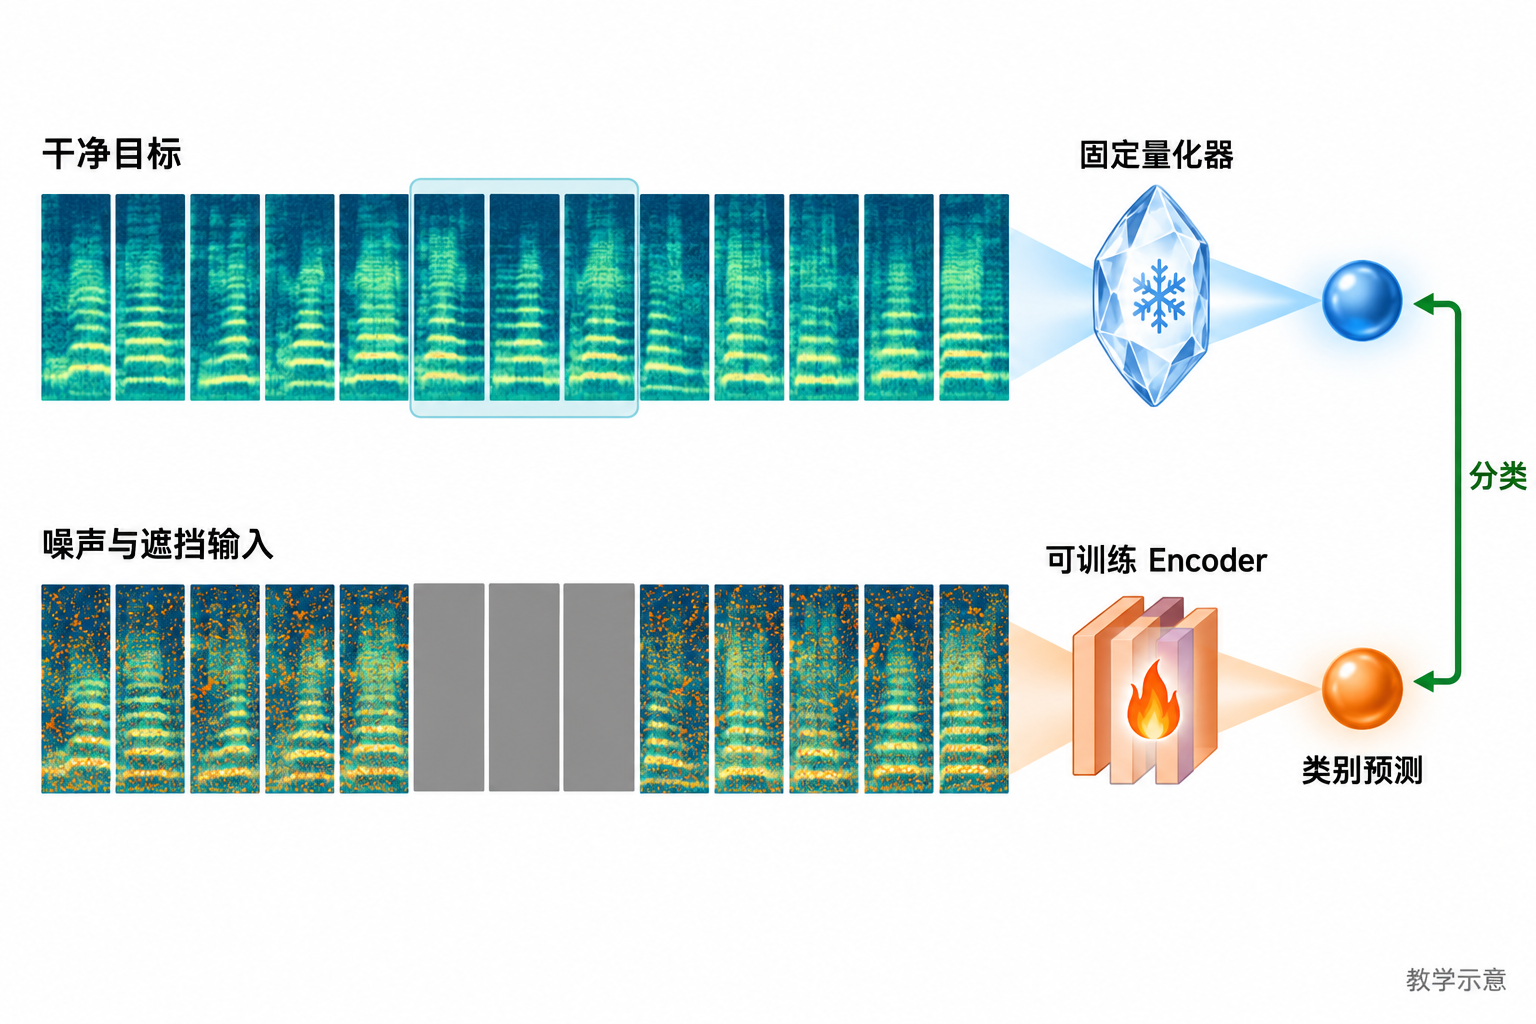
目标保持干净,学生面对污染与遮挡。ImageGen 教学示意。
上面的雪花表示固定目标量化器,下面的火焰表示可训练学生。NEST 沿着 BEST-RQ 式随机目标和去噪遮挡,训练通用 FastConformer 表示。目标来自干净声音,学生输入可以被噪声和其他说话人污染。NEST
4. 2025—2026:大规模多语模型与训练框架
前面比较的是训练题目;现在沿着题目看大规模模型、文字解码路径和可用的训练工程。
4.1 2025 OmniASR-W2V:数据与模型规模
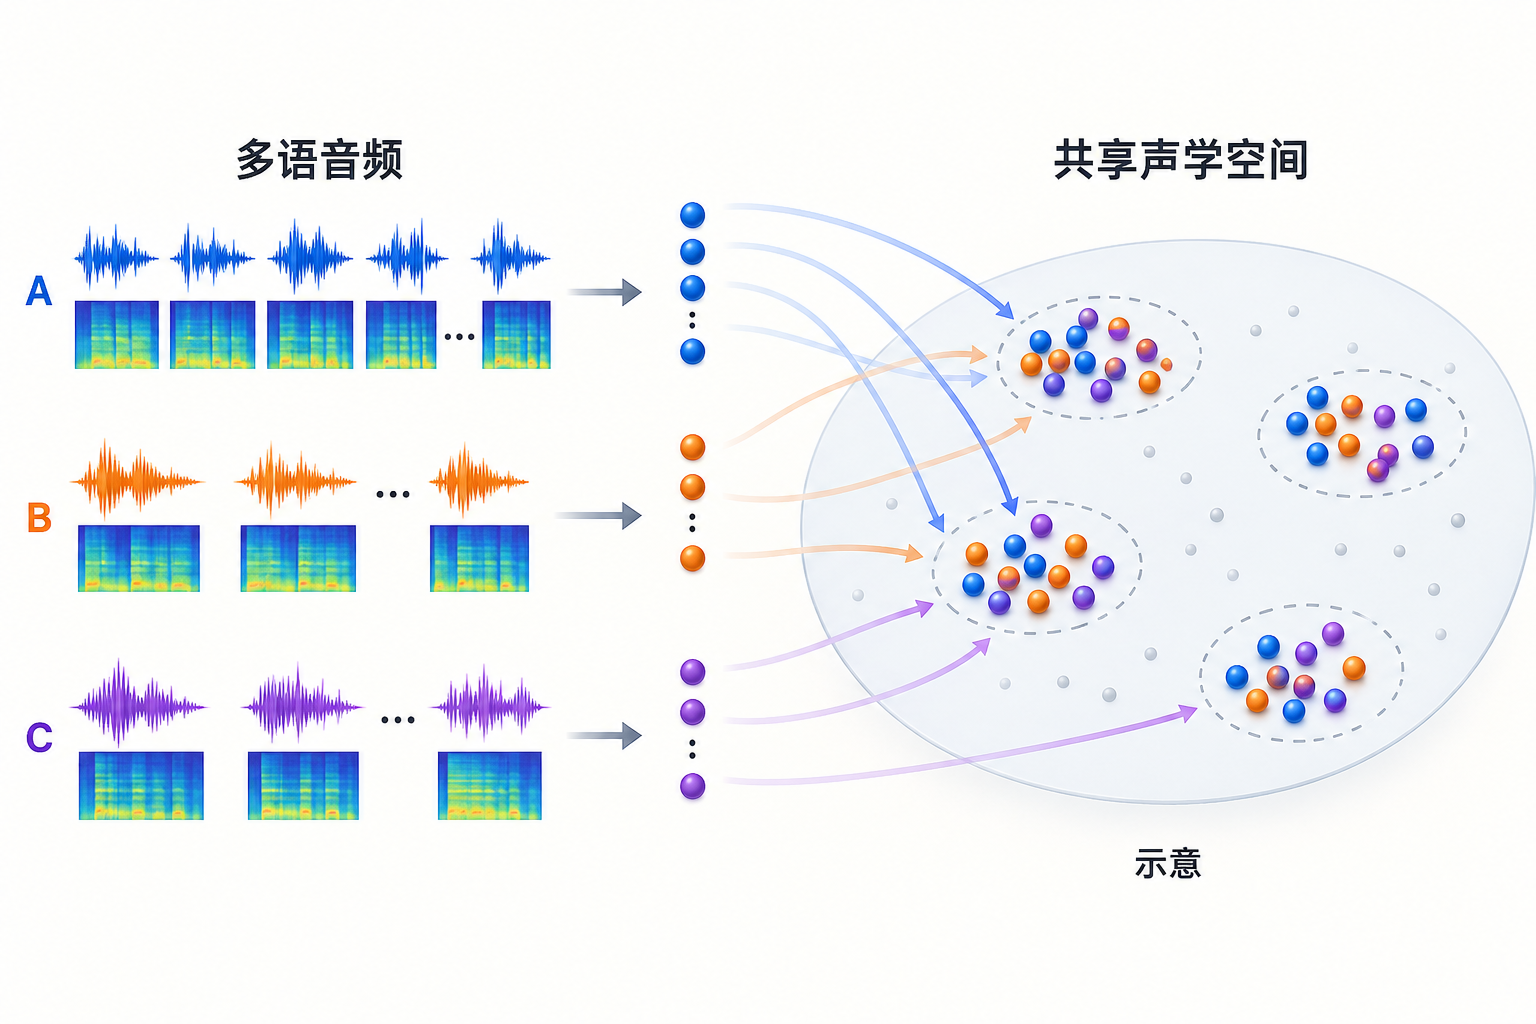
不同颜色表示语言来源,混色邻域表示共享建模的直觉,并非实测嵌入。ImageGen 教学示意。
左边一些来源多,一些来源少。Omnilingual ASR 的 W2V encoder 把约 430 万小时多语音频送入经典 wav2vec 2.0 学习任务,模型从约 300M扩到名义 7B。采样怎样照顾低资源语言、主干怎样扩大,会一起影响它学到的表示。Omnilingual ASR、官方仓库
它在 2025 年的进展主要来自多语数据、采样、模型规模和后续 ASR 系统。理解这条路线时,可以继续沿着熟悉的“遮挡上下文与完整目标”看下去,然后检查数据和工程怎样被放大。
4.2 OmniASR 的 CTC 与 LLM-ASR 迁移路径
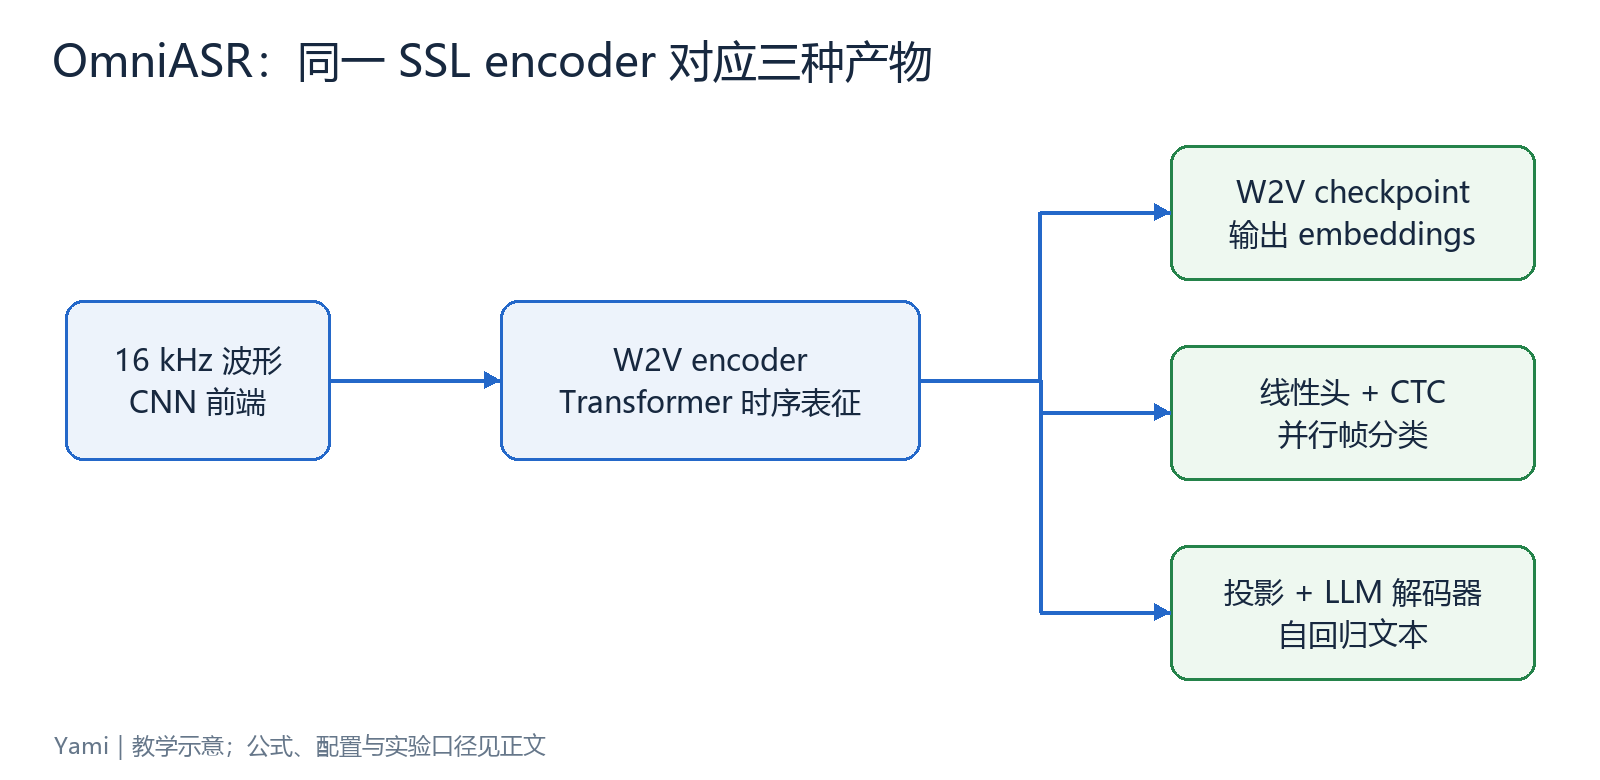
W2V 提供声学表示;CTC 和 LLM-ASR 接上不同解码路径,得到识别系统。
图中先有 W2V encoder,再分出 CTC 和 LLM-ASR。encoder 家族是自监督预训练产物;后面两条路径继续用转写训练,并采用不同的文字生成方式。评测识别成绩时,解码结构也属于模型系统的一部分。
第三篇:fairseq2 + OmniASR-W2V从 waveform、CNN 一直跟到 masked/target 分支、量化器和 loss,再讲参数共享与 CTC 冻结日程。300M/1B/3B/7B 每档都有形状与源码解释;官方 20k 步微调例子和论文 200k 步全量训练也分别说明用途。
4.3 fairseq2 的组件与训练作业
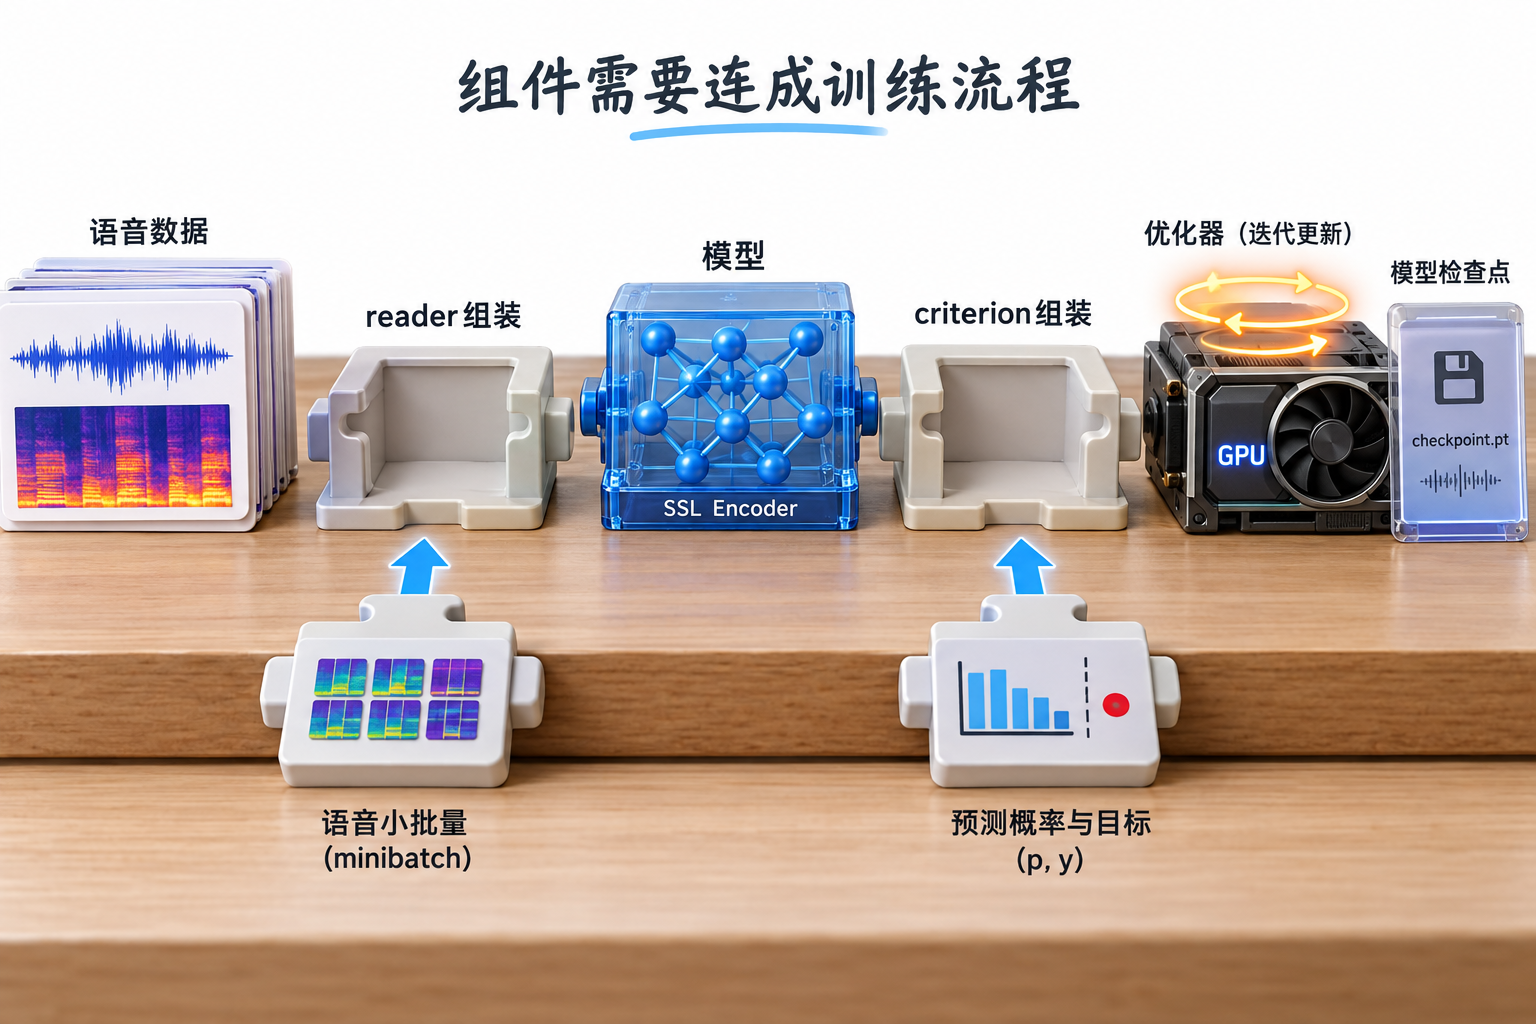
模型组件、数据读取和损失接线共同组成训练流程。桌面零件是 ImageGen 工程示意。
桌面上已经有模型、预测概率和目标等组件;把数据整理成 batch、把目标与 loss 接好,才能进入训练循环。按 fairseq2 v0.6.0 与固定 Omni 提交核对:W2V 模型和损失组件已经存在,Omni 提供监督 ASR recipe。从零训练未标注音频 SSL,仍需自行组装 reader、criterion 和训练 recipe。
这也帮助区分几个常被放在一起的名字。HuBERT、BEST-RQ 是“怎样出题”的方法;OmniASR-W2V 是训练出的 encoder 家族;fairseq2、NeMo Speech 是承载数据、分布式训练、优化器和检查点的框架。框架的创立年份无法直接推出今天识别效果,版本新旧也要放回具体可执行的训练路径中看。
4.4 2026 NeMo Speech 3.0:从表示训练到流式 ASR
NeMo Speech 3.0 是平台版本,它还承载监督 ASR 训练和流式部署。公开 NEST 例子使用双向上下文;另一条 Nemotron 3.5 路线是具有语言提示的 cache-aware RNNT 识别系统,训练答案是转写文字。NeMo Speech、Nemotron 3.5 模型卡
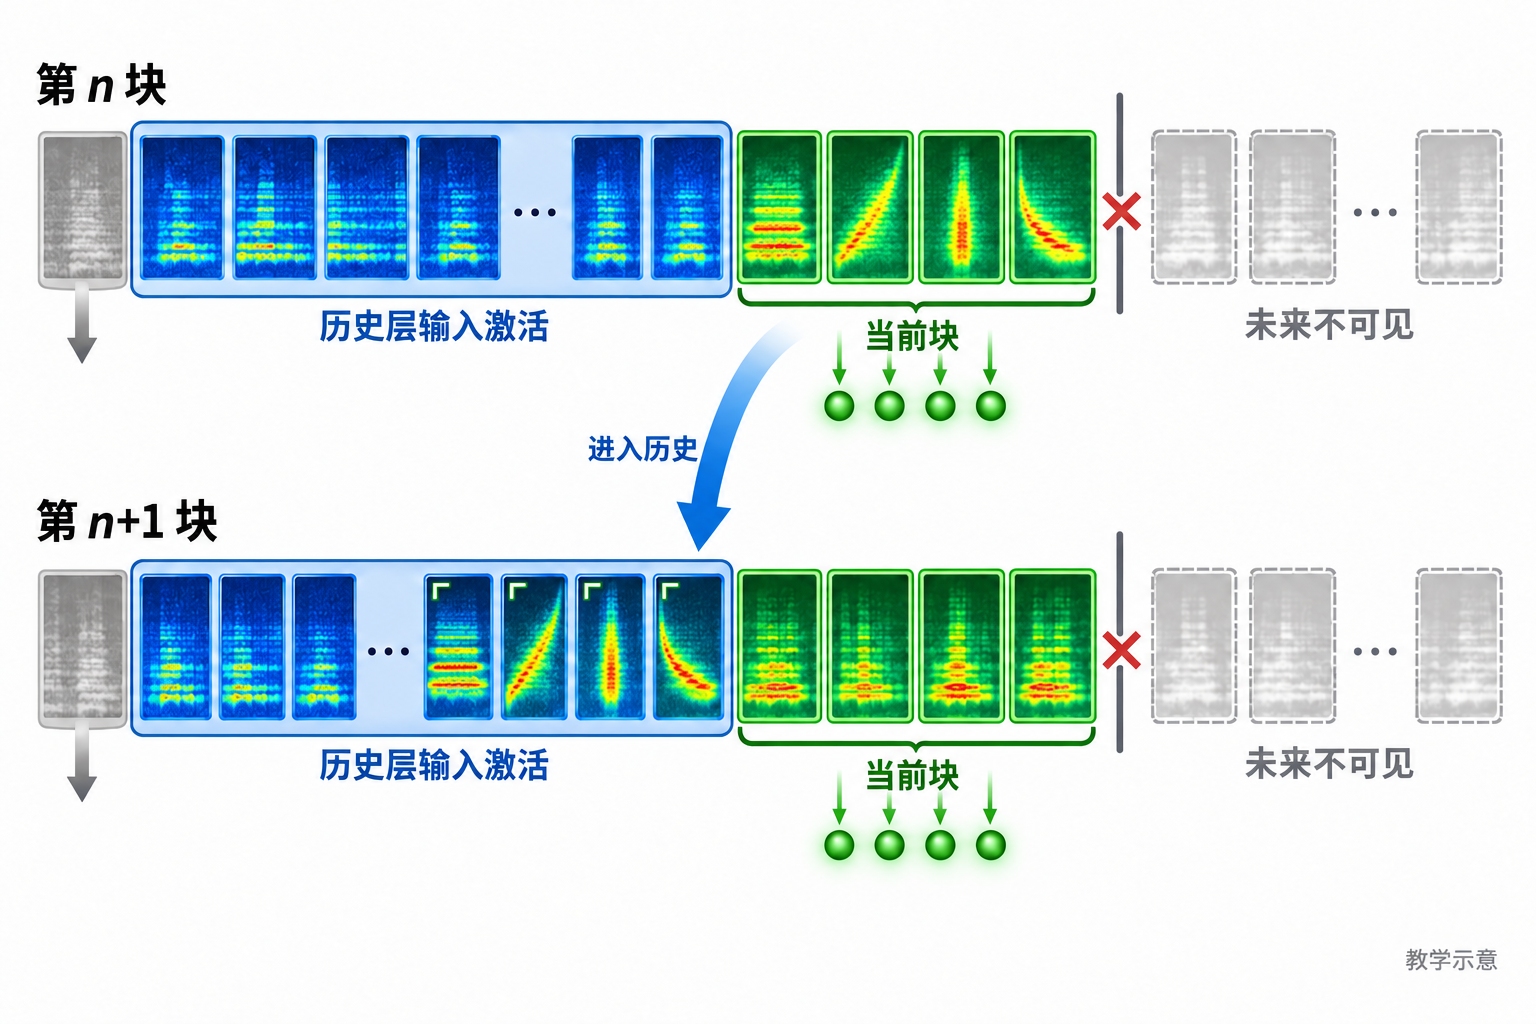
上排绿色四帧在下排进入蓝色历史;未来屏障之外的声音尚不能访问。ImageGen 教学示意。
找一找上排的横纹、斜纹、竖带和弧纹。到了下排,它们保持纹理和顺序,位置移进历史区;新的四帧接替当前块。每层维护声学缓存,让下一块继续使用同一音频流的历史。
第四篇:NeMo Speech 3.0把 NEST 的 Mel 8 帧合并、mask 阈值与损失位置逐步画出,再讲 RNNT 的时间/文字双轴和缓存对象。模型卡中的 80–1120 ms 是 chunk 设置;端到端还包括计算、解码和 endpointing,要另外测量这些时间。
5. 效果比较与后续阅读
方法、模型和框架已经各就各位,最后用指定任务的同一评测条件比较,并选择下一篇深读。
5.1 统一条件下的多语迁移效果
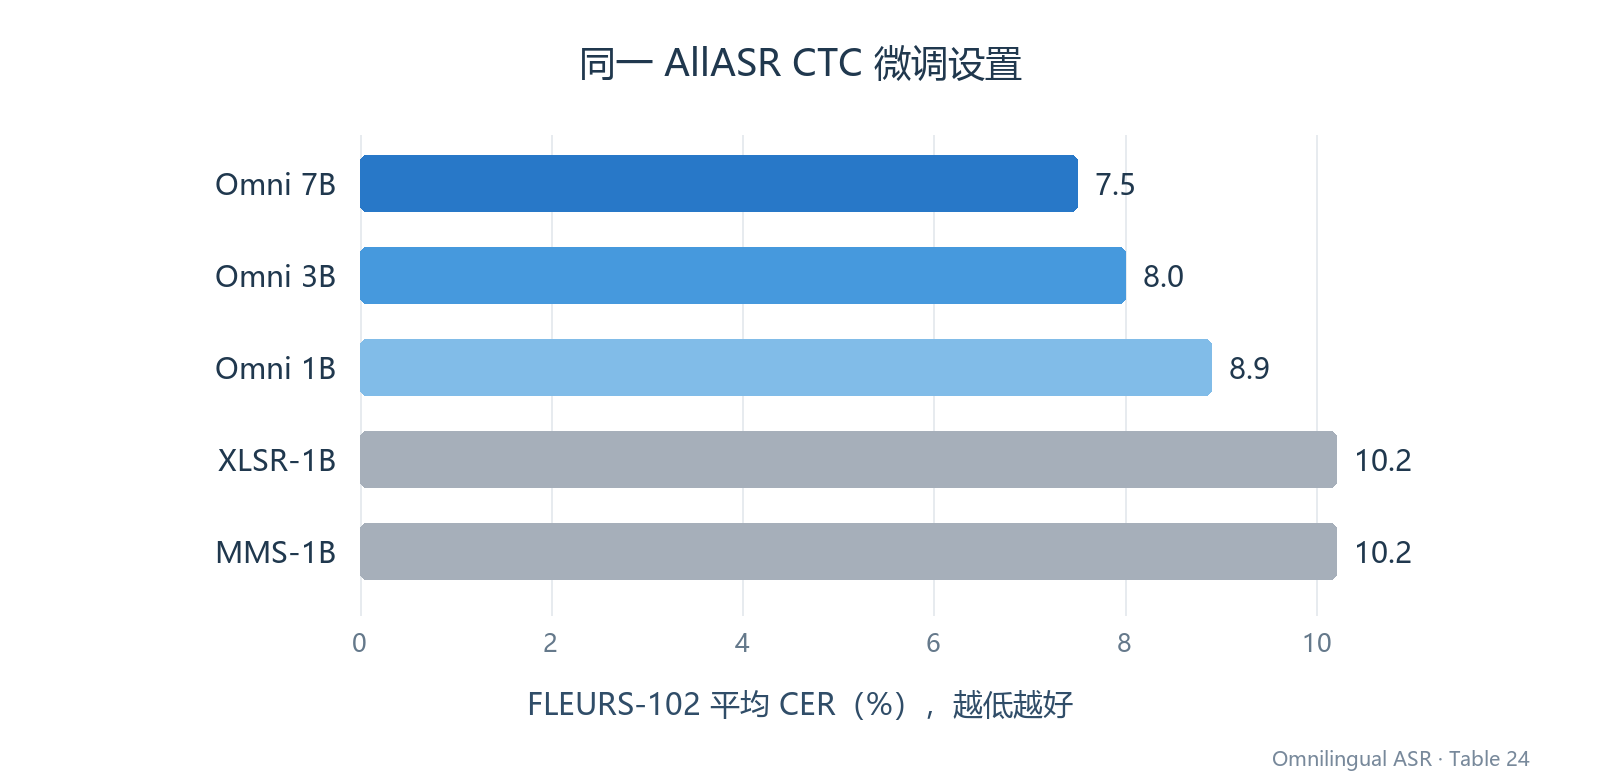
Omnilingual ASR Table 24 的数值重绘。相同 AllASR CTC 微调设置,CER 越低越好。
这张图可以直接比较柱子长度。Omni 7B 为 7.5,3B 为 8.0,1B 为 8.9;XLSR-1B 与 MMS-1B 都是 10.2。它们来自相同 AllASR CTC 微调设置下的 FLEURS-102 平均 CER,支持 Omni 在这个多语迁移实验中的价值。论文 §5.9、Table 24
如果换成单语言、小标注量、冻结主干或不同计算预算,这把尺子也跟着变了。NeMo/Nemotron 的成绩还要同时看 chunk、语言提示、标点归一化与实际延迟;NEST 的说话人 EER、ASR WER 和其他任务 accuracy,则回答各自的任务问题。先确定要完成的任务,再固定训练和评测条件,最后比较质量、成本与可复现程度。
5.2 按任务进入四篇深读
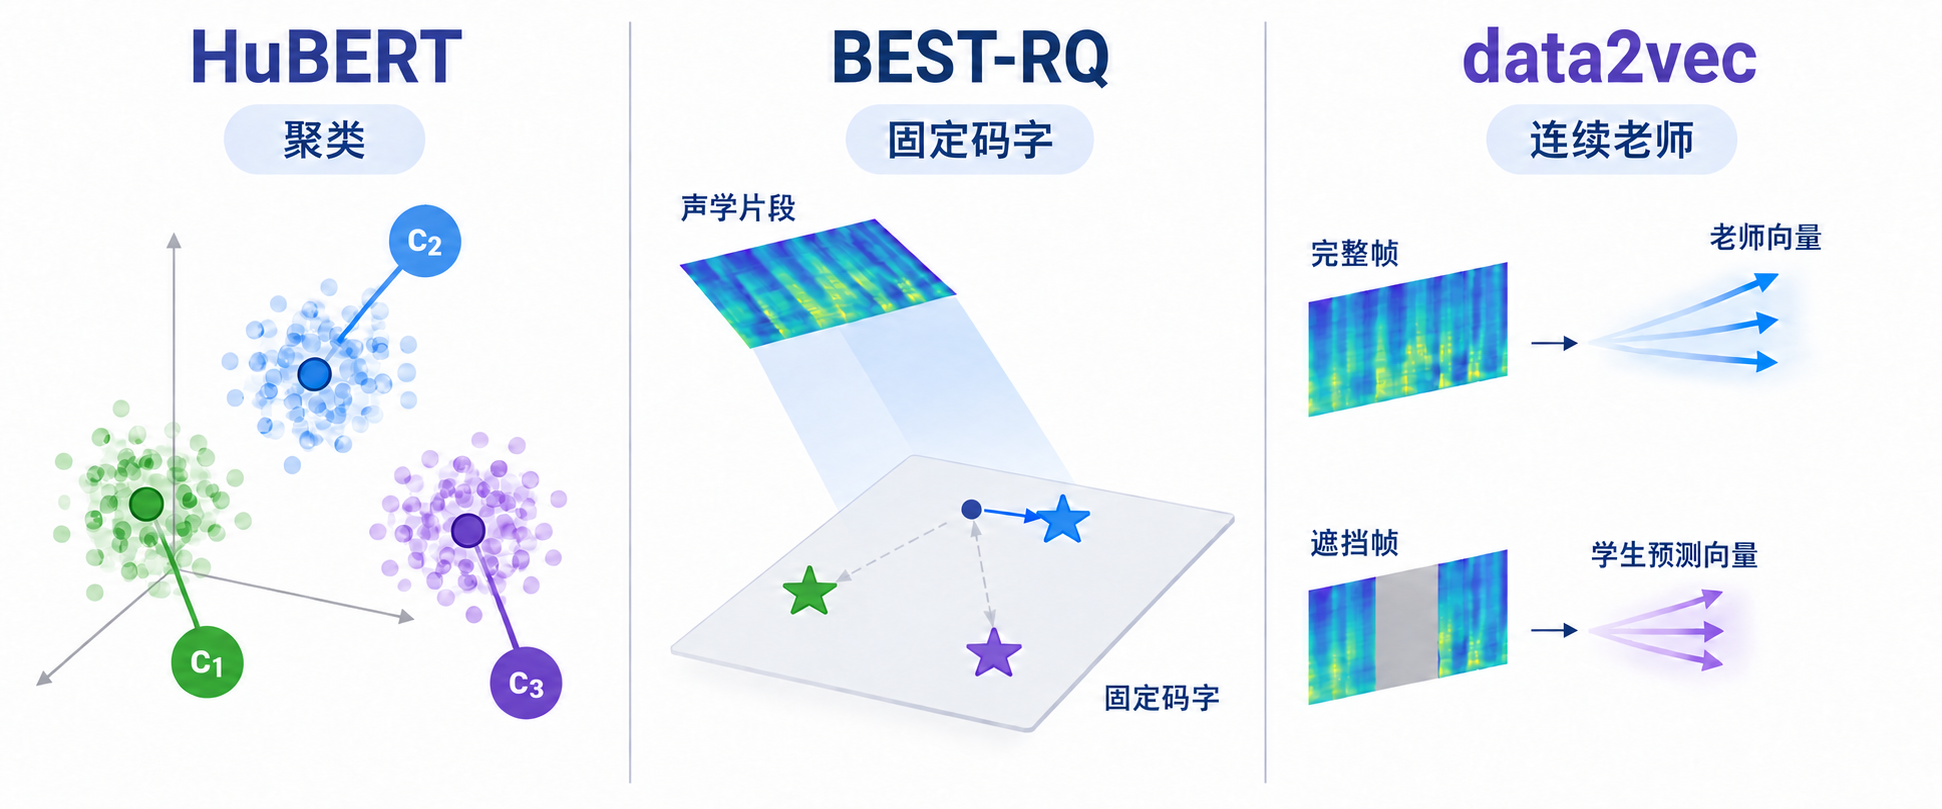
先看目标怎样生成,再追踪主干、训练规模与部署方式。ImageGen 教学示意。
图中的三种答案制造器,是进入后面深读的坐标。研究离散目标为何有用,从 HuBERT、BEST-RQ 看目标生成、干净/遮挡路径和标签对齐;自己训练多语 SSL encoder,从 fairseq2 + OmniASR-W2V 看采样、卷积长度、量化器梯度与 recipe 组装;在 NeMo 训练通用表示,从 NEST 看固定量化器、clean/noisy batch 和下采样后 loss;微调流式 ASR,则从 Nemotron 看 checkpoint 配置、context mask、cache 和 RNNT。
- 01 HuBERT:语音预训练的前史与隐藏单元:CPC → wav2vec → vq-wav2vec → wav2vec 2.0 → HuBERT,逐步看目标、标签、时间和预测损失。
- 02 BEST-RQ:固定随机目标与预训练支路:完整矩阵手算、SpeechBrain 重实现、USM 多头,以及 data2vec、WavLM 的不同取舍。
- 03 fairseq2 + OmniASR-W2V:大规模多语预训练:SSL 数据流、四档规模、CTC/LLM 迁移、冻结日程与同条件 CER。
- 04 NeMo Speech 3.0:NEST预训练与流式ASR:固定目标、FastConformer、mask 聚合、RNNT、声学缓存与监督微调。
5.3 资料范围与阅读说明
这里的论文和公开代码核对至 2026-10-12。原论文图保留作者、图号和许可,ImageGen 图用于直觉说明,精确数值图与手算负责核对具体计算。四篇都保留源码入口、版本和实验条件;本次没有运行完整训练,论文成绩与模型卡成绩分别注明来源。
完整训练语料、内部过滤和所有发布作业,需要逐项核对可取得的材料。各篇因此分别说明论文设置、仓库例子与已发布 checkpoint。四篇深读保持隐藏审阅状态,本导读公开。图片可以点击放大,读宽表时可收起左侧目录。
正在连接 GitHub 评论…