03|流匹配训练:插值路径、语音补全与条件丢弃
流匹配训练不需要先运行一条完整生成轨迹。每个样本随机选择流时间,把噪声与真实 mel 插值成一个中间状态,训练网络预测该位置的速度。生成时才沿多个时间步反复调用同一网络。
F5-TTS 又把任务组织成语音补全:模型可见部分参考语音,却不能在条件分支直接看到待生成区域的真实 mel。于是训练里至少有三种不同的遮罩含义,混在一起会造成标签泄漏或损失统计错误。原论文 §2–3
带噪声状态中含有目标信息是训练路径的一部分;条件分支泄漏完整目标则是另一回事。
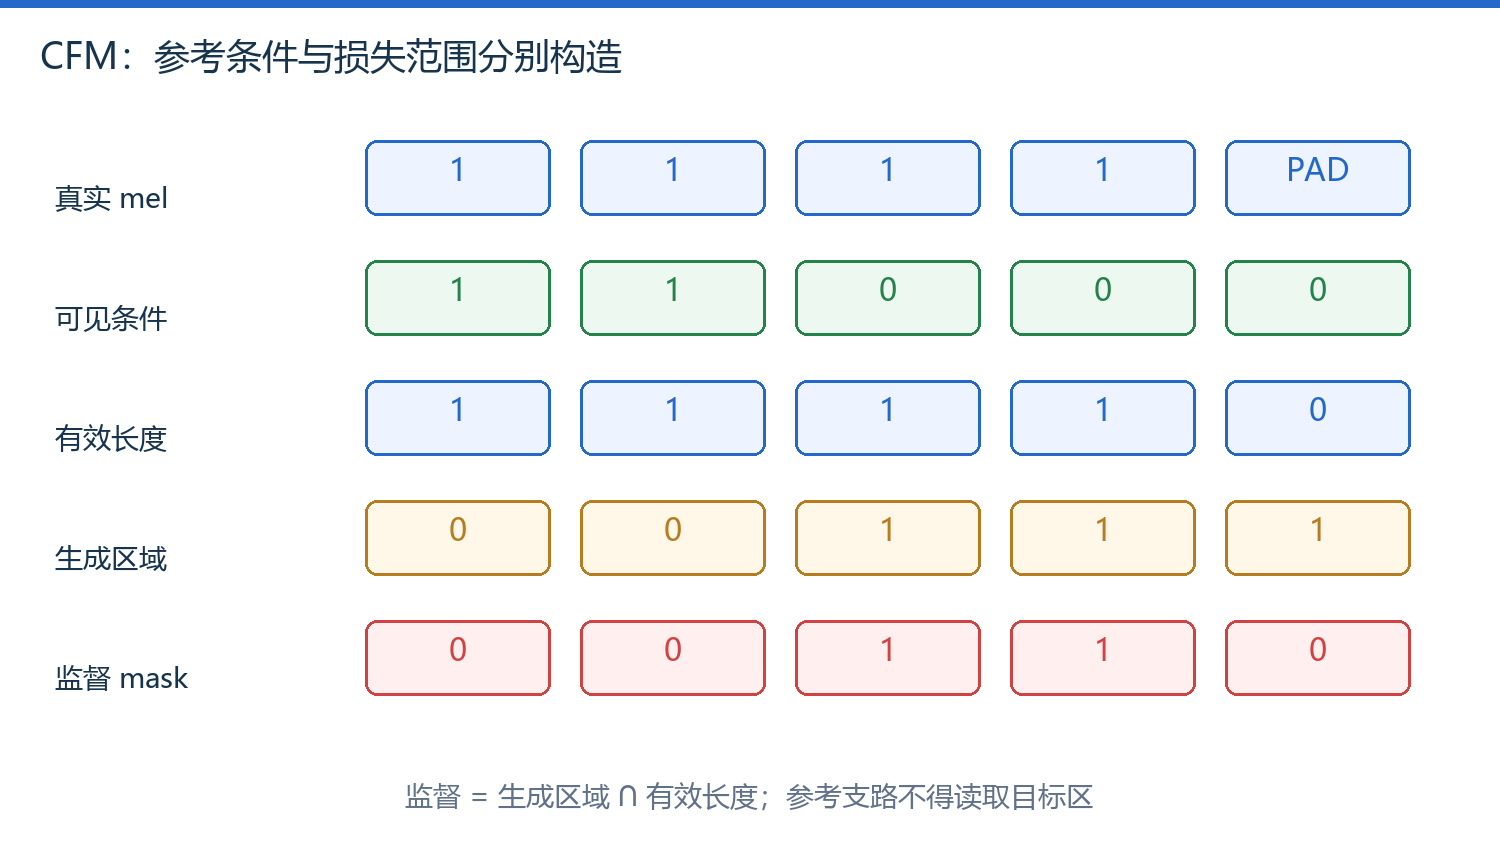
图 1|流状态、可见条件、有效长度与监督区域的区分
1. 从直线路径推导速度
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 采样的高斯噪声,[B,T,F]。 | |
| 真实 mel,同样为 [B,T,F]。 | |
| 0 到 1 的无量纲流时间;每个样本可随机抽取。 | |
| 两端点之间的中间状态。 | |
| 该条件直线路径的目标速度;对固定两端点不随 t 改变。 | |
| 对流时间求导,不是对音频采样点求导。 |
单个两频带位置取 X0=(0,2)、X1=(4,0):t=0.25 时状态为 (1,1.5),速度为 (4,−2)。训练网络看到的是混合了不同目标配对的状态,学到的整体速度场一般随状态与时间变化;不能因为某条条件路径是直线,就把所有真实生成轨迹都当成恒定速度。
2. 状态、参考条件与监督区域的掩码
| 位置示例 | 帧 0 | 帧 1 | 帧 2 | 帧 3 | 帧 4 |
|---|---|---|---|---|---|
| 有效帧 valid | 1 | 1 | 1 | 1 | 0 |
| 需要生成 generate | 0 | 0 | 1 | 1 | 1 |
| 条件 mel 可见 | 1 | 1 | 0 | 0 | 0 |
| 损失纳入 | 0 | 0 | 1 | 1 | 0 |
帧 4 即使标记待生成,仍属于 padding,所以不参加损失。用于注意力的有效长度 mask 与用于损失的监督 mask 也应分别传递;一个控制网络读取范围,一个控制梯度监督位置。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 批、音频帧和频带索引;t′ 避免与流时间 t 混淆。 | |
| generate 与 valid 的逻辑与,仅在真正要生成的有效区域为 1。 | |
| 网络预测速度;参数 θ 被训练。 | |
| 遮盖后的 mel 条件和文本条件。 | |
| 目标速度与频带总数;分母统计监督标量数。 | |
| 教学版 masked MSE;这里明确了批内有效元素平均规则。 |
若两帧各 2 频带都预测 0、目标速度全为 1,四个平方误差和为 4,除以 4 得到损失 1。参考区域再大,也不稀释这个数。
3. 构造一次训练批次
下方函数对应图 1 的四个输出:状态、参考条件、速度标签、监督 mask。它不执行神经网络;调用方把前三类条件交给网络,再按 mask 计算损失。
def cfm_batch(target, noise, time, generate, valid):
    # [B,T,F], time [B], Boolean masks [B,T]
    tau=time[:,None,None]
    state=(1-tau)*noise+tau*target
    reference=target.masked_fill((generate|~valid)[...,None],0)
    supervised=generate & valid
    if not supervised.any(): raise ValueError('no generated valid frame')
    return state,reference,target-noise,supervised
time[:,None,None] 保证同一句使用同一个流时间,并在帧与频带轴广播。把时间张量误放成 [T] 虽可能广播成功,却会变成每帧处于不同噪声阶段的另一个训练任务。
本轮 CPU 实验得到条件 [1,1,0,0,0]、监督 mask [0,0,1,1,0]、loss=1;参考帧和 padding 帧的预测梯度全为零。完整模型仍需验证注意力是否正确处理 padding。
4. 条件丢弃与 CFG 的训练基础
如果推理要比较有条件与无条件速度,训练就必须让模型见过对应的条件缺失状态。条件丢弃针对的是参考音频或文本支路,并不是把当前流状态整个清零。原论文区分音频条件丢弃,以及音频和文本同时丢弃;复现实例应按代码约定构造空条件。
| 输入支路 | 正常条件 | 对应丢弃情况 |
|---|---|---|
| 流状态 | 当前带噪 mel | 仍然保留 |
| 参考 mel | 可见语音部分 | 按训练配置变为无参考条件 |
| 文本 | 参考与目标文字 | 联合丢弃时采用空文本约定 |
| 流时间 | t | 始终需要 |
CFG 能否工作取决于训练过的条件缺失方式,不能临时发明一个从未见过的空输入格式。
5. 训练日志与最小验证
分别统计不同流时间区间、参考比例和语句长度上的误差。总均值相近时,早期低信噪阶段的错误可能更影响后续对齐。自由生成仍需固定文本、参考和随机种子,检查漏读与音色,而不只是看速度 MSE。
速度目标拟合正确不等于最终语音自然;长度估计、积分误差和声码器仍会影响结果。
继续 参考提示、Sway 与采样。
正在连接 GitHub 评论…