05|HiFi-GAN:并行波形生成与周期判别
声学模型已经能并行输出 mel,波形端若仍逐点生成,整条链路仍会被声码器限制。HiFi-GAN 用卷积生成器一次生成一段波形,用多个判别器学习人耳敏感的周期性与不同时间尺度结构。原论文 · 官方实现
生成器负责合成;判别器只在训练中提供反馈,推理不需要运行判别器。
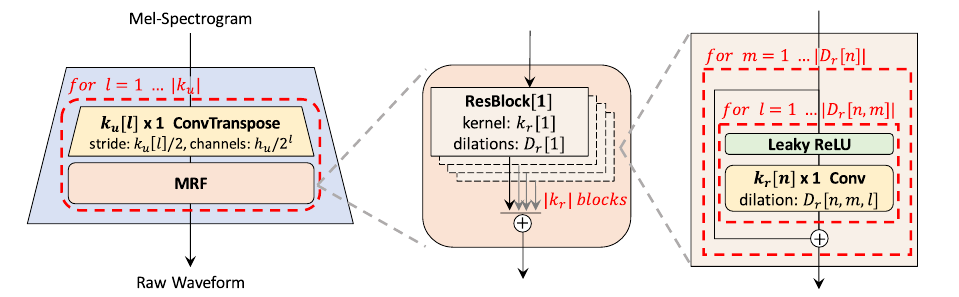
图 1|HiFi-GAN 的上采样与多感受野融合
深入学习路径
依次学习生成器、判别器、损失反向传播和前端验证,把“并行声码器”拆成能够实际实现与排错的模块。
| 子文章 | 阅读目标 |
|---|---|
| 01|生成器:转置卷积、残差块与多感受野融合 | 转置卷积、残差块与多感受野融合 |
| 02|判别器:多周期重排与多尺度观察 | 多周期重排与多尺度观察 |
| 03|训练目标:对抗损失、特征匹配与梯度路由 | 对抗损失、特征匹配与梯度路由 |
| 04|声学接口与验证:mel 配置、片段对齐与误差归因 | mel 配置、片段对齐与误差归因 |
各篇包含独立机制解释、张量或状态约定、数值例与验证边界。代码集中入口见 深入机制实验附录。
1. mel 帧如何变成波形采样点
转置卷积逐级提高时间分辨率,每一级后面的 MRF(多感受野融合)以不同卷积核、膨胀率观察同一段特征。不同分支融合后继续上采样,最后输出单通道波形。它不是先生成前一个样本再反馈,因此可以利用 GPU 对时间位置并行计算。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 输入 mel 帧数,教学例 10 帧。 | |
| 上采样阶段数,例为 4。 | |
| 上采样阶段索引。 | |
| 第 j 阶段的整数步幅;常见配置为 8、8、2、2。 | |
| 连乘运算,8×8×2×2=256。 | |
| 输出采样点数;假设卷积 padding 配置使各级精确扩展,本例 2,560。 |
若声学前端帧移为 256 点,上采样乘积也应为 256;若帧移是 300,直接接这个模型会改变时间关系。采样率、FFT 大小、mel 频率范围、幅度压缩和归一化也必须一致,光看 [80,T] 的形状不够。
2. MPD 与 MSD 分别看什么
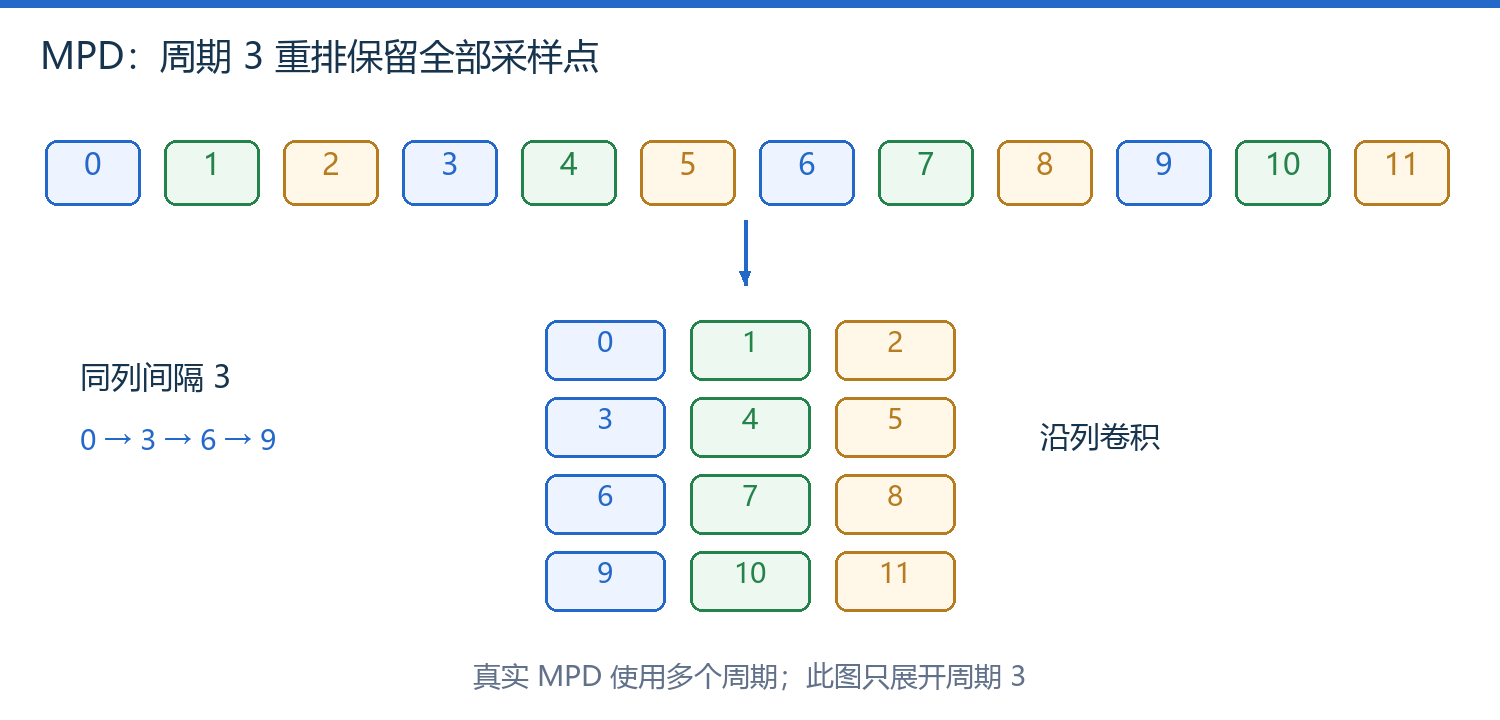
图 2|周期 3 的重排:同一列读取间隔为 3 的采样点
| 判别结构 | 操作 | 检查目标 |
|---|---|---|
| MPD,多周期判别器 | 按 2、3、5、7、11 等周期重排,沿同余位置卷积 | 周期结构与谐波相关细节 |
| MSD,多尺度判别器 | 原波形与不同下采样尺度 | 连续局部结构与较长范围结构 |
| MRF,生成器模块 | 多个感受野分支融合 | 为输出同时提供多种范围的信息 |
MPD 的“周期”不是逐帧提取出的 F0 周期;它用多个固定重排方式暴露统计规律。以 3 为周期,序列 0...11 排成四行三列,每列相邻元素相差 3。所有输入样本仍被使用,并非每三个点丢掉两个。
3. 为什么不只用对抗损失
| 损失 | 约束 | 单独使用的不足 |
|---|---|---|
| 对抗损失 | 让波形具有真实音频的统计特征 | 可能偏离给定内容,训练也易不稳定 |
| 特征匹配 | 让真实与生成音频在判别器中间层接近 | 依赖判别器学到的表示 |
| mel 重建 | 保持主要时频结构与输入一致 | 不能完全确定相位和细节 |
多种监督互补:既约束内容,又要求局部波形像真实声音。
GAN 损失下降不等于音质持续变好;需要固定验证样本、频谱检查和盲听。
4. 从 HiFi-GAN 到 BigVGAN 的变化
BigVGAN把周期归纳偏置进一步放入生成器,并处理非线性带来的混叠,在更广音频分布上探索通用声码器。GPT-SoVITS v3 使用的预训练 BigVGAN 配置与原版 HiFi-GAN 并不相同。比较前先核对采样率和 mel 配置,不能只替换权重文件。
| 复现顺序 | 成功证据 |
|---|---|
| 真实 mel 重建 | 声码器与前端匹配 |
| 接预测 mel | 能承受声学预测误差 |
| 测冷启动与热推理 | 区分权重加载和稳定运行成本 |
| 测长短句与批量 | 确认延迟与吞吐的适用范围 |
周期重排代码及实际结果见 机制实验源码。继续 Glow-TTS 与对齐。
专题导航:TTS 总目录
正在连接 GitHub 评论…