04|流式推理与缓存:因果等价、首包边界与并发状态
Qwen3-TTS 报告中的低延迟来自多个部件共同作用:低时间帧率、分层 token 生成、因果 codec 和合适的打包策略。工程验证也必须沿这条链拆分,不能只测一次主干前向就宣称端到端首包达到报告数字。
技术报告 §3.3 与表 2分别记录 LM 首包、codec 解码和并发变化。本文的 CPU 实验只验证缓存等价,不复现论文 GPU 速度。
正确缓存应在相同输入与状态初始化下复现完整计算;加速前先证明没有改变输出语义。
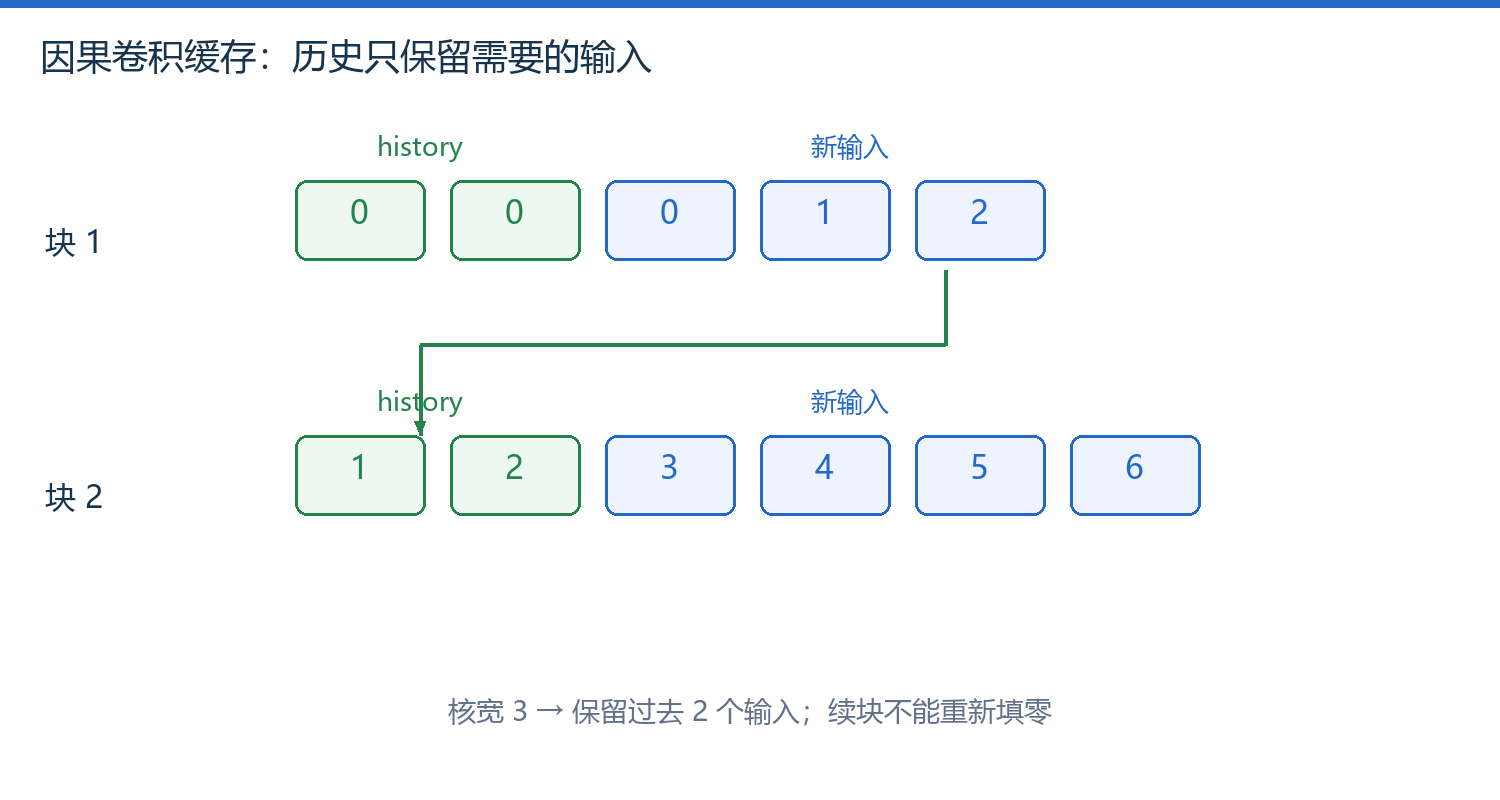
图 1|因果卷积逐块读取历史、计算新输出并更新状态
1. 推理状态的作用域与生命周期
| 状态 | 持续范围 | 新请求时 |
|---|---|---|
| 时间主干 KV cache | 当前语音序列 | 清空 |
| 帧内码本预测状态 | 当前帧的局部生成 | 按调用协议重新建立 |
| codec 卷积历史 | 当前音频流 | 初始化左侧上下文 |
| 待播放音频队列 | 当前客户端会话 | 停止旧流、处理残留 |
不同状态不能共用一个“cache”变量后任意传递。并发批处理中还要跟踪每条序列长度;一条提前 EOS,另一条仍继续时,padding 和状态索引都应保持各自语义。
2. 因果卷积的缓存等价性
对于 stride=1、dilation=1、核宽 K 的因果卷积,当前块需要保留前 K−1 个输入位置。PyTorch conv1d 使用互相关顺序;本例核 [1,2,3] 与窗口 [过去两点,过去一点,当前点] 对应。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 当前输出位置。 | |
| 输入与输出标量;句首越界输入填零。 | |
| 从较旧位置到当前位置的核权重,本例 1、2、3。 |
输入 0...11,位置 3 的结果是 1×1+2×2+3×3=14。如果恰在位置 3 开始新块,却重新零填充而不带历史,将得到 9;shape 相同,数值已经错误。
def causal_conv_chunk(x, history, weight):
    # Stride 1, dilation 1, [B,C,T]; history owns the last K-1 inputs.
    keep=weight.shape[-1]-1
    joined=torch.cat([history,x],-1)
    out=F.conv1d(joined,weight)
    new_history=joined[...,-keep:] if keep else joined[...,:0]
    return out,new_history
代码对应图 1 的 history + chunk → conv → output / 新history。实际 codec 包含多层、上采样、不同 stride 等,缓存长度与对齐规则更复杂;不能把本函数直接套在任意模型上。
3. 本轮实际检查
完整序列一次卷积,与按 3、4、5 个位置切块的缓存卷积,输出均为:
[0,3,8,14,20,26,32,38,44,50,56,62]
max_abs_error = 0
这是固定 float32 整数样例上的精确一致。真实网络在不同精度、批大小和执行内核下,通常需要给出合理的绝对/相对误差容差。比较两次独立随机语音输出没有意义,应固定 token 与噪声后比较同一计算。
4. 一帧可解码与四帧一包
12.5 Hz 对应每帧 80 ms 音频;报告的四帧包覆盖 320 ms,用于减少过碎调度开销。因果 codec 理论上不需要额外右侧帧,但实际产品选择包大小后仍要等包内 token 到齐。
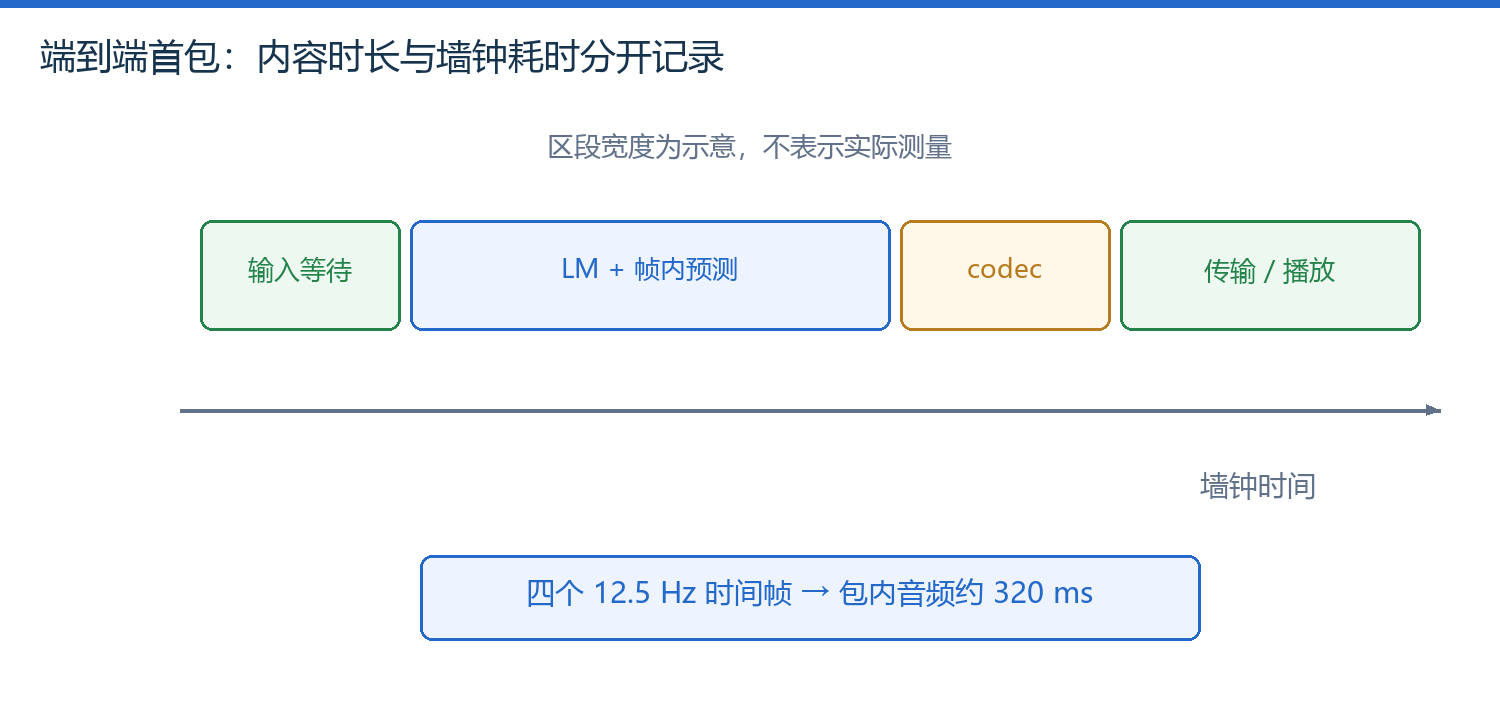
图 2|输入等待、主干与局部生成、解码和传输分别计时
| 时间量 | 起止边界 | 容易混淆的对象 |
|---|---|---|
| 输入等待 | 请求开始到满足可生成条件 | 网络推理时间 |
| 首个 token | LM 开始到第一个生成编号 | 完整码本帧或可播放音频 |
| 首个音频包 | 解码启动到包可交付 | 包内 320 ms 音频时长 |
| 用户首音 | 请求发出到客户端开始播放 | 服务端首包完成 |
报告表 2 在其单并发配置下,0.6B 12Hz 的 LM 首包 93 ms、解码 4 ms,合计 97 ms;1.7B 对应 97+4=101 ms。该数字不包括你任意更换硬件、队列与传输协议后的保证,也不是本轮实测。
5. 可复查的性能记录
记录设备、精度、批大小、输入长度、输出秒数、冷/热状态和并发数。GPU 操作异步,需要用事件或同步边界计时;记录首包与总耗时时也要说明是否包含 tokenizer、参考编码和数据搬运。
把“因果等价正确”和“性能更快”分成两个实验,避免速度收益掩盖音频接缝或漏帧。
取消请求时只停止网络发送而不释放生成状态,会继续耗费计算并可能污染下次请求。
与 多码本调度结合阅读,可区分序列布局、模型状态和服务缓冲三个层次。
正在连接 GitHub 评论…