07|神经音频编码:EnCodec、RVQ 与音频 token
波形每秒有数万个采样点,直接把每个点当成语言模型 token 会产生极长序列。神经音频编码器先降采样为连续特征,再量化成有限词表中的整数;解码器负责从这些整数恢复波形。这里的“词表”存储向量原型,不是中文汉字或英文单词。EnCodec 论文 · 官方实现
音频帧数决定时间长度;码本数决定每帧表达多少层细节。
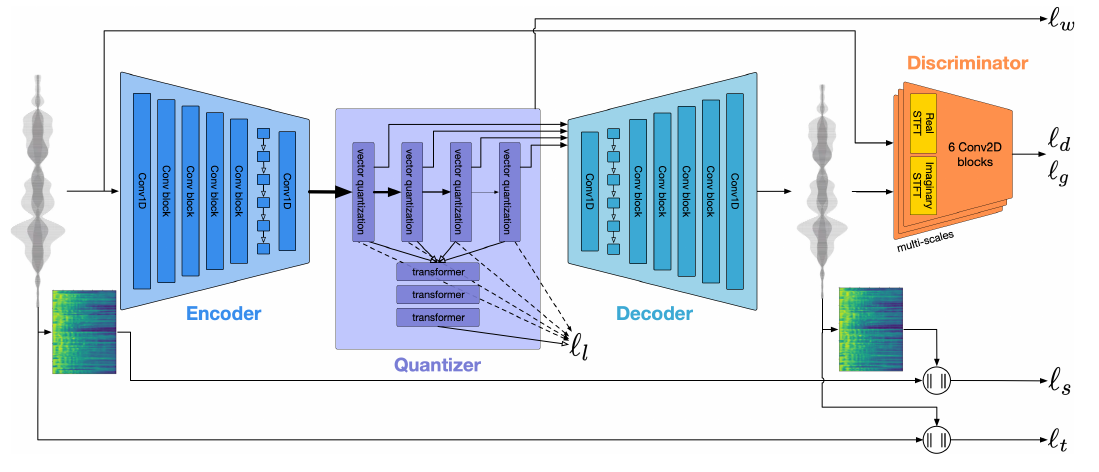
图 1|EnCodec 的编码、残差量化与波形重建
1. RVQ 的逐层残差
单个码本只能从有限原型中选一个近似。Residual Vector Quantization(残差向量量化)先量化原向量,再让下一层量化剩余误差,多层相加得到更精细重建。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 一帧连续编码向量,维数 D;无直接物理单位。 | |
| 开始时尚未解释的全部向量。 | |
| 码本层索引,1 至 K。 | |
| 使用的码本层数。 | |
| 某码本中的候选编号。 | |
| 第 k 层第 i 个码字向量,维数 D。 | |
| 当前层选中的整数编号。 | |
| 返回距离最小的编号,不返回距离本身。 | |
| 减去本层近似后的残差。 | |
| 所有已选码字相加形成的重建向量。 | |
| 平方欧氏距离;每维差值平方后相加。 |
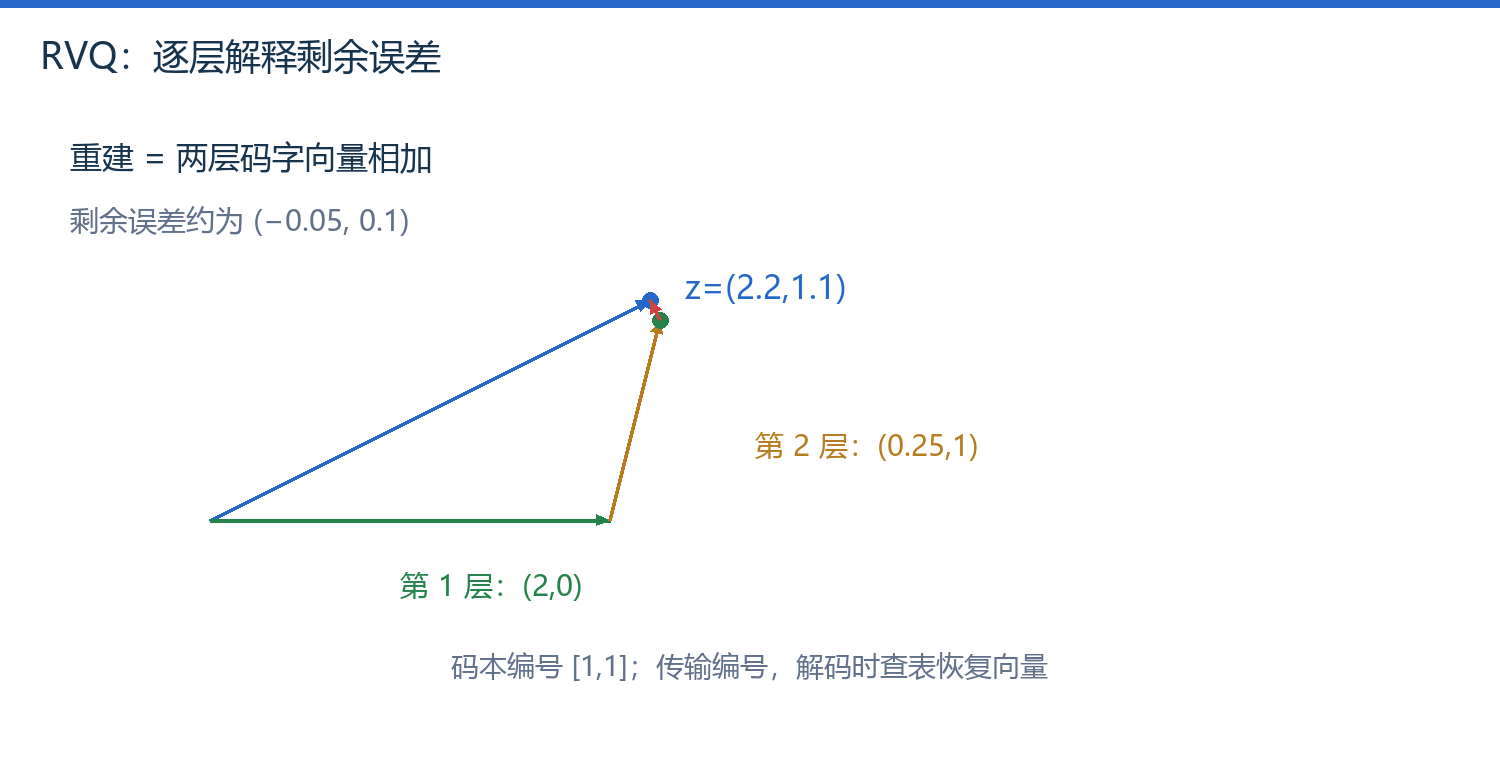
图 2|二维教学例:第一层取主成分,第二层修正残差
令 ,第一层选择 ,剩余 ;第二层选 ,重建为 ,残差约为 。每层选的都是向量,传输时只需发送它的编号;接收端必须拥有相同码本。
2. 帧率、token 数与码率
不考虑熵编码和包头时,定长编号的名义码率为:
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 名义码率,单位 bit/s。 | |
| 音频 token 帧率,单位帧/秒。 | |
| 每帧使用的码本数。 | |
| 每层码本大小,假设各层相同。 | |
| 以 2 为底的对数,计算编号所需比特。 | |
| 向上取整,确保编码所有编号。 |
教学例:75 帧/秒、8 层、每层 1024 个码字,得到 bit/s,即 6 kbit/s。10 秒语音有 750 个时间位置,但有 6,000 个码本编号;将这些编号全部展平,会显著拉长语言模型序列。
码率计算能同时解释压缩收益与下游语言模型的序列成本。
第一个码本并不天然等于纯语义;是否加入语义教师或联合任务,要看具体 tokenizer。
3. 从 codec 到 TTS
| 技术 | 模型要预测什么 | 如何处理多层信息 |
|---|---|---|
| VALL-E | codec 编号 | 首层自回归,其余层条件补全 |
| NaturalSpeech 2/3 | 连续潜变量或属性分解表示 | 扩散生成与属性分解 |
| Qwen3-TTS | 低帧率多码本编号 | 时间主干与帧内预测模块 |
| 2026 年进展 | 低帧率 token、掩码或双层 AR | 多条路线继续并行发展 |
RVQ 的逐层最近邻实现与数值检查在 机制实验源码。只有重建测试通过,才能把合成错误继续定位到上游 token 生成器。
专题导航:TTS 总目录
正在连接 GitHub 评论…