01|流式 TTS:分块、上下文缓存与延迟指标
“流式”至少包括两个独立问题:输入文字是否能逐步到达,输出音频是否能逐块播放。一个系统即使返回音频流,也可能先等完整文字句子。分析实现时,应从用户等待开始计时,而不是只从 GPU 启动某层网络开始。
TTFT、首个可播放音频延迟和 RTF 分别描述不同阶段。
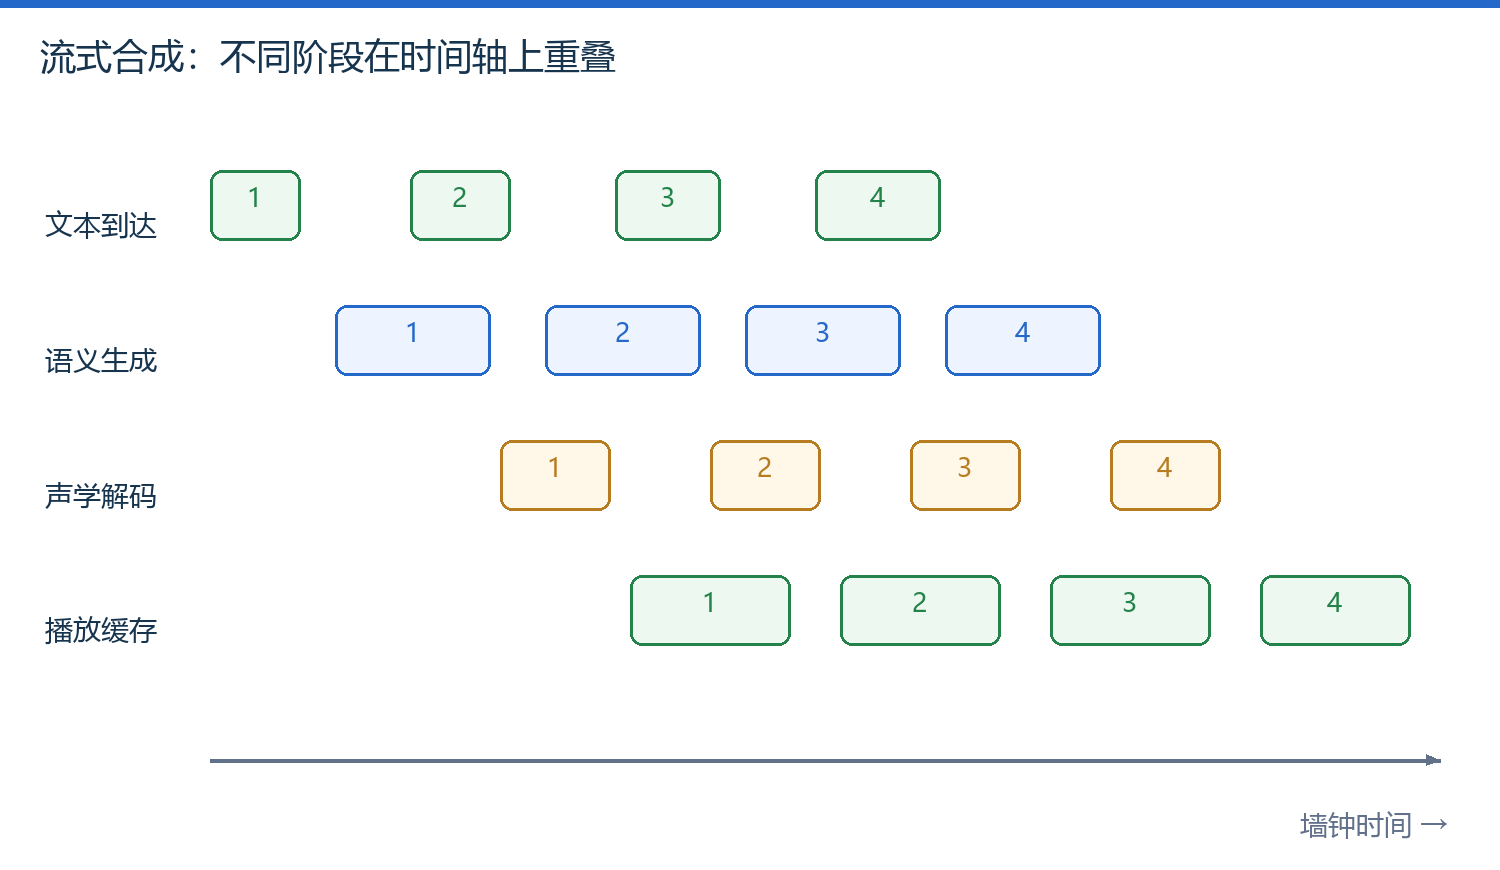
图 1|文本到达、语义生成、声学解码与播放在时间轴上的重叠
1. 指标定义与手算
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 完成指定合成任务的计时耗时,单位秒;需说明是否含加载、前端和传输。 | |
| 输出音频可播放时长,单位秒。 | |
| 实时率,无量纲;小于 1 表示计算比播放更快。 |
生成 10 秒音频耗时 2 秒,RTF 为 0.2。但若前 1.8 秒没有任何音频可播,用户仍感到明显等待。反过来,首包 100 ms 到达而后续经常断流,也不是稳定实时合成。
| 指标 | 测量边界 | 应一起报告 |
|---|---|---|
| TTFT | 请求/输入就绪到首个语音 token | token 定义、是否包含前端 |
| TTFA / 首包延迟 | 到首段可解码或可播放音频 | 首包时长、声码器、传输 |
| RTF | 全任务计算时间 / 音频时长 | batch、并发、设备、精度 |
| 块间延迟 | 相邻块到达间隔 | 分位数、播放缓存与断流次数 |
2. 分块为什么需要上下文
| 状态 | 保存目的 | 丢失时可能出现 |
|---|---|---|
| LLM KV cache | 避免重复计算已读 token,保留生成上下文 | 延迟增长、上下文行为改变 |
| CFM 的历史条件/允许窗口 | 保持块间声学衔接 | 韵律或音色跳变 |
| 声码器卷积/Transformer 状态 | 维持波形生成连续性 | 接缝、爆音、起音重复 |
| 前端未决文本缓冲 | 等待尚不明确的发音 | 数字、单位与多音词提前读错 |
这些状态的生命周期不同:同一次生成跨块保留;用户开始新一句或换说话人时,哪些状态重置必须明确定义。不能为了低延迟把上一个用户的参考条件带给下一次请求。
正确缓存既减少重复计算,也保留跨块的模型上下文。
3. 截至 2026 年的新进展
X2Streaming-TTS(2026-08)关注严格因果文字输入:对未决数字与单位缓冲,结合容量与标点决定分段,同时传递 Talker 的历史状态和 Code2Wav 状态。它处理的是“已经播出的发音不能撤回”的问题。
| 输入前缀 | 过早决定的风险 | 流式前端应记录 |
|---|---|---|
| “共计 3” | 后续可能出现小数点或单位 | 未决数字片段 |
| “2026/” | 后续可能补日期,读法变化 | 规范化是否可提交 |
| 一长句持续到达 | 等句号会无限延后 | 块容量、标点候选与上下文预算 |
论文报告的 15.8 ms 是单请求的首个音频 token 中位延迟,不能改写成任何设备上的端到端首个可听声音延迟。
这属于论文与公开实现层面的新方向,尚不代表所有语种、符号、并发环境都得到验证。复现实验应同时提供输入 token 到达时间,不能把完整文本提前放进内存再宣称严格在线输入。
4. 服务排查表
| 症状 | 定位动作 |
|---|---|
| 首包慢,后续快 | 分开统计前端、prompt 编码、LM prefill、首块解码 |
| 每块都有短停顿 | 检查同步阻塞与缓冲阈值 |
| 接缝明显 | 检查状态重置、重叠裁剪与采样率 |
| 并发一高便断流 | 记录尾延迟而非只有平均 RTF |
正在连接 GitHub 评论…