01|VALL-E 与 VALL-E 2:将语音合成转为条件 token 预测
VALL-E 使用参考语音的 codec token 作为提示,预测目标文本对应的音频 token,再通过 codec 解码器恢复波形。它把零样本声音迁移与大规模条件语言建模结合起来。VALL-E · VALL-E 2
参考提示提供说话方式,目标文本提供要朗读的内容,二者承担不同条件角色。
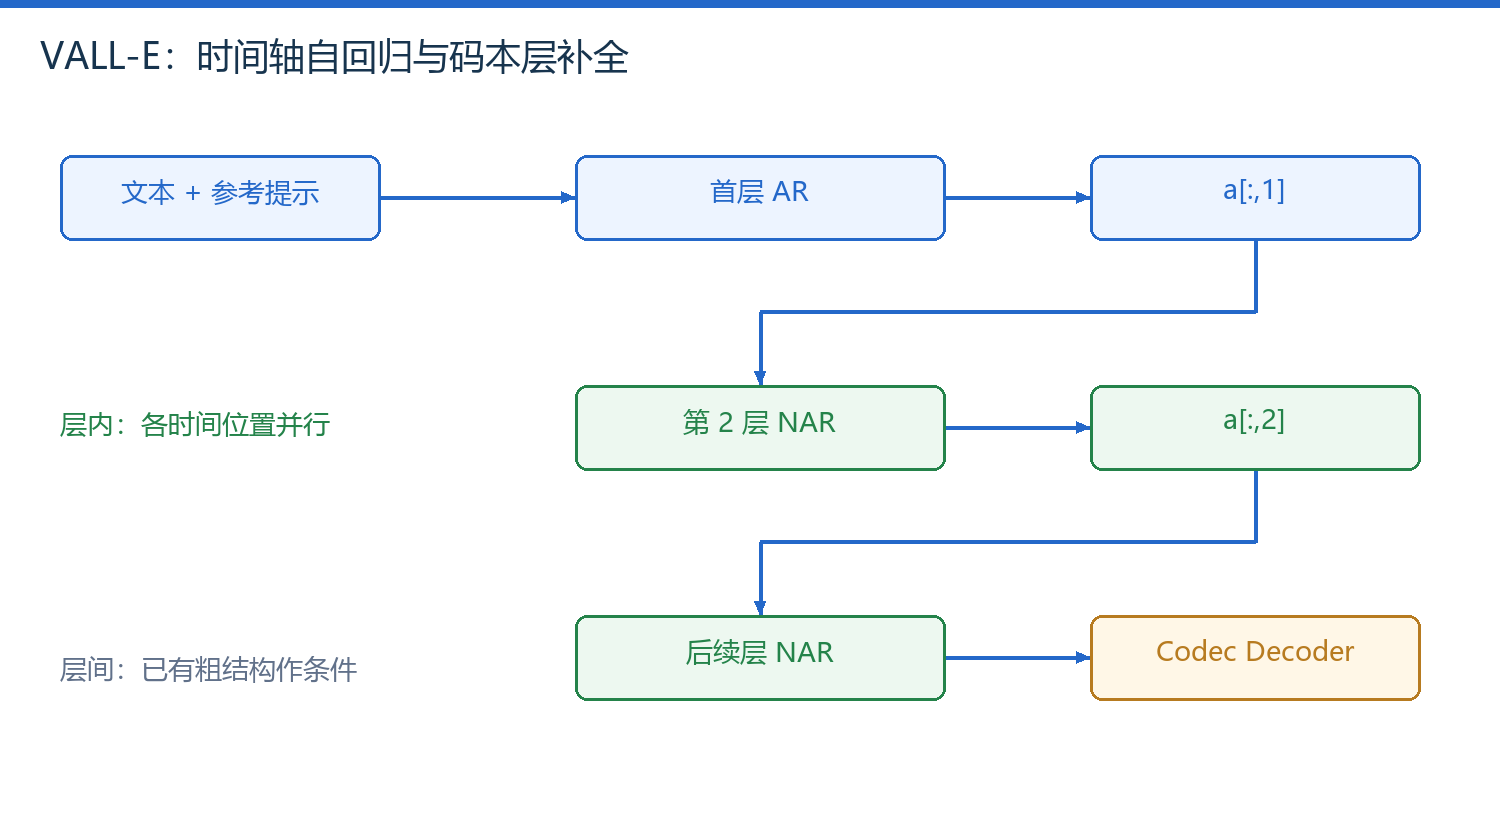
图 1|首层沿时间生成,后续码本在已知首层条件下补全
1. 为什么拆成 AR 与 NAR 两部分
如果时间长度为 750 帧、每帧 8 层,完全展平为 6,000 步会增加延迟。原版把第一层沿时间自回归生成,再按层预测其余码本;每个后续层可以沿时间并行。它不是把所有层都独立预测,因为后续层需要已经生成的粗结构。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 目标音频 token 矩阵,时间 T × 码本 K。 | |
| 文本条件;实际序列格式还需按原实现组织参考与目标文字。 | |
| 参考语音等提示条件。 | |
| 码本层索引。 | |
| 码本总层数。 | |
| 所有时间位置的第一层编号。 | |
| 第 k 层之前已经获得的全部层。 | |
| 表示整个时间轴,不是概率中的特殊运算。 | |
| 条件概率分布;此式展示层间分解。 | |
| 各层条件概率相乘;首层内部另有时间自回归分解。 |
教学例有 4 帧、3 层:首层先决定 4 个编号;第二层基于这些编号给每帧补一次修正;第三层再补更细的修正。此处“粗细”是建模作用,不代表第一层完全没有音色,后面完全没有文字信息。
2. 提示与目标的边界
| 内容 | 在推理中可见吗 | 用途 |
|---|---|---|
| 参考录音及其编码 | 可见 | 提供音色、声学环境、韵律线索 |
| 目标文本 | 可见 | 约束生成内容 |
| 目标录音 token | 不可见 | 只能由模型生成 |
| 训练时前面的真实目标 token | 可用于 teacher forcing | 推理要换成已生成 token |
新说话人通过上下文条件进入模型,通常无需逐人重训权重。
3. VALL-E 2 改进了哪两个环节
| 原问题 | VALL-E 2 的机制 | 代价与边界 |
|---|---|---|
| AR token 反复循环 | repetition-aware sampling 调整重复风险下的采样 | 正常语音也有重复,不能一律禁止重复编号 |
| 长 token 序列计算成本 | grouped code modeling 合并时间建模单元 | 更复杂的组内表示与解码规则 |
论文标题中的 human parity 指其评测设置中的比较结果,不能推导为所有语言、长文本、噪声参考都达到真人。本文没有复现该主观评测。相关研究也不意味着官方已经提供可任意部署的完整模型服务。
不能把某个第三方“VALL-E 复现仓库”的权重、数据与速度写成微软原论文结果。
4. 后续技术的分岔
GPT-SoVITS 先预测较紧凑的语义 token,再用条件声学网络恢复细节;Qwen3-TTS 12Hz 路线直接建模多码本 token。它们借用了语言建模范式,但 token 语义、帧率与解码器并不通用。返回 音频编码导读,继续 NaturalSpeech。
正在连接 GitHub 评论…