01|流匹配实现:条件区域、Euler 积分与 CFG
本节把训练目标和推理更新拆成三个小函数。这里使用已知二维恒定速度验证积分;真实模型的速度依赖当前状态与条件,因此不会因为四步教学例能精确到达终点,就在四步获得高质量语音。
训练目标函数、损失掩码与推理积分器是三个不同职责。
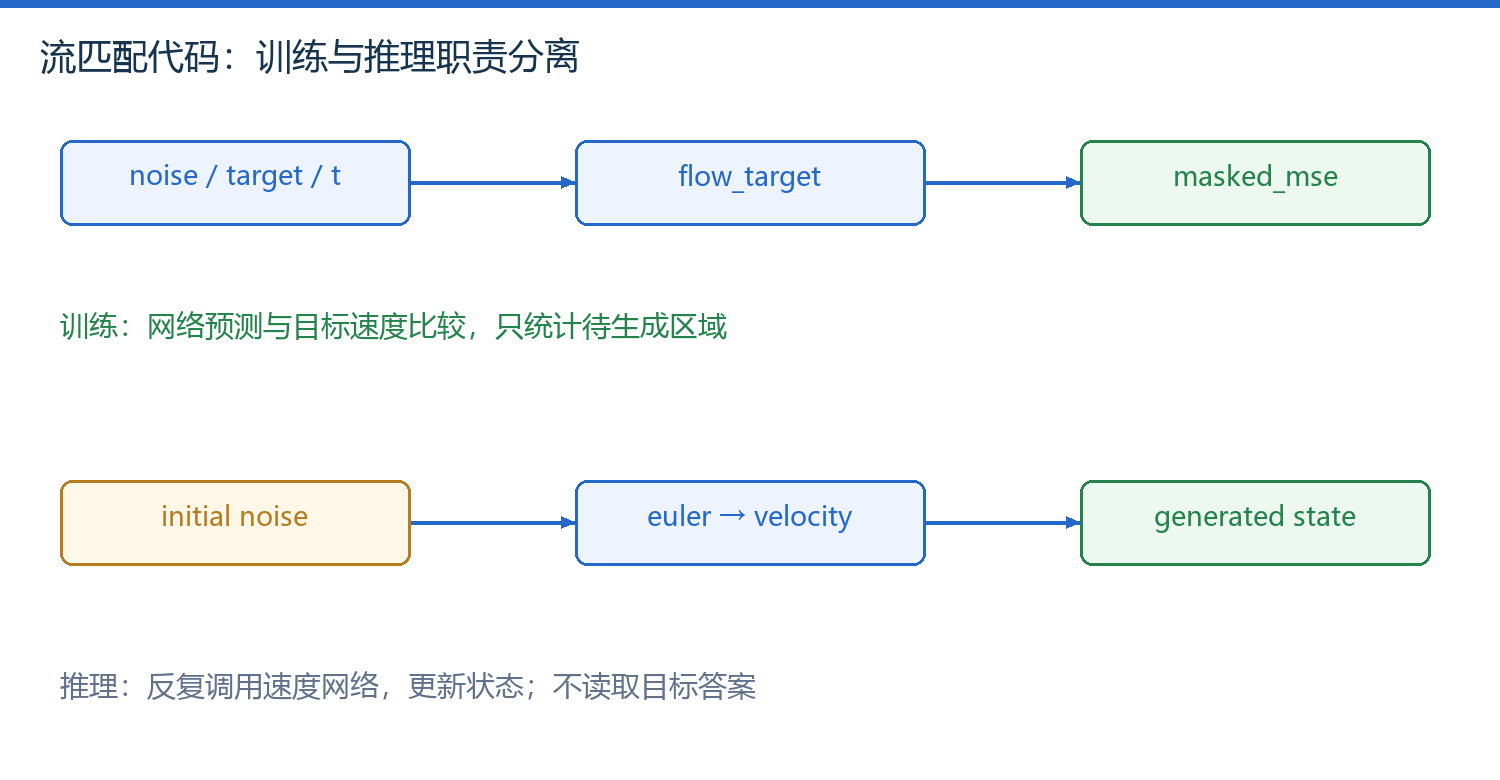
图 1|训练构造监督与推理调用速度网络的代码关系
1. 训练路径与张量约定
| 函数 | 输入 | 输出 |
|---|---|---|
flow_target | 同形状的噪声、真实特征与流时间 | 插值状态、目标速度 |
masked_mse | 预测/目标 [B,T,F];bool mask [B,T] | 只统计生成区有效元素的标量 |
euler | 初始状态、速度函数、步数 | 最终状态 |
def flow_target(noise, target, time):
    return (1-time)*noise + time*target, target-noise
def masked_mse(prediction, target, generated_mask):
    """Mask [B,T] includes generated valid frames only; tensor [B,T,D]."""
    weight = generated_mask.unsqueeze(-1).expand_as(prediction)
    if not weight.any(): raise ValueError('empty generated region')
    return (prediction-target).square()[weight].mean()
参考区和 padding 区的 mask 都为 False。只屏蔽 loss 而不处理条件输入,仍可能泄漏完整目标;只屏蔽输入而不屏蔽 padding loss,则模型会花容量拟合补齐值。
2. Euler 更新的量纲与手算
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 数值积分步索引,0 至 S−1。 | |
| 本教学积分的步数。 | |
| 第 j 步当前频谱状态;上标是迭代编号,不是乘方。 | |
| 第 j 步的流时间,教学等距网格 j/S。 | |
| 相邻流时间差,无音频秒单位。 | |
| 条件速度网络;本实验用恒定函数替代。 | |
| 文本与参考条件;恒定教学函数省略此参数。 |
def euler(initial, velocity, steps):
    if steps < 1: raise ValueError('steps must be positive')
    state = initial.clone()
    for j in range(steps): state = state + velocity(state,j/steps)/steps
    return state
从 (0,2) 开始,以速度 (4,-2) 走四步,每步加 (1,-0.5);状态依次为 (1,1.5)、(2,1)、(3,0.5)、(4,0)。实验同时检查被屏蔽位置梯度为零、生成区梯度非零。
实验验证了更新方向、步长和掩码,没有把目标数据误当成推理输入。
3. CFG 的计算与额外开销
无分类器引导用有条件与去条件的两次速度估计做外推。采用 F5-TTS/GPT-SoVITS 常见约定:
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 有文本/音频条件时的速度预测。 | |
| 按训练规定丢弃条件时的预测。 | |
| 引导强度;0 仍然是有条件预测。 | |
| 提供给积分器的最终速度。 |
若 、、,最终速度为 (5,-2.5)。这不保证一定更接近真实样本,只加强与条件有关的方向。许多配置会产生额外网络评估,速度比较应说明是否启用 CFG。
不同库可能用 w 与 α 的不同定义;把数值直接照搬,可能把引导强度整体错移 1。
完整可运行脚本见 机制实验源码。返回 F5-TTS,继续 GPT-SoVITS 声学解码。
正在连接 GitHub 评论…