01|FastSpeech 2:音高、能量与一对多映射
同一句“今天下雨了”可以平静陈述,也可以惊讶地上扬。文字本身没有包含全部音高、停顿和响度信息。FastSpeech 2 用显式条件缩小这一信息缺口,并直接学习真实录音的 mel,减少原版教师蒸馏带来的信息损失。论文
variance adaptor 把时长、音高和能量作为可预测、可控制的条件。
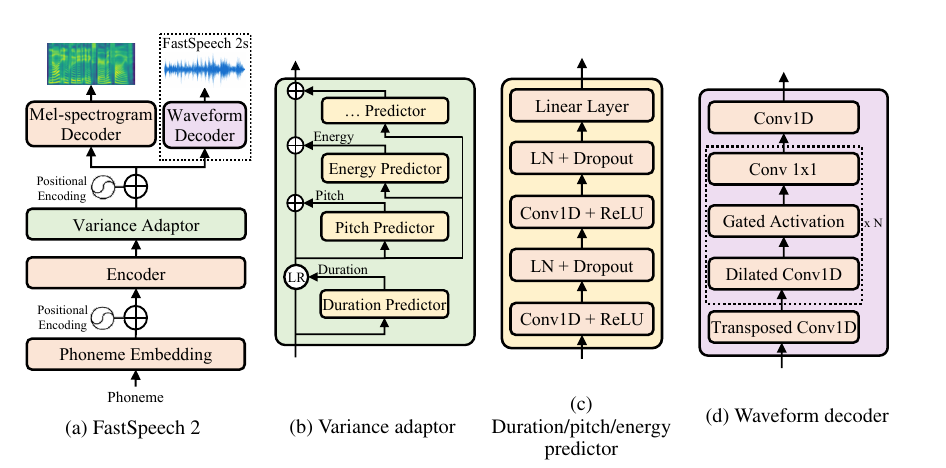
图 1|FastSpeech 2 的变异适配器与预测分支
1. 三种条件承担不同职责
| 条件 | 物理含义 | 常见表示 | 控制效果 |
|---|---|---|---|
| duration | 音素持续多久 | 整数帧数,预测常在对数域 | 语速与局部停顿 |
| pitch / F0 | 有声音段的基频 | Hz、对数 F0 或其变换 | 语调;不是说话人身份的全部 |
| energy | 帧内信号强弱 | 频谱幅值的范数等 | 强弱变化;不是无条件音量旋钮 |
原论文的音高预测使用连续小波变换(CWT),把曲线分解成多尺度分量再预测和重建;不少开源复现直接预测音素级或帧级 F0。讨论代码时必须说明采用哪一种,不能把简化实现写成原论文。
2. 时长监督的数值尺度
以下用常见教学约定 说明零时长的处理。它是本实验约定,不要求所有实现采用相同变换:
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 平均时长回归误差,无物理单位。 | |
| 有效音素个数,padding 不参与平均。 | |
| 有效音素索引。 | |
| 标注时长,单位帧,非负整数。 | |
| 网络输出的对数时长预测值。 | |
| 自然对数;加 1 使零帧可表示。 | |
| 对有效位置求平均;不是对补齐后的最大长度平均。 |
取 ,标签约为 [1.0986,0.6931,1.3863]。若预测分别多出 [0.1,-0.2,0],平方误差为 [0.01,0.04,0],平均为 。推理通过指数逆变换、截断与取整回到帧数;不能把对数值直接用于重复向量。
3. 训练和推理必须分别画路径
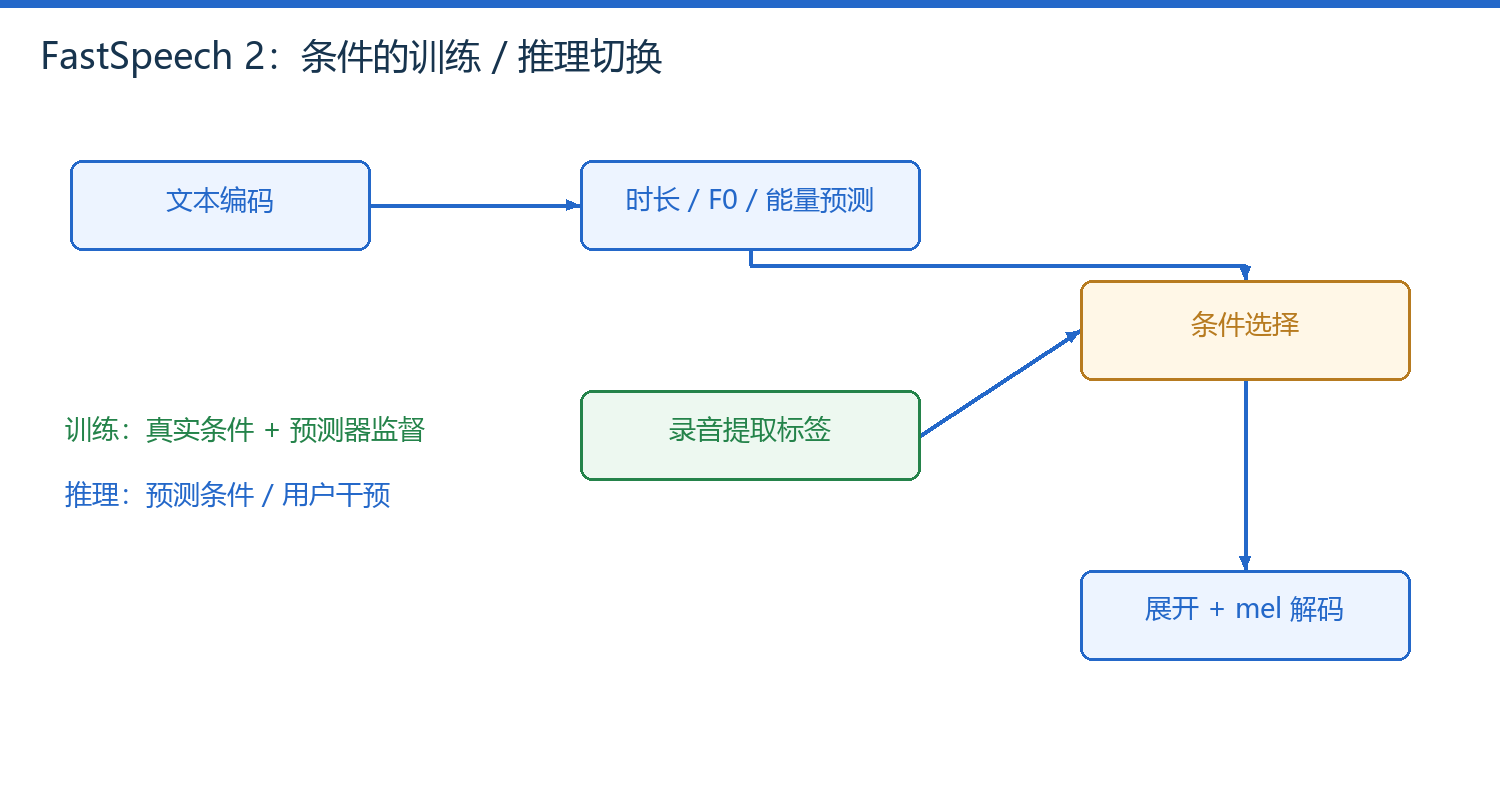
图 2|真实变异条件用于训练,预测条件用于推理
| 路径 | 时长 / 音高 / 能量从何而来 | 损失作用在哪里 |
|---|---|---|
| 训练声学预测 | 对齐与录音提取值 | mel 重建监督声学主干 |
| 训练条件预测器 | 文本隐藏状态 | 预测值对齐提取标签 |
| 推理 | 条件预测器,或用户指定值 | 不计算监督损失 |
可以独立干预时长或音高,并观察另外两类因素是否受到连带影响。
pitch 的无声区不是 0 Hz 的正常声带振动;清浊标记、插值和标准化需要匹配训练预处理。
4. 排错与下一步
| 错误 | 首先验证 |
|---|---|
| 音频被压缩或拉长 | 帧移、时长和 mel 帧数之和是否一致 |
| 声调异常 | pitch 单位、均值方差、清浊区处理是否一致 |
| 训练正常、推理明显退化 | 是否只测试真实条件,没有测试预测条件 |
| 词内突变 | 条件是音素级还是帧级;展开次序是否一致 |
FastSpeech 2s 是进一步直接输出波形的分支,不能把普通 FastSpeech 2 加外置声码器写成 2s。继续 长度调节器实验,或返回 FastSpeech 导读。
正在连接 GitHub 评论…