01|GPT-SoVITS 语义建模:SSL 量化与前缀因果遮罩
本节追踪“文字怎样变成可解码的语义序列”。先理解 token 从哪里来,再阅读预测网络;否则容易误把 HuBERT 特征、量化编号与声学潜变量当成同一种东西。
训练标签来自音频编码与量化;GPT 预测的是编号分布,不是直接预测波形。
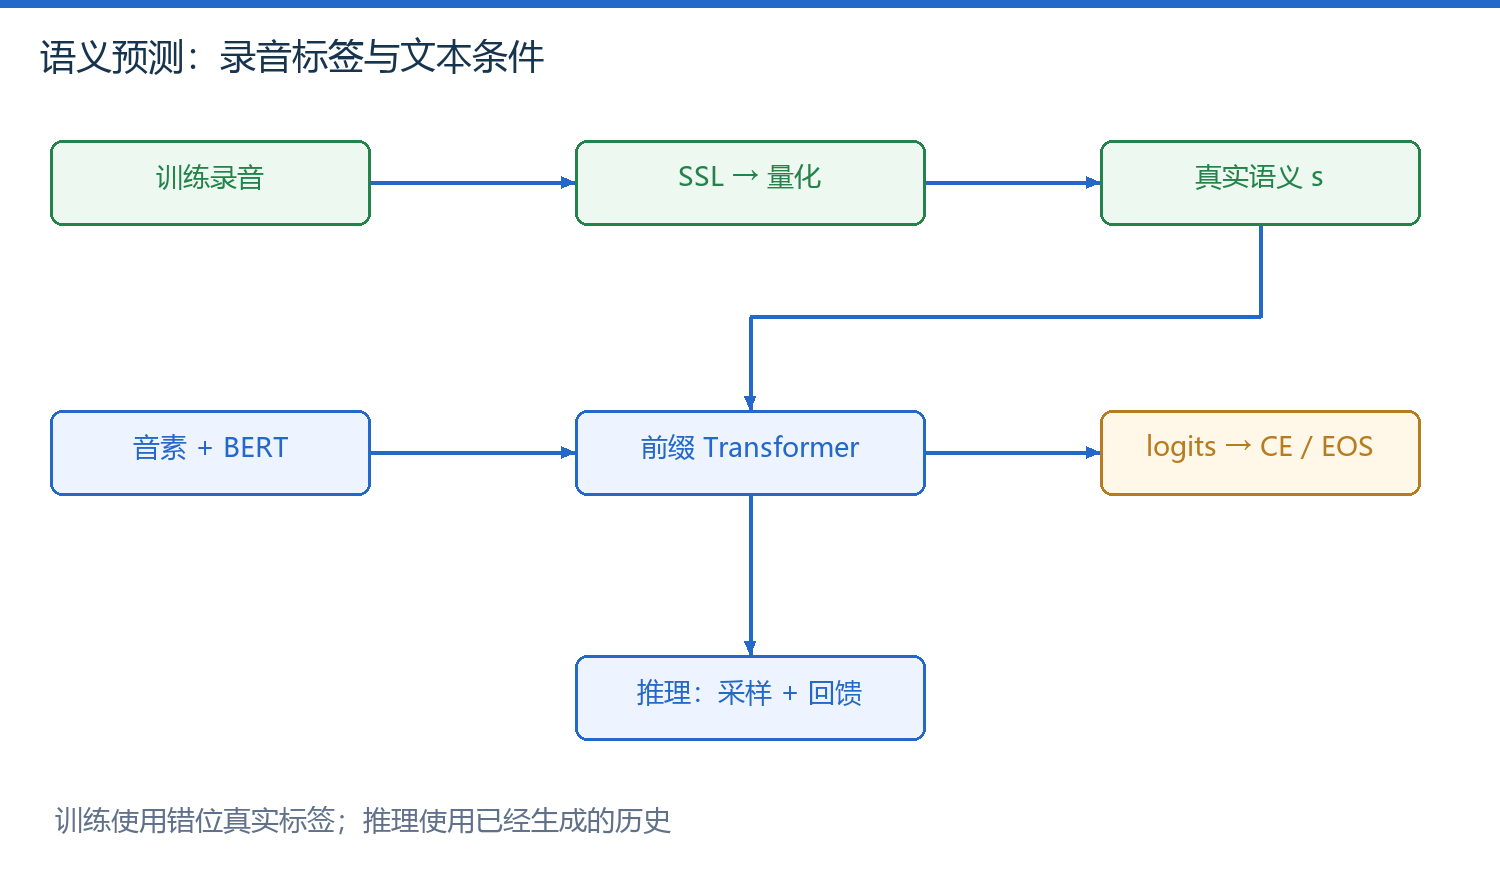
图 1|录音提供语义标签,文本提供条件,训练与推理在反馈处不同
1. 语义 token 的获得
| 阶段 | 常见形状 | 操作 |
|---|---|---|
| SSL 特征 | [B,768,Tssl] | 由自监督语音编码器提取 |
ssl_proj | 时间降采样或保持 | 25 Hz 配置使用 kernel=2、stride=2 |
| 量化器 | 一个有效码本,1024 个原型 | 为每帧选编号 |
| 标签输出 | [B,1,Tsem] 等封装 | 后续训练通常转为整数序列 |
这些数字对应当前 SynthesizerTrn 等源码的语义接口,不是任意 HuBERT 模型都共享的常数。模型实现
它虽然复用 ResidualVectorQuantizer 类,但这里配置 n_q=1;不能因为类名带 Residual,就写成 EnCodec 那样每帧生成八层编号。1024 个原型只需要 10 bit 表示一个编号,但项目内部张量通常用 int64 存储,张量内存大小不等于压缩文件码率。
2. 文本前缀与音频后缀的遮罩
文本位置可以相互读取,不能看到后面的音频目标;音频位置可以看到文本和已经出现的音频,不能看到未来语义 token。它是一种前缀语言模型结构,并非整段序列一律下三角。
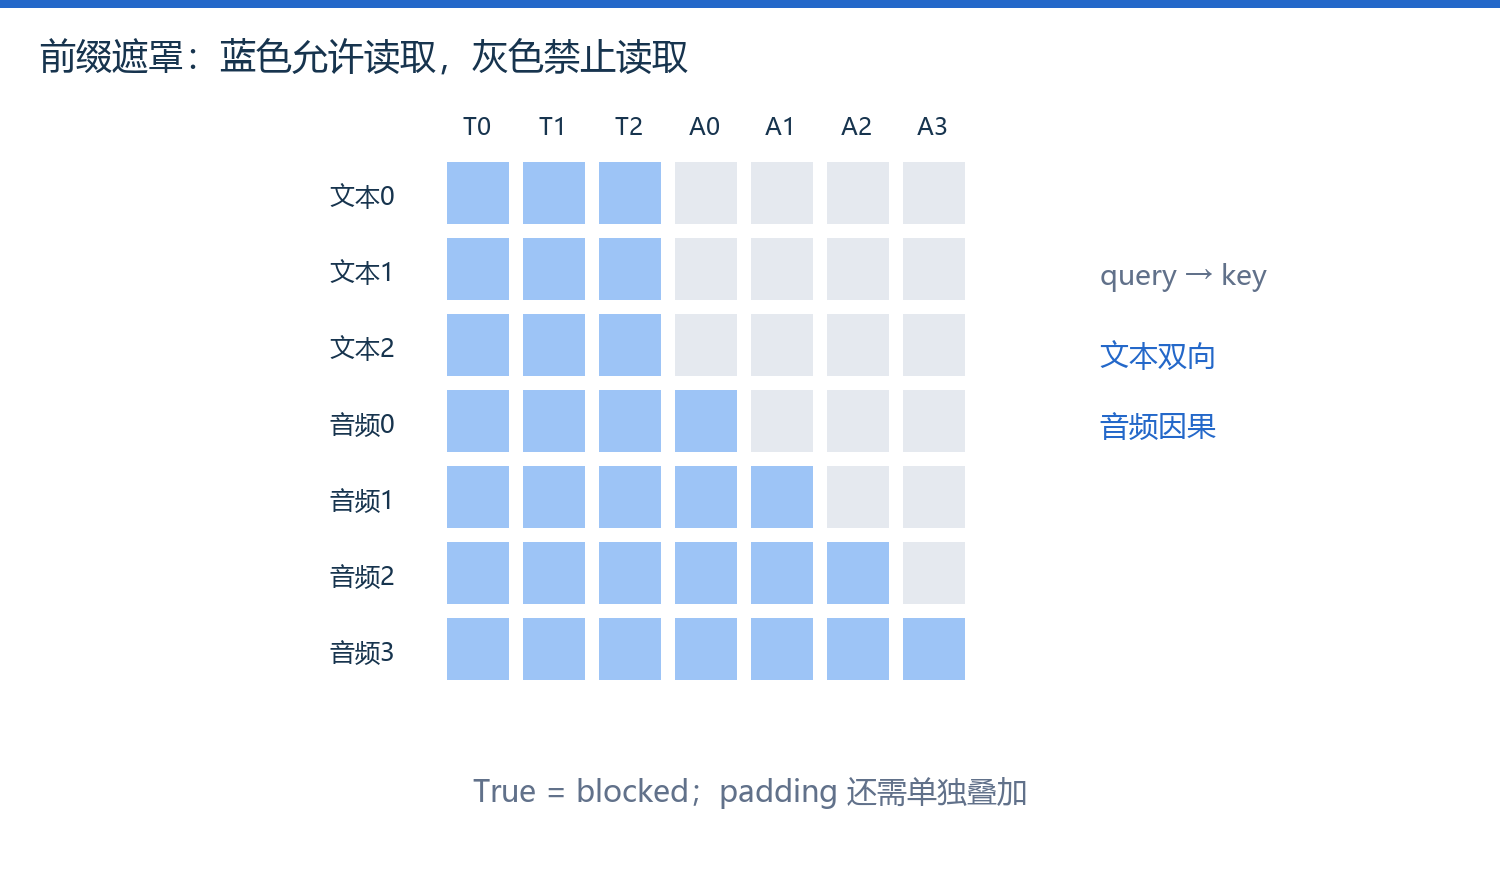
图 2|3 个文本位置与 4 个音频位置的允许读取关系
| 查询位置 | 文本键 | 历史/当前音频键 | 未来音频键 |
|---|---|---|---|
| 文本 | 允许 | 屏蔽 | 屏蔽 |
| 音频 | 允许 | 允许 | 屏蔽 |
make_input_data 同时叠加 padding mask。中文 BERT 特征先投影到模型维度,再与音素嵌入相加;文字到音素展开关系必须与特征长度一致。GPT 源码
3. 自回归目标与终止
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 交叉熵部分;不是声称当前实现所有训练路径只有此项。 | |
| 目标 token 位置数,按训练约定包括终止标签。 | |
| 目标位置索引。 | |
| 当前位置真实语义编号或 EOS。 | |
| 当前位置之前的真实标签;推理时换成已采样结果。 | |
| 目标与参考文字组织出的文本条件。 | |
| 参考语义提示等条件。 | |
| 参数 θ 的网络给正确编号分配的概率。 | |
| 自然对数;累积损失使用 nats。 |
若连续三个正确标签的概率为 [0.8,0.5,0.25],损失分别约为 [0.2231,0.6931,1.3863],总和约 2.3026。最后一项也可能是 EOS;忽略终止监督会导致拖长或不能停止。固定提交的 forward 还含构造拒绝序列的 reference-free DPO 项,forward_old 则是另一条旧路径;分析训练损失要核对实际调用入口。
4. 遮罩实现与验证
函数输入两个长度,输出 [N+T,N+T] bool;True 表示禁止读取,没有可学习参数。先建立文本—音频分区,再遮住音频上三角:
def prefix_mask(text_length, audio_length):
    """True means BLOCKED. Text bidirectional; audio causal over all text."""
    n, t = text_length, audio_length
    mask = torch.zeros(n+t,n+t,dtype=torch.bool)
    mask[:n,n:] = True
    mask[n:,n:] = torch.ones(t,t,dtype=torch.bool).triu(1)
    return mask
实际实验确认禁止位置的 softmax 权重和为 0;把最后音频位置的 value 加 100,之前六个查询位置输出保持完全相同。这验证了遮罩方向,不能替代整个多层模型的泄漏检查。
训练可并行计算各位置损失,推理仍沿目标 token 时间轴逐步生成。
只把输入右移却忘记屏蔽未来,模型仍会偷看答案,训练准确率会虚高。
正在连接 GitHub 评论…