02|GPT-SoVITS 声学解码:VITS 分支与流匹配分支
语义编号不能直接播放。声学网络首先结合目标音素与参考声音形成条件,再生成可恢复波形的连续表示。v2Pro 与 v3/v4 在此处分岔;这一结构差异比版本号更值得优先理解。
v2Pro 走潜变量与波形生成路径;v3/v4 走条件特征、CFM、mel 与声码器路径。
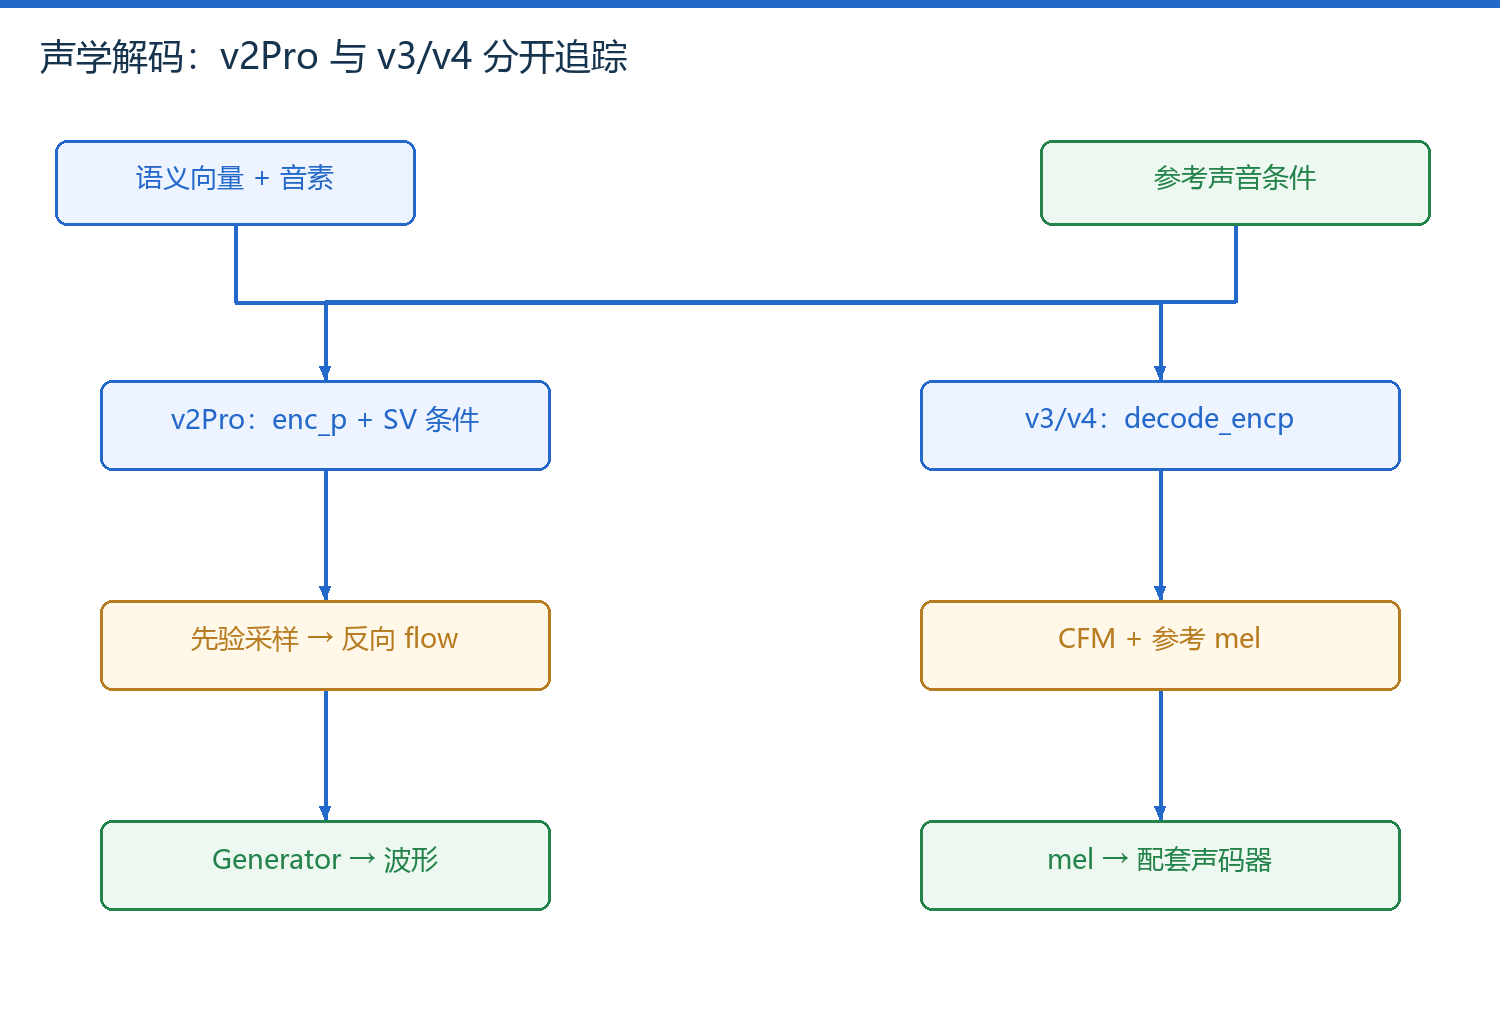
图 1|两条声学解码路径及各自的参考条件入口
1. v2 / v2Pro 的路径
decode 从语义码本取回向量,按配置上采样,交给 enc_p 与目标音素融合;参考频谱通过 ref_enc 得到条件。v2Pro 额外把 ERes2NetV2 说话人验证特征投影后加入参考条件。先验采样后通过反向 flow 与生成器得到波形。固定版本模型文件
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 从条件先验抽取的潜变量,后续送入反向 flow。 | |
| 网络输出的逐位置均值张量。 | |
网络输出的对数标准差,源码对应 logs_p。 | |
| 与均值同形状的标准正态噪声。 | |
noise_scale,控制该次采样的随机幅度。 | |
| 对应元素相乘。 | |
| 自然指数,把对数标准差转换为正标准差。 |
若某元素均值 0.2、对数标准差为 0、噪声为 −1、缩放 0.5,则潜变量为 。这不是直接给波形加 −0.5 的噪声,而是在潜空间改变采样,再经过后续非线性解码。
2. v3 / v4 的路径
| 调用 | 输入与输出 | 作用 |
|---|---|---|
decode_encp | 语义编号、音素、参考 → 条件特征 | 建立与 mel 时间轴匹配的条件 |
cfm.inference | 噪声、参考 mel、条件、步数 → mel | DiT 速度预测与 Euler 更新 |
| vocoder | mel → 波形 | v3 使用对应 BigVGAN;v4 使用配套声码器 |
源码在参考前缀保留独立条件通道,把待积分状态的参考前缀置零,并在每次更新后再次置零;目标片段参与生成。长输出按块生成,新块会接收上一块末端的特征与 mel 条件。它不等于每段独立启动后直接拼接。
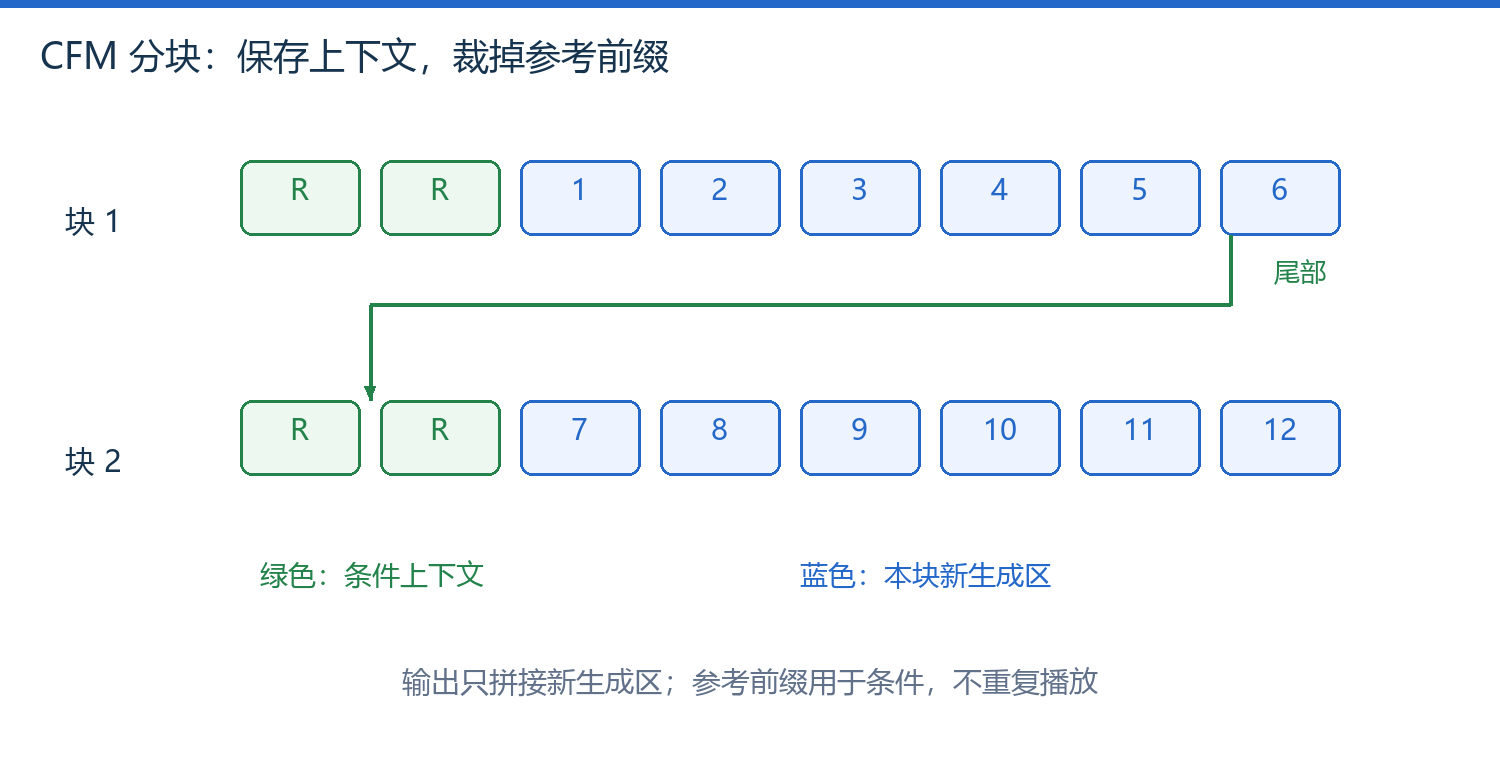
图 2|CFM 分块延续:上一块尾部成为下一块的参考上下文
重要实现细节:通用 CFM.inference 支持 CFG,但核对的 WebUI 调用传入 inference_cfg_rate=0。因此不能仅因函数存在有/无条件分支,就宣称默认 WebUI 每一步都运行两遍网络。训练函数还混合了带步长的 shortcut 式目标,不能把当前全部训练损失说成最基础线性 CFM。
3. 采样率与特征采样率不能混写
| 分支 | 已核对的关键配置 | 含义 |
|---|---|---|
| v2Pro | 输出/训练音频 32 kHz,hop 640 | 50 Hz 声学潜变量时间轴 |
| v3 | 配套 24 kHz、100 band BigVGAN | 原生输出 24 kHz |
| v4 | 参考 mel 路径使用 32 kHz 预处理;配套声码器输出 48 kHz | 输入特征预处理率不等于最终波形采样率 |
把预处理率、特征帧率与输出率分别记录,能够解释 v4 为什么不能照搬 v3 的声码器。
不能混用不同分支的 s2 权重、mel 配置和 vocoder;张量形状偶然能对上也不代表语义匹配。
4. 对照实验
固定同一参考录音与文本,分别记录前端、GPT、声学解码和输出处理耗时;再对一个参数做单因素改变。CFM 步数只属于相应分支,v2Pro 的 noise_scale 则影响潜变量采样。记录参数的“归属模块”,比堆一组所谓通用最佳值更容易复现。继续 版本与配置。
正在连接 GitHub 评论…