02|12Hz 音频编码:语义监督、残差码本与因果解码
Qwen3-TTS 的 12Hz 名称容易让人以为每秒只预测 12 个整数。报告中的实际时间帧率为 12.5 Hz,每帧有 16 层码本:首层侧重语义监督,其余 15 层逐步补充声学残差。时间步变少了,但每帧仍携带多个离散编号。
本篇讨论 12Hz 路线;25Hz 单码本、分块流匹配解码是另一套结构。技术报告 §2.2
帧率、每帧码本数、码本词表大小是三个不同维度,不能用一个 token/s 数字全部概括。
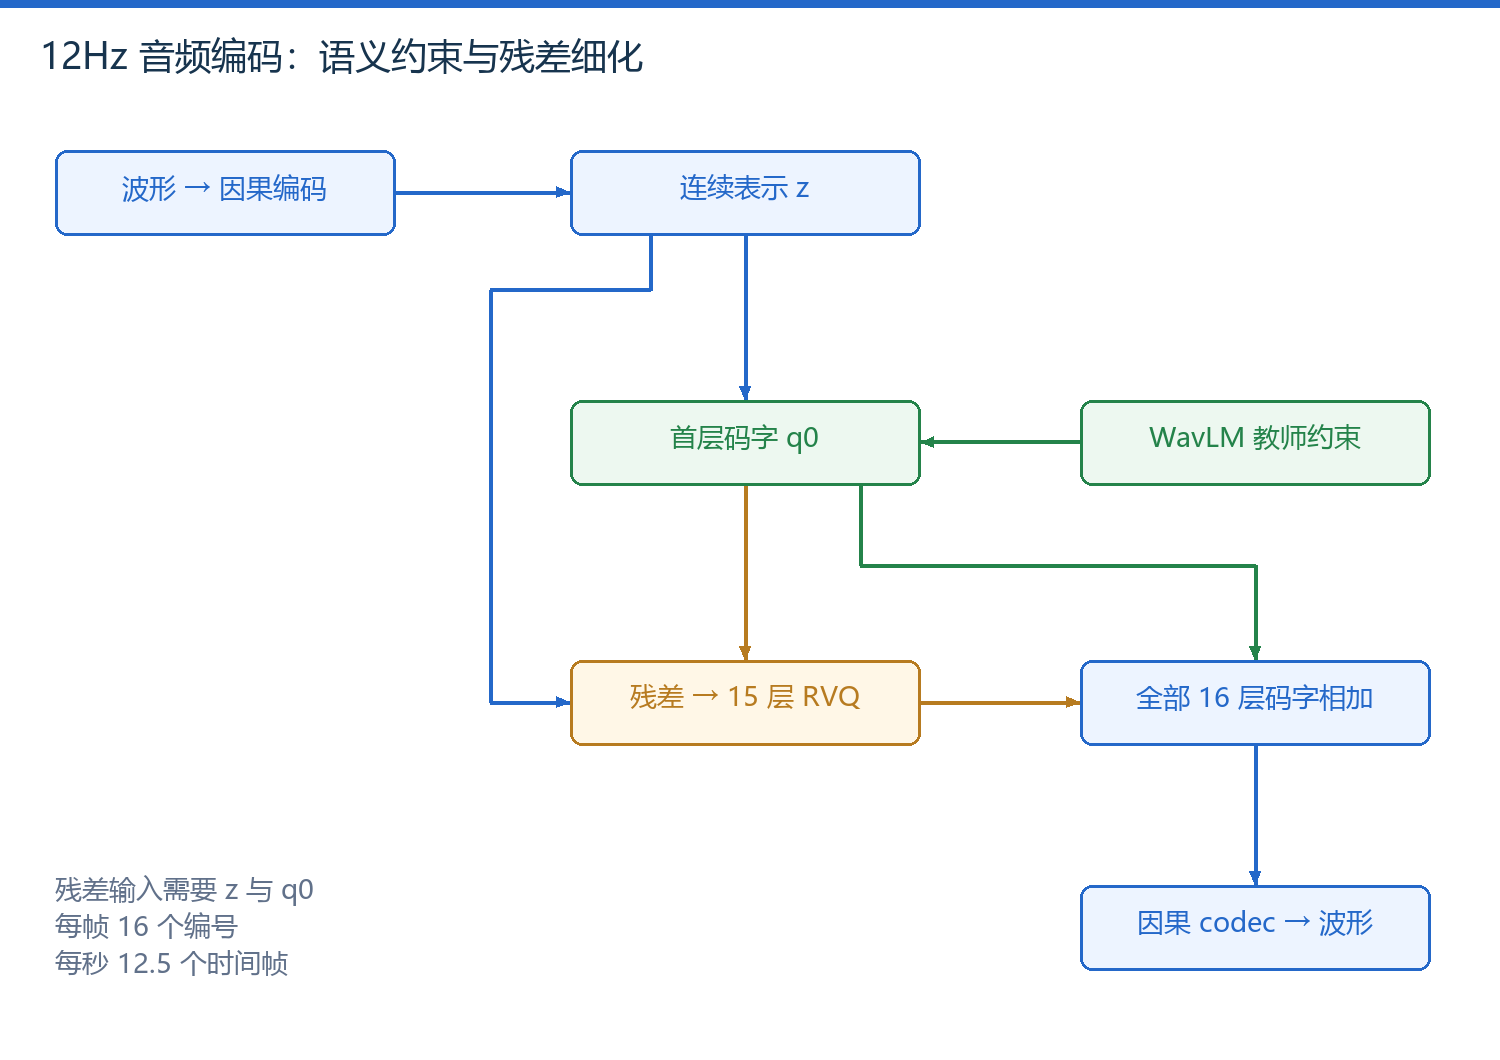
图 1|首层语义监督与后续残差量化共同构成一帧编码
1. 音频时长、编码帧数与码本形状
| 表示 | 数量/形状 | 时间意义 |
|---|---|---|
| 原始波形 | [B,1,L] | 每秒有采样率个点 |
| 编码器连续表示 | [B,T,D] | 每个位置约覆盖 80 ms 的推进 |
| 多码本编号 | [B,T,16] | 每帧 16 个整数 |
| 重建向量 | [B,T,D] | 各层码字向量汇总 |
B 是批大小,T 是编码帧数,D 是隐藏维度。2 秒约有 25 帧、400 个编号。后面的生成主干可以按帧推进;如果把 400 个编号简单展平送入同一个大主干,就失去分层调度的一部分效率优势。
2. 首层语义监督与信息保留边界
报告用 WavLM 教师引导首层表示,并通过波形重建、对抗与多尺度 mel 目标联合训练编码系统。语义监督鼓励某些内容信息集中在首层,但不保证首层完全没有音色或韵律,也不保证后续残差与文字内容完全独立。
| 训练约束 | 主要作用 | 不能自动推出 |
|---|---|---|
| 语义教师 | 引导首层保留高层语音信息 | 首层 token 等价于音素 |
| 重建/谱损失 | 保留可恢复的声学结构 | 生成 LM 已会预测这些编码 |
| 对抗反馈 | 改善波形统计细节 | 听感在所有域都相同 |
| 因果结构 | 控制未来依赖 | 服务端必然无首包等待 |
3. 残差量化与多码本重建
为理解递进补充,使用一般 RVQ 的教学表达:
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 待量化连续向量与初始残差。 | |
| 码本层索引及总层数;完整路线 K=16。 | |
| 第 k 层编号及其查表码字。 | |
| 当前层补偿向量和剩余误差。 | |
| 由各层码字相加得到的重建向量。 |
取一维 z=2.6,首层选 2,残差为 0.6;次层选 0.5,残差为 0.1;第三层选 0.125,重建为 2.625,误差 −0.025。层数增加提供修正机会,但实际码本训练与生成误差共同决定质量,不保证每次新增层都改善任意评价指标。
4. 码率估算与计算开销
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 未计封装与熵编码的理论固定长度码率,bit/s。 | |
| 时间帧率,此路线 12.5 帧/s。 | |
| 第 k 层词表大小;按实际配置读取。 | |
| 该层编号所需的信息位数;非二次幂词表固定整数编码还涉及向上取整。 |
若为教学假设所有 16 层都有 1,024 项,则每个编号 10 bit,每秒 12.5×16×10=2,000 bit。这个 2 kbps 是假设配置的演算,不是对所有 Qwen 权重的宣称。生成计算量还取决于大主干每帧调用次数、局部网络规模与声码器,不由码率单独决定。
5. 因果解码的边界
因果 codec 只依赖当前及过去编码,理论上完整的一帧码本到齐后即可产生对应音频。报告同时为减少过小包调度开销采用四帧一包,覆盖约 320 ms 音频。包内音频时长与生成包的墙钟耗时不是同一量。
一个完整时间帧包含所有需要的码本编号;只拿到首层编号不能视为完整高保真解码条件。
因果性消除规定范围外的未来等待,不消除网络计算、初始状态和调度开销。
继续 双轨主干与 MTP,理解如何生成这一帧的 16 个编号。
正在连接 GitHub 评论…