06|实验复现、结构验证与故障排查
这一篇集中保存运行环境、300 步实测结果、测试边界与接入真实语音的排错清单。可以在读过前三篇后直接动手,也可以作为实现后的验收参考。
证据边界: 结构测试与四条人工信号过拟合,不能直接证明真实 TTS 的音质与泛化。
1. 实验配置与复现结果
1.1 数据与环境
配套脚本不下载语音数据,直接构造四条 513 点的谐波信号。采样率 8 kHz, 取 125 或 250 Hz,振幅系数取 0.55 或 0.75,并设置两个初相位。每条信号由基频与 0.2 倍的二次谐波相加,再按 1.2 缩放。输入、目标、条件均可在 main() 中逐行找到。
生成数据也应能复核。每条信号采用:
谐波实验数据:符号与取值
| 数学记号 | 含义、单位与示例 |
|---|---|
| 采样索引,范围为 。 | |
| 索引 处的归一化波形振幅。 | |
| 采样率,为 Hz。 | |
| 四条信号的基频分别为 Hz。 | |
| 四条信号的振幅系数分别为 。 | |
| 初相位,单位为弧度;分别为 。 | |
| 圆周率; 对应二次谐波角频率翻倍。 | |
| 正弦函数。 | |
| 二次谐波相对于基频分量的权重。 | |
| 两项振幅上界之和,用于归一化,使绝对振幅不超过 。 |
第一条信号在 的计算可分为三步:
| 项目 | 代入 | 结果 |
|---|---|---|
| 周期位置 | ||
| 两个谐波分量 | , | 二次谐波在此处贡献为零 |
| 归一化振幅 | 约 |
对应条件为 [125/250,0.55]=[0.5,0.55],广播到本条信号的所有位置。这是程序检查用的人工数据,不是自然语音。
实验固定这四条数据反复训练,目的是回答“这个网络与训练循环能否拟合一个很小的任务”。它没有验证集,不能回答说话人泛化、发音准确性或自然度问题。
| 配置项 | 本次实测设置 |
|---|---|
| 运行环境 | Windows、Python 3.12、PyTorch 2.14.0+cpu |
| 可复现设置 | CPU 线程 2,随机种子 7 |
| 优化设置 | Adam,学习率 0.002,300 次参数更新 |
| 模型规模 | 12 个块、24 通道、57496 个参数 |
| 上下文范围 | 感受野 127 点 |
硬件和库版本会影响浮点结果与用时,不要求跨环境逐位复现。
将源码附录中的完整脚本保存为 wavenet_minimal.py,在文件所在目录执行:
python -m venv .venv
.\.venv\Scripts\python.exe -m pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
.\.venv\Scripts\python.exe wavenet_minimal.py --steps 300 --out results
脚本只依赖 Python 标准库与 PyTorch,CPU 即可运行;绘图脚本另外需要 Pillow,但训练不依赖它。某些 PyTorch 环境可能提示未安装 NumPy,本实现没有调用 Tensor 与 NumPy 的转换。若你使用已有兼容 PyTorch 环境,可直接执行最后一行。
1.2 实测结果
| 项目 | 本次实测结果 |
|---|---|
| 初始交叉熵 | 5.565298 nats / sample |
| 300 次更新后的交叉熵 | 0.003926 nats / sample |
| 训练循环用时 | 13.40 秒,不含环境安装、结构验证与生成 |
| 训练后未来扰动最大误差 | 0 |
| 训练后缓存等价最大误差,float32 | 3.17×10⁻⁵ |
| 训练后缓存等价最大误差,float64 | 2.84×10⁻¹⁴ |
| 感受野外输入扰动误差 | 0 |
| 256 类编解码往返 | 全部通过 |
| 自由采样输出 shape | [1,128] |
float32 等价检查使用 atol=1e-4, rtol=1e-5;float64 的最大误差阈值为 1e-10。这里同时报告误差与阈值,不把“在容差内一致”说成逐位相等。
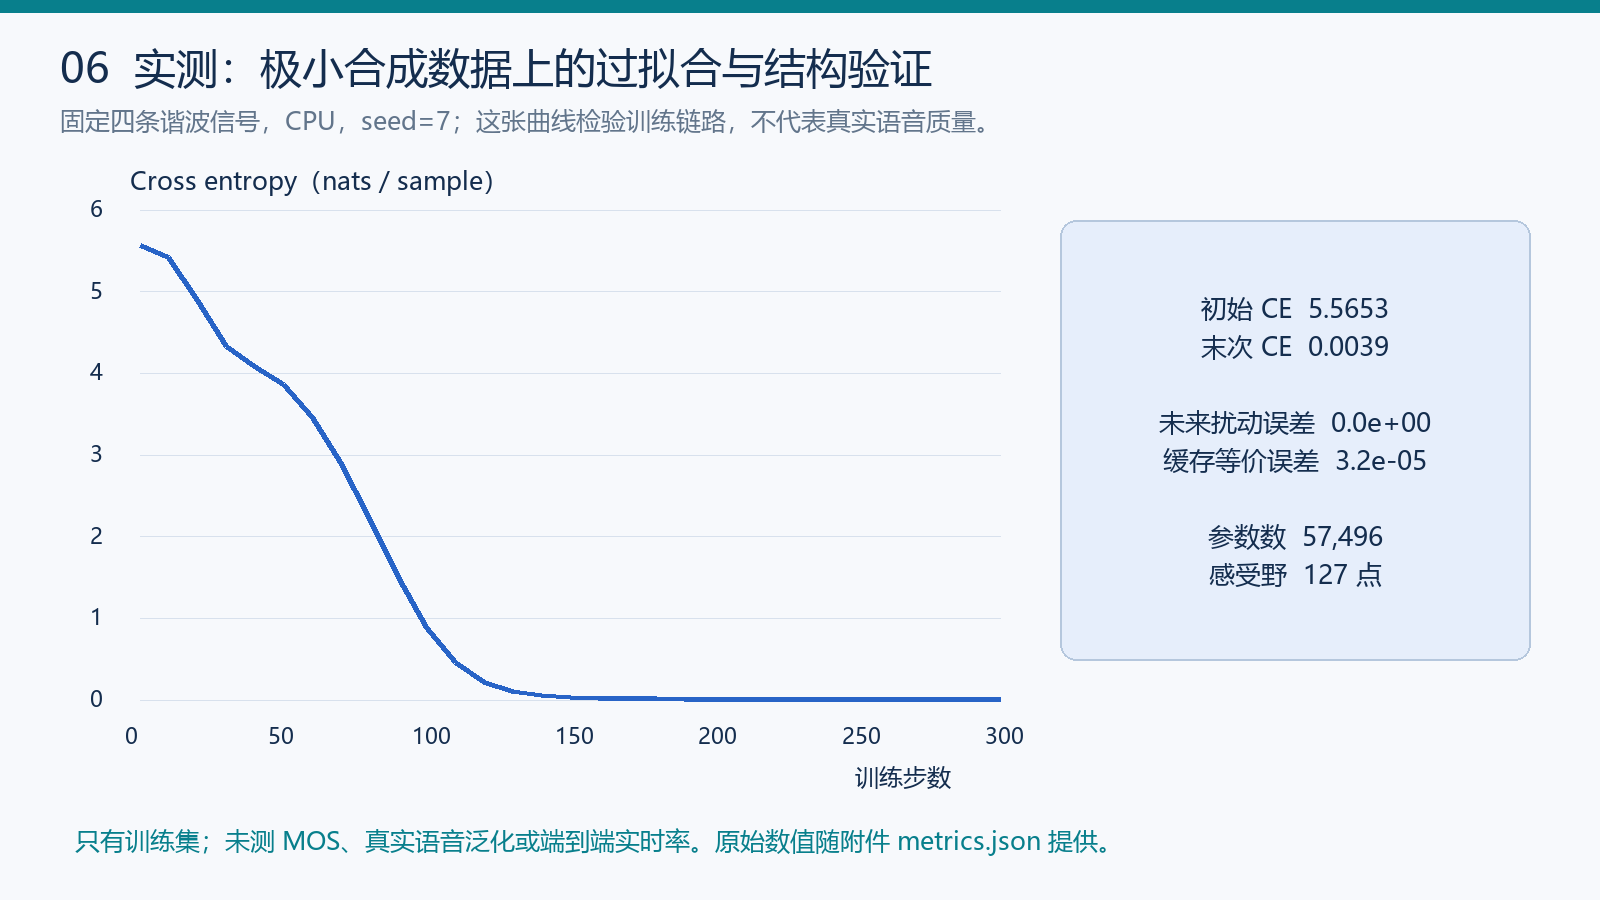
图 1|训练损失与结构检查(实测)
训练曲线来自运行产物 results/metrics.json。将每种证据与它支持的结论分开:
| 观察结果 | 可以说明 | 不能据此认定 |
|---|---|---|
| 固定四条信号的 loss 下降 | 小样本拟合链路正常 | 新语句泛化或说话自然 |
| 生成 128 点检查完成 | 状态更新与采样可执行 | 长时间生成稳定;8 kHz 下仅 秒 |
| 未执行听众评价 | 没有 MOS 数据 | 不能把 loss 换算为主观音质分数 |
本实验未报告 MOS、真实语音效果、泛化能力或端到端实时率。 MOS 是听众按量表给出的主观质量评分。
1.3 验证项目与结论边界
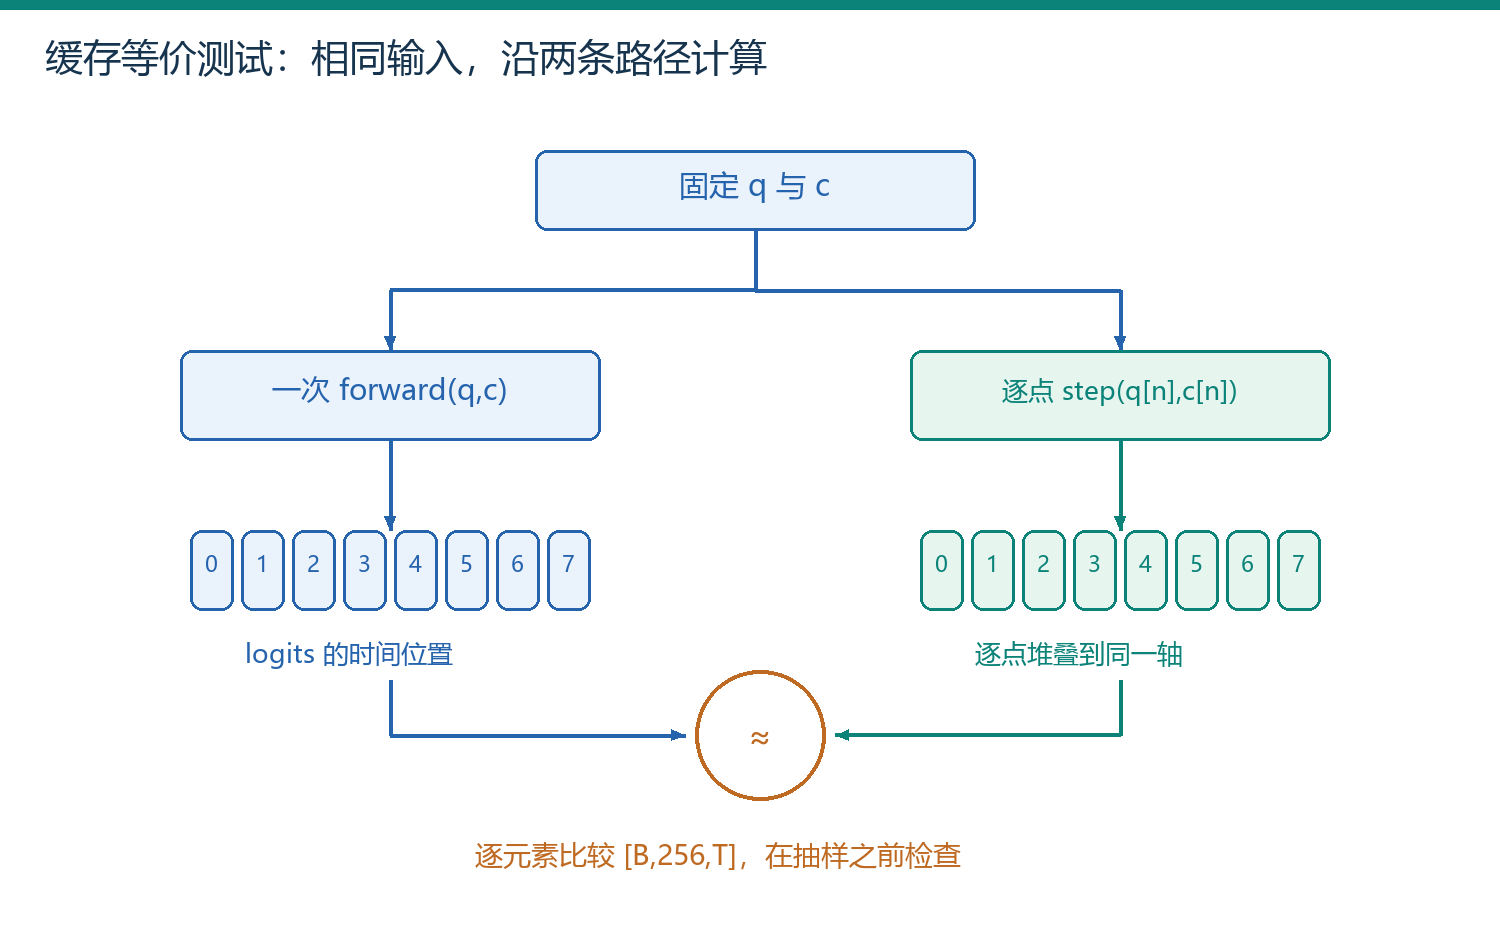
图 2|缓存数值等价的验证路径
图展示缓存等价检查的两条计算路径:同一输入经过整段与逐点计算,最后对齐时间轴。因果性和感受野检查则主动修改指定输入区域,具体区别见下表;不要把几项不同的测试混成一次“跑通”。
| 检查 | 做法 | 能发现的问题 | 仍不能证明什么 |
|---|---|---|---|
| 量化往返 | 遍历 256 个类别 | 编码/解码约定不一致 | 连续振幅无损 |
| 长度与类别轴 | 检查 [2,256,80] | padding、转置、输出通道错误 | 数据标签语义正确 |
| 未来扰动 | 修改索引 41 及之后的数据 | 意外读取未来 | 所有数据预处理都无泄露 |
| 有限感受野 | 改窗口外的最早输入 | 意外的长程依赖 | 窗口内每一点都被有效利用 |
| 缓存等价 | 逐点 logits 对比整段 logits | 队列顺序、索引、重置错误 | 高性能或好音质 |
| 小样本拟合 | 固定四条信号训练 300 步 | 梯度、损失和优化链路问题 | 新文本或真实语音泛化 |
2. 真实语音数据的接入与排错
真实语音接入应先验证数据与对齐,再扩大训练规模。 每一步都保留可以检查的产物:
| 阶段 | 具体检查 | 可检查的产物 | 容易遗漏的问题 |
|---|---|---|---|
| 波形预处理 | 统一采样率、声道与 PCM 到浮点的转换 | 峰值、静音比例、录音长度统计 | clamp 会削波,不能掩盖错误的幅值尺度 |
| 条件准备 | 明确音素边界、基频或 Mel 帧的来源与时间粒度 | 逐采样点的条件索引表、阶跃边界样例 | 训练可获得的条件,推理时可能还要预测 |
| 裁剪与计分 | 提供左上下文,只在有效目标区间计分 | 上下文、目标和 mask 的对应表 | 从长历史续写前需预热全部缓存 |
| 自由生成评估 | 分别观察短期噪声、长期漂移、爆音和停顿 | 按未见语句、说话人划分的试听与指标记录 | 教师强制下低 loss 不等于自由生成稳定 |
遇到异常时,可从下表定位一个最小复现动作:
| 现象 | 优先排查 | 一个具体动作 |
|---|---|---|
| loss 很快接近零,生成却完全不对 | 标签泄露或错位 | 手工打印四个点的 inp/target 对应关系 |
| 音调或速度整体改变 | 采样率、条件单位 | 核对写出 WAV 的采样率与训练 fs |
| 音素边界持续出现噪声 | 条件上采样与裁剪偏移 | 用阶跃条件标记边界并逐点对齐 |
| 流式与整段结果不一致 | 状态缓存及算子语义 | 对同一固定输入比较 logits |
| 新音频开头带有上一条特征 | 缓存未重置 | 每个 utterance 建独立 state |
| 全部变成极端振幅或直流偏置 | μ-law 编解码、类别约定 | 先过 256 类往返测试并打印解码范围 |
这些检查是接入真实数据的起点,不意味着增加模型层数可以替代前端与对齐工作。
3. 扩展实验设计
| 练习 | 控制变量与操作 | 需要观察什么 |
|---|---|---|
| 标签错位反例 | 打印四点输入/标签表,再故意取消错位 | 为什么更容易拟合反而可能说明答案泄露;仅作局部错误示范 |
| 条件边界检查 | 固定权重,只修改阶跃边界 | 目标 是否读取新帧,补足常数条件的测试盲区 |
| 环形缓存实现 | 先用固定输入比较 logits,再计时 | 先验证等价,再比较性能;报告硬件、batch、精度、预热和点数 |
训练循环的 13.40 秒不是合成速度,不能混用。
这些是后续学习练习,未混入上面的已执行测量。已有实测只对应附录原脚本与保存的 metrics.json。
正在连接 GitHub 评论…