01|声学表示与 CBHG 文本编码
返回 Tacotron 总览 · 下一篇:注意力对齐与多帧解码
字符是离散符号,录音是高速变化的振幅序列。Tacotron 在两者之间引入频谱帧:把一小段声音中的频率成分变成一组连续数值。本篇解释这个表示选择,以及文本怎样变成可供注意力读取的记忆。
1. 采样点、频谱帧与文本位置
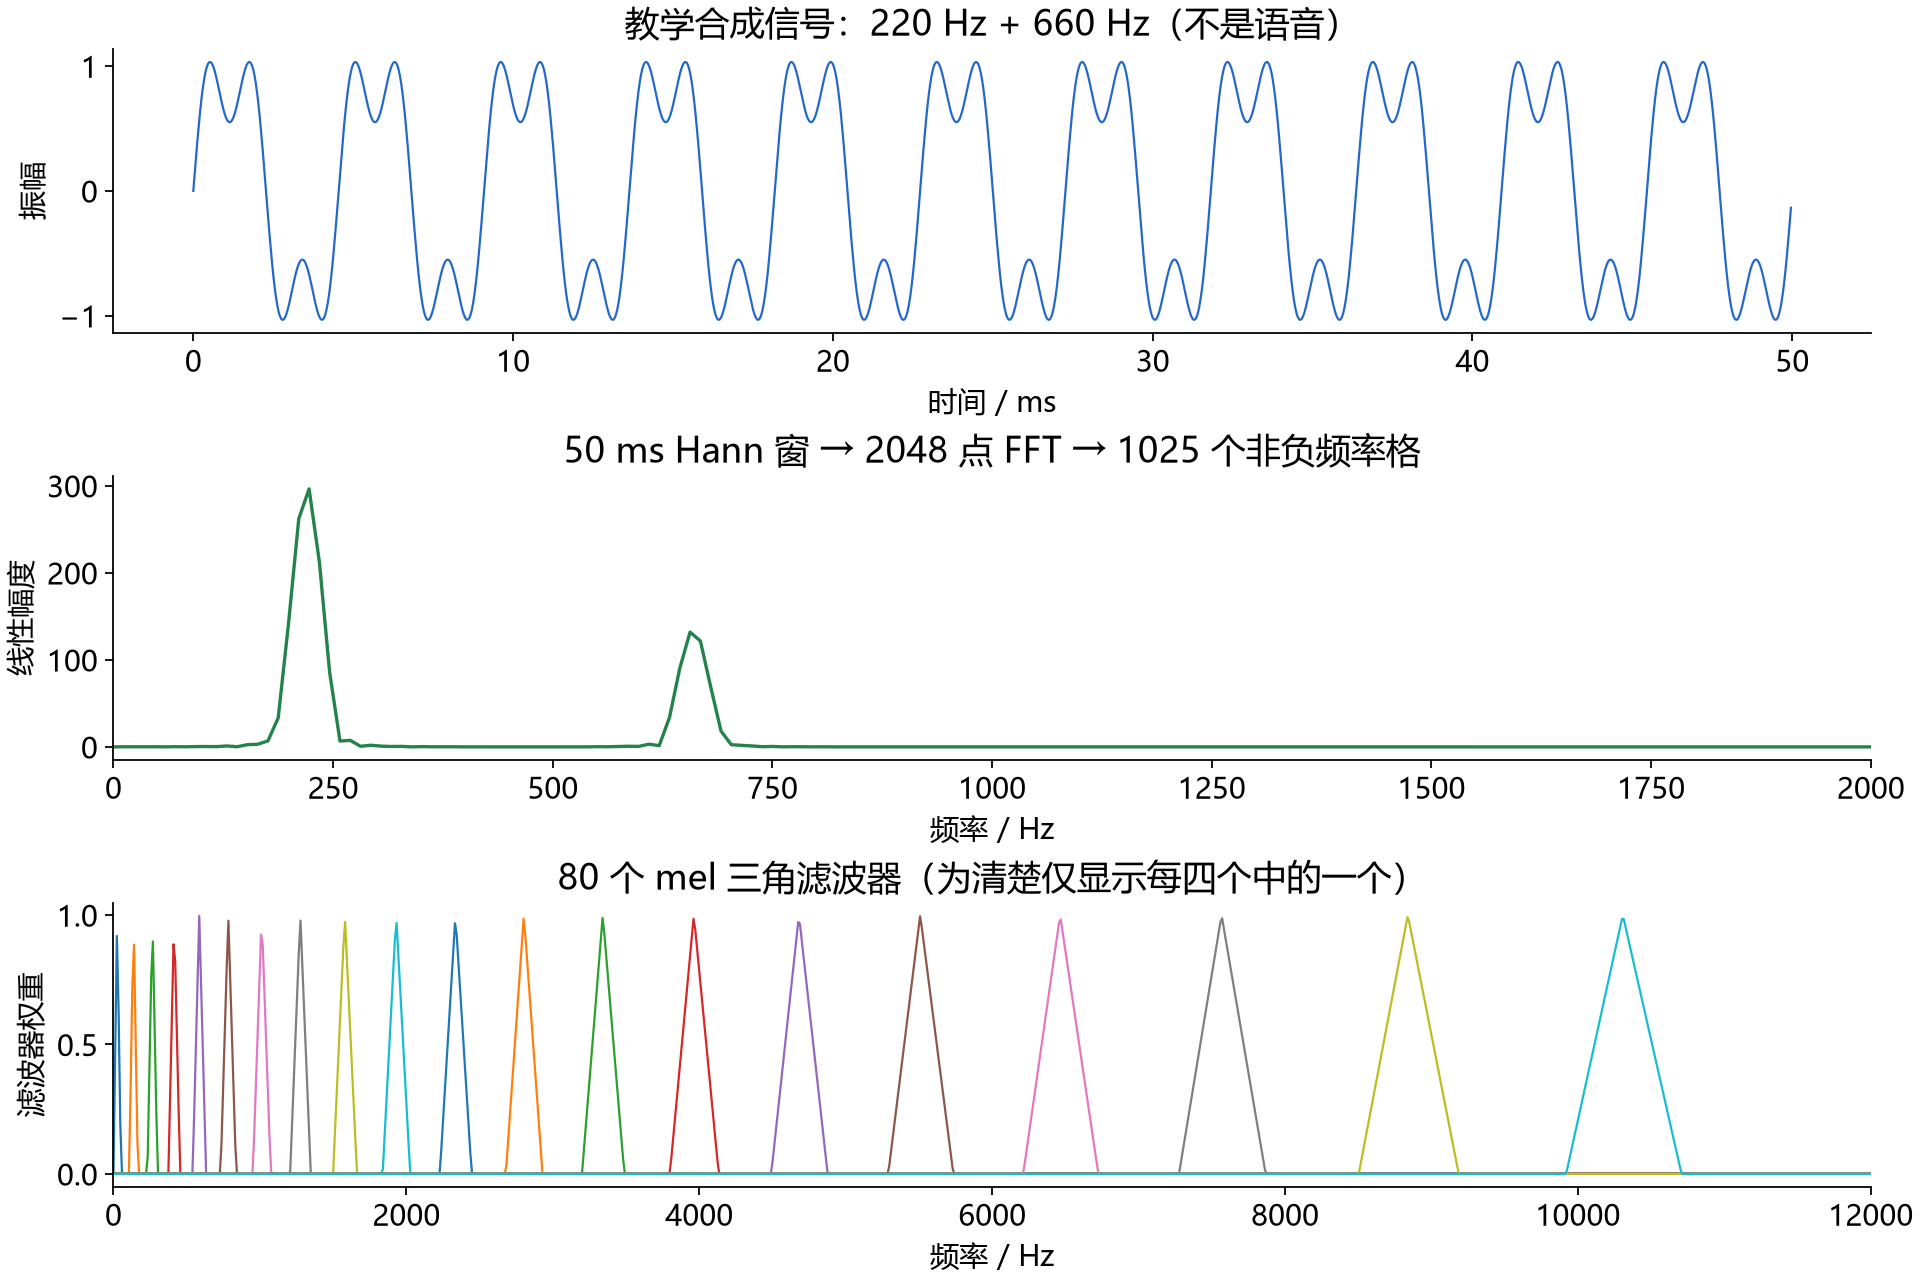
图 1|从时域振幅到频率表示:确定性合成信号示例
上图第一行是人为叠加的 220 Hz 与 660 Hz 信号;第二行的峰来自这两个频率;第三行显示 mel 滤波器在低频更密、高频更宽。它不是 Tacotron 生成的语音,也不是训练结果。
字符位置、声学帧索引、波形采样点索引是三套坐标,不能互换。
| 对象 | 例子 | 轴与单位 |
|---|---|---|
| 波形 | 单声道浮点数组 | 时间轴的每格是一个采样点;振幅通常归一化 |
| 一帧频谱 | 一个短窗口内各频率的幅度 | 横向可读作频率;不是一个音素或一个字 |
| mel 序列 | 连续很多帧的 80 通道特征 | 帧轴 × mel 通道轴;值是经处理的幅度表示 |
| 字符编码 | “hello” 的 5 个字符向量 | 文本位置轴;没有固定毫秒长度 |
原论文使用 24 kHz 采样率、50 ms 窗、12.5 ms 帧移和 2048 点 FFT。先忽略边界补齐,一个窗口包含 个采样点,相邻窗口移动 点。窗口重叠使变化能平滑地沿时间追踪。2048 点 FFT 中多出来的长度由补零提供,补零让频率采样更密,不会凭空增加真实频率分辨能力。原论文 §4
2. 短时傅里叶变换与 mel 压缩
原版在频谱分析前采用系数 0.97 的预加重:把当前采样点减去上一个采样点乘系数的结果,减弱缓慢变化成分的相对占比。这个固定滤波步骤不是神经网络预测。
预加重:符号与数值
| 符号 | 含义与约定 |
|---|---|
| 从 0 开始的波形采样点索引。 | |
| 原始归一化振幅;教学边界取 。 | |
| 预加重系数,原论文取 0.97。 | |
| 预加重后的振幅;波浪号区分处理前后。 |
输入为 时,输出为 。恢复时先保留首点 0.2,再用 递推还原下一点;合成端需要与分析端使用一致约定。
短时傅里叶变换(STFT)把滑动窗口内的信号分解到一组频率上。为保持表达简洁,下面的 表示送入 STFT 的波形,可是完成预加重后的结果;图 1 的纯正弦教学图则未做预加重,便于辨认两个峰。下面写出未居中补齐的教学约定;真实工程必须固定边界规则,再在训练和合成中保持一致。
STFT:逐项符号与单位
| 符号 | 含义、形状与约定 |
|---|---|
| 波形在整数采样点 的归一化振幅;进入公式前可做预加重。 | |
| 非负整数帧索引;本约定窗口从采样点 开始。 | |
| 频率格索引;实信号通常保留 。 | |
| 窗内采样点索引,遍历 。 | |
| 窗口长度,1200 个采样点。 | |
| 帧移,300 个采样点;与文本记忆符号无关。 | |
| FFT 长度,2048;不是帧数。 | |
| Hann 窗的无量纲权重,减轻截断边界引入的频谱泄漏。 | |
| 虚数单位,平方为 。 | |
| 圆周率;指数内整体是无量纲角度。 | |
| 复指数函数;不同 对应不同振荡频率。 | |
| 将窗口内所有采样点的复数贡献相加。 | |
| 复频谱;模长是幅度,复数角度是相位。FFT 归一化约定会影响数值尺度。 |
| 具体位置 | 计算 | 解释 |
|---|---|---|
| 第 2 帧起点 | 点 | 相对起点 25 ms |
| 第 2 帧读取范围 | 600 至 1799 点 | 共 1200 点、50 ms |
| 频率格 20 | Hz | 频率格不是 mel 通道 |
| 非负频率格数 | 包含直流与 Nyquist 频率 |
mel 特征将相邻频率格用三角滤波器加权汇总,再压缩幅度动态范围。以下是与“log magnitude”一致的一种教学定义;具体滤波器边界、底数和归一化并非原论文全部明确规定,复现时应固定实现,不能混用功率谱配置。
mel 特征:滤波、幅度与对数
| 符号 | 含义、形状与约定 |
|---|---|
| 第 帧、第 个 mel 通道的 log 幅度特征;不是 Hz。 | |
| 与上式相同的帧索引。 | |
| mel 滤波器索引,本文取 。 | |
| 线性频率格索引,。 | |
| FFT 长度 2048,故上限为 。 | |
| 固定 mel 滤波器的非负权重;矩阵形状为 。 | |
| 复频谱的幅度;此处不是幅度平方的功率谱。 | |
| 沿线性频率格求和,得到一个 mel 通道值。 | |
| 正数下限,用于避免对零取对数;例 。 | |
| 在幅度和下限中取较大值。 | |
| 教学例使用自然对数;归一化和对数底数必须在正逆变换中一致。 |
手算一个只有三个非零权重的滤波器:幅度为 ,权重为 ,先得到 ,再取 。最终是一个通道值,不是三个频率峰各自的位置。
1025 个幅度压成 80 个通道会丢失细节;mel 变换通常不能直接求逆恢复原始频谱。
因此原版 Tacotron 增加后处理网络,学习从 mel 序列预测线性频谱。更低维的 mel 目标也让注意力解码器不必一边学习对齐,一边预测全部细密频率格。
3. CBHG 的多尺度局部特征
CBHG 的缩写来自 Convolution Bank、Highway network、bidirectional GRU。它把不同长度的局部模式、跨层信息保留和整句上下文组合在一起。
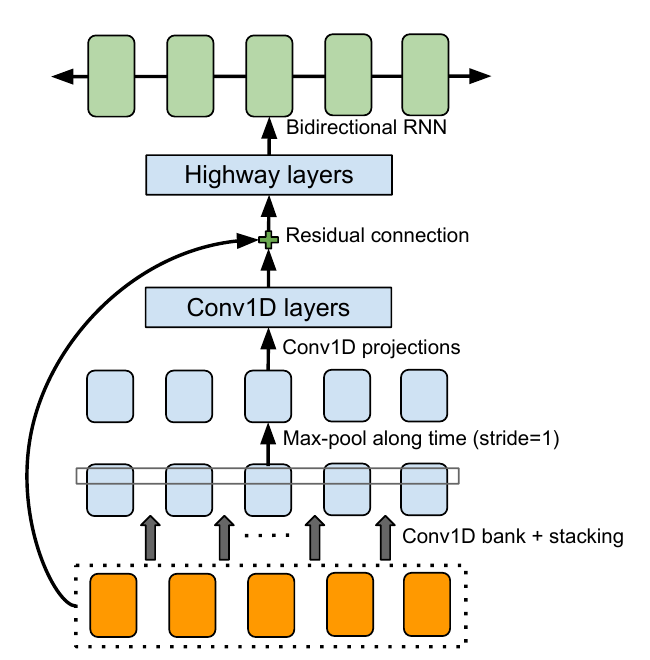
图 2|原论文 CBHG 模块
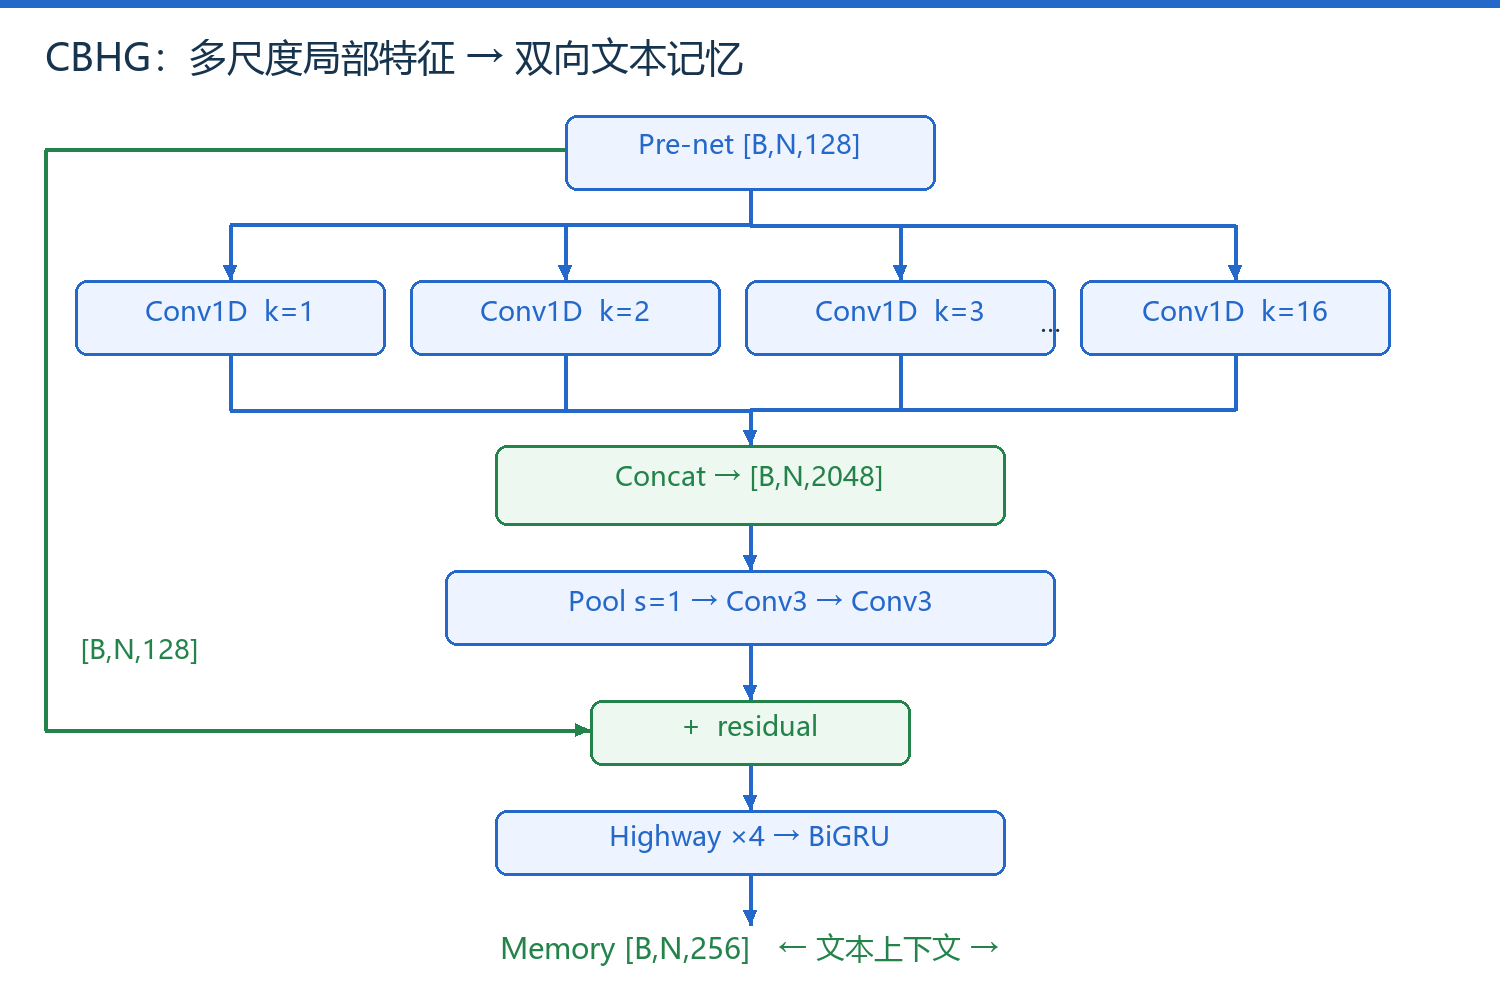
图 3|原版文本编码器的分支、汇合与张量形状
图 3 中 是批大小、 是文本位置数。卷积沿文本位置滑动,各分支读取同一个输入,而不是把宽度 1、2、3 的卷积依次串起来。卷积 bank 的宽度从 1 到 16,每个分支输出 128 通道,拼接后为 通道。
| 子层 | 输入 → 输出 | 设计目的 |
|---|---|---|
| 字符 embedding | → | 给离散字符可学习向量 |
| Pre-net | 256 → 256 → 128,ReLU 与 dropout | 非线性变换与信息瓶颈,降低直接记忆输入的倾向 |
| 卷积 bank | → | 并行提取多种局部跨度;卷积配合 batch normalization |
| 池化 | 宽 2、步长 1 | 聚合邻域,同时保留文本位置数 |
| 两个卷积投影 | 2048 → 128 → 128 | 融合多尺度信息;最后一个投影不使用 ReLU |
| 残差相加 | 128 + 128 → 128 | 让输入保留直接路径,通道必须一致 |
| 四层 highway | 128 → 128 | 学习每个特征保留还是变换 |
| 双向 GRU | 每方向 128 → 拼接 256 | 同时读取左、右文本上下文 |
以“ship”为例,宽度 1 分支偏向单字符局部信息,宽度 2 分支有机会联合观察“sh”,更宽分支观察更长上下文。这是可能学习的模式,不是保证某个卷积核必然对应一个音素。英文发音还依赖更长上下文,因此局部卷积之后仍保留双向序列模型。
编码器可以读取完整文本的未来位置;这不违反声学解码器的自回归约束。
“已知的未来字符”和“尚未生成的未来声学帧”是不同对象。前者推理开始前就有,后者还不存在。
4. Highway 的保留路径与变换路径
对一个文本位置的 128 维向量,highway 学习一个逐维门,在变换后的表示和原输入之间混合:
Highway:向量、矩阵和运算
| 符号 | 含义、形状与约定 |
|---|---|
| 一个位置的输入向量,形状 ;无物理单位。 | |
| 门控权重矩阵,形状 。 | |
| 门控偏置,形状 。 | |
| sigmoid 函数,将每维变为 0 到 1 的门值。 | |
| 逐维门向量;接近 1 偏向变换路径,接近 0 偏向保留路径。 | |
| 变换路径权重矩阵,形状 。 | |
| 变换路径偏置,形状 。 | |
| 逐维取输入与 0 的较大值。 | |
| 变换后的非负向量,形状 。 | |
| 全一向量减门值,得到保留路径的权重。 | |
| 逐元素乘法;不是矩阵乘法。 | |
| 混合后的输出,形状 。 |
| 单维教学例 | 变换路径贡献 | 保留路径贡献 | 输出 |
|---|---|---|---|
| 输入 2、变换结果 6、门 0.25 | 3 | ||
| 相同输入、门 0 | 0 | 2 | 2,完全保留 |
| 相同输入、门 1 | 6 | 0 | 6,完全变换 |
普通残差直接相加;highway 额外学习混合比例。CBHG 两种结构都有,不能因为看到一条跳连就把 highway 省略掉。下一篇使用编码器输出的整句记忆,计算注意力并展开声学解码。
正在连接 GitHub 评论…