02|监督语义编码:ASR 瓶颈、FSQ 与离散编号
CosyVoice 的语音 token 不是“先用通用音频 codec 压缩,再直接交给语言模型”的唯一实现。CosyVoice 2 将量化瓶颈放入有文字监督的语音编码器,让离散表示在训练中承担识别相关信息的传递任务。这会改变 token 学到的偏好,也解释了它与纯重建型 codec 的差异。
本篇集中解释 CosyVoice 2 的 FSQ 路径;CosyVoice 3 进一步扩展多任务监督,见本章后训练子文。CosyVoice 2 §2.2
token 的含义来自编码器、量化规则与训练目标的共同约束,编号本身没有跨模型通用语义。
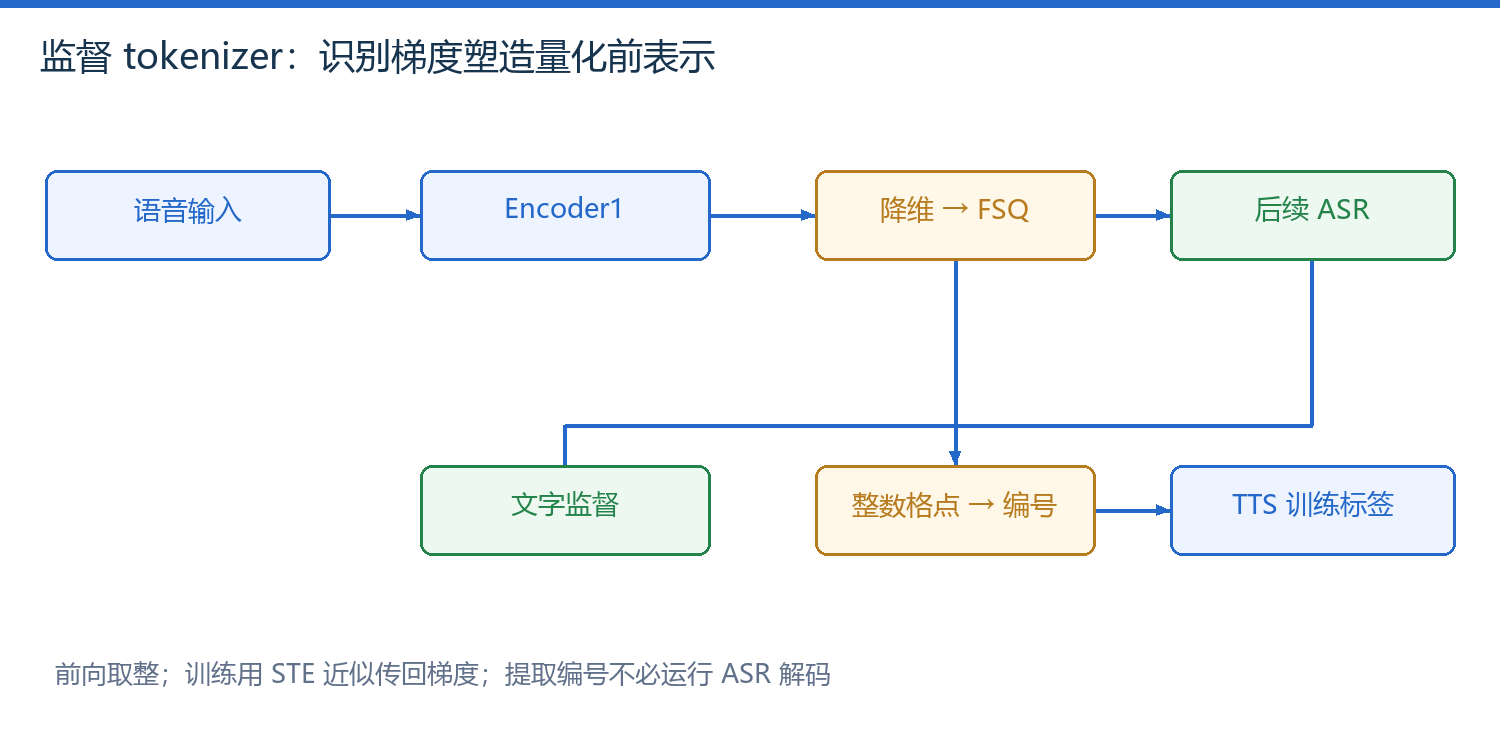
图 1|识别监督穿过量化瓶颈,推理仅取前半段作为 tokenizer
1. 识别训练链与编码提取链
| 阶段 | 数据流 | 需要文字标签吗 |
|---|---|---|
| tokenizer 训练 | 语音 → Encoder1 → FSQ → 后续编码/ASR 解码 | 需要,用于识别监督 |
| 提取语音 token | 语音 → Encoder1 → FSQ → 编号 | 不需要先识别出文字 |
| TTS 语言模型训练 | 文本与提示 → 预测语音编号 | 需要成对语音编号标签 |
| 声学重建训练 | 编号+参考条件 → mel/波形 | 需要声学目标 |
“有监督 tokenizer”描述训练来源,不表示提取 token 时先运行一次文本识别,再把识别文字当 token。CosyVoice 2 的 tokenizer 输出速率为 25 Hz,因此 2 秒语音约对应 50 个离散位置;边界处理仍可能影响精确数量。
2. FSQ 与最近邻向量量化的区别
向量量化从一组可学习码字中找最近向量;FSQ 将低维向量各分量限制到有限整数范围,再组合成一个编号。为了能手算,本文用每维三个等级 −1、0、1,两维一共 9 个组合。该教学范围不宣称是官方全部配置。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 低维连续向量第 j 个分量,本例两维。 | |
| 维度索引,0 或 1。 | |
| 先压到有限范围附近,再取最近整数;边界舍入遵循实际实现。 | |
| 量化值,−1、0 或 1。 | |
| 平移后的非负数字,0、1 或 2。 | |
| 三进制组合编号,范围 0…8;本例规定第 0 维是低位。 |
输入 h=(1.1,−0.2),tanh 约为 (0.8005,−0.1974),取整为 (1,0),平移为 (2,1),编号为 2+3×1=5。恢复时 id % 3=2、id // 3=1,再减 1 回到 (1,0)。实际系统的维数、等级数、位序与编号偏移必须按同一实现约定。
3. 取整操作与直通梯度估计
直接对 round 求导通常无法为上游提供有用梯度。straight-through estimator 在前向使用量化值,在反向借用连续分支的导数:
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 量化前输入及有界连续表示。 | |
| 对 b 取整的值。 | |
| 前向保留数值、反向阻断梯度。 | |
| 前向等于 q;反向把梯度传到 b 的教学近似。 |
前向 b+(q−b)=q;反向括号里的差值被当常量,所以梯度从 z 流到 b,再经过 tanh。它是梯度近似,不是证明离散 round 在数学上可导。
def fsq_teaching(h):
    # Two dimensions with levels -1,0,1; no learned nearest-neighbor table.
    bounded=h.tanh()
    integer=bounded.round()
    straight=bounded+(integer-bounded).detach()
    digits=(integer+1).long()
    index=digits[...,0]+3*digits[...,1]
    return straight,index
实际 CPU 输出为 (1,0)、编号 5;输入两维梯度约为 0.3592、0.9610,符合 tanh 的局部导数。这段代码只适用于两维三等级教学例,不能直接替换官方高维 tokenizer。
4. 量化利用率与内容保留
| 检查 | 观察什么 | 解释边界 |
|---|---|---|
| 编号直方图 | 是否只集中在少数格点 | 不均匀本身不等于失败,语音分布也不均匀 |
| 识别任务表现 | token 是否保留文字线索 | 不能代替音色与韵律质量 |
| 重建与克隆 | 后端能否恢复声学信息 | 必须固定参考与解码器 |
| 跨语言迁移 | 编码与生成是否适应新语言 | 不只检查 token 数量 |
FSQ 的编号计算可以精确还原量化格点;被量化丢掉的连续细节仍然不可逆。
码本利用率高不等于语音质量高,目标监督是否保留需要的信息更关键。
下一篇 文本—语音混合序列解释这些编号如何进入语言模型。
正在连接 GitHub 评论…