02|Fish Audio S2:双自回归、细粒度指令与多奖励训练
Fish Audio S2 把较大的时间主干与较小的帧内声学模型组合,并通过数据标注和后训练增强表达控制。本页的架构对应 S2 技术报告与 S2 Pro 开放权重;官方在线服务中的 S2.1 Pro 单独列在版本边界中。报告 · 官方仓库
Slow AR 决定时间上的粗语义;Fast AR 在当前帧内补充声学码本。
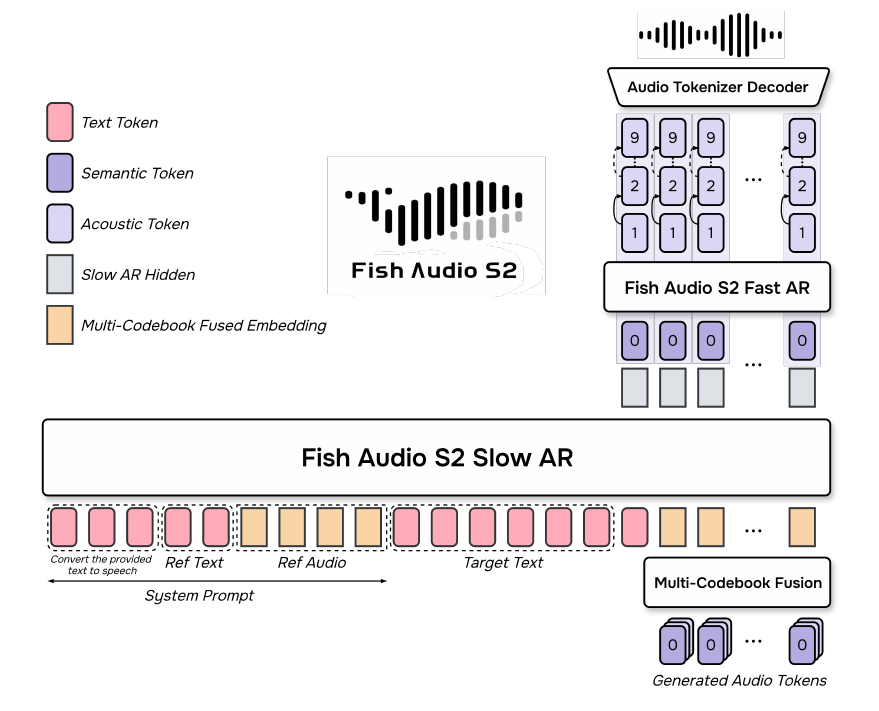
图 1|Fish Audio S2 的 Slow AR、Fast AR 与多码本反馈
1. 一帧的生成过程
| 顺序 | 模块 | 输入与输出 |
|---|---|---|
| 1 | Slow AR,报告使用 Qwen3-4B 主干 | 历史与文本 → 首层编号、全局隐藏状态 |
| 2 | Fast AR,四层 Transformer | 全局状态、首层编号 → 其余九层编号 |
| 3 | 多码本融合 | 当前帧所有编号的嵌入 → 下一时间步输入 |
| 4 | codec 解码器 | 完整编号组 → 波形片段 |
首层接受语义蒸馏,声学 tokenizer 以 44.1 kHz 音频和总下采样 2048 组织帧,因此帧率约为 21.53 Hz;“约 21 Hz”是近似描述,不是 21,000 Hz 波形采样率。
2. 帧内生成为什么节省大主干计算
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 每秒音频编码帧数。 | |
| 波形采样率,单位采样点/秒。 | |
| 编码器总下采样倍率,单位采样点/帧。 |
10 秒语音约有 215 帧,10 层共约 2,150 个编号。Dual-AR 把较重的时间建模维持在帧尺度,再由小网络逐层生成细节;真实时间还受首帧、编译、批量和波形解码影响,不能直接宣布快十倍。
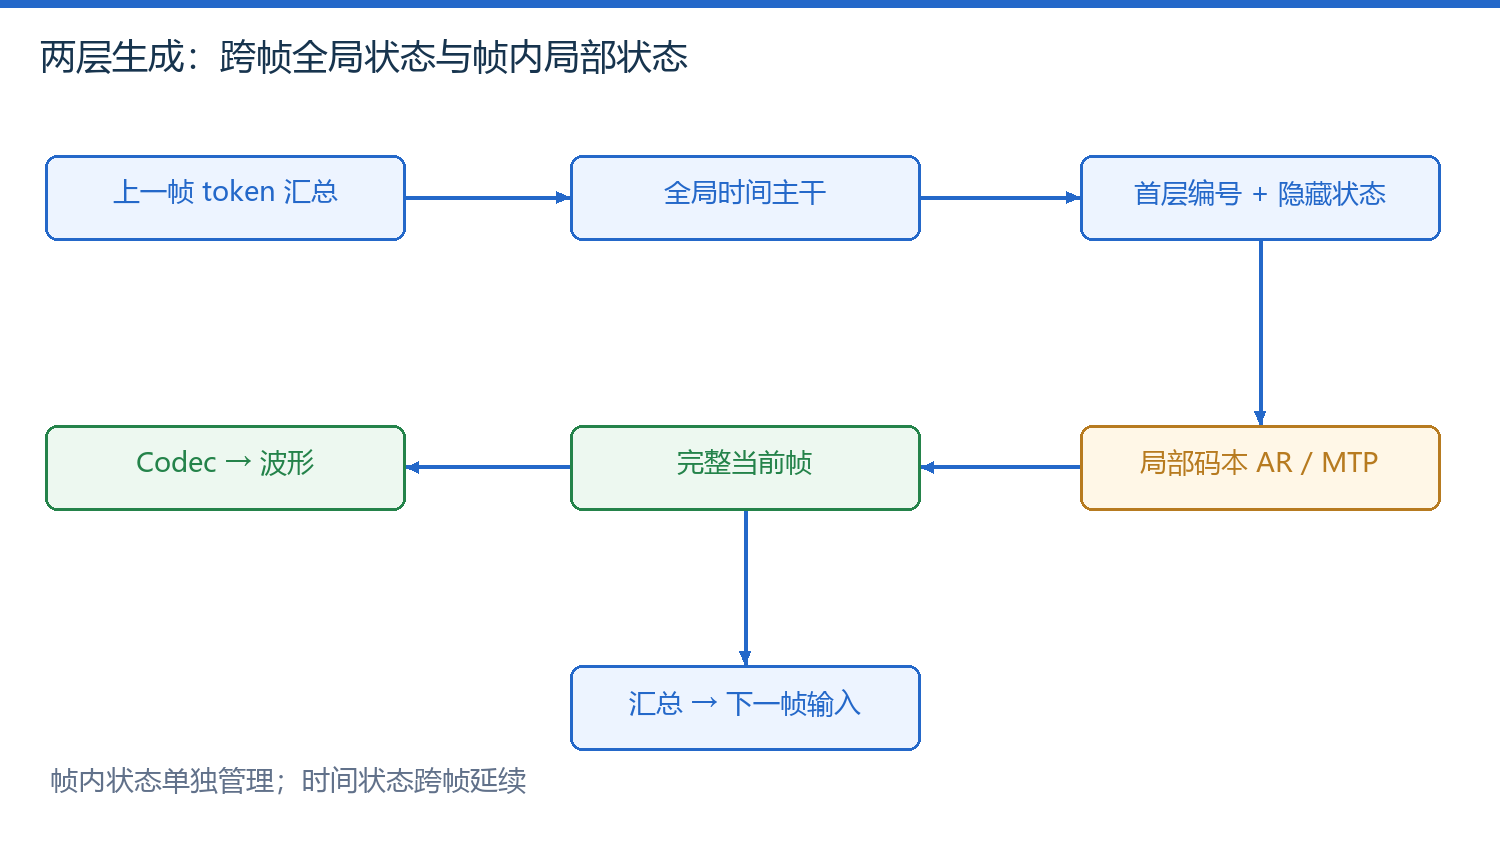
图 2|帧内状态与跨帧状态的不同生命周期
3. 指令能力来自数据与目标
训练数据不仅包含转写文字,还包括说话人轮次与声音属性描述。质量评估、富转写系统先用于筛选和标注数据,后训练又把相关能力转成奖励,促使生成既正确又符合要求。
| 奖励方向 | 想改善什么 | 单独追求的风险 |
|---|---|---|
| 内容准确 | 少漏字、少读错 | 机械但识别友好的声音 |
| 声学质量 | 清晰、少伪影 | 牺牲某些表达变化 |
| 说话人相似 | 身份稳定 | 过度依赖参考片段风格 |
论文使用 GRPO 变体组织多奖励优化。模型学到的标签可以出现在局部词语周围,提供比整句“高兴地说”更细的控制;但标签遵循率仍需独立验证,而不是听一段成功演示就认定稳定。
对同一文本只改变一个局部标签,才能判断控制是否作用在预期位置。
4. S2 与 S2.1 的边界
截至 2026-09-29,官方仓库提供 S2 Pro 的模型与代码链接;S2.1 Pro 官方服务文章描述另一在线服务型号。该页面曾列带截止日期的免费安排,本文不据此声称当前永久免费,也不推断其服务权重与开源 checkpoint 相同。
在线 API 的版本、开放权重的版本和推理引擎版本应分别固定。
模型卡与许可证决定具体使用范围,仓库可见不等于所有商业场景都使用同一授权。本文重点是架构与证据链;未调用付费服务或执行权重推理。返回 2026 年进展。
正在连接 GitHub 评论…