附录|TTS 机制实验:代码地图、运行入口与完整源码
本附录提供一份纯 CPU 可运行的教学脚本,验证多个技术之间共用的核心机制。它不加载预训练语音模型,不包含完整 TTS 训练,也不会输出可听语音。 每个实验只对已声明的张量性质给出证据。
先用小张量验证不变量,再把同一约定接入大模型。
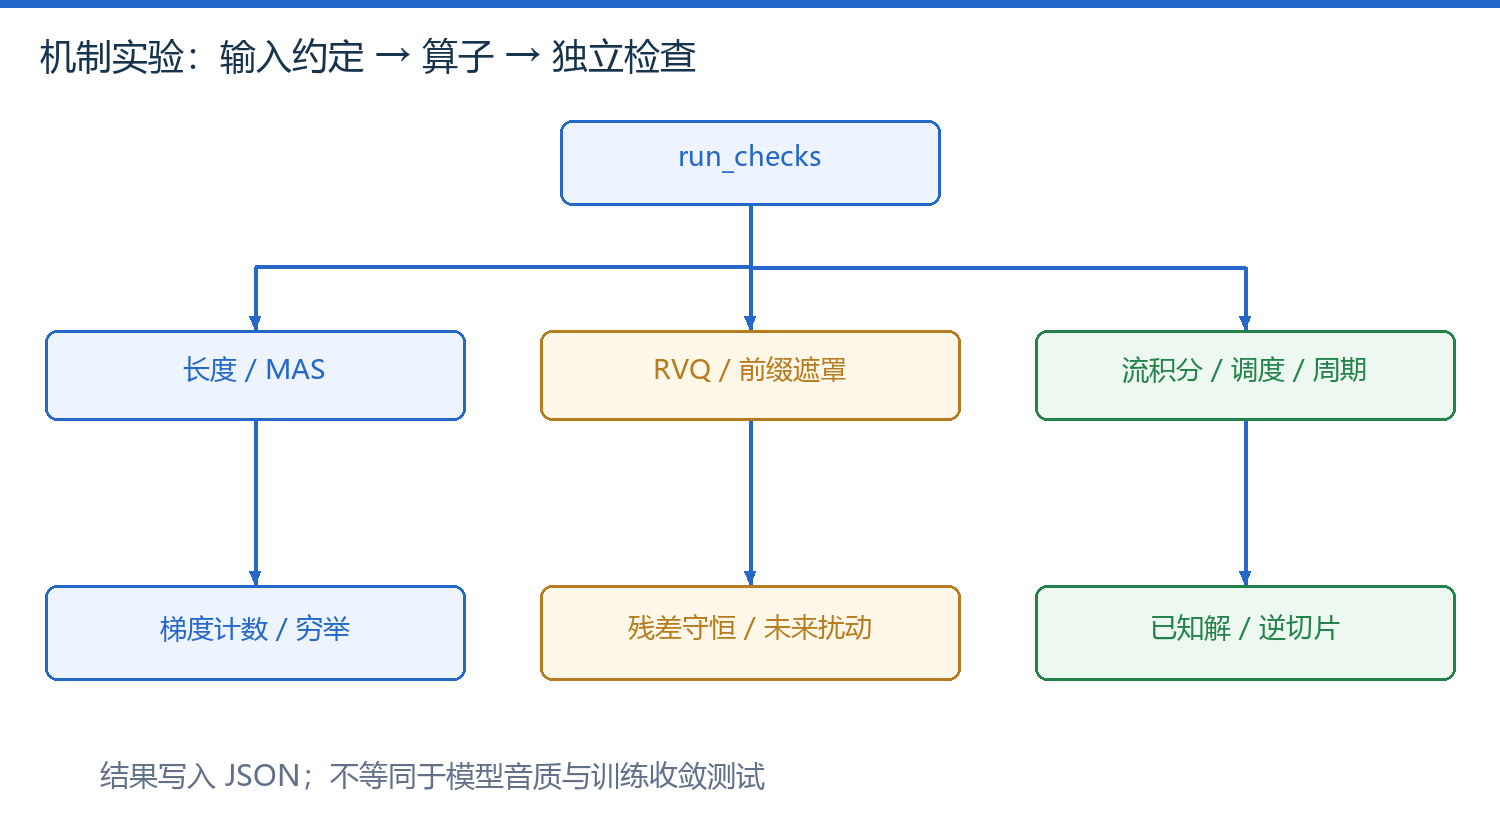
图 1|run_checks 到各机制函数的调用与验证关系
1. 模块与输入输出
| 函数 | 输入 → 输出 | 对应文章 |
|---|---|---|
length_regulate | 音素向量、整数时长 → 帧向量 | FastSpeech |
monotonic_path | 帧—音素得分 → 最佳路径 | Glow-TTS / VITS |
residual_quantize | 连续特征、码本 → 编号与残差 | EnCodec |
prefix_mask | 文本/音频长度 → bool mask | GPT-SoVITS |
flow_target / masked_mse | 噪声、真实值、mask → 监督损失 | F5-TTS / CFM |
euler | 初始状态与速度函数 → 终态 | 流匹配推理 |
period_view | 波形 → 按周期重排矩阵 | HiFi-GAN |
delay_pattern | 时间×码本编号 → 错位矩阵 | 多码本调度 |
2. 运行与预期产物
将下方代码保存为 mechanism_lab.py,环境安装 PyTorch 后运行:
python mechanism_lab.py
输出为终端 JSON 和同目录 results/mechanism-checks.json。本文记录的实际环境是 Python 3.12.14、PyTorch 2.14.0+cpu;固定随机种子 2026。脚本不联网、不下载权重。
| 验证 | 实际结果 |
|---|---|
| 时长展开 | [3,2] → [6,2];梯度计数 [2,1,3] |
| MAS 与穷举比较 | 路径 [0,0,1,2,2],最高得分 17 |
| RVQ 重建与残差 | 编号 [1,1];重建 [2.25,1];两者相加恢复输入 |
| 因果遮罩 | 禁止位置权重为 0,未来 value 扰动不影响早期输出 |
| 流积分 | 四步恒定速度回到 [4,0] |
| 掩码梯度 | 参考/padding 区为 0,生成区非零 |
| 周期视图 | 10 点按周期 3 补齐为 [1,1,4,3] |
| 延迟排列 | 逆切片完整恢复原编号矩阵 |
检查使用穷举、逆变换和扰动等独立证据,避免只验证函数没有报错。
周期示例采用零填充便于阅读,原版 HiFi-GAN 常用反射填充;最近邻量化示例也未实现训练用的直通梯度与码本更新。
3. 完整源码
展开或收起完整机制实验脚本
python147 行
"""CPU teaching lab: mechanisms, not pretrained TTS or an audio-quality benchmark."""
from pathlib import Path
import json
import torch
import torch.nn.functional as F

def length_regulate(hidden, durations):
    """One unpadded item: [N,H], integer [N] -> [sum(d),H]."""
    if durations.dtype != torch.long or (durations < 0).any():
        raise ValueError('durations must be non-negative int64')
    if len(hidden) != len(durations): raise ValueError('length mismatch')
    return torch.repeat_interleave(hidden, durations, dim=0)

def monotonic_path(score):
    """[frames,phones]; stay or advance by one; every phone gets >=1 frame."""
    frames, phones = score.shape
    if frames < phones: raise ValueError('not enough frames')
    dp = torch.full_like(score, -torch.inf)
    move = torch.zeros_like(score, dtype=torch.bool)
    dp[0,0] = score[0,0]
    for t in range(1, frames):
        for n in range(min(t+1, phones)):
            stay = dp[t-1,n]
            advance = dp[t-1,n-1] if n else score.new_tensor(-torch.inf)
            move[t,n] = advance > stay
            dp[t,n] = score[t,n] + torch.maximum(stay,advance)
    n = phones-1
    path = torch.zeros_like(score)
    for t in range(frames-1,-1,-1):
        path[t,n] = 1
        n -= int(move[t,n])
    return path, dp[-1,-1]

def residual_quantize(z, codebooks):
    """[T,D], [K,V,D] -> IDs [T,K], reconstructed [T,D], residual [T,D]."""
    residual = z.clone()
    reconstruction = torch.zeros_like(z)
    ids = []
    for book in codebooks:
        distance = (residual[:,None,:] - book[None,:,:]).square().sum(-1)
        index = distance.argmin(-1)
        selected = book[index]
        ids.append(index)
        reconstruction += selected
        residual -= selected
    return torch.stack(ids,dim=-1), reconstruction, residual

def prefix_mask(text_length, audio_length):
    """True means BLOCKED. Text bidirectional; audio causal over all text."""
    n, t = text_length, audio_length
    mask = torch.zeros(n+t,n+t,dtype=torch.bool)
    mask[:n,n:] = True
    mask[n:,n:] = torch.ones(t,t,dtype=torch.bool).triu(1)
    return mask

def flow_target(noise, target, time):
    return (1-time)*noise + time*target, target-noise

def masked_mse(prediction, target, generated_mask):
    """Mask [B,T] includes generated valid frames only; tensor [B,T,D]."""
    weight = generated_mask.unsqueeze(-1).expand_as(prediction)
    if not weight.any(): raise ValueError('empty generated region')
    return (prediction-target).square()[weight].mean()

def euler(initial, velocity, steps):
    if steps < 1: raise ValueError('steps must be positive')
    state = initial.clone()
    for j in range(steps): state = state + velocity(state,j/steps)/steps
    return state

def period_view(waveform, period):
    """[B,1,L] -> [B,1,ceil(L/p),p]; constant pad is teaching-only."""
    if period < 1: raise ValueError('period must be positive')
    pad = (-waveform.shape[-1]) % period
    padded = F.pad(waveform,(0,pad))
    return padded.reshape(*padded.shape[:-1],-1,period)

def delay_pattern(tokens):
    """[T,K] -> [T+K-1,K]; -1 denotes BOS/EOS padding in this demo."""
    t,k=tokens.shape
    grid=torch.full((t+k-1,k),-1,dtype=tokens.dtype)
    for j in range(k):grid[j:j+t,j]=tokens[:,j]
    return grid

def run_checks():
    torch.manual_seed(2026)
    out={'scope':'Teaching tensor invariants; no speech training or MOS measurement.',
         'torch':torch.__version__,'device':'cpu'}
    h=torch.tensor([[1.,10.],[2.,20.],[3.,30.]],requires_grad=True)
    expanded=length_regulate(h,torch.tensor([2,1,3]))
    expanded.sum().backward()
    assert expanded.shape==(6,2)
    assert h.grad[:,0].tolist()==[2,1,3]
    try:
        length_regulate(h,torch.tensor([2,-1,3]))
    except ValueError:
        pass
    else:
        raise AssertionError('negative duration was accepted')
    out['duration']={'expanded':expanded.detach().tolist(),'gradient':h.grad[:,0].tolist()}
    scores=torch.tensor([[3.,-4.,-9.],[2.,1.,-8.],[-4.,3.,-1.],[-6.,1.,4.],[-7.,0.,5.]])
    path,best=monotonic_path(scores)
    assert path.argmax(-1).tolist()==[0,0,1,2,2]
    assert path.sum(1).eq(1).all() and path.sum(0).gt(0).all()
    assert best.item()==17
    # Cross-check dynamic programming against exhaustive legal duration compositions.
    brute=[]
    for a in range(1,4):
        for b in range(1,5-a):
            c=5-a-b
            if c>0:brute.append(scores[range(5),[0]*a+[1]*b+[2]*c].sum().item())
    assert best.item()==max(brute)
    out['mas']={'path':path.argmax(-1).tolist(),'durations':path.sum(0).tolist(),'score':best.item()}
    z=torch.tensor([[2.2,1.1]])
    books=torch.tensor([[[0.,0.],[2.,0.],[0.,2.]],[[0.,0.],[.25,1.],[1.,.5]]])
    ids,q,r=residual_quantize(z,books)
    assert ids.tolist()==[[1,1]] and torch.allclose(q+r,z)
    out['rvq']={'ids':ids.tolist(),'reconstructed':q.tolist(),'residual':r.tolist()}
    mask=prefix_mask(3,4)
    qk=torch.randn(7,7)
    weights=qk.masked_fill(mask,-torch.inf).softmax(-1)
    assert weights[mask].eq(0).all()
    values=torch.randn(7,3); altered=values.clone();altered[6]+=100
    assert torch.equal((weights@values)[:6],(weights@altered)[:6])
    out['prefix']={'shape':list(mask.shape),'blocked_probability':float(weights[mask].sum())}
    x0=torch.tensor([0.,2.]);x1=torch.tensor([4.,0.])
    xt,velocity=flow_target(x0,x1,.25)
    final=euler(x0,lambda x,t:velocity,4)
    assert torch.allclose(final,x1)
    pred=torch.zeros(1,4,2,requires_grad=True); target=torch.ones_like(pred)
    loss=masked_mse(pred,target,torch.tensor([[False,True,True,False]]));loss.backward()
    assert pred.grad[:,[0,3]].eq(0).all() and pred.grad[:,[1,2]].ne(0).all()
    out['flow']={'at_quarter':xt.tolist(),'velocity':velocity.tolist(),'euler_final':final.tolist(),'masked_mse':loss.item()}
    folded=period_view(torch.arange(10.).reshape(1,1,10),3)
    assert folded.shape==(1,1,4,3)
    out['period']={'rows':folded[0,0].tolist()}
    tokens=torch.arange(12).reshape(4,3);grid=delay_pattern(tokens)
    assert all(torch.equal(grid[j:j+4,j],tokens[:,j]) for j in range(3))
    out['delay']={'grid':grid.tolist(),'steps':len(grid)}
    return out

if __name__=='__main__':
    result=run_checks()
    (Path(__file__).parent/'results').mkdir(exist_ok=True)
    (Path(__file__).parent/'results'/'mechanism-checks.json').write_text(json.dumps(result,indent=2),encoding='utf8')
    print(json.dumps(result,indent=2))
4. 从实验进入模型复现
结构实验通过后,再加入真实特征、批处理 mask、设备精度和模型权重。复现音质还需固定测试文本、参考录音、评测协议与听音条件;上述结果不能充当训练收敛或音质指标。返回 TTS 技术路线。
专题导航:TTS 总目录
正在连接 GitHub 评论…