04|条件 WaveNet:mel 上采样与混合 Logistic 输出
Tacotron 2 的声学模型输出 mel,WaveNet 输出波形。这条接口有两个独立问题:频谱条件如何对齐到每个采样点,以及输出头如何描述 16 位波形幅值。原版 WaveNet 的 256 类量化例子,不能直接替代 Tacotron 2 的混合 Logistic 输出。
原论文 §2.3 与训练设置使用 24 kHz 音频、12.5 ms 帧移与 10 个 Logistic 分量;文中的小数例用于理解概率,不是训练好的声音。
mel 上采样生成的是每个采样点的条件向量,不是把 mel 数值直接当作波形播放。
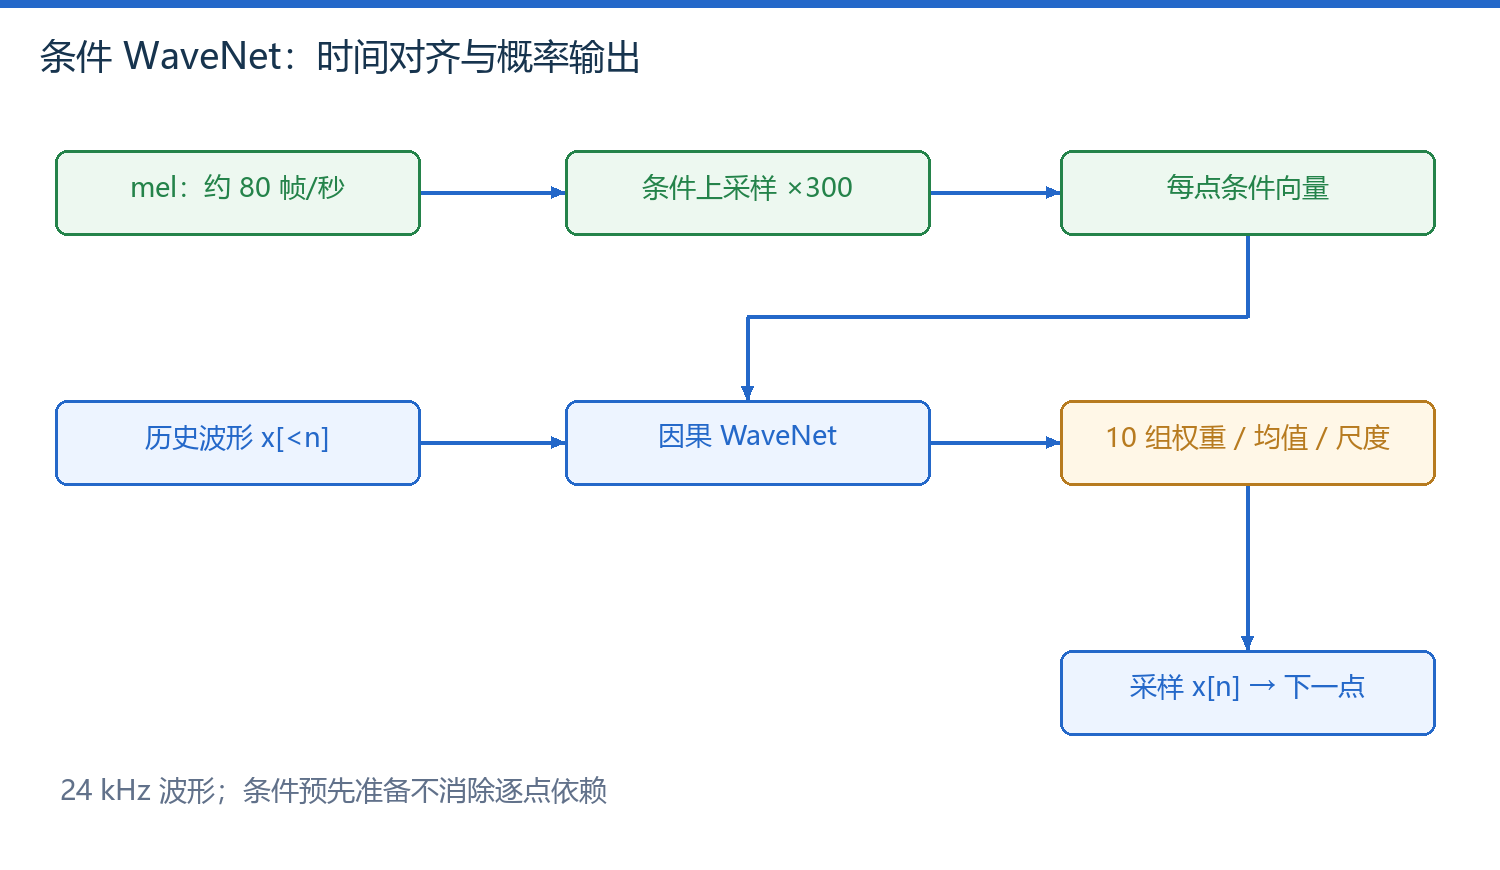
图 1|低帧率 mel 条件与高采样率自回归波形的连接
1. mel 帧与波形采样点的时间对应
| 对象 | 一秒数量 | 示例张量 | 解释 |
|---|---|---|---|
| mel | 约 80 帧 | [B,80,T] | 第二维是频带,最后一维是帧 |
| 条件网络输出 | 约 24,000 位置 | [B,C,L] | 每个位置提供 C 维条件 |
| 波形 | 24,000 点 | [B,1,L] | 单通道振幅序列 |
帧移为 24,000×0.0125=300 点。有效上采样倍率要与 300 匹配,但边界帧数还取决于 STFT padding。对齐不是只检查两个张量恰好能广播:条件错开一帧就相当于约 12.5 ms 的偏移,过渡辅音和起音会受影响。
条件向量进入 WaveNet 的门控残差块,与因果卷积结果共同决定当前输出分布。整句 mel 可以由声学模型预先提供,但波形历史仍按采样点逐步生成;条件并行准备没有消除波形自回归。
2. 混合 Logistic 分布的参数
先介绍连续密度的含义,再说明离散 16 位样本对应区间概率。一个输出位置预测若干分量的权重、均值和尺度:
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 当前真实样本的归一化振幅中心。 | |
| 混合分量数及索引;论文 K=10,教学可先用 1。 | |
| 未归一化权重分数及 softmax 后权重;权重和为 1。 | |
| 第 k 个 Logistic 分布的中心。 | |
| 对数尺度及正尺度;尺度越小,分布越集中。 | |
| sigmoid 函数与第 k 个分量的累积分布函数。 | |
| 相邻归一化量化值间距;与幅值映射约定一起确定。 | |
| 当前量化区间的概率;最小/最大端点要单独处理尾部。 | |
| 对所有分量的区间概率作加权求和。 |
取一个分量,权重 1、均值 0、尺度 1,教学区间 [-0.5,0.5] 的概率为 sigmoid(0.5)-sigmoid(-0.5)≈0.2449,负对数概率约为 1.407。这是刻意放大的区间,不是 16 位音频的实际量化间隔。若两个分量分别给该区间概率 0.2、0.5,权重 0.7、0.3,则最终概率是 0.7×0.2+0.3×0.5=0.29。
训练最小化真实采样点的负对数概率;推理先选混合分量,再按其分布采样或采用约定的生成策略。输出头预测分布参数,并不等价于直接回归一个均值。
3. 混合分布概率计算的数值稳定性
| 数值问题 | 原因 | 处理思路 |
|---|---|---|
| 两个 CDF 几乎相等 | 量化区间小、尾部分布饱和 | 用稳定的 log-space 分支或密度近似 |
| 尺度接近零 | 对数尺度过小 | 按实现限制最小 log scale |
| 混合概率下溢 | 多个很小概率相加 | 使用 log-sum-exp |
| 边界样本丢失概率质量 | 区间一端超出归一化范围 | 为最小/最大样本累计尾部 |
这些操作改变的是数值稳定性,不能随意把 tiny probability 替换成常数后声称仍在精确优化同一目标。复现应对照选用的 MoL 实现及其幅值归一化。
4. 声码器训练条件与输入分布
Tacotron 2 论文先训练频谱预测器,再用第一阶段生成的输出训练调整后的 WaveNet。对“声码器通常在真实 mel 上训练”的一般性讨论,不能直接写成这篇论文的训练事实。两类条件值得分开做接口诊断:
| 验证输入 | 能回答的问题 | 不能直接回答 |
|---|---|---|
| 与训练前端一致的真实 mel | 波形端是否能重建这类条件 | 是否适应声学模型预测误差 |
| teacher-forced 预测 mel | 在较稳定对齐下如何处理预测谱 | 自由生成是否漏字 |
| 自由生成 mel | 完整文字到音频链路表现 | 错误必然来自声码器 |
先固定 mel 变换、时间对齐和条件来源,再比较波形输出头。
5. 与并行声码器的连接
混合 Logistic 改变概率表示,没有消除逐点依赖。HiFi-GAN 则改为卷积生成整段波形,通过训练时的判别器约束细节。两者差别同时涉及网络执行方式和训练目标,不只是输出头换了名字。
频谱失去相位信息不意味着声码器可以任意生成内容;它仍受 mel 和训练分布约束。
下一步阅读 HiFi-GAN 生成器,对比时间维如何被并行展开。
正在连接 GitHub 评论…