附录|深入机制实验:输入契约、梯度检查与完整代码
本附录集中保存本轮新增教程的可运行代码。它验证注意力读取、mel 有效区、上采样形状、GAN 梯度边界、CFM 掩码、Sway 网格、FSQ 及流式缓存,便于对照文章中的手算例。它没有下载模型权重,也没有训练完整语音系统。
先按正文理解数据流,再运行对应实验;完整源码仅作为可复制的参考。
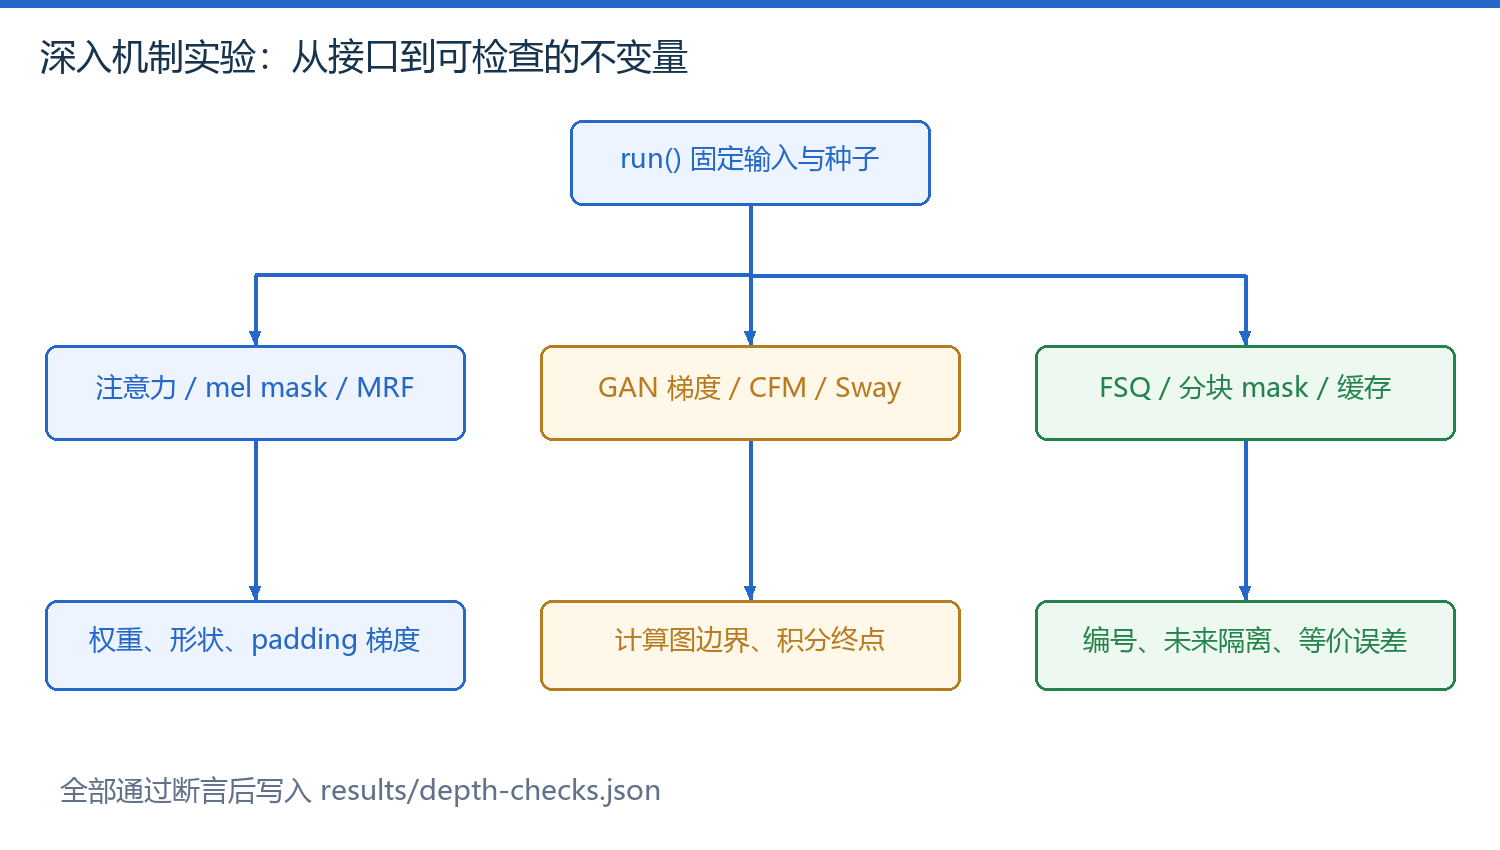
图 1|九组机制检查的输入、执行与输出记录
1. 模块阅读地图
| 函数/模块 | 输入契约 | 负责验证 | 对应子文 |
|---|---|---|---|
| attend | 分数 [B,N]、记忆 [B,N,H]、有效文字 mask | padding 与加权上下文 | 位置敏感注意力 |
| acoustic_loss | 两路 mel、标签、长度 | 有效元素平均与 padding 梯度 | 声学训练 |
| MiniMRF | [B,C,L] | 并联残差、分支平均、形状 | HiFi-GAN 生成器 |
| gan_gradient_check | 内置标量参数 | D/G 阶段 detach 和冻结区别 | 对抗损失 |
| cfm_batch | mel、噪声、时间、两类 mask | 条件与监督区分 | F5 训练 |
| sway_grid / integrate | 网格参数、初值、速度函数 | 非均匀步长 | F5 采样 |
| fsq_teaching | 两维连续向量 | 前向取整、反向近似、编号 | CosyVoice tokenizer |
| chunk_allow | 长度、块长 | 块内双向与未来隔离 | 分块 CFM |
| causal_conv_chunk | 新块、历史、卷积核 | 分块与完整计算等价 | Qwen 流式缓存 |
2. 运行环境与命令
实测环境为 Python 3.12.14、PyTorch 2.14.0+cpu,运行于 CPU。将下方源码保存为 depth_lab.py,在已经安装 PyTorch 的环境执行:
python depth_lab.py
程序在脚本旁建立 results/depth-checks.json,同时向终端打印结果。没有外部语音文件依赖。若测试失败,应保留异常与版本信息;不要删除 assert 后把“能打印”当成验证通过。
3. 实际结果与解释
| 检查 | 本轮结果 | 支持的结论 |
|---|---|---|
| 注意力读取 | 权重约 [0.1,0.2,0.7,0],上下文 [2.2,2.5] | 有效位置归一化和读取正确 |
| mel mask | loss=2,padding 梯度为零 | 无效帧未进入该损失 |
| 上采样+MRF | [1,4,10]→[1,4,80] | 当前配置形状和反向可执行 |
| MPD reflect | 最后一行 [9,8,7] | 非整除边界处理符合示例 |
| GAN 梯度 | D 阶段无 G 梯度;G 阶段 g_grad≈−0.96 | 两阶段图边界正确 |
| CFM mask | loss=1,参考与 padding 区梯度为零 | 监督区域正确 |
| Sway 积分 | 恒速二维终点 [4,0] | 实际非均匀步长被使用 |
| FSQ | 编码 [1,0],编号 5,非零近似梯度 | 格点编码与 STE 正确 |
| 分块注意力 | 未来扰动不改变第一块输出 | 该层看不到后续块 |
| 卷积缓存 | 最大绝对误差 0 | 指定核、输入与切法下精确一致 |
结果来自本轮实际运行;图中其余数值示意不自动变成完整模型实测。
4. 完整源码
数据入口全部位于 run();各函数与图 1 的分支对应,断言通过后才写结果文件。代码较长,可以收起这一参考区域,回到对应机制文章。
完整 depth_lab.py 源码
python151 行
"""Small CPU mechanisms; no trained speech model or audio-quality claim."""
from pathlib import Path
import json, math
import torch
from torch import nn
from torch.nn import functional as F

def attend(energy, memory, valid):
    # energy [B,N], memory [B,N,H], valid [B,N]
    if not valid.any(-1).all():
        raise ValueError('each item needs a valid text position')
    weights = energy.masked_fill(~valid, -torch.inf).softmax(-1)
    context = torch.bmm(weights[:,None,:], memory).squeeze(1)
    return weights, context

def acoustic_loss(before, after, target, lengths):
    # All mel tensors [B,T,F]; normalize by valid scalar elements.
    mask = torch.arange(target.shape[1])[None,:] < lengths[:,None]
    mask = mask.to(target.device).unsqueeze(-1).expand_as(target)
    if not mask.any(): raise ValueError('empty mel target')
    return ((before-target).square()[mask].mean()
            +(after-target).square()[mask].mean())

class MiniMRF(nn.Module):
    """Teaching residual branches, not a HiFi-GAN checkpoint-compatible block."""
    def __init__(self, channels=4):
        super().__init__()
        self.branches=nn.ModuleList([
            nn.Conv1d(channels, channels, k, padding=(k-1)//2)
            for k in (3,5,7)])
    def forward(self, x):
        return torch.stack([x+layer(F.leaky_relu(x,0.1))
                            for layer in self.branches]).mean(0)

def gan_gradient_check():
    # Scalar parameters expose the detach boundary exactly.
    g=torch.tensor(0.5,requires_grad=True)
    d=torch.tensor(0.4,requires_grad=True)
    real=torch.tensor(1.)
    fake=2*g
    loss_d=(d*real-1).square()+(d*fake.detach()).square()
    loss_d.backward()
    assert g.grad is None
    d_grad=float(d.grad)
    d.grad=None
    d.requires_grad_(False)
    loss_g=(d*fake-1).square()
    loss_g.backward()
    assert g.grad is not None and d.grad is None
    return dict(loss_d=float(loss_d.detach()),d_grad=d_grad,
                loss_g=float(loss_g.detach()),g_grad=float(g.grad))

def cfm_batch(target, noise, time, generate, valid):
    # [B,T,F], time [B], Boolean masks [B,T]
    tau=time[:,None,None]
    state=(1-tau)*noise+tau*target
    reference=target.masked_fill((generate|~valid)[...,None],0)
    supervised=generate & valid
    if not supervised.any(): raise ValueError('no generated valid frame')
    return state,reference,target-noise,supervised

def sway_grid(steps, coefficient=-1.):
    u=torch.linspace(0.,1.,steps+1)
    t=u+coefficient*(torch.cos(math.pi*u/2)-1+u)
    if not torch.all(t[1:]>t[:-1]): raise ValueError('non-monotone grid')
    return t

def integrate(initial, velocity, times):
    state=initial.clone()
    for start,end in zip(times[:-1],times[1:]):
        state=state+(end-start)*velocity(state,start)
    return state

def fsq_teaching(h):
    # Two dimensions with levels -1,0,1; no learned nearest-neighbor table.
    bounded=h.tanh()
    integer=bounded.round()
    straight=bounded+(integer-bounded).detach()
    digits=(integer+1).long()
    index=digits[...,0]+3*digits[...,1]
    return straight,index

def chunk_allow(length, chunk_size):
    q=torch.arange(length)[:,None]
    k=torch.arange(length)[None,:]
    return k//chunk_size <= q//chunk_size

def causal_conv_chunk(x, history, weight):
    # Stride 1, dilation 1, [B,C,T]; history owns the last K-1 inputs.
    keep=weight.shape[-1]-1
    joined=torch.cat([history,x],-1)
    out=F.conv1d(joined,weight)
    new_history=joined[...,-keep:] if keep else joined[...,:0]
    return out,new_history

def run():
    torch.manual_seed(30)
    out={'scope':'deterministic teaching checks, CPU; no full TTS training',
         'torch':torch.__version__}
    memory=torch.tensor([[[1.,0.],[0.,2.],[3.,3.],[99.,99.]]])
    energy=torch.tensor([[0.,math.log(2),math.log(7),100.]])
    a,c=attend(energy,memory,torch.tensor([[True,True,True,False]]))
    assert torch.allclose(a,torch.tensor([[.1,.2,.7,0.]]),atol=1e-6)
    assert torch.allclose(c,torch.tensor([[2.2,2.5]]),atol=1e-6)
    out['attention']={'weights':a.tolist(),'context':c.tolist()}
    target=torch.zeros(2,4,2);before=torch.ones_like(target,requires_grad=True)
    after=torch.ones_like(target,requires_grad=True);lengths=torch.tensor([2,4])
    loss=acoustic_loss(before,after,target,lengths);loss.backward()
    assert loss.item()==2 and before.grad[0,2:].eq(0).all()
    out['mel_mask']={'loss':loss.item(),'padding_gradient':before.grad[0,2:].tolist()}
    x=torch.randn(1,4,10);up=nn.ConvTranspose1d(4,4,16,stride=8,padding=4)(x)
    fused=MiniMRF()(up);fused.sum().backward()
    assert fused.shape==(1,4,80)
    out['upsample_mrf']={'input':list(x.shape),'output':list(fused.shape)}
    wav=torch.arange(10.).reshape(1,1,-1)
    folded=F.pad(wav,(0,2),mode='reflect').reshape(1,1,4,3)
    assert folded.flatten().tolist()==[0,1,2,3,4,5,6,7,8,9,8,7]
    out['mpd']={'period3_reflect':folded[0,0].tolist()}
    out['gan']=gan_gradient_check()
    target=torch.ones(1,5,2);noise=torch.zeros_like(target)
    state,ref,velocity,m=cfm_batch(target,noise,torch.tensor([.25]),
        torch.tensor([[False,False,True,True,True]]),torch.tensor([[True,True,True,True,False]]))
    pred=torch.zeros_like(target,requires_grad=True)
    fm_loss=(pred-velocity).square()[m].mean();fm_loss.backward()
    assert pred.grad[:,[0,1,4]].eq(0).all() and pred.grad[:,2:4].ne(0).all()
    assert ref[0,:,0].tolist()==[1,1,0,0,0]
    out['cfm']={'condition':ref[0,:,0].tolist(),'mask':m.tolist(),'loss':fm_loss.item()}
    grid=sway_grid(4);final=integrate(torch.tensor([0.,2.]),lambda x,t:torch.tensor([4.,-2.]),grid)
    assert torch.allclose(final,torch.tensor([4.,0.]),atol=1e-6)
    out['sway']={'grid':grid.tolist(),'final':final.tolist()}
    h=torch.tensor([[1.1,-.2]],requires_grad=True);z,idx=fsq_teaching(h)
    z.sum().backward();assert idx.item()==5 and h.grad.ne(0).all()
    out['fsq']={'code':z.tolist(),'index':idx.tolist(),'gradient':h.grad.tolist()}
    allow=chunk_allow(6,2);scores=torch.randn(6,6);weights=scores.masked_fill(~allow,-torch.inf).softmax(-1)
    values=torch.randn(6,3);changed=values.clone();changed[2:]+=100
    assert torch.equal((weights@values)[:2],(weights@changed)[:2])
    out['chunk']={'allowed':allow.int().tolist(),'future_perturbation_invariant':True}
    wave=torch.arange(12.).reshape(1,1,12);kernel=torch.tensor([[[1.,2.,3.]]])
    full=F.conv1d(F.pad(wave,(2,0)),kernel);history=torch.zeros(1,1,2);parts=[]
    for part in wave.split([3,4,5],-1):
        y,history=causal_conv_chunk(part,history,kernel);parts.append(y)
    cached=torch.cat(parts,-1);error=(cached-full).abs().max().item()
    assert error==0
    out['cache']={'max_error':error,'output':cached.flatten().tolist()}
    return out

if __name__=='__main__':
    result=run();root=Path(__file__).parent/'results';root.mkdir(exist_ok=True)
    (root/'depth-checks.json').write_text(json.dumps(result,indent=2),encoding='utf8')
    print(json.dumps(result,indent=2))
小机制检查不能证明大模型音质、长句稳定性或论文中的延迟数字。
完整训练和真实语音评测需要独立的数据、模型权重、设备和盲听设计。本轮不把这些未执行事项写成已复现。
专题导航:TTS 总目录
正在连接 GitHub 评论…