03|Tacotron 2 与说话人迁移:声学接口的形成
Tacotron 2 把文字变成 mel 频谱,再交给条件 WaveNet 生成波形。理解它的价值,要区分两种错误:读错、重复、漏字通常先查声学模型;音色粗糙、底噪和高频伪影还需检查声码器及其输入分布。 本章衔接 Tacotron 专题,并解释后来的说话人迁移为何能复用这条接口。
深入学习路径
从文本对齐、帧级训练到波形条件接口,分别核查每个模块的输入、状态与监督;说话人迁移单独成文。
| 子文章 | 阅读目标 |
|---|---|
| 01|说话人表示:参考录音、向量归一化与零样本迁移 | 参考录音、向量归一化与零样本迁移 |
| 02|位置敏感注意力:累计对齐与解码状态 | 累计对齐与解码状态 |
| 03|声学训练:帧反馈、残差修正与停止判断 | 帧反馈、残差修正与停止判断 |
| 04|条件 WaveNet:mel 上采样与混合 Logistic 输出 | mel 上采样与混合 Logistic 输出 |
各篇包含独立机制解释、张量或状态约定、数值例与验证边界。代码集中入口见 深入机制实验附录。
1. 从原版 Tacotron 到 Tacotron 2
mel 频谱成为语言建模与波形生成之间的条件接口。
| 位置 | 原版 Tacotron | Tacotron 2 | 改变的含义 |
|---|---|---|---|
| 文本编码 | CBHG | 三层卷积与双向 LSTM | 用较直接的局部特征与上下文编码 |
| 对齐 | 内容注意力 | 位置敏感注意力 | 结合历史对齐,帮助推进阅读位置 |
| 声学输出 | 多帧 mel,加线性频谱后处理 | 每步一帧 mel,卷积 post-net 修正 | 以 mel 预测为中心组织网络 |
| 结束 | 受实现停止规则影响 | 单独预测停止概率 | 把结束判断纳入监督 |
| 波形恢复 | Griffin–Lim | 条件 WaveNet | 由生成模型补充相位和细节 |
Tacotron 2 论文中的比较对象与数据条件需一同阅读;这里不把其 MOS 推广为任何语种或任何说话人上的保证。
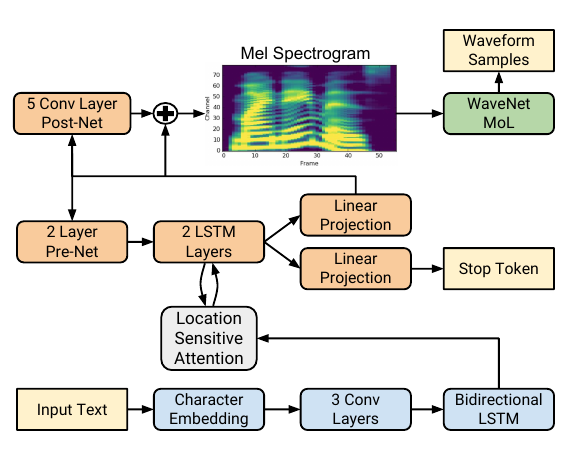
图 1|Tacotron 2 的频谱预测网络与 WaveNet
2. 两条时间轴与条件上采样
以论文使用的 24 kHz 波形、12.5 ms 帧移为例,一秒约有 80 帧 mel,却有 24,000 个波形采样点。WaveNet 每次预测一个采样点,声学条件必须先与该时间轴匹配。帧率决定条件更新时间,采样率决定波形分辨率,两者不可混用。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 帧移对应的采样点数,本例为 300 点。 | |
| 采样率,单位 Hz,即每秒采样点数。 | |
| 相邻频谱帧的时间间隔,单位秒;12.5 ms = 0.0125 s。 | |
| 标量乘法;单位 Hz × s 抵消为采样点数。 |
| 量 | 教学值 | 不能据此推断什么 |
|---|---|---|
| 10 个 mel 帧间隔 | 3,000 个采样点 | STFT 窗长不一定也是 300 |
| 1 秒声学条件 | 约 80 帧 | 边界补齐会影响实际帧数 |
| 1 秒输出波形 | 24,000 点 | 上采样条件不等于复制波形 |
先对齐时间轴,再讨论网络层数,才能避免声学模型与声码器接口错配。
3. 训练与推理的接口偏移
训练声学网络时,解码器通常读取真实的上一帧;推理时读取自己的预测。对一般声码器接入,真实 mel 与预测 mel 的条件差异值得检查;但 Tacotron 2 原论文明确先训练频谱预测器,再使用其生成输出训练 WaveNet,不能把“只用真实 mel 训练”归到原论文。两处偏移可以叠加,因此“真实 mel 重建很好”只证明声码器的上限,没有证明文字到声音整条链路正确。
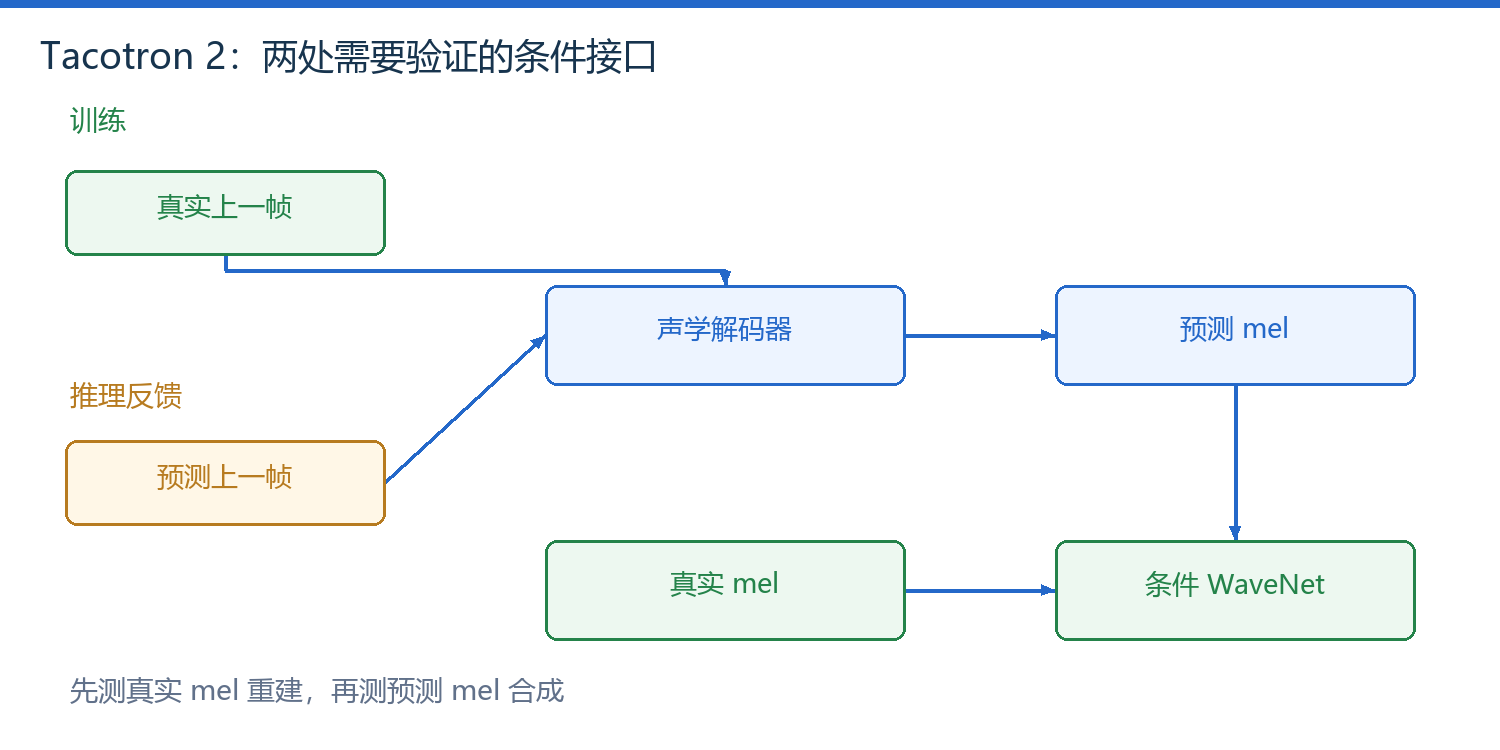
图 2|训练与推理跨越的两处输入分布变化
| 诊断步骤 | 固定什么 | 观察什么 |
|---|---|---|
| 真实 mel → 声码器 | 排除文本预测误差 | 声码器能否重建目标音色、带宽 |
| 预测 mel → 同一声码器 | 固定波形生成模型 | 发音与韵律是否在声学阶段已偏离 |
| 固定文本,多次自回归 | 固定内容 | 对齐是否跳跃、重复或提前停止 |
| 使用预测 mel 适配声码器 | 固定前端 | 分布适配是否改善真实端到端输出 |
只测试真实频谱重建,不能证明文本合成系统没有漏字。
4. 说话人迁移的下一步
单说话人模型把声音身份写进权重。迁移学习方法引入从参考录音得到的说话人向量,让合成器把“说什么”和“谁来说”作为不同输入。其训练数据、向量归一化及泛化限制在 说话人表示子文展开。
| 阅读节点 | 要回答的问题 |
|---|---|
| 说话人编码与零样本迁移 | 未见过的说话人如何通过参考音频进入模型? |
| FastSpeech 与时长建模 | 怎样移除声学帧的逐步反馈? |
| HiFi-GAN | 怎样移除波形采样点的逐步反馈? |
专题导航:TTS 总目录
正在连接 GitHub 评论…