04|FastSpeech:时长监督与并行声学生成
自回归声学网络的下一帧依赖上一帧:不仅慢,对齐走错还可能把错误继续反馈。FastSpeech 将问题拆成两个任务:先决定每个音素占多少帧,再一次性计算全部声学帧。 这里的音素是发音单位;音素个数不是汉字数,也不等于 mel 帧数。论文
时长把长度不匹配变成显式、可控制的中间变量。
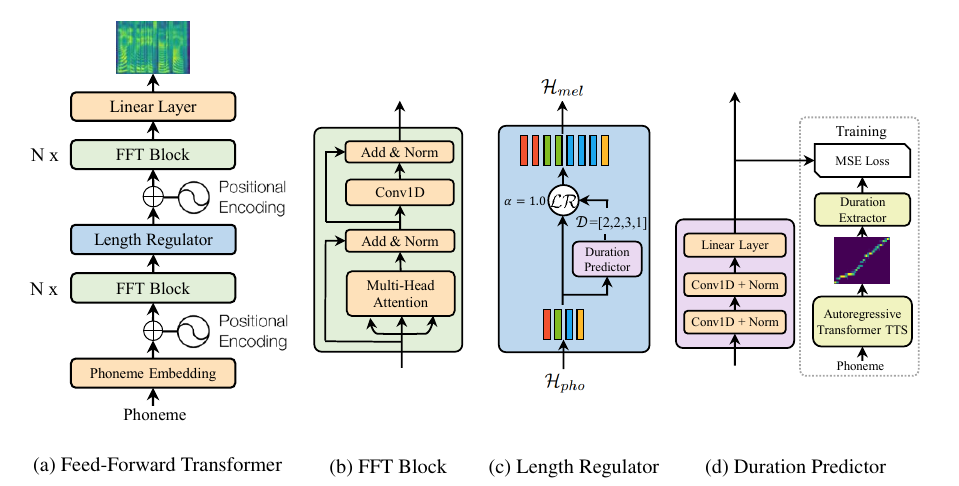
图 1|FastSpeech 的双侧 FFT 与长度调节器
1. 网络为何分成文本侧和帧侧
FFT 在本文指 Feed-Forward Transformer,不是快速傅里叶变换。文本侧在音素时间轴计算上下文;长度调节器复制每个位置的隐藏向量;帧侧再在更长的序列上建模声学变化。复制向量只是提供条件,后续网络输出的频谱帧可以各不相同。
| 阶段 | 教学形状 | 时间轴 |
|---|---|---|
| 音素编码 | [N,H]=[3,2] | 3 个音素 |
| 时长预测 | [N]=[3] | 每个音素一个帧数 |
| 长度调节 | [T,H]=[6,2] | 6 个声学帧 |
| 帧侧 FFT 与投影 | [T,F] | 每帧 F 个 mel 特征 |
2. 长度调节器的手算
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 音素数,本例 3。 | |
| 音素位置索引,1 至 N。 | |
| 第 i 个音素的整数时长,单位为 mel 帧。 | |
| 展开后的帧数;本例 2+1+3=6。 | |
| 文本隐藏矩阵,形状 N×H;H 为隐藏通道数。 | |
| 展开矩阵,形状 T×H。 | |
| Length Regulator:按各位置时长重复向量,不含声学解码。 |
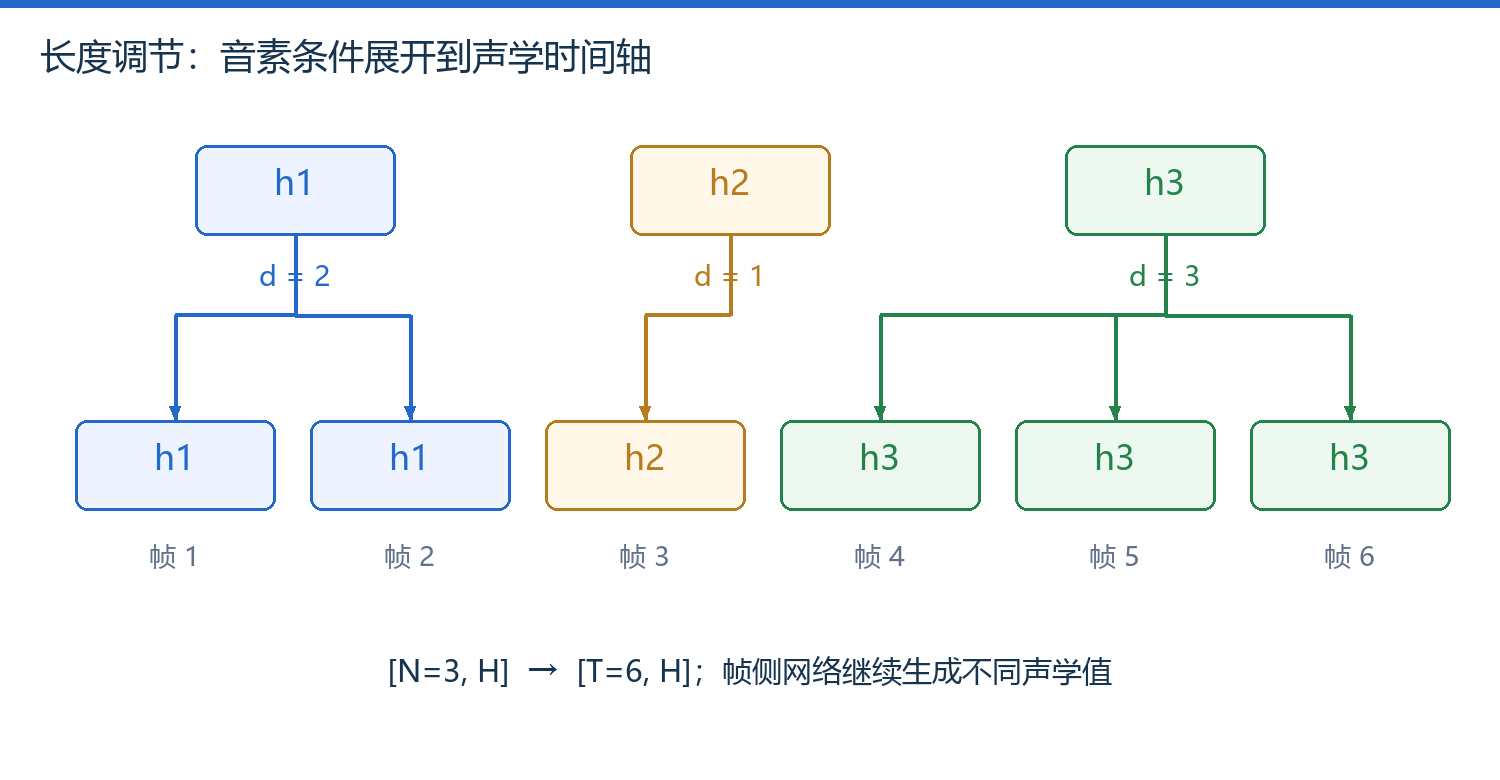
图 2|三个音素按 2、1、3 帧展开,帧位置仍各不相同
| 音素隐藏值 | 时长 | 展开位置 |
|---|---|---|
[1,10] | 2 | 第 1、2 帧 |
[2,20] | 1 | 第 3 帧 |
[3,30] | 3 | 第 4、5、6 帧 |
如果把全部时长乘以 1.5 后取整,句子会变长,通常读得更慢。取整方式、小于一帧的音素、标点停顿都需要明确;“速度系数越大越快”并不是所有接口的共同约定。
3. 训练为什么仍需要教师
原版从自回归教师的注意力提取时长,同时使用教师生成的 mel 作为蒸馏目标。前者回答“重复几次”,后者降低同一文本对应多种韵律的学习难度。推理时教师退出,只保留时长预测与并行声学网络。
| 信息 | 训练 | 推理 |
|---|---|---|
| 时长 | 从教师对齐提取 | 由时长预测器估计 |
| 声学目标 | 教师生成的 mel | 没有目标录音 |
| 长度调节 | 已知整数时长 | 预测值转换为整数时长 |
并行化移除了“生成上一帧才能生成下一帧”的计算依赖。
教师注意力错误会变成时长监督错误;并行网络并不自动修复错误标签。
4. 实现阅读路线
时长与变异适配器解释 FastSpeech 2 如何用真实录音、pitch 和 energy 取代蒸馏;长度调节实验给出数据流、实现与梯度检查。先把时长单位弄清,再阅读多头注意力实现,能更快发现 TTS 特有的问题。
专题导航:TTS 总目录
正在连接 GitHub 评论…