03|声学训练:帧反馈、残差修正与停止判断
Tacotron 2 的训练看起来只是回归 mel,实际至少包含三个相互牵制的任务:保持正确内容对齐,预测下一帧频谱,判断什么时候结束。仅报告总 loss 下降,会掩盖“频谱越来越平滑,但自由生成开始重复”的问题。
本文区分原论文设计、开源实现选择与教学损失。论文采用单帧解码、prenet 信息瓶颈、post-net 残差以及停止概率;NVIDIA 的复现代码在循环结构、正则化和标签处理上有自己的具体实现。论文 · 复现代码
训练时输入真实上一帧,推理时输入自己的预测;网络相同,输入分布与停止条件不同。
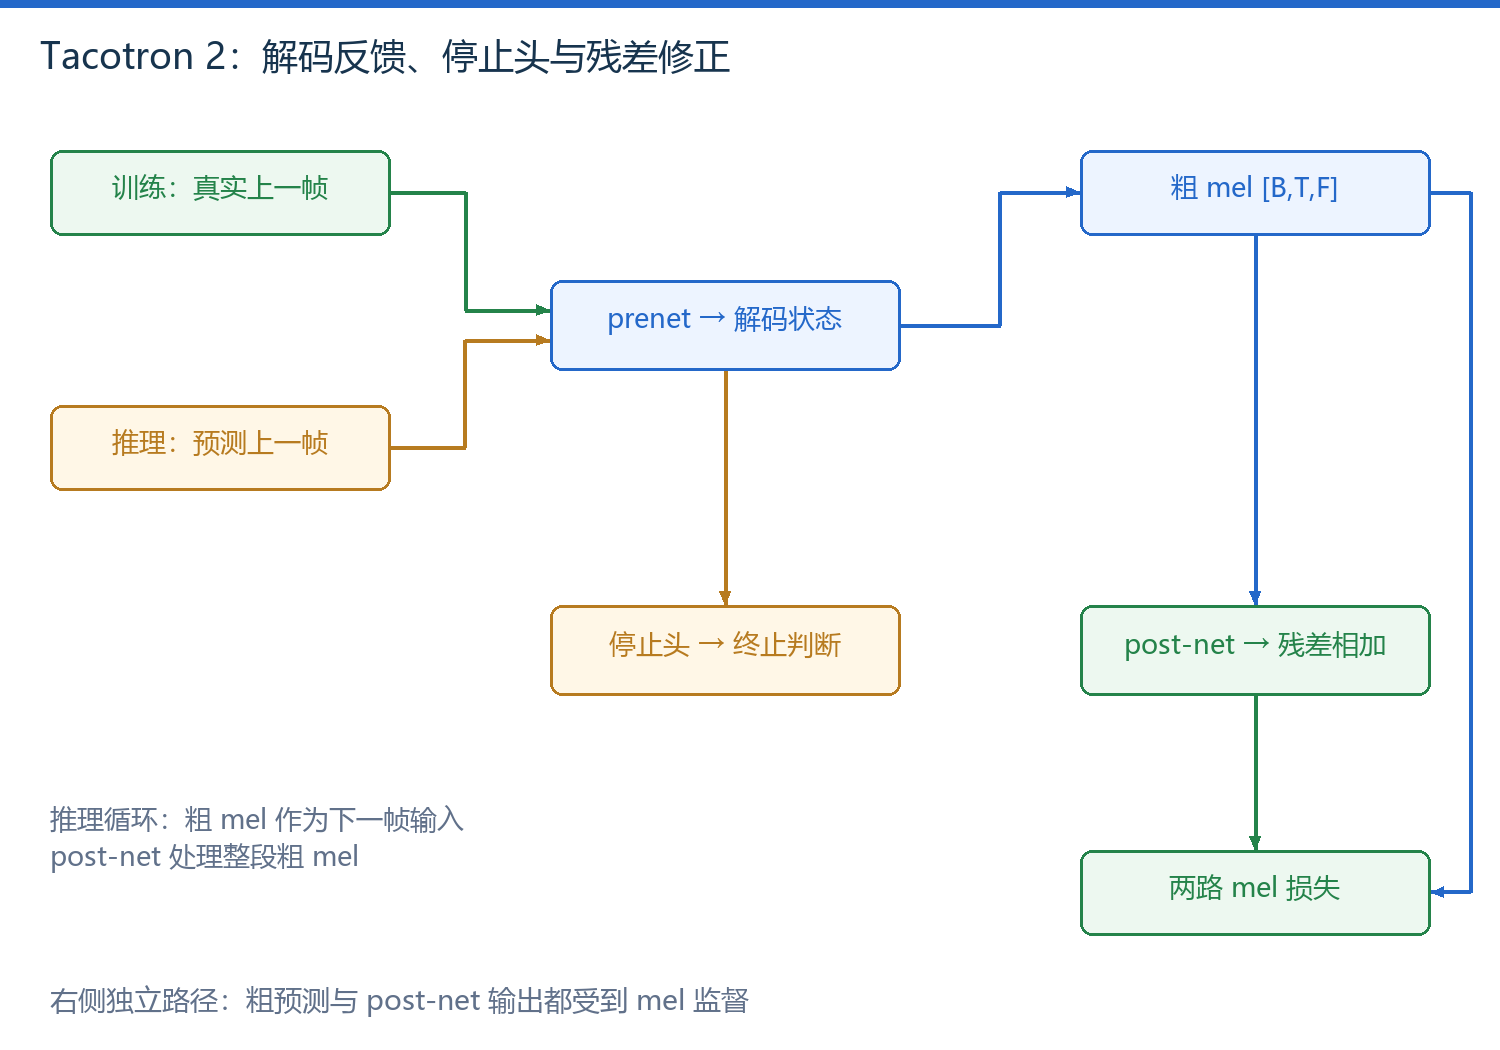
图 1|teacher forcing、自由生成与 post-net 的职责
1. 教师强制与帧反馈偏移
| 解码步 | 训练输入 | 监督目标 | 推理输入 |
|---|---|---|---|
| 0 | 全零 GO 帧 | 真实帧 0 | 同一 GO 帧 |
| 1 | 真实帧 0 | 真实帧 1 | 预测帧 0 |
| 2 | 真实帧 1 | 真实帧 2 | 预测帧 1 |
当前目标不能直接作为当前解码器输入,否则模型可能学到复制。teacher forcing 也不等于所有帧完全并行:LSTM 状态和注意力仍沿解码时间递推,只是历史 mel 不必等待采样结果。
prenet 把上一帧压缩成较小表示,降低网络仅依靠局部频谱惯性的机会。论文在推理时仍对 prenet 使用 dropout;因此把模型设为 eval 后是否彻底关闭所有随机性,必须按实现确认,不能凭框架习惯推断。
2. post-net 的残差修正机制
设解码器先产生粗 mel,再由卷积 post-net 阅读整段粗结果,输出残差。它可利用相邻帧,补充局部细节;这与继续运行一次文字注意力是不同操作。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 解码器粗频谱;教学轴顺序为 [B,T,F]。 | |
| post-net 卷积网络,其输出与输入形状一致。 | |
| 粗频谱加残差后的最终频谱。 | |
| 批大小、声学帧数、mel 频带数;例 [2,4,80]。 | |
| 帽子表示预测;上下标是阶段名称,不是乘方。 |
例如某帧两频带的粗预测是 [-2,-1],残差 [0.2,-0.1],修正结果为 [-1.8,-1.1]。post-net 能修正谱值,但不能保证把已跳过的整段文字补回来,因此对齐与频谱质量必须分别验证。
3. 有效帧损失与停止标签
下面定义教学版有效元素平均 MSE,明确分母;不同实现若包含 padding,会得到不同损失尺度。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 批内样本、声学帧与 mel 频带的索引。 | |
| 真实 mel 标签,与两路预测使用完全相同的变换。 | |
| 有效帧取 1,padding 取 0。 | |
| 频带总数;乘有效帧数得到有效标量数。 | |
| 对所有指定索引求和;该损失同时训练粗预测与残差修正。 |
两个样本分别有 2、4 个有效帧,每帧 2 个频带;若两路预测都比标签多 1,分母为 2×(2+4)=12,分子为 12×(1+1)=24,损失为 2。补齐帧即使出现极大误差,也不应贡献这份 mel 损失。
停止头输出 sigmoid 概率,通常用二元交叉熵训练。论文在首次超过 0.5 时停止;具体复现如何给末帧及 padding 区域设置停止标签,要看数据整理代码。停止头与 mel 回归的 mask 不一定相同。
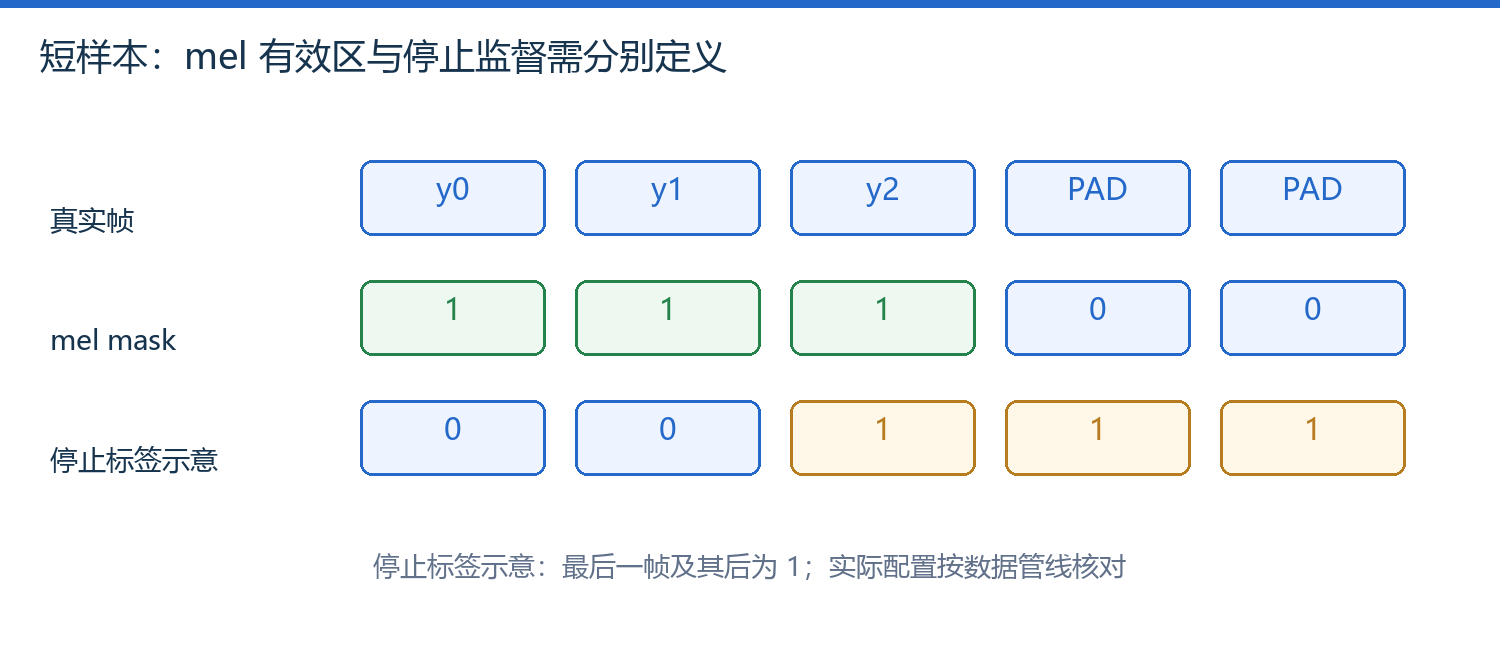
图 2|真实长度、mel 有效区与停止监督的区分
4. 损失代码与实测边界
图 1 的两路 mel 预测在损失节点汇合。调用方提供真实长度;函数只负责生成 mask、计算两路差值并按有效标量数平均。
def acoustic_loss(before, after, target, lengths):
    # All mel tensors [B,T,F]; normalize by valid scalar elements.
    mask = torch.arange(target.shape[1])[None,:] < lengths[:,None]
    mask = mask.to(target.device).unsqueeze(-1).expand_as(target)
    if not mask.any(): raise ValueError('empty mel target')
    return ((before-target).square()[mask].mean()
            +(after-target).square()[mask].mean())
实际 CPU 检查得到损失 2,短样本 padding 的梯度全为零。这个检查能捕获常见的无效帧泄漏,却不能替代完整训练中的自由生成验证。
验证集必须同时保存 teacher-forced loss、自由生成对齐图、停止步数和固定试听样本。
5. 长句与异常终止
| 情况 | 检查动作 | 为什么有用 |
|---|---|---|
| 短句正常、长句循环 | 分段对比,检查注意力尾部 | 区分局部声学能力与累积状态错误 |
| 过早停止 | 记录停止 logits、标签末帧 | 查标签错位或末尾静音处理 |
| 永不停止 | 设置最大步数并记录触发原因 | 限制死循环,同时保留失败证据 |
| 训练好、推理崩溃 | 相同输入切换 teacher forcing | 暴露预测历史带来的分布偏移 |
最大解码步数是保护边界,不能把被强制截断的结果算成正常结束。
接下来在 声学接口与混合 Logistic 输出中连接波形生成。
正在连接 GitHub 评论…