03|统一语言模型:混合序列、填充标记与流式推进
CosyVoice 2 的流式能力不只是把整句生成结果拆成小包发送。它还训练一种文字与语音交替出现的序列格式,让模型在有限文字到达后生成一段语音,再切回接收文字。这里的控制标记决定何时读输入、何时继续生成。
原报告以 Qwen2.5-0.5B 作为文本—语音主干,并使用 5 个文字 token、15 个语音 token 的混合比例。下面用更小比例讲执行机制。CosyVoice 2 §2.3
FILL 表示请求更多文本,不表示“整句已经结束”;EOS 才承担结束语义。
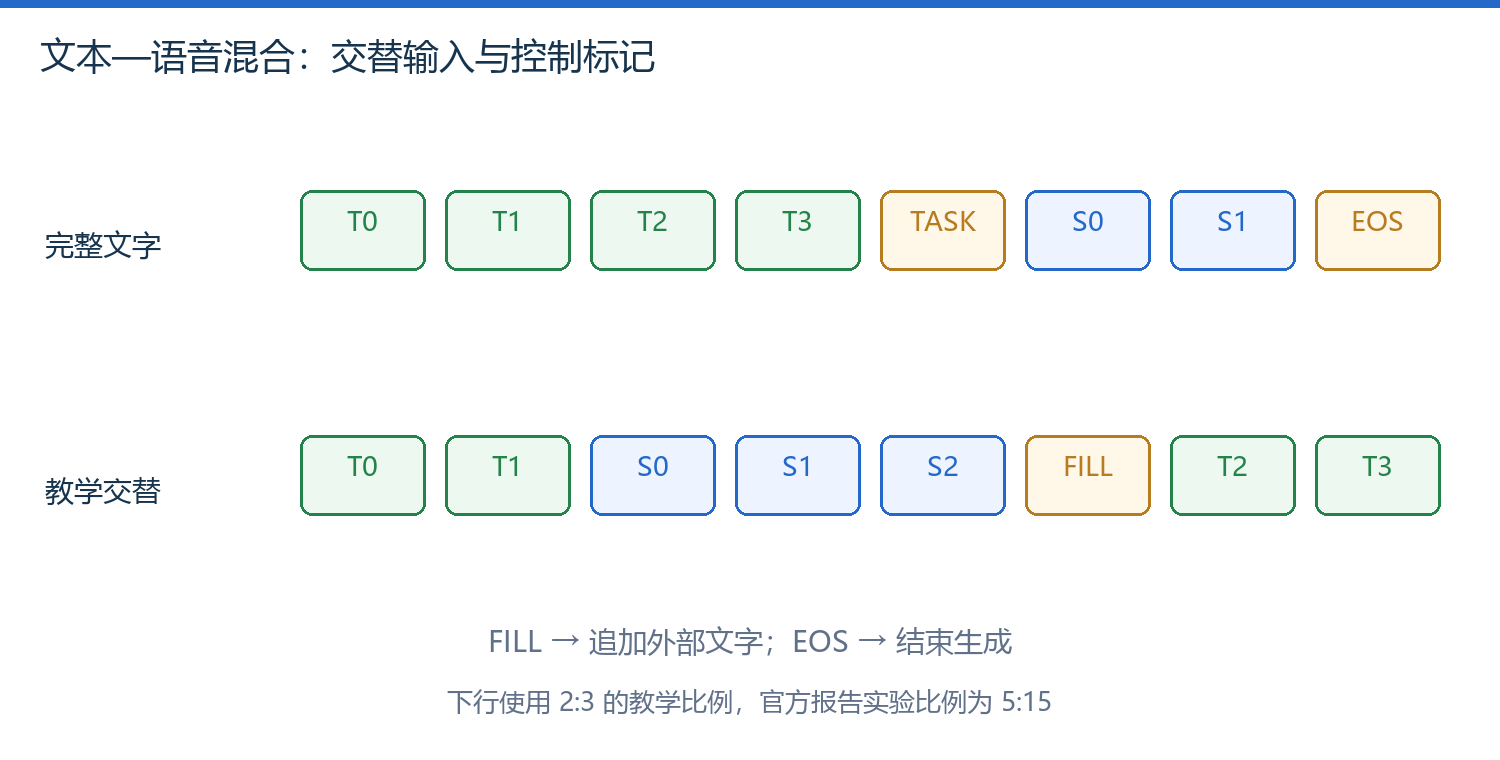
图 1|完整文本前缀与文字/语音交替序列的对照
1. 非流式与流式格式
| 模式 | 示意序列 | 输入条件 |
|---|---|---|
| 非流式 | START Text... TASK Speech... EOS | 先拿到完整文字 |
| 交替模式 | START Text块 Speech块 Text块 Speech块... | 每次引入一部分文字 |
| 文字耗尽后的尾部 | TASK 剩余Speech EOS | 不再请求新文字,完成剩余发声 |
这些名称用于解释职责,并非可直接复制的真实 token ID。提示录音参与 ICL 时,参考转写与参考语音 token 还要按协议拼接;不能把任意 wav 文件路径直接当作 LM token。
2. 外部文字位置的损失屏蔽
文字由调用方提供,语音由模型生成。训练 next-token prediction 时,并非所有位置都计入同一种目标:接入文字的位置可以忽略文本预测损失,切换边界则训练模型预测 filling 标记,提示运行时注入下一块文字。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 混合序列中的位置,不是原始音频采样点。 | |
| 当前可见的全部混合历史。 | |
| 在该位置真正监督的目标:语音编号或控制标记。 | |
| 是否纳入损失的 0/1 权重;忽略位置为 0。 | |
| LM 对目标的条件概率。 | |
| 自然对数及本文定义的有效位置平均交叉熵。 |
三个受监督目标的概率为 0.5、0.25、0.8,负对数约为 0.693、1.386、0.223,平均约 0.767。被忽略的文字位置即使概率很低,也不进入这个平均。padding 同样必须有清楚的忽略规则。
3. 流式生成的状态转移
用教学比例 2 个文字、3 个语音演示;不把它当官方配置。
| 时刻 | 外部输入/模型事件 | LM 状态 | 服务动作 |
|---|---|---|---|
| A | 收到 T0、T1 | 追加两文字 token | 开始语音预测 |
| B | 生成 S0、S1、S2 | 语音历史与 KV cache 增长 | 交给后端或暂存 |
| C | 预测 FILL | 保留已生成状态 | 请求下一文字块 |
| D | 输入尚未到达 | 状态不应被重置 | 等待,并记录输入等待耗时 |
| E | 收到 T2、T3 | 追加文字 | 继续 S3… |
| F | 输入声明结束 | 按协议进入尾部 | 生成剩余语音直到 EOS |
把 C 误当 EOS 会截断句子;在 D 不断重新调用整句生成则可能重复前面的音频。状态所有权应属于当前请求,不能由多个并发用户共享一份历史缓存。
4. 模型流式与产品流式的差别
CosyVoice 2 报告中的不同 ICL/SFT 场景对输入已知程度不同。某个演示以完整目标文字开始,只证明它能逐段输出音频,不自动证明上游文本也可以逐字到达。验证双向流式应主动延迟第二块文字,检查首段音频是否已经生成。
| 测试条件 | 检验对象 |
|---|---|
| 所有文字一次给出 | 模型正常合成、输出分块 |
| 第二块文字延迟送达 | 文本输入等待是否阻塞全部输出 |
| 请求中途取消 | 缓存、GPU 工作与播放队列能否清理 |
| 两请求交替调用 | 缓存是否隔离 |
先验证控制标记与状态推进,再优化分块大小;否则速度优化可能只是更快地产生重复片段。
5. 文字粒度与语言差异
5 个 tokenizer token 并不等于 5 个汉字或 5 个英文单词。缩写、标点、数字及不同语言会改变 token 化长度,也会改变可用语义上下文。因此固定交替比例不能直接解释为固定“每说几个字停一下”。后端还存在语音 token 到 mel 的帧率转换。
文本块足够小不一定更自然;过少右侧语义可能影响断句、多音字与韵律。
继续 分块流匹配,把 LM 输出接到可播放波形。
正在连接 GitHub 评论…