04|分块声学生成:前瞻、注意力遮罩与流匹配
即使语音 LM 已经逐块产生 token,后面的声学生成器仍可能等待完整句子。CosyVoice 2 把 token 到 mel 的流匹配网络也纳入分块设计,通过受控前瞻和注意力遮罩限制可读取的上下文。
本篇解释三个时间尺度:25 Hz token、50 Hz mel、24 kHz 波形。网络内部的流时间又是另一条 0→1 的积分进程,不应与这三条音频时间轴混用。CosyVoice 2 §2.4
低延迟是整个解码链的属性;一个因果注意力 mask 不能抵消前端和声码器的未来依赖。
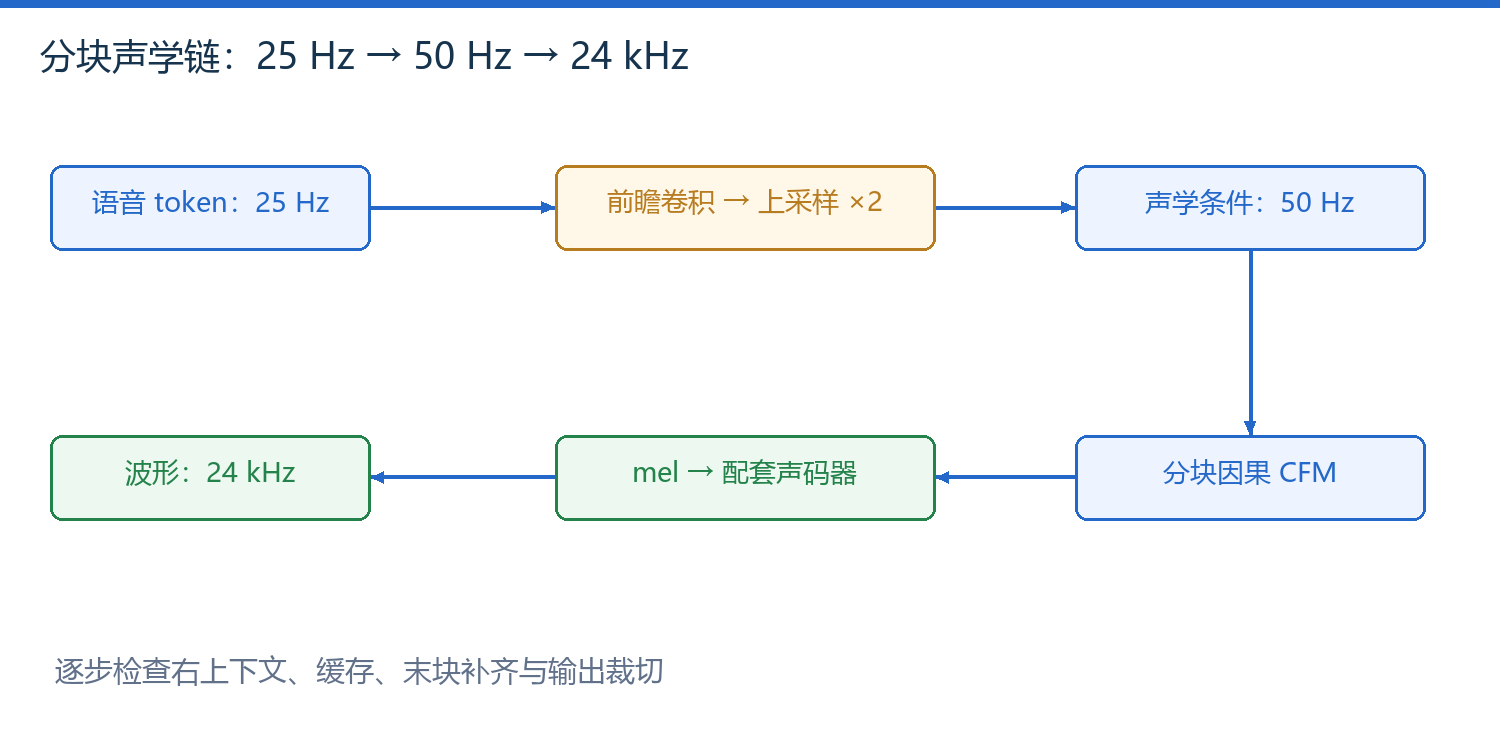
图 1|token 前瞻、二倍上采样、分块 CFM 与波形输出
1. token 帧率与 mel 帧率
| 表示 | 每秒数量 | 15 token 对应的约定时长 |
|---|---|---|
| 语音 token | 25 | 0.6 秒 |
| mel 帧 | 50 | 约 30 帧 |
| 波形点 | 24,000 | 14,400 点 |
这是速率换算,不等于首包墙钟延迟一定是 0.6 秒。token 由模型计算生成,可能快于播放;不过若输入来自真实录音在线编码,等待未来录音就会直接增加采集延迟。
前瞻卷积在 token 上读取一定数量的后续位置,再二倍上采样到 mel 时间轴。若取教学前瞻 P=2,token 时间范围为 2/25=80 ms;在 TTS 输出端,具体额外等待取决于未来两个 token 何时生成。
2. 分块 mask 与逐位置因果 mask
下面用块长 2 的简化规则:查询可以看过去所有块及当前块,不能看后续块。它用于解释“块内双向、块间因果”,不冒充官方全部四种 mask 的逐位实现。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 查询和键的位置索引,从 0 开始。 | |
| 块大小,教学值 2。 | |
| 向下取整,把位置映射到块编号。 | |
| 条件成立时为 1;这里 1 表示允许,不是 blocked。 |
位置 0 可以看位置 1,因为同属第一块;它不能看位置 2。逐位置严格因果则连位置 1 也不可看。需要转换到某个 attention API 时,必须确认布尔 True 表示允许还是屏蔽,不能按变量名猜。
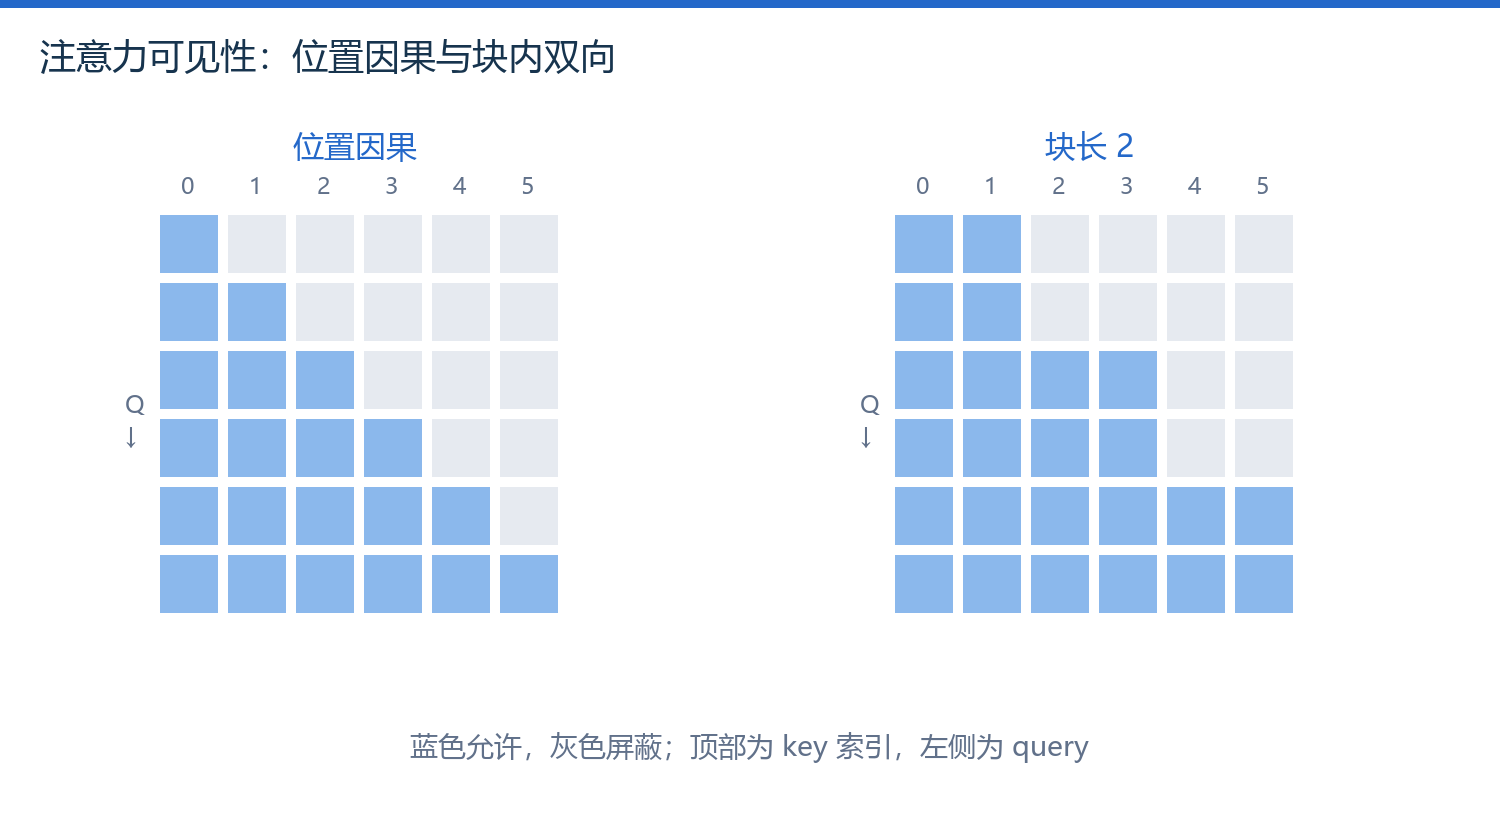
图 2|逐位置因果与块内双向遮罩的可见范围
def chunk_allow(length, chunk_size):
    q=torch.arange(length)[:,None]
    k=torch.arange(length)[None,:]
    return k//chunk_size <= q//chunk_size
CPU 检查把第 2 位置以后的 value 全部增加 100,第一块输出完全不变。这只验证该教学 attention 层的可见性;完整模型还要检查卷积、归一化、上采样与每一次流积分调用。
3. 跨积分步的因果性约束
流匹配推理反复更新状态。若任意一步使用了完整未来条件,未来信息就可能进入当前块;后续再加 mask 也不能撤销已经泄漏的信息。因此应把展开后的多步网络视为一条长计算图,逐个检查所有路径。
| 路径 | 需要检查 | 常见遗漏 |
|---|---|---|
| token 前处理 | 前瞻范围及末块补齐 | 把右 padding 当作无前瞻 |
| CFM 注意力 | 每步采用的 mask | 首步正确、后续步改回全上下文 |
| 卷积/UNet | 右侧感受野 | 仅遮罩 attention |
| mel→波形 | 声码器上下文和裁切 | 输出边界重复或破音 |
原报告用非因果、全因果及不同分块上下文配置统一训练。其目的在于兼容质量/延迟取舍,而不是宣称所有配置具有相同延迟。
4. CosyVoice 的条件与训练目标
CosyVoice 2 报告用 token、参考 mel、说话人向量和流时间作条件,并使用预测速度与目标速度的 L1 差异。F5 教学常见的 MSE 不能原封不动称为这里的论文损失。
对单个速度向量,预测 (1,4)、目标 (2,2),元素平均 L1 为 (1+2)/2=1.5;平均平方误差则为 (1+4)/2=2.5。两者梯度与异常值敏感性不同,日志数值也不可直接对比。
本章把论文条件、损失类型和教学 mask 分开记录,便于读者回到源码逐项核对。
5. 首块、续块与末块
首块缺少左历史,常对延迟最敏感;续块可利用已有上下文;末块必须在没有真实未来 token 时按协议补齐并及时结束。只测中间长片段,容易漏掉首尾错误。固定一句话,用整句与不同分块切法比较边界附近波形,是比只听一段顺滑样例更有区分力的验证。
分块结果相近需要实际对照;不能因为每块 shape 正确就宣称等价于整句推理。
阅读 流式指标与状态继续检查服务层首音延迟。
正在连接 GitHub 评论…