05|逐点生成缓存:状态队列与数值等价验证
这一篇只回答推理实现:每层要保存什么、何时读写,以及如何证明逐点计算与整段卷积一致。读完应能手工推进一个队列,再检查自己写的 step()。
缓存的核心: 保存每一层的输入隐藏向量;先读旧状态,再写新状态。
1. 分层状态队列与更新顺序
对于核宽 =2、膨胀率 =4 的一层,当前计算需要本层输入 和 。中间三项本次用不上,但未来几步会轮到它们。于是维护一个长度为 4、从旧到新的队列。
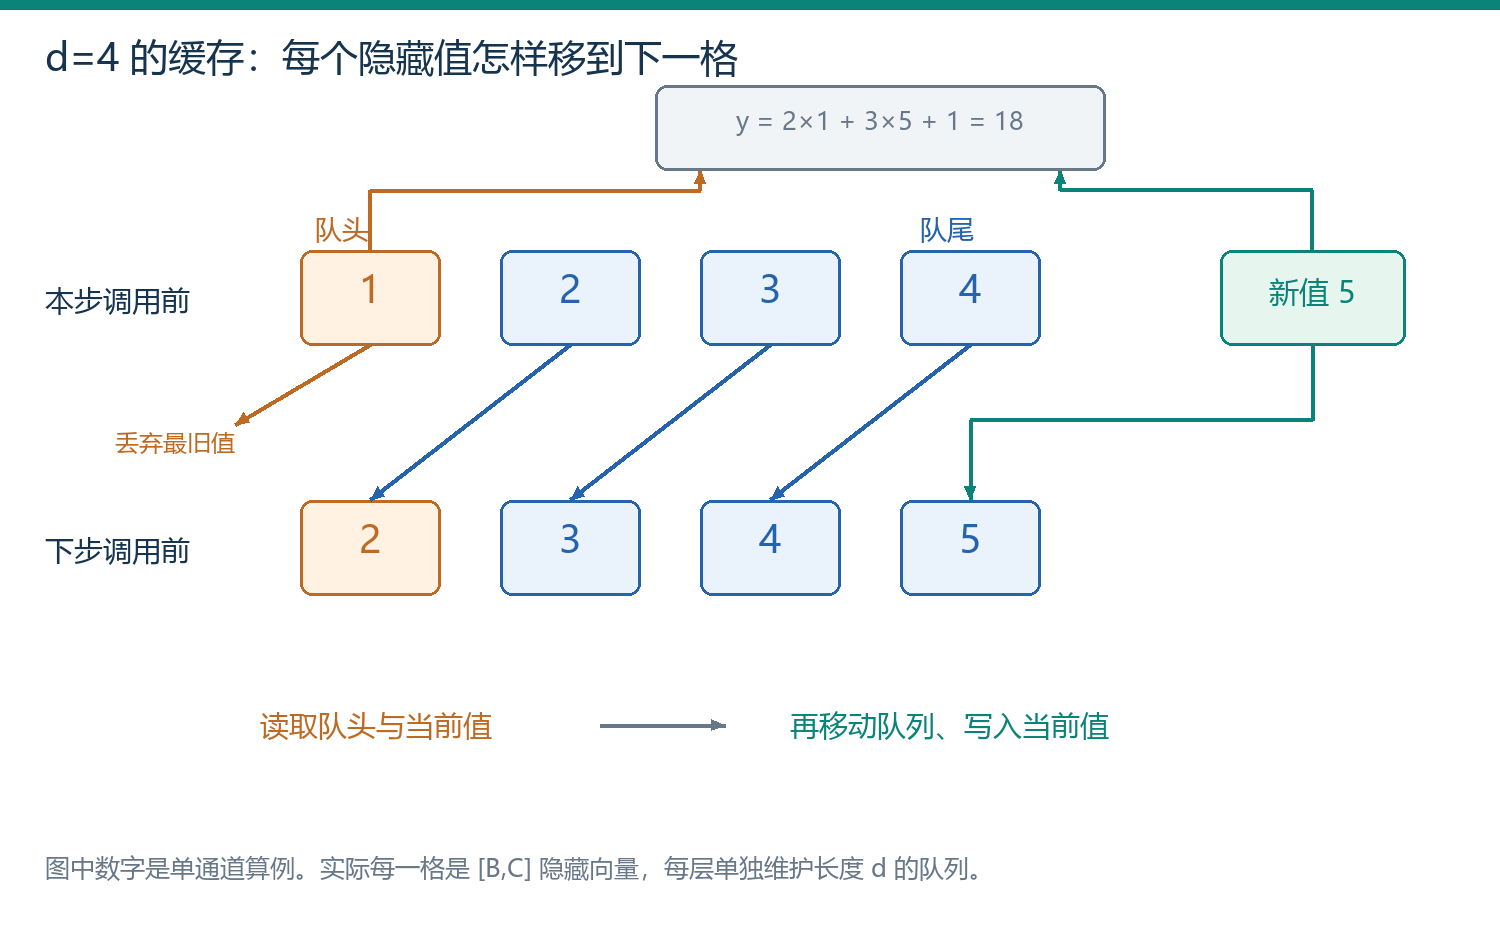
图 1|缓存队列的读取与更新
按行读图。第一行队列 [1,2,3,4],当前输入 5:读队头 1 与当前 5 得到输出 18,再更新成 [2,3,4,5]。下行展示更新后的队列;下一步若输入 6,就会读队头 2,得到 23。先更新再读会把 1 错换成 2,时间错位一个点。
多通道的计算是:
缓存卷积:符号与形状
| 数学记号 | 含义、单位与示例 |
|---|---|
| 当前网络时间索引。 | |
| 该层膨胀率;图中为 。 | |
| 输入隐藏通道数;实际教学网络为 。 | |
| 当前输入隐藏向量,单个样本有 个分量。 | |
| 相隔 步的历史输入向量。 | |
旧位置对应的卷积核切片,形状为 [2C,C]。 | |
| 当前位置对应的卷积核切片,形状同上。 | |
| 偏置向量,长度为 ,只加一次。 | |
| 因果卷积的输出,长度为 ;之后还需条件加法和门控。 |
图中退化为单通道示例,两个权重是 2 和 3,=1,所以第一步为 2×1+3×5+1=18。实际 =24,各层 history 为 [B,24,d],每格存一批隐藏向量,不是一个音频编号。
下面代码只替换因果卷积这一部分。w[:,:,0] 对应旧位置,w[:,:,1] 对应当前。返回的新 history 必须保留并传给下一步。
def step(self, x, history):
    w = self.conv.weight
    y = F.linear(history[:, :, 0], w[:, :, 0])
    y = y + F.linear(x, w[:, :, 1], self.conv.bias)
    history = torch.cat((history[:, :, 1:], x.unsqueeze(-1)), dim=-1)
    return y, history
队列必须保存**进入该层之前的隐藏向量**。第一层读 embedding,后续层读前一块的残差结果;各层表示不同,所以不能只存一段原始波形,再把同一份队列交给所有层。本思路与 Fast WaveNet 的缓存生成方向一致。技术报告
2. 缓存计算与整段卷积的等价性
等价性的核心是:每一步读取的旧值、当前值、权重和条件完全一致。 沿时间与网络深度分别检查:
| 推进方向 | 前提 | 当前操作 | 为下一步保留的条件 |
|---|---|---|---|
| 时间:初始化 | 各层队列全为隐藏零 | 与整段卷积左补零一致 | 第一步读取相同的历史 |
| 时间:索引 | 队列保存 | 读取队头与 ,完成本步计算 | 更新后保存 |
| 深度:当前块到下一块 | 本块输入和目标条件一致 | 执行相同门控、残差、skip | 下一块的当前输入一致 |
这里 是该层在位置 的输入隐藏向量, 是该层膨胀率。归纳依赖具体结构;加入读取未来统计量的归一化后,不能直接沿用证明。本教学模型没有 BatchNorm 或 Dropout。
| 开始方式 | 状态处理 | 原因 |
|---|---|---|
| 新的一条音频 | 重新调用 initial_state(B) | 不能继承上一条音频的隐藏历史 |
| 从真实前缀继续生成 | 逐点送入前缀,预热每层队列 | 每层都需要相应的中间表示 |
| 只提供最后一个 seed | 更早队列仍是零 | 一个音频类别无法恢复整段隐藏历史 |
3. 固定输入下的数值等价测试
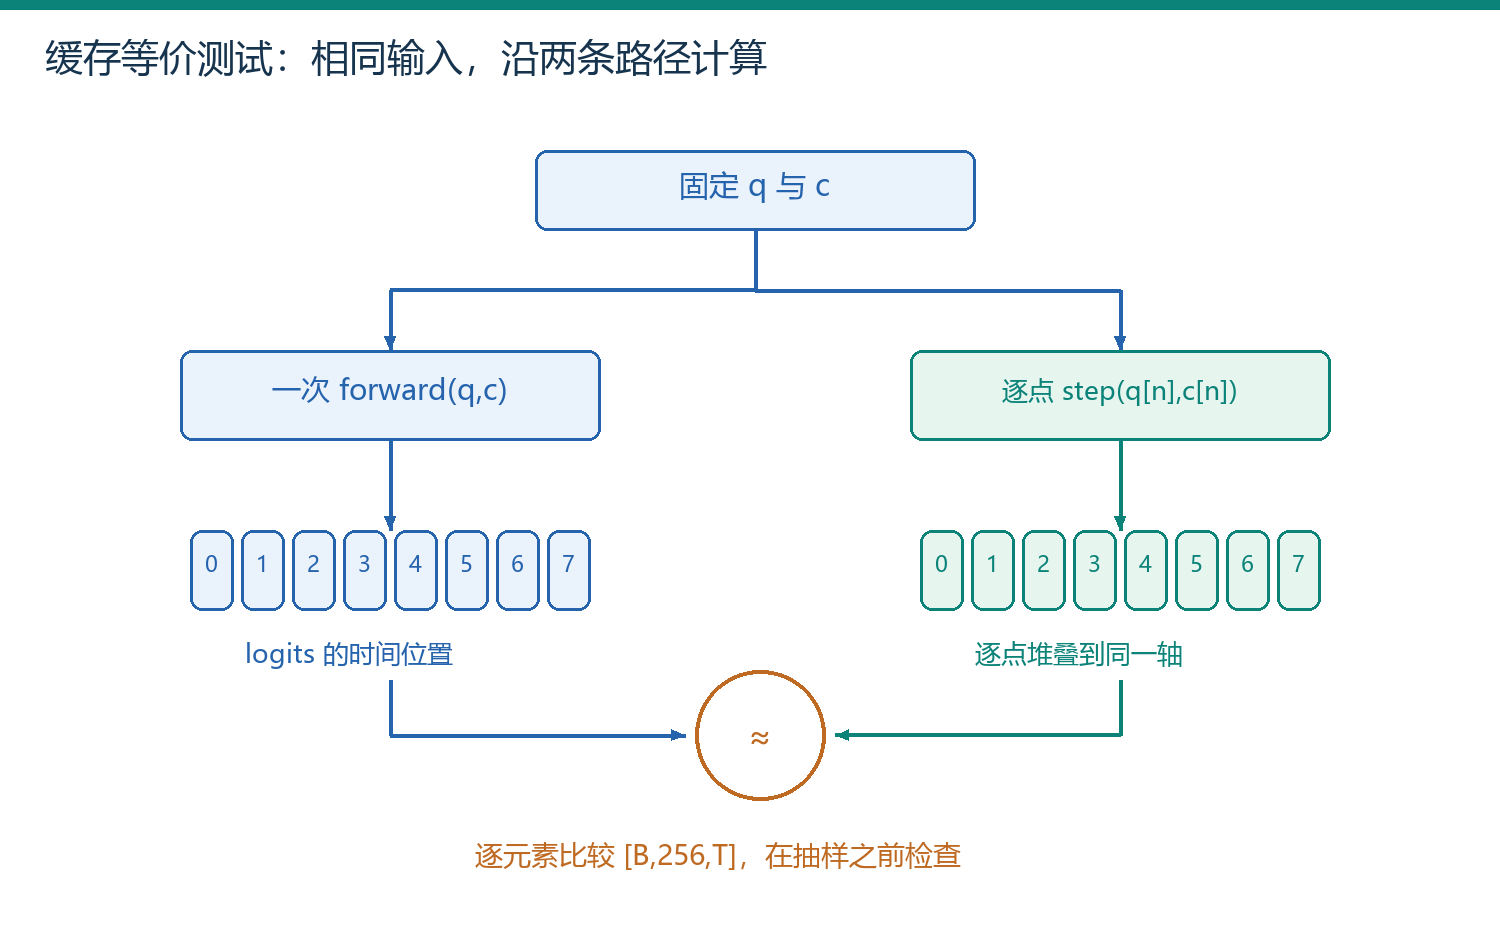
图 2|固定输入下的两条计算路径
沿图中分叉的两条边读:输入保持一致,只有计算路径不同。 两条路径必须接收同一串固定输入 和同一条件。forward 一次输出整段;step 从零状态逐点输出,沿时间堆起来。下面是测试的核心,略去 dtype 转换与其他检查; 为 [B,T], 为 [B,H,T]。
full = model(q, c)
state = model.initial_state(q.shape[0])
parts = []
for n in range(q.shape[1]):
    one, state = model.step(q[:, n], c[:, :, n], state)
    parts.append(one)
cached = torch.stack(parts, dim=2)
torch.testing.assert_close(full, cached, atol=1e-4, rtol=1e-5)
full 与 cached 都是 [B,256,T]。比较的是抽样之前的 logits;若两路各自自由抽样,第一处随机差异就会改变后面的历史,无法定位是不是缓存错误。
浮点比较逐项使用 。
数值比较:误差与容差
| 数学记号 | 含义、单位与示例 |
|---|---|
| 待检查路径在某位置、某类别上的 logit。 | |
| 参考路径在相同位置、相同类别上的 logit。 | |
| 绝对容差,本例为 。 | |
| 相对容差,本例为 。 |
若参考值 ,允许误差约为 。最大绝对误差只是一个摘要,不能脱离各元素大小替代逐项判断。
| 检查精度 | 训练后最大绝对误差 | 解读 |
|---|---|---|
| float32 | 同时按绝对与相对容差逐项检查 | |
| 同一权重转 float64 | 更高精度下的辅助验证 |
算子累加顺序可引入浮点差异。容差内一致不等于逐位相等。 训练前后均执行验证,以覆盖较大权重的情形。
4. 缓存的计算收益与性能限制
队列元素总数为 。
缓存容量:符号与单位
| 数学记号 | 含义、单位与示例 |
|---|---|
| 缓存中的浮点数个数。 | |
| 批大小。 | |
| 每层的隐藏通道数。 | |
| 层数。 | |
| 层索引,从 到 。 | |
| 第 层队列的长度,等于该层膨胀率。 |
代入 、、,得到 。float32 每项占 字节,共 字节,约 KiB,不含模型参数与临时张量。
缓存能减少重复工作,但是否高效还取决于实现:
| 方式 | 每步做什么 | 仍然存在的限制 |
|---|---|---|
本脚本 torch.cat | 拼接并复制队列 | 搬运开销、Python 循环、小算子调度 |
| 环形队列 | 覆盖最旧位置并移动指针 | 仍需顺序预测新点 |
| Parallel WaveNet | 蒸馏训练并行生成器 | 属于生成路径的改造,不是扩大缓存 |
缓存不消除相邻采样的依赖。 秒、 kHz 音频仍需要 次顺序推进。本脚本验证索引与函数等价,没有报告生产实时率。Parallel WaveNet
自测:交换两个核切片会怎样?shape 仍可能全部正确,但输入旧值与当前值的权重反了。最短排查方式是先复现图中的 18、23、28,再跑全模型固定输入等价测试。
正在连接 GitHub 评论…