08|F5-TTS:流匹配与文本引导的语音补全
F5-TTS 把零样本合成写成带文本条件的声学补全:参考片段可见,目标片段未知,网络把噪声逐步变成目标 mel。文本不需要先获得逐音素时长标签,但生成序列的总长度仍需确定。论文 · 官方代码
学习的是连续速度场;推理通过数值积分生成频谱,再用声码器恢复波形。
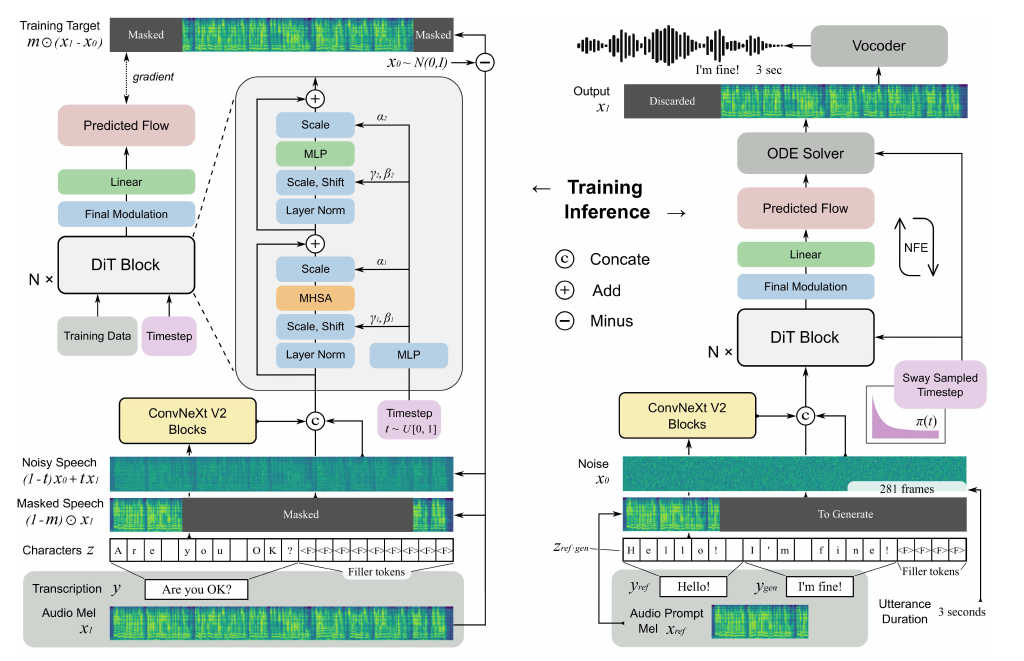
图 1|F5-TTS 的训练补全任务与推理 ODE 路径
深入学习路径
将流匹配基础、文本/声学融合、训练掩码与推理采样分开,避免在一个总览里混淆四种职责。
| 子文章 | 阅读目标 |
|---|---|
| 01|流匹配实现:条件区域、Euler 积分与 CFG | 条件区域、Euler 积分与 CFG |
| 02|文本与声学对齐:ConvNeXt 文本建模与 DiT 主干 | ConvNeXt 文本建模与 DiT 主干 |
| 03|流匹配训练:插值路径、语音补全与条件丢弃 | 插值路径、语音补全与条件丢弃 |
| 04|推理采样:参考长度、Sway 时间网格与 CFG | 参考长度、Sway 时间网格与 CFG |
各篇包含独立机制解释、张量或状态约定、数值例与验证边界。代码集中入口见 深入机制实验附录。
1. 速度监督从何而来
对一条训练音频的 mel 与随机噪声作线性插值,就得到任意流时间位置的样本;两端之差给出该条件路径的速度目标。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 与 mel 同形状的高斯噪声;教学例 (0,2)。 | |
| 真实 mel 特征;教学例只取两个特征值 (4,0)。 | |
| 0 到 1 的流时间,无秒单位;不是录音帧索引。 | |
| 噪声与数据之间的插值状态。 | |
| 条件速度目标;教学例 (4,−2)。 | |
| 文本与可见参考频谱等条件。 | |
| 神经网络预测的速度,形状与频谱相同。 | |
| 可学习网络参数。 | |
| 对录音、噪声和采样流时间求期望,实际用 batch 估计。 | |
| 平方误差;实际训练只在需要生成的有效区域统计。 |
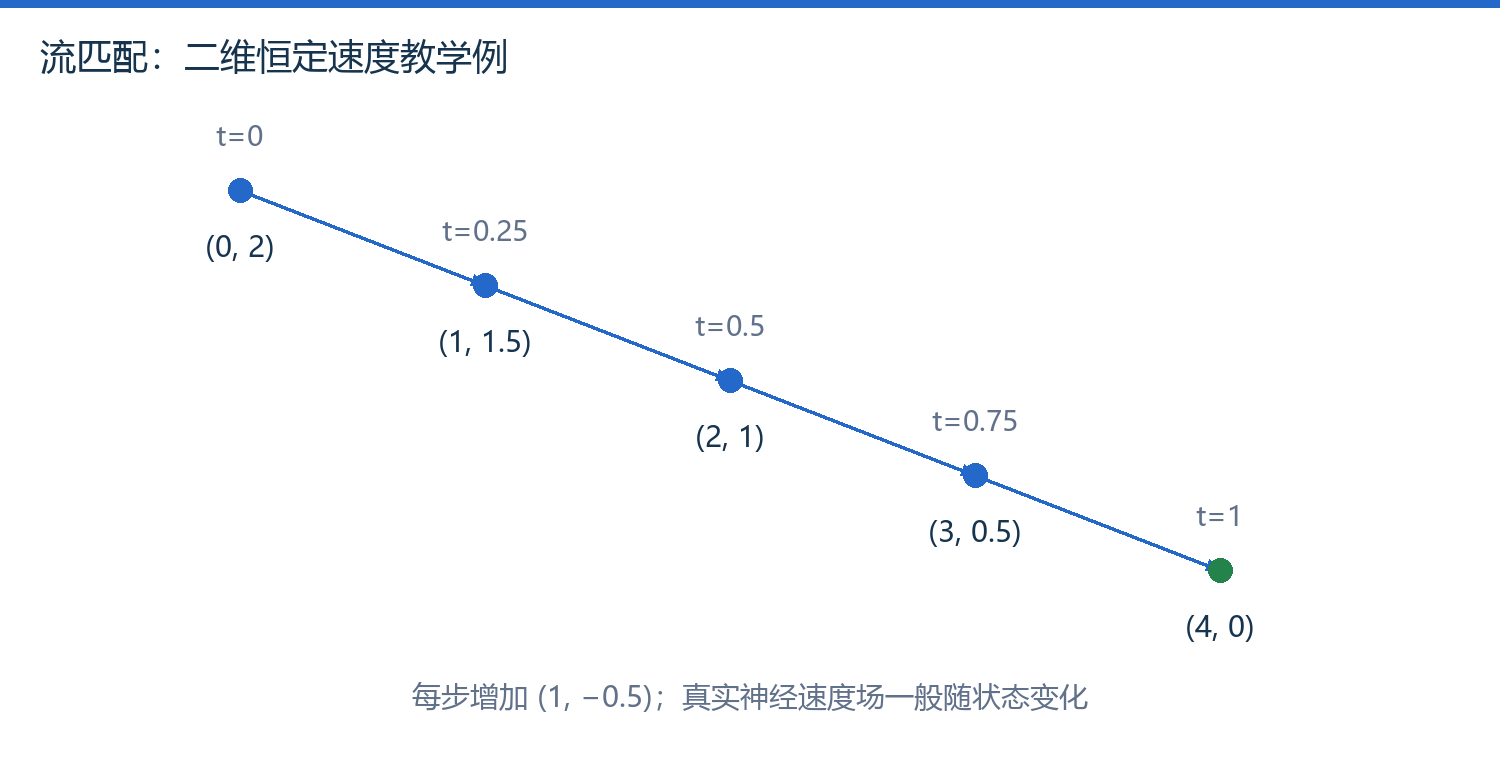
图 2|二维教学路径:四次 Euler 更新从噪声端到达目标端
当 ,插值为 ;若网络输出 ,与真实速度差为 ,平方和是 2,按两个元素平均则为 1。损失是求和还是平均要与代码保持一致。
2. 文本如何与频谱共同输入
文本字符嵌入先通过 ConvNeXt 模块整理局部关系,再与带噪频谱、可见参考条件送入 DiT。字符序列用 filler 补到目标声学长度;这不是把某个字符强制配给同位置声学帧,对齐由网络在补全训练中学习。
| 张量 | 教学约定形状 | 含义 |
|---|---|---|
| noisy mel | [B,T,F] | 当前积分状态 |
| audio condition | [B,T,F] | 可见参考区,未知区置零 |
| text condition | [B,T,H] | 补齐并编码的文本特征 |
| flow time | [B] | 当前噪声到数据的位置 |
| predicted velocity | [B,T,F] | 当前状态的更新方向 |
没有音素级时长预测器,不等于没有长度问题。
目标总时长过短会挤压甚至漏读,过长可能出现拖音或多余停顿。论文以参考音频与文本比例估计时长;官方实现还应核对具体文本计数、语速和分段逻辑。
3. 推理步数与 Sway Sampling
ODE 求解器选择在哪些流时间评估网络。Sway Sampling 改变时间网格,让更多评估放在对生成有帮助的区域;它不直接改变训练好的权重,也不是减少输出语音的采样点数。不同求解器一次“步”可能调用网络多次,所以应同时报告 NFE(网络评估次数)。
减少 NFE 能降低解码计算,但效果需在固定文本与参考音频下比较。
截至 2026-09-29,官方仓库提供后续 F5-TTS v1 基座及推理、微调入口;本文数学主线对应原论文,不把后续 checkpoint 与论文实验混为同一配置。继续 流匹配实现与掩码,或进入 GPT-SoVITS。
专题导航:TTS 总目录
正在连接 GitHub 评论…