04|GPT-SoVITS 数据准备、微调与故障定位
微调质量首先受“录音与文字是否真的匹配”影响。把错误识别、切断音素、背景音乐和多说话人混录送进网络,训练损失仍可能下降,但会把错误规律写入模型。本页给出可检查的数据流,训练命令以固定版本的 WebUI 实际生成配置为准。
先建立固定验证集,再处理训练集;训练集好听不能证明泛化。
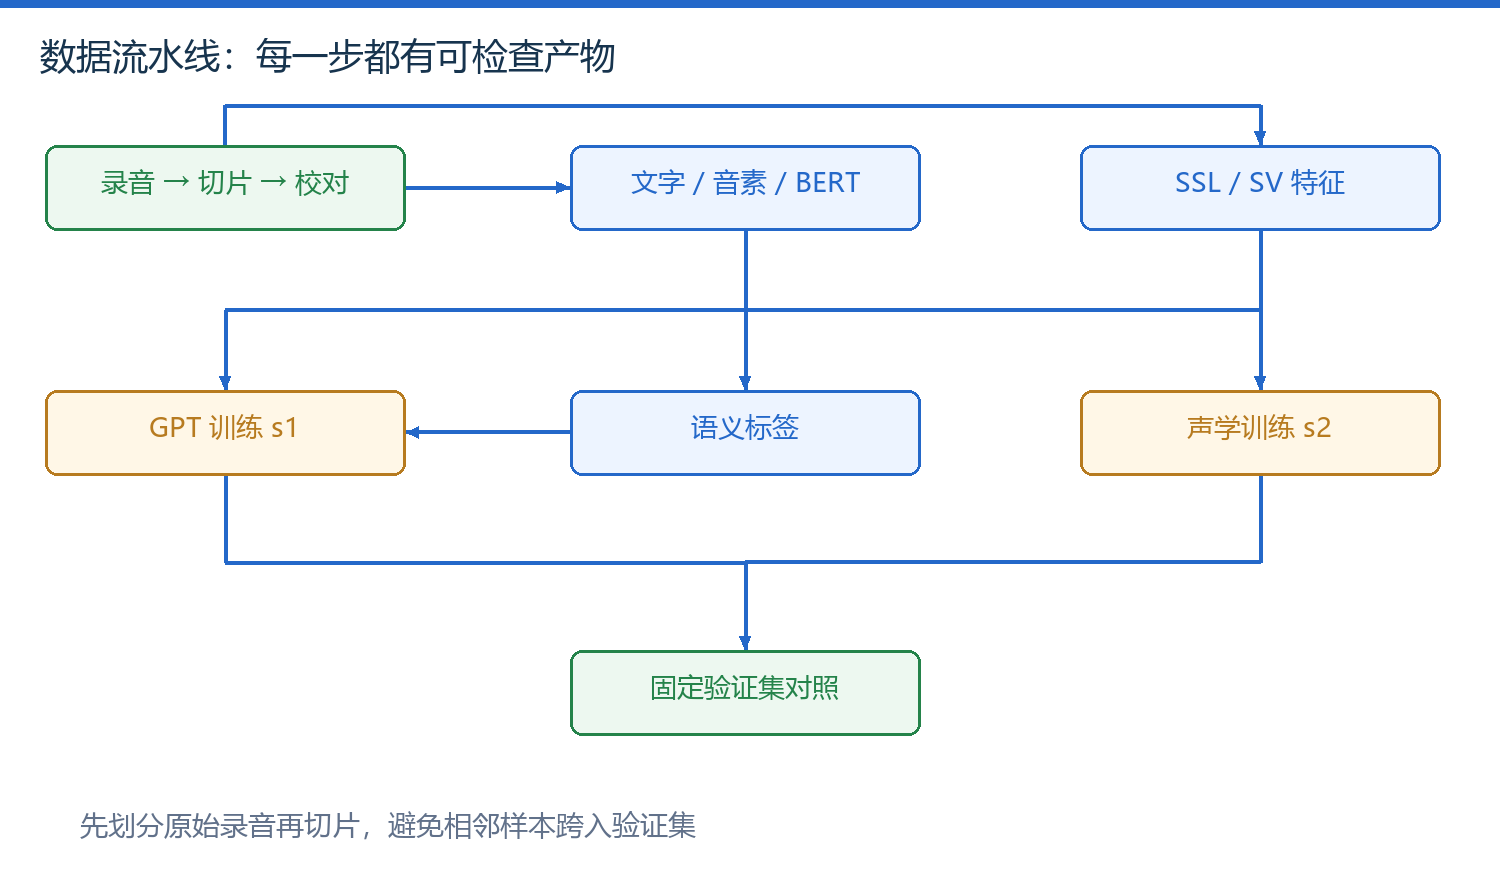
图 1|从录音、校对、特征提取到两阶段训练与验证
1. 从音频到模型所需的三类标签
官方 .list 每行使用 音频路径|说话人|语言|文字。字段中的竖线是分隔符,不能随意出现在文字中;文件必须指向切分后且与标签一致的录音。
| 阶段 | 固定版本入口 | 产物与检查 |
|---|---|---|
| 文本处理 | prepare_datasets/1-get-text.py | 音素与 BERT 特征;长度与语言前端对应 |
| SSL/波形处理 | 2-get-hubert-wav32k.py | SSL 特征与相应波形;检查采样率和截断 |
| Pro 身份特征 | 2-get-sv.py | 说话人验证特征,仅用于匹配分支 |
| 语义编号提取 | 3-get-semantic.py | GPT 目标序列;检查空序列和异常长度 |
| 声学训练 | s2_train.py 或分支训练入口 | token/文本/参考 → 波形或声学生成模型 |
| GPT 训练 | s1_train.py | 文本条件 → 语义序列 |
2. 切分与校对的最低检查
| 项目 | 检查动作 | 错误后果 |
|---|---|---|
| 片段边缘 | 听开头结尾,查看波形 | 丢失辅音、拖尾,产生截断监督 |
| 文字忠实性 | 按实际说法转写数字、重复与语气词 | 学到漏字或额外词 |
| 说话人一致性 | 按录音来源复核 | 身份条件被混合 |
| 响度与削波 | 检查峰值与听感 | 强归一化不能恢复削波信息 |
| 训练/验证隔离 | 按原始录音划分后再切片 | 相邻重复片段泄漏到验证集 |
不是片段越短越好:过短会失去语调和上下文,过长增加训练成本。选择范围应服从具体版本预处理检查,先验证能完整保留发音,再追求批处理效率。
3. 用时长比发现异常
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 语义帧密度,单位 token/秒。 | |
| 提取出的语义时间位置数,非所有特征元素数。 | |
| 对应音频时长,单位秒,必须来自同一实际片段。 |
在 25 Hz 配置中,10 秒音频若有约 250 个 token,则密度约为 25;若记录变成 2.5 或 250,先检查时长单位、重采样与特征文件是否错配。短片段边界会有小偏差,不能机械要求每条严格相等。
帧密度、空标签和文件对应关系可以在训练前筛出大量低级错误。
4. 微调实验如何逐步推进
| 顺序 | 操作 | 判断依据 |
|---|---|---|
| 1 | 先用基座合成固定验证文本 | 建立无需微调的基线 |
| 2 | 完成标签与特征抽查 | 随机片段、最长最短片段均正常 |
| 3 | 按版本选择声学训练/LoRA 入口 | checkpoint 与配置匹配 |
| 4 | 训练 GPT 并定期保存 | 比较未见文本、数字、多音字和长句 |
| 5 | 对比不同 checkpoint | 同参考、同随机种子、同文本 |
当前 WebUI 对 v3/v4 类训练存在 s2_train_v3_lora.py 路径,不能把 v2 的完整训练配置直接搬过去。本文没有下载大权重并执行微调,因此没有报告显存占用、收敛轮数或微调音质成绩。
“一小段录音即可尝试”是使用门槛描述,不是足够数据质量与训练覆盖的保证。
5. 按模块定位故障
| 症状 | 首查 | 然后检查 |
|---|---|---|
| 重复、漏字、停不下来 | 文字前端、GPT EOS/采样 | 长文本切分、训练标签 |
| 内容正确但音色漂移 | 参考录音与声学权重 | Pro 身份特征、训练说话人一致性 |
| 金属声、带宽异常 | vocoder 与 mel 配置 | 输出采样率、过强后处理 |
| 段落拼接突变 | 分句与跨块上下文 | 参考条件、静音插入与幅度 |
| 训练集好、验证集差 | 数据泄漏与过拟合 | checkpoint、学习率与数据多样性 |
回到 GPT-SoVITS 导读,或继续 CosyVoice。
正在连接 GitHub 评论…