01|说话人表示:参考录音、向量归一化与零样本迁移
这里的“零样本”指合成阶段不需要为新说话人更新模型参数,并非模型从未接受过大量多说话人训练。2018 年迁移学习论文把说话人验证网络、声学合成器与声码器分开训练;参考录音通过嵌入向量影响合成,而不是被逐帧复制。
说话人编码器提取身份条件;文本仍决定要说的内容。
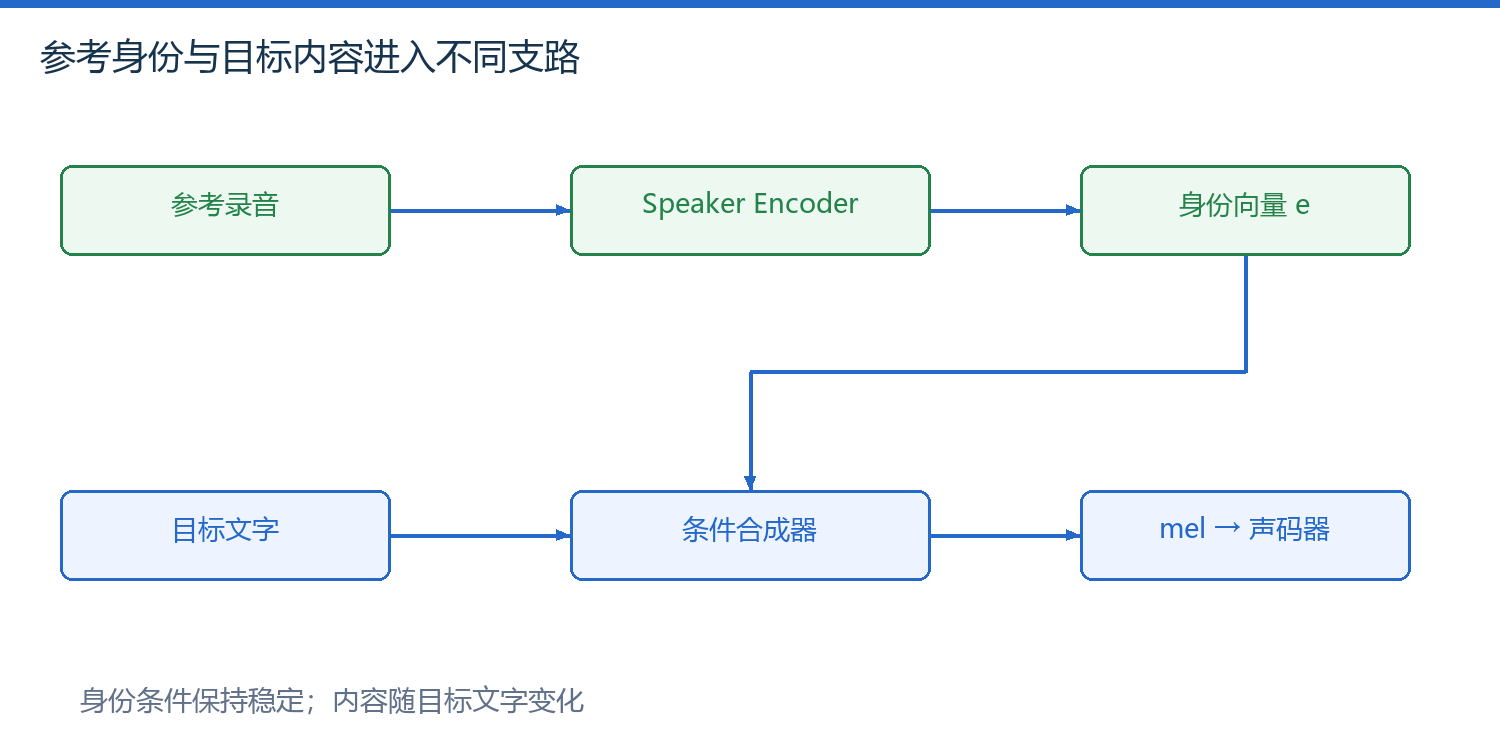
图 1|说话人验证知识迁移到语音合成的三网络路径
1. 参考录音经过哪些计算
| 模块 | 输入 → 输出 | 学习任务 |
|---|---|---|
| 说话人编码器 | 参考 mel 片段 → 固定维向量 | 让同一说话人的录音更接近、不同说话人分开 |
| 合成器 | 文本序列与说话人向量 → mel | 以该身份生成目标文本的声学序列 |
| 声码器 | mel → 波形 | 实现该声学条件下的细节重建 |
参考录音可能长短不同,合成器却需要稳定的固定维条件。常见实现把录音切成多个片段,分别编码,聚合后归一化。以下是用于理解聚合的教学计算,不冒充论文完整验证损失。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 参考片段个数,本例 2。 | |
| 片段索引,从 1 到 M。 | |
| 第 m 个片段的嵌入向量,教学例使用二维;真实模型维度由配置决定。 | |
| 片段向量的算术平均。 | |
| 对所有片段逐维相加。 | |
| 欧氏长度,即各分量平方和的平方根。 | |
| 归一化后的条件向量,无物理单位;零向量必须额外处理。 |
两个片段给出 与 :平均为 ,长度约为 ,最终向量约为 。归一化保留方向,去掉整体幅值;它不自动去除录音噪声或情绪信息。
2. 条件广播与代码接口
对文本隐藏序列 [B,N,H],说话人向量 [B,D] 可沿文本轴广播,再拼接为 [B,N,H+D]。图中的支路只编码一次,不能在每个文本位置重新抽一段随机参考音频。
# 教学接口:B=batch, N=文本长度, H=文本维度, D=说话人维度
speaker = speaker / speaker.norm(dim=-1, keepdim=True).clamp_min(1e-8)
condition = speaker[:, None, :].expand(-1, text_hidden.size(1), -1)
memory = torch.cat([text_hidden, condition], dim=-1)
同一身份条件可用于不同目标文本,参考文字无需成为输出内容。
3. 评估需要分开的问题
| 现象 | 更可能相关的因素 | 控制变量实验 |
|---|---|---|
| 音色不像,但文字正确 | 参考音频、身份嵌入、训练覆盖 | 同文本更换同一人的参考片段 |
| 音色像,但跟着参考情绪走 | 身份与风格没有完全解耦 | 平静与激动参考分别生成 |
| 跨语言明显变音 | 训练语言与说话人分布 | 固定录音,逐语言检查 |
| 相似度高但听感嘶哑 | 客观嵌入指标未覆盖音质 | 加入盲听与声学失真检查 |
说话人相似度不是音质分数,也不是“完全复制身份”的证明。
GPT-SoVITS v2Pro 的说话人验证特征也服务于身份条件,但其语义 token 与声学解码路径不同,不能直接等同于本节三网络方案。返回 本章导读,或进入 GPT-SoVITS。
正在连接 GitHub 评论…