09|GPT-SoVITS:语义生成、参考条件与声学解码
GPT-SoVITS 的核心是两阶段生成:GPT 根据文本与参考提示预测语义 token,声学解码器再根据这些 token、目标音素与参考声音重建波形。项目名称中的 GPT 表示自回归序列建模,不是调用 ChatGPT API;SoVITS 部分也已随版本演进,不能只用一张早期 VITS 架构图概括全部版本。
本章的 v1–v4 与 v2Pro 历史讲解依据 2026-09-29 的核查,保留源码快照 48b1a0169a28582a8984402f82cf438d3bfa6aca(2026-08-18 提交)。这些子文中的旧分支与配置继续对应该快照,不能直接用最新代码替代后假定细节相同。历史源码 · 版本发布
**2026-10-08 更新:**新增 GPT-SoVITS v5 专题,公开推理代码另固定到 e7cd61ec3dcc9a34089f50ed169e3103a16ad675(2026-10-07 提交)。新专题深入解释 Dev/Turbo、流匹配、DMD、新版声码器和 Seed-TTS 评测;版本事实与项目自测分开核对。v5 源码快照
语义 token 负责承载发音内容与时序线索,参考条件补充音色等声学信息。
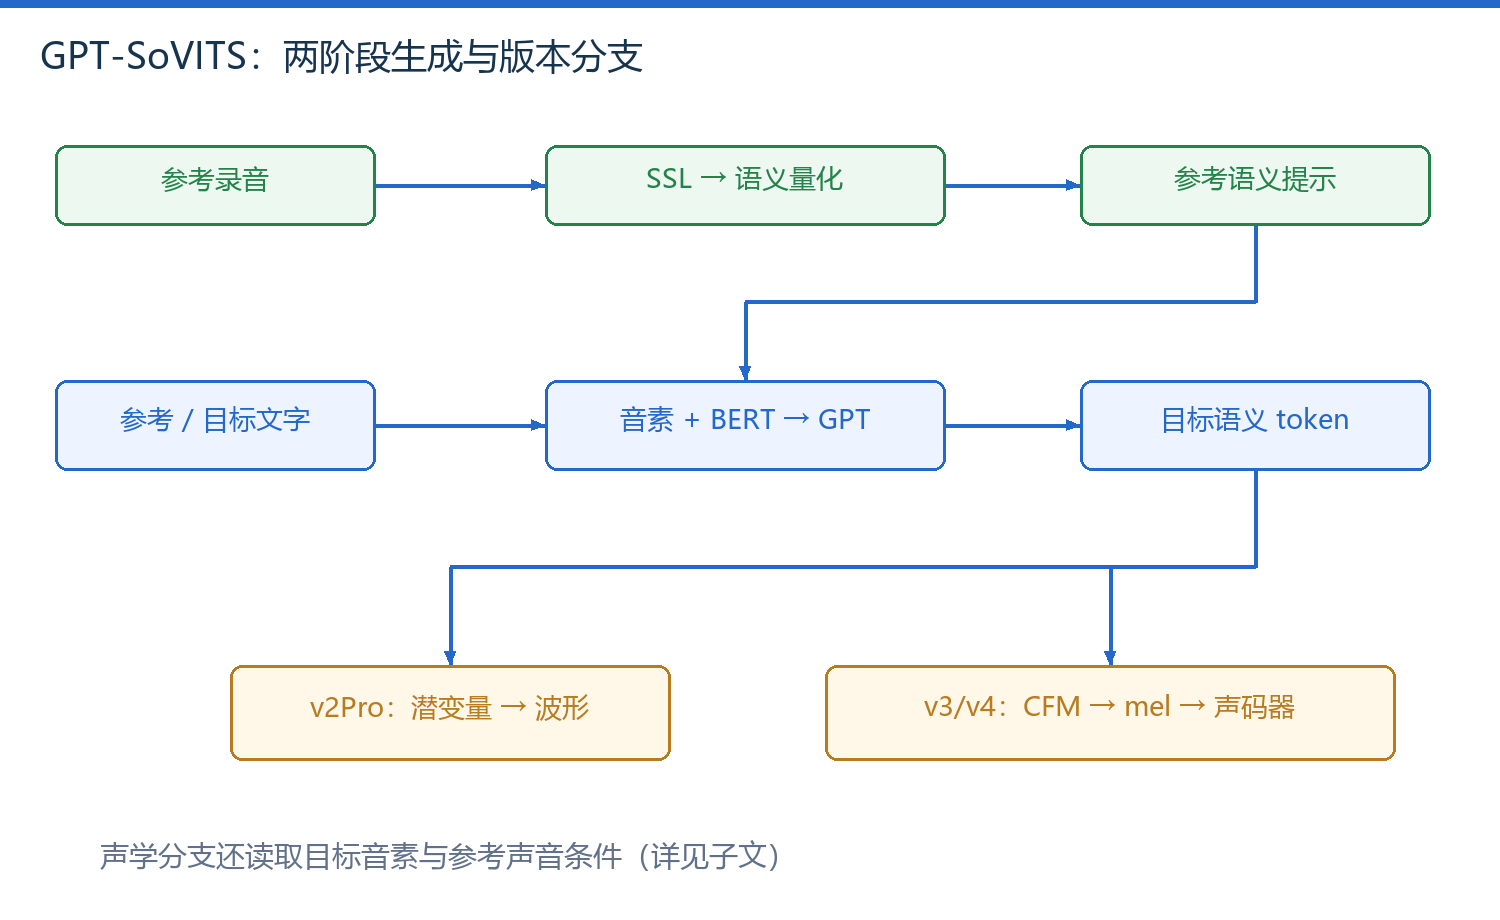
图 1|GPT-SoVITS 的语义提示、目标生成与两类声学解码路径
1. 输入如何分工
| 输入 | 被谁读取 | 提供的信息 |
|---|---|---|
| 目标文本 | 文本前端、GPT 与声学条件网络 | 要说的内容及音素线索 |
| 参考录音 | SSL 编码器、量化器、参考编码器 | 参考语义片段与声音条件 |
| 参考文字 | 文本前端与 GPT 提示 | 解释参考录音说了什么,帮助上下文续接 |
| 可选多参考 | 特定版本声学分支 | 多段参考的身份/风格统计 |
| 说话人验证特征 | v2Pro/ProPlus 分支 | 更明确的说话人条件 |
SSL 指自监督语音表征。这里常用中文 HuBERT 提取连续特征,再经可训练投影和量化得到语义编号;这些编号不能拿给 EnCodec 解码器直接播放,因为码本与解码器并非同一系统。
2. 三种时间分辨率
以仓库常见的 25 Hz 语义配置与 v2 系列 32 kHz 输出为例,一秒约有 25 个语义位置、50 个声学潜变量位置、32,000 个波形采样点。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| v2 配置中由 STFT 帧移确定的声学时间分辨率。 | |
| 波形采样率,此配置为 32,000 Hz。 | |
| 帧移,此配置为 640 个采样点。 | |
| 除法,把每秒采样点数转换为每秒帧数。 |
| 10 秒教学估算 | 数量 | 代码意义 |
|---|---|---|
| 语义 token | 约 250 | GPT 的目标时间步 |
| 声学潜变量 | 约 500 帧 | 25 Hz 语义常先扩展两倍 |
| v2 输出波形 | 320,000 点 | 需要匹配正确输出采样率 |
实际长度会受边界、静音与裁剪影响。v3/v4/v5 的 mel 和声码器配置不同,不能套用这一行 v2 配置做所有版本的换算。v5 常见语义配置为 25 Hz,连续声学特征约 100 帧/秒,波形为 48 kHz;具体形状与边界见 v5 网络架构。
先固定版本和张量单位,才有可解释的调参结果。
零样本推理、少量录音微调、完整预训练是三种任务;“几秒参考”不等于“几秒训练出基础模型”。
3. 本章结构与源码阅读路线
| 子文 | 内容与验证目标 |
|---|---|
| 语义编码与 GPT 因果预测 | HuBERT、单层量化、文本前缀遮罩、teacher forcing 与 EOS |
| 声学解码与版本分支 | v2Pro 的身份特征,以及 v3/v4 的 CFM、mel 和声码器 |
| 版本选择与复现配置 | 确定 checkpoint、采样率和代码版本,避免数字排序误导 |
| 数据准备、微调与诊断 | 从录音到标签、特征、两阶段训练和固定验证集 |
| v5:少步蒸馏、声码器与评测 | 最新独立专题;架构、采样、DMD、参数化、波形、加速、评测与源码附录 |
完整项目中 UI 负责收集参数,模型文件负责计算。阅读时从 get_tts_wav 的输入流追到各分支,再深入算子;不要从数千行 WebUI 布局代码开始猜模型结构。推理入口
4. v5 专题与证据边界
v5 延续“语义生成 → 连续声学生成 → 波形合成”的分工。下面是新源码快照的默认发布配置;早期图和旧子文仍用于解释对应历史路径。
| 项目 | v5 Dev | v5 Turbo |
|---|---|---|
| 默认 GPT 权重 | s1v3.ckpt | 同左 |
| 声学权重 | s2Gv5dev.pth | s2Gv5turbo.pth |
| 默认声学采样 | 32 步、CFG 1.3 | 4 步、无额外 CFG 分支 |
| 连续声学接口 | 100-bin mel、约 100 帧/秒 | 同左 |
| 参考 mel 分析 | 32 kHz 输入、320 点帧移 | 同左 |
| 波形输出 | 48 kHz、每 mel 帧 480 个采样点 | 同左 |
“无 CFG”仍有参考 mel 和逐帧语义条件,只是不额外计算去参考 mel 的负分支。32 步和 4 步是迭代更新整段 mel 的次数,不是音频帧数。CFG 1.3 对应本项目额外放大差值的系数,其数值不能与其他项目直接互换。活动采样实现
25 Hz 语义、100 Hz mel 与 48 kHz 波形可以描述同一秒音频;它们是不同阶段的时间分辨率。
| 说法 | 当前可支持的范围 |
|---|---|
| Turbo 从 Dev 经 DMD 蒸馏得到 | 官方 Wiki 的版本说明;完整后训练配方尚未公开 |
CFMV5.forward 的流匹配损失 | 公开训练接口;不能冒充 Turbo DMD 蒸馏代码 |
| v5 声码器改进高频伪影 | 官方效果声明;公开 Generator 与 v4 同构,加载新版权重 |
| CUDA Graph / 外部 FlashAttention | 当前主要加速 GPT 语义生成;不等于整条生成链均被捕获 |
| Seed-TTS 中文相似度提升 | 项目方自测;需结合错误率、听感与复现口径阅读 |
零样本克隆成绩不能替代 v5 微调效果,也不能把 SIM 换算成自然度百分比。
新专题按模块拆成八篇子文(含源码实验附录),并提供默认展开的符号解释、张量图、手算和教学代码。建议从 架构与参考窗口进入;直接关心排行榜时可阅读 Seed-TTS 评测与复现。官方 v5 说明
专题导航:TTS 总目录
正在连接 GitHub 评论…